

Büyük dil modellerinin (LLM'ler) manzarası baş döndürücü bir hızla gelişiyor. Modeller daha güçlü, yetenekli ve en önemlisi daha erişilebilir hale geliyor. Qwen ekibi kısa süre önce, kodlama, matematik ve genel muhakeme dahil olmak üzere çeşitli kıyaslamalarda etkileyici performans sergileyen en yeni nesil LLM'leri olan Qwen3'ü tanıttı. Mixture-of-Experts (MoE) Qwen3-235B-A22B gibi amiral gemisi modelleri yerleşik devlerle ve hatta Qwen3-4B gibi daha küçük yoğun modellerin önceki nesil 72B parametre modelleriyle rekabet etmesiyle, Qwen3 önemli bir sıçramayı temsil ediyor.
Bu sürümün önemli bir yönü, iki MoE varyantı (Qwen3-235B-A22B ve Qwen3-30B-A3B) ve 0,6B'den 32B parametreye kadar değişen altı yoğun model dahil olmak üzere çeşitli modellerin açık ağırlıklandırılmasıdır. Bu açıklık, geliştiricileri, araştırmacıları ve meraklıları bu güçlü araçları keşfetmeye, kullanmaya ve bunlar üzerine inşa etmeye davet ediyor. Bulut tabanlı API'ler kolaylık sağlarken, gizlilik, maliyet kontrolü, özelleştirme ve çevrimdışı erişilebilirlik ihtiyaçları nedeniyle bu gelişmiş modelleri yerel olarak çalıştırma arzusu artıyor.
Neyse ki, yerel LLM yürütme için araç ekosistemi önemli ölçüde olgunlaştı. Bu süreci basitleştiren iki öne çıkan platform Ollama ve vLLM'dir. Ollama, çeşitli modellere başlamak için inanılmaz derecede kullanıcı dostu bir yol sunarken, vLLM, özellikle daha büyük modeller için verim ve verimlilik için optimize edilmiş yüksek performanslı bir hizmet çözümü sunar. Bu makale, Qwen3'ü anlamanız ve hem Ollama hem de vLLM'yi kullanarak bu güçlü modelleri yerel makinenizde kurmanız için size rehberlik edecektir.
Geliştirici Ekibinizin birlikte maksimum verimlilikle çalışması için entegre, Hepsi Bir Arada bir platform mu istiyorsunuz?
Apidog tüm taleplerinizi karşılıyor ve Postman'in yerini çok daha uygun bir fiyata alıyor!
Qwen 3 ve Kıyaslamalar Nedir?
Qwen3, Qwen ekibi tarafından geliştirilen ve Nisan 2025'te yayınlanan üçüncü nesil büyük dil modellerini (LLM'ler) temsil eder. Bu yineleme, gelişmiş muhakeme yeteneklerine, Mixture-of-Experts (MoE) gibi mimari yenilikler aracılığıyla verimliliğe, daha geniş çok dilli desteğe ve çok çeşitli kıyaslamalarda iyileştirilmiş performansa odaklanarak önceki sürümlere göre önemli bir ilerlemeyi ifade eder. Sürüm, araştırma ve geliştirme için erişilebilirliği teşvik eden Apache 2.0 lisansı altında çeşitli modellerin açık ağırlıklandırılmasını içeriyordu.
Qwen 3 Model Mimarisi ve Varyantları, Açıklandı
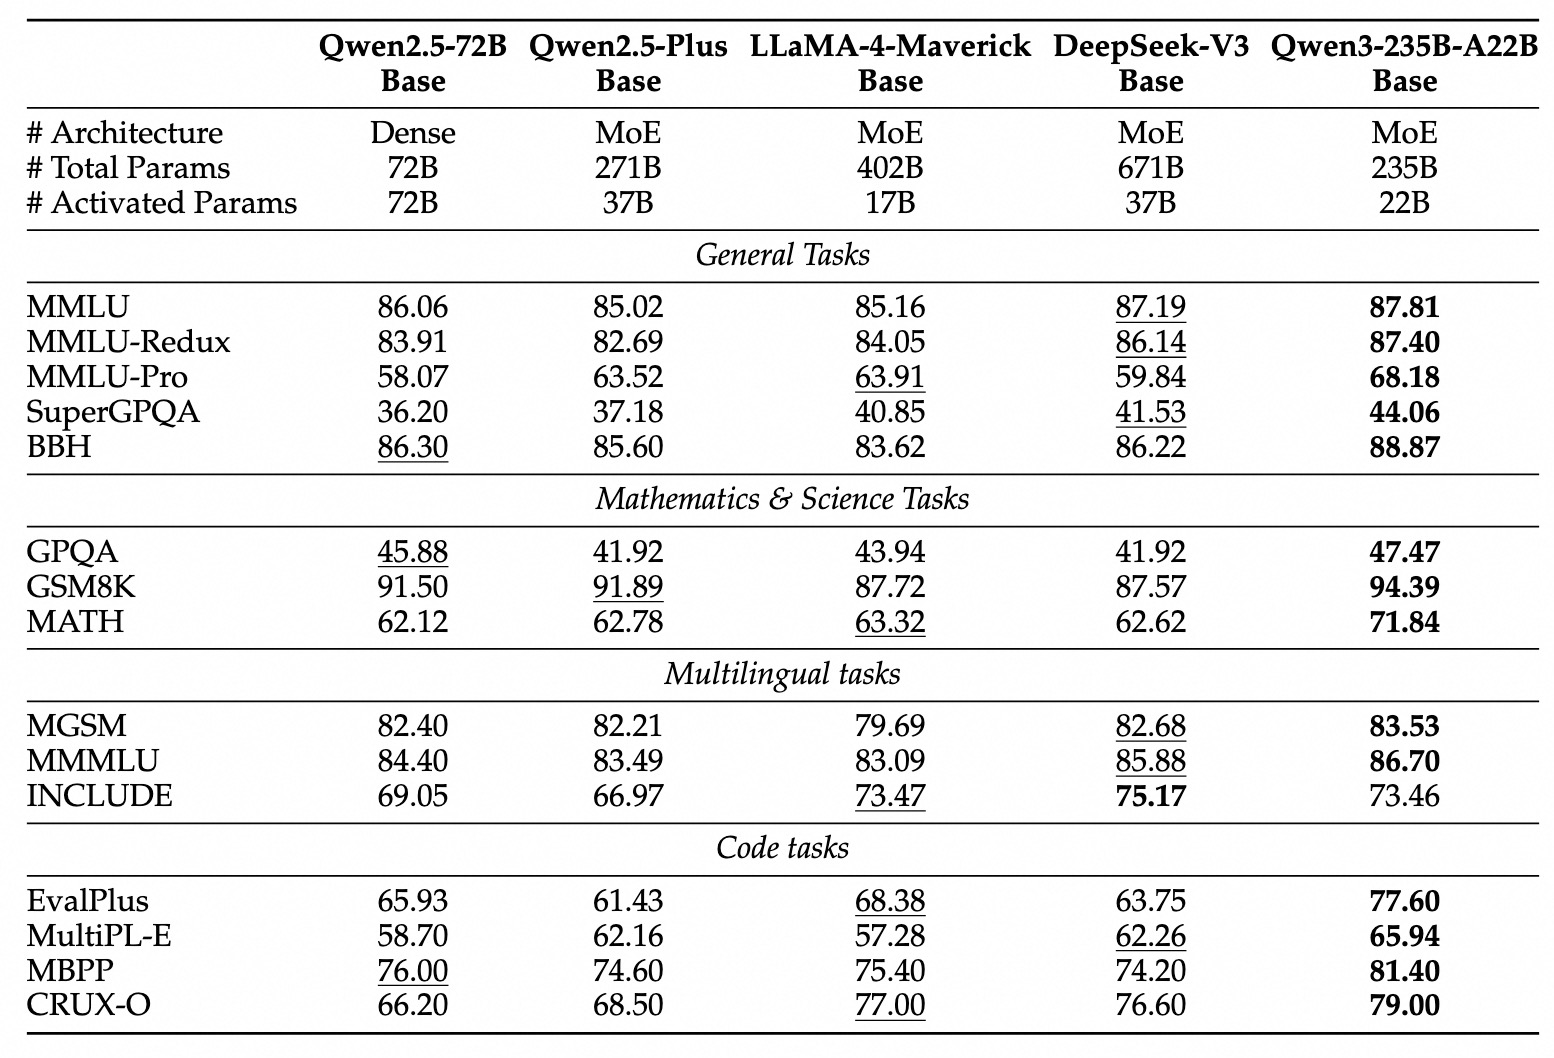
Qwen3 ailesi, çeşitli hesaplama bütçelerine ve performans gereksinimlerine hitap eden hem geleneksel yoğun modelleri hem de seyrek MoE mimarilerini kapsar.
Yoğun Modeller: Bu modeller, çıkarım sırasında tüm parametrelerini kullanır. Temel mimari ayrıntıları şunları içerir:
| Model | Katmanlar | Dikkat Başlıkları (Sorgu / Anahtar-Değer) | Kelime Gömülülerini Bağla | Maksimum Bağlam Uzunluğu |
|---|---|---|---|---|
| Qwen3-0.6B | 28 | 16 / 8 | Evet | 32.768 belirteç (32K) |
| Qwen3-1.7B | 28 | 16 / 8 | Evet | 32.768 belirteç (32K) |
| Qwen3-4B | 36 | 32 / 8 | Evet | 32.768 belirteç (32K) |
| Qwen3-8B | 36 | 32 / 8 | Hayır | 131.072 belirteç (128K) |
| Qwen3-14B | 40 | 40 / 8 | Hayır | 131.072 belirteç (128K) |
| Qwen3-32B | 64 | 64 / 8 | Hayır | 131.072 belirteç (128K) |
Not: Grup Sorgu Dikkat (GQA), tüm modellerde kullanılır ve Sorgu ve Anahtar-Değer başlıklarının farklı sayısıyla gösterilir.
Mixture-of-Experts (MoE) Modelleri: Bu modeller, çıkarım sırasında her belirteç için yalnızca bir "uzman" İleri Beslemeli Ağ (FFN) alt kümesini etkinleştirerek seyreklikten yararlanır. Bu, daha küçük yoğun modellere daha yakın hesaplama maliyetlerini korurken büyük bir toplam parametre sayısına izin verir.
| Model | Katmanlar | Dikkat Başlıkları (Sorgu / Anahtar-Değer) | # Uzmanlar (Toplam / Etkinleştirilmiş) | Maksimum Bağlam Uzunluğu |
|---|---|---|---|---|
| Qwen3-30B-A3B | 48 | 32 / 4 | 128 / 8 | 131.072 belirteç (128K) |
| Qwen3-235B-A22B | 94 | 64 / 4 | 128 / 8 | 131.072 belirteç (128K) |
Not: Her iki MoE modeli de toplam 128 uzman kullanır, ancak belirteç başına yalnızca 8'ini etkinleştirir, bu da eşdeğer boyutta bir yoğun modele kıyasla hesaplama yükünü önemli ölçüde azaltır.
Qwen 3 Temel Teknik Özellikleri
Hibrit Düşünme Modları: Qwen3'ün belirgin bir özelliği, kullanıcı tarafından kontrol edilebilen iki farklı modda çalışabilmesidir:
- Düşünme Modu (Varsayılan): Model, nihai yanıtı oluşturmadan önce dahili, adım adım muhakeme (Zincir-Düşünce stili) gerçekleştirir. Bu gizli düşünme süreci, genellikle özel belirteçlerle işaretlenir (örneğin, belirli çerçeve yapılandırmalarını kullanırken nihai cevaptan önce
<think>...</think>içeriğini çıktı olarak verir). Bu mod, mantıksal çıkarım, matematiksel muhakeme veya planlama gerektiren karmaşık görevlerde performansı artırır. Ayrılan hesaplama muhakeme bütçesiyle doğrudan ilişkili ölçeklenebilir performans iyileştirmelerine olanak tanır. - Düşünmeyen Mod: Model, daha basit sorgularda hız ve azaltılmış hesaplama maliyeti için optimize ederek, açık bir dahili muhakeme aşaması olmadan doğrudan bir yanıt oluşturur.
Kullanıcılar, istemlerinde/thinkve/no_thinkgibi etiketleri kullanarak (çerçeve izin veriyorsa) çok turlu konuşmalarda potansiyel olarak tur bazında bu modlar arasında dinamik olarak geçiş yapabilir ve gecikme/maliyet ile muhakeme derinliği arasındaki değiş tokuş üzerinde ince ayarlı kontrol sağlayabilir.
Kapsamlı Çok Dilli Destek: Qwen3 modelleri, büyük dil ailelerinde (Hint-Avrupa, Sino-Tibet, Afro-Asyatik, Avustronezya, Dravid, Türk vb.) 119 dil ve lehçeyi destekleyen çeşitli bir korpus üzerinde önceden eğitilmiştir ve bu da onları çok çeşitli küresel uygulamalar için uygun hale getirir.
Gelişmiş Eğitim Yöntemleri:
- Ön Eğitim: Modeller, trilyonlarca belirteçten oluşan büyük ölçekli bir veri kümesi üzerinde önceden eğitildi. Son ön eğitim aşaması, etkili bağlam penceresini başlangıçta 32K belirtece ve daha büyük modeller için 128K'ya kadar uzatmak için yüksek kaliteli uzun bağlam verilerinin kullanılmasını içeriyordu.
- Eğitim Sonrası: Modelleri talimatları takip etme yetenekleri, muhakeme becerileri ve hibrit düşünme mekanizmasıyla donatmak için gelişmiş dört aşamalı bir boru hattı kullanıldı:
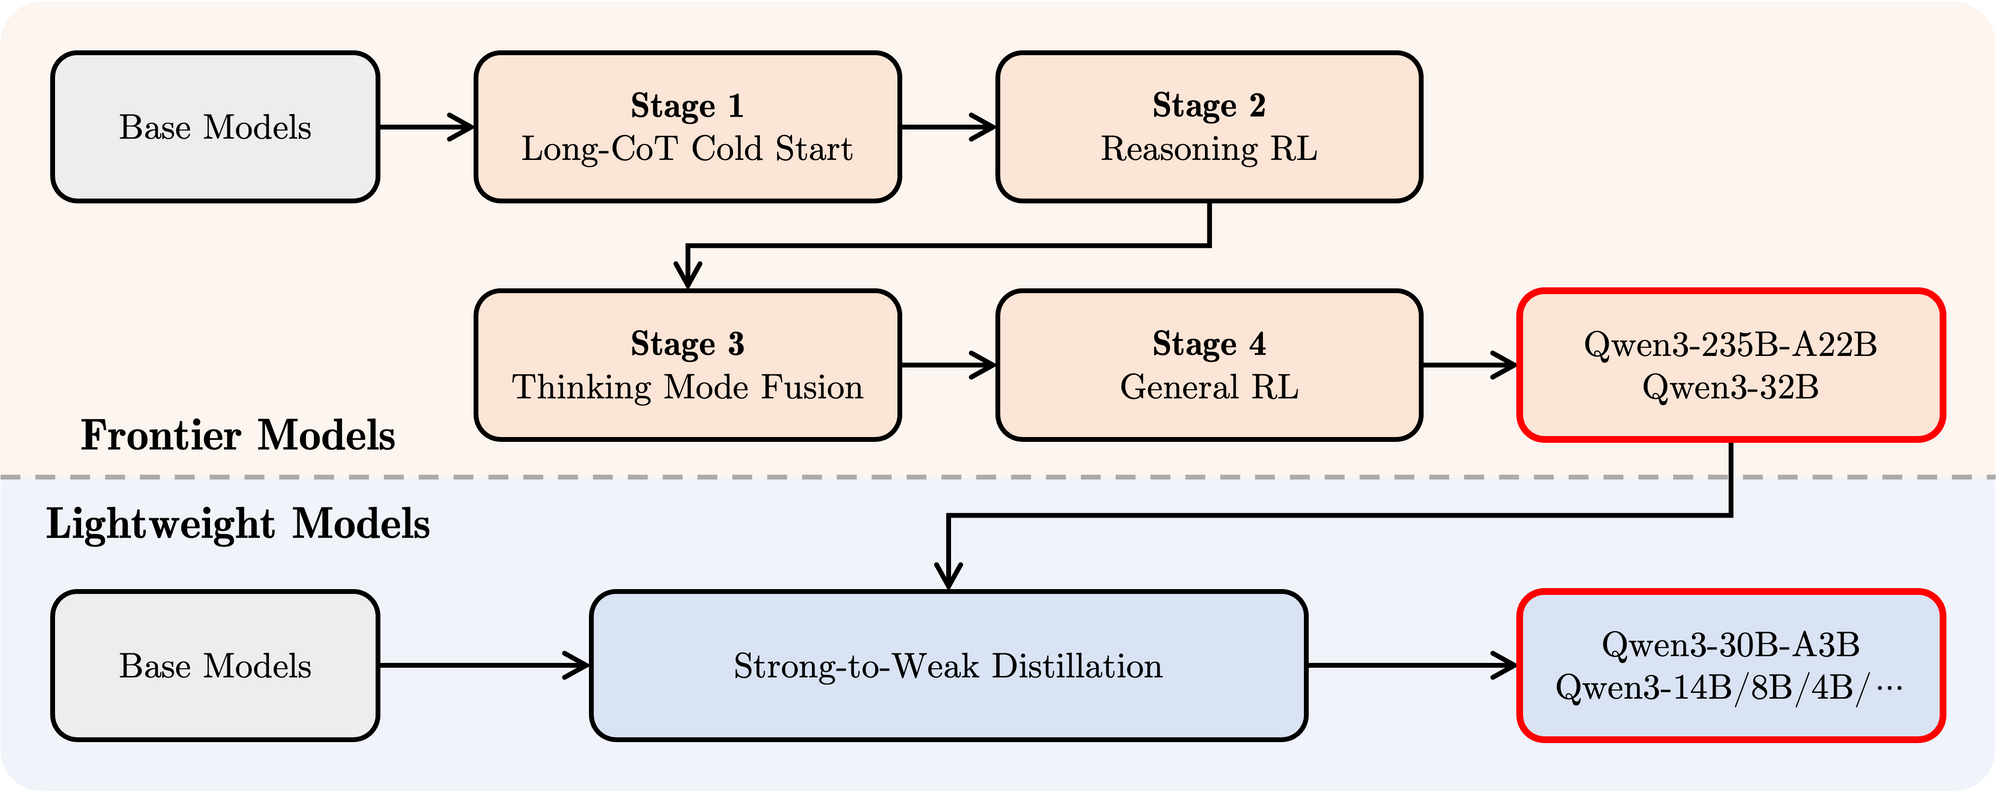
- Uzun CoT Soğuk Başlangıç: Temel muhakeme yetenekleri oluşturmak için matematik, kodlama, mantıksal muhakeme ve STEM'i kapsayan çeşitli uzun Zincir-Düşünce (CoT) verileri üzerinde denetimli ince ayar (SFT).
- Muhakemeye Dayalı Takviyeli Öğrenme (RL): Özellikle muhakeme görevleri için keşif ve sömürmeyi geliştirmek üzere kural tabanlı ödüller kullanarak RL için hesaplama kaynaklarını ölçeklendirme.
- Düşünme Modu Füzyonu: Muhakeme geliştirilmiş modeli, uzun CoT verilerinin ve Aşama 2 modeli tarafından oluşturulan standart talimat ayarlama verilerinin bir karışımı üzerinde ince ayar yaparak düşünmeyen yetenekleri entegre etme. Bu, derin muhakemeyi hızlı yanıt üretimiyle birleştirir.
- Genel RL: Genel davranışları iyileştirmek ve istenmeyen çıktıları azaltmak için çok sayıda genel etki alanı görevi (talimat takibi, biçim uyumu, aracı yetenekleri) genelinde RL uygulamak.
Qwen 3 Kıyaslama Performansı
Qwen3, diğer önde gelen çağdaş modellere karşı oldukça rekabetçi bir performans sergiliyor:
Amiral Gemisi MoE: Qwen3-235B-A22B modeli, kodlama, matematik ve genel yetenekleri değerlendiren çeşitli kıyaslamalarda DeepSeek-R1, Google'ın o1 ve o3-mini, Grok-3 ve Gemini-2.5-Pro gibi üst düzey modellerle karşılaştırılabilir sonuçlar elde ediyor.
Daha Küçük MoE: Qwen3-30B-A3B modeli, çıkarım sırasında parametrelerin yalnızca bir kısmını (3B'ye karşı 32B) etkinleştirmesine rağmen, MoE mimarisinin verimliliğini vurgulayarak QwQ-32B gibi modellerden önemli ölçüde daha iyi performans gösterir.
Yoğun Modeller: Mimari ve eğitimdeki gelişmeler nedeniyle, Qwen3 yoğun modelleri genellikle daha büyük Qwen2.5 yoğun modellerinin performansına uyar veya onları aşar. Örneğin:
Qwen3-1.7B≈Qwen2.5-3BQwen3-4B≈Qwen2.5-7B(ve bazı açılardanQwen2.5-72B-Instructile rekabet eder)Qwen3-8B≈Qwen2.5-14BQwen3-14B≈Qwen2.5-32BQwen3-32B≈Qwen2.5-72B
Özellikle, Qwen3 yoğun temel modelleri, STEM, kodlama ve muhakeme görevlerinde seleflerine göre özellikle güçlü performans iyileştirmeleri gösterir.
MoE Verimliliği: Qwen3 MoE temel modelleri, parametrelerin yalnızca ~%10'unu etkinleştirirken önemli ölçüde daha büyük Qwen2.5 yoğun modelleriyle karşılaştırılabilir performans elde eder ve hem eğitimde hem de çıkarımda önemli tasarruflara yol açar.
Bu kıyaslama sonuçları, Qwen3'ün hem yüksek performans hem de özellikle MoE varyantlarıyla geliştirilmiş hesaplama verimliliği sunan son teknoloji bir model ailesi olarak konumunu vurgulamaktadır. Modeller, Hugging Face, ModelScope ve Kaggle gibi standart platformlar aracılığıyla kullanılabilir ve yerel yürütme dahil olmak üzere çeşitli iş akışlarına ve uygulamalara entegrasyonlarını kolaylaştıran Ollama, vLLM, SGLang, LMStudio ve llama.cpp gibi popüler dağıtım çerçeveleri tarafından desteklenmektedir.
Ollama ile Qwen 3'ü Yerel Olarak Nasıl Çalıştırılır
Ollama, LLM'leri yerel olarak indirme, yönetme ve çalıştırma kolaylığı nedeniyle büyük popülerlik kazanmıştır. Karmaşıklığın çoğunu soyutlayarak bir komut satırı arayüzü ve bir API sunucusu sağlar.
1. Kurulum:
Ollama'yı kurmak genellikle basittir. Resmi Ollama web sitesini (ollama.com) ziyaret edin ve işletim sisteminiz (macOS, Linux, Windows) için indirme talimatlarını izleyin.
2. Qwen3 Modellerini Çekme:
Ollama, hazır modellerden oluşan bir kitaplık tutar. Belirli bir Qwen3 modelini çalıştırmak için ollama run komutunu kullanırsınız. Model yerel olarak mevcut değilse, Ollama onu otomatik olarak indirir. Qwen ekibi, çeşitli Qwen3 varyantlarını doğrudan Ollama kitaplığında kullanıma sundu.
Ollama web sitesinin Qwen3 sayfasında (örneğin, ollama.com/library/qwen3) mevcut Qwen3 etiketlerini bulabilirsiniz. Yaygın etiketler şunları içerebilir:
qwen3:0.6bqwen3:1.7bqwen3:4bqwen3:8bqwen3:14bqwen3:32bqwen3:30b-a3b(Daha küçük MoE modeli)
Örneğin, 4B parametre modelini çalıştırmak için terminalinizi açın ve şunu yazın:
ollama run qwen3:4b
Bu komut, modeli (gerekirse) indirecek ve etkileşimli bir sohbet oturumu başlatacaktır.
3. Model ile Etkileşim:ollama run komutu etkinleştirildikten sonra, istemlerinizi doğrudan terminale yazabilirsiniz. Ollama ayrıca, OpenAI standardıyla uyumlu bir API sunan yerel bir sunucu (genellikle http://localhost:11434 adresinde) başlatır. Bunu, curl veya Python, JavaScript vb. çeşitli istemci kitaplıkları gibi araçları kullanarak programlı olarak etkileşimde bulunabilirsiniz.
4. Donanım Hususları:
LLM'leri yerel olarak çalıştırmak önemli kaynaklar gerektirir.
- RAM: Daha küçük modeller (0,6B, 1,7B) bile birkaç gigabayt RAM gerektirir. Daha büyük modeller (8B, 14B, 32B, 30B-A3B), Ollama tarafından kullanılan nicemleme düzeyine bağlı olarak genellikle 16GB, 32GB ve hatta 64GB+ daha fazlasına ihtiyaç duyar.
- VRAM (GPU): Kabul edilebilir bir performans için, yeterli VRAM'e sahip özel bir GPU şiddetle tavsiye edilir. Ollama, uyumlu GPU'ları (NVIDIA, Apple Silicon) otomatik olarak kullanır. VRAM miktarı, çıkarımı önemli ölçüde hızlandıran, tamamen GPU'da rahatça çalıştırabileceğiniz en büyük modeli belirler.
- CPU: Ollama, modelleri CPU'da çalıştırabilse de, performans bir GPU'dakinden önemli ölçüde daha yavaş olacaktır.
Ollama, özellikle tüketici sınıfı donanımda (sınırlar dahilinde) hızlı başlangıç, yerel geliştirme, deneme ve tek kullanıcılı sohbet uygulamaları için mükemmeldir.
Ollama'yı vLLM ile Yerel Olarak Nasıl Çalıştırılır
vLLM, çıkarım hızını ve bellek verimliliğini önemli ölçüde artırmak için PagedAttention gibi optimizasyonlar kullanan, yüksek verimli bir LLM hizmet kitaplığıdır ve bu da onu talepkar uygulamalar ve daha büyük modellere hizmet vermek için ideal hale getirir. vLLM ekibi, Qwen3'ün piyasaya sürülmesinden itibaren 0. Gün desteği dahil olmak üzere yeni mimariler için mükemmel destek sağlar.
1. Kurulum:
vLLM'yi pip kullanarak kurun. Genellikle bir sanal ortam kullanmanız önerilir:
pip install -U vllm
Gerekli önkoşullara sahip olduğunuzdan emin olun, genellikle uygun bir CUDA araç takımı yüklü uyumlu bir NVIDIA GPU. Belirli gereksinimler için vLLM belgelerine bakın.
2. Qwen3 Modellerine Hizmet Verme:
vLLM, bir modeli yüklemek ve OpenAI uyumlu bir API sunucusu başlatmak için vllm serve komutunu kullanır. Qwen ekibi ve vLLM belgeleri, Qwen3'ü çalıştırma konusunda rehberlik sağlar.
Sağlanan bilgilere ve yaygın vLLM kullanımına dayanarak, büyük Qwen3-235B MoE modeline FP8 nicemlemesi (azaltılmış bellek kullanımı için) ve 4 GPU arasında tensör paralelliği kullanarak nasıl hizmet verebileceğiniz aşağıdadır:
vllm serve Qwen/Qwen3-235B-A22B-FP8 \
    --enable-reasoning \
    --reasoning-parser deepseek_r1 \
    --tensor-parallel-size 4
Bu komutu inceleyelim:
Qwen/Qwen3-235B-A22B-FP8: Bu, muhtemelen bir Hugging Face deposu konumuna işaret eden model tanımlayıcısıdır.FP8, bu kadar büyük bir model için çok önemli olan modelin bellek ayak izini azaltan 8 bit kayan nokta nicemlemesinin kullanımını gösterir.--enable-reasoning: Bu bayrak, Qwen3'ün hibrit düşünme yeteneklerini vLLM içinde etkinleştirmek için hayati öneme sahiptir.--reasoning-parser deepseek_r1: Qwen3'ün düşünme çıktısının belirli bir biçimi vardır. vLLM'nin bunu işlemesi için bir ayrıştırıcı gerekir. Blog yazısı, vLLM içindeepseek_r1ayrıştırıcısının kullanılması gerektiğini (SGLang'ınqwen3ayrıştırıcısı kullanırken) belirtir. Bu, vLLM'nin düşünme adımlarını nihai yanıttan doğru bir şekilde yorumlamasını ve potansiyel olarak ayırmasını sağlar.--tensor-parallel-size 4: Bu, vLLM'ye modelin ağırlıklarını ve hesaplamayı 4 GPU arasında dağıtmasını bildirir. Tensör paralelliği, tek bir GPU'ya sığamayacak kadar büyük modelleri çalıştırmak için gereklidir. Bu sayıyı mevcut GPU'larınıza göre ayarlarsınız.
Bu komutu diğer Qwen3 modelleri (örneğin, Qwen/Qwen3-30B-A3B veya Qwen/Qwen3-32B) için uyarlayabilir ve donanımınıza göre tensor-parallel-size gibi parametreleri ayarlayabilirsiniz.
3. vLLM Sunucusu ile Etkileşim:vllm serve çalıştıktan sonra, OpenAI API spesifikasyonunu yansıtan bir API sunucusuna (varsayılan olarak http://localhost:8000) ev sahipliği yapar. Standart araçları kullanarak onunla etkileşimde bulunabilirsiniz:
- curl:
curl http://localhost:8000/v1/completions \
    -H "Content-Type: application/json" \
    -d '{
        "model": "Qwen/Qwen3-235B-A22B-FP8", # Hizmet verdiğiniz model adını kullanın
        "prompt": "LLM'lerde Mixture-of-Experts kavramını açıklayın.",
        "max_tokens": 150,
        "temperature": 0.7
    }'
- Python OpenAI İstemcisi:
from openai import OpenAI

# Yerel vLLM sunucusuna işaret edin
client = OpenAI(base_url="http://localhost:8000/v1", api_key="EMPTY")

completion = client.completions.create(
  model="Qwen/Qwen3-235B-A22B-FP8", # Hizmet verdiğiniz model adını kullanın
  prompt="Müzik keşfeden bir robot hakkında kısa bir hikaye yazın.",
  max_tokens=200
)
print(completion.choices[0].text)
4. Performans ve Kullanım Durumları:
vLLM, yüksek verim (saniye başına birçok istek) ve düşük gecikme süresi gerektiren senaryolarda parlar. Optimizasyonları onu şunlar için uygun hale getirir:
- Yerel LLM'ler tarafından desteklenen uygulamalar oluşturma.
- Modellere aynı anda birden fazla kullanıcıya hizmet verme.
- Çoklu GPU kurulumları gerektiren büyük modelleri dağıtma.
- Performansın kritik olduğu üretim ortamları.
Apidog ile Ollama Yerel API'sini Test Etme
Apidog, Ollama'nın API moduyla iyi eşleşen bir API test aracıdır. İstek göndermenize, yanıtları görüntülemenize ve Qwen 3 kurulumunuzu verimli bir şekilde hata ayıklamanıza olanak tanır.
Apidog'u Ollama ile kullanma şekli:
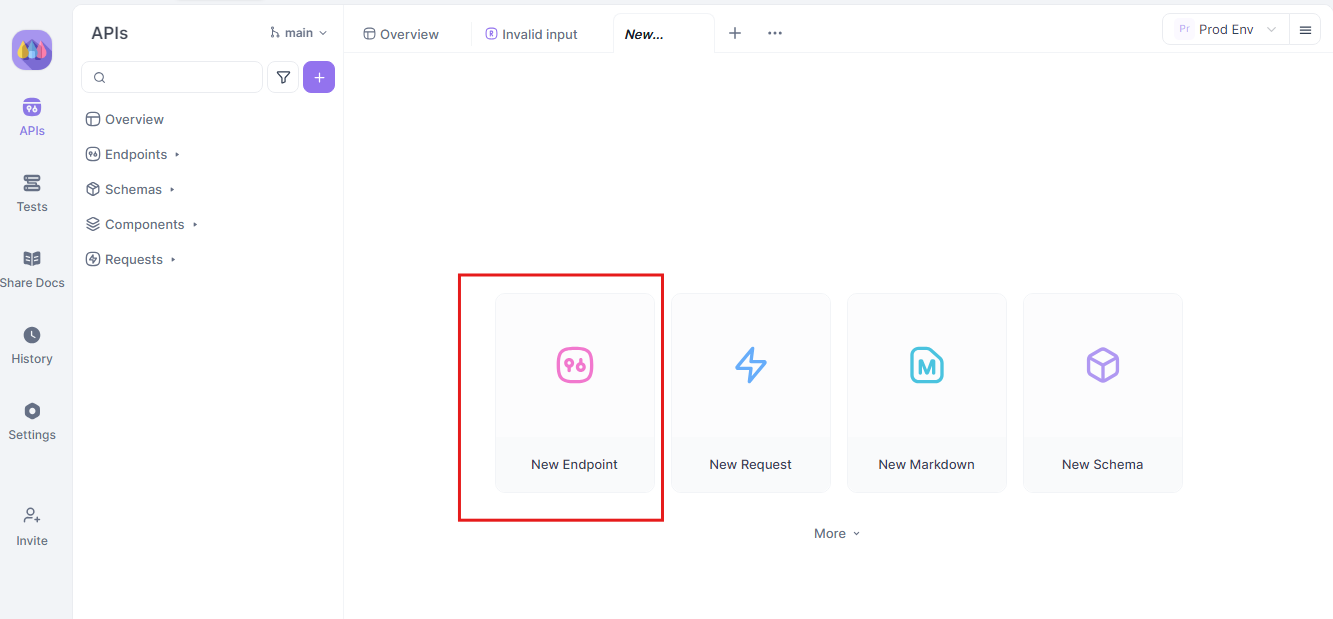
- Yeni bir API isteği oluşturun:
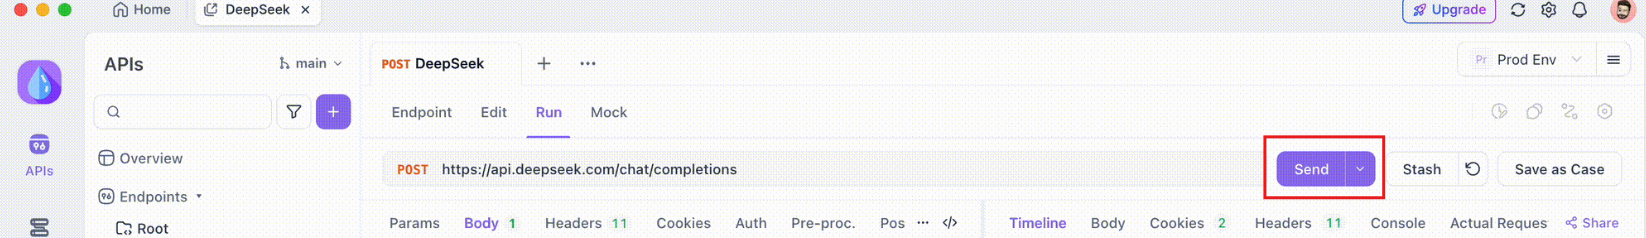
- Uç Nokta:
http://localhost:11434/api/generate - İsteği gönderin ve yanıtı Apidog'un gerçek zamanlı zaman çizelgesinde izleyin.
- Yanıtları otomatik olarak ayrıştırmak için Apidog'un JSONPath çıkarma özelliğini kullanın; bu özellik Postman gibi araçlardan daha üstündür.
Akış Yanıtları:
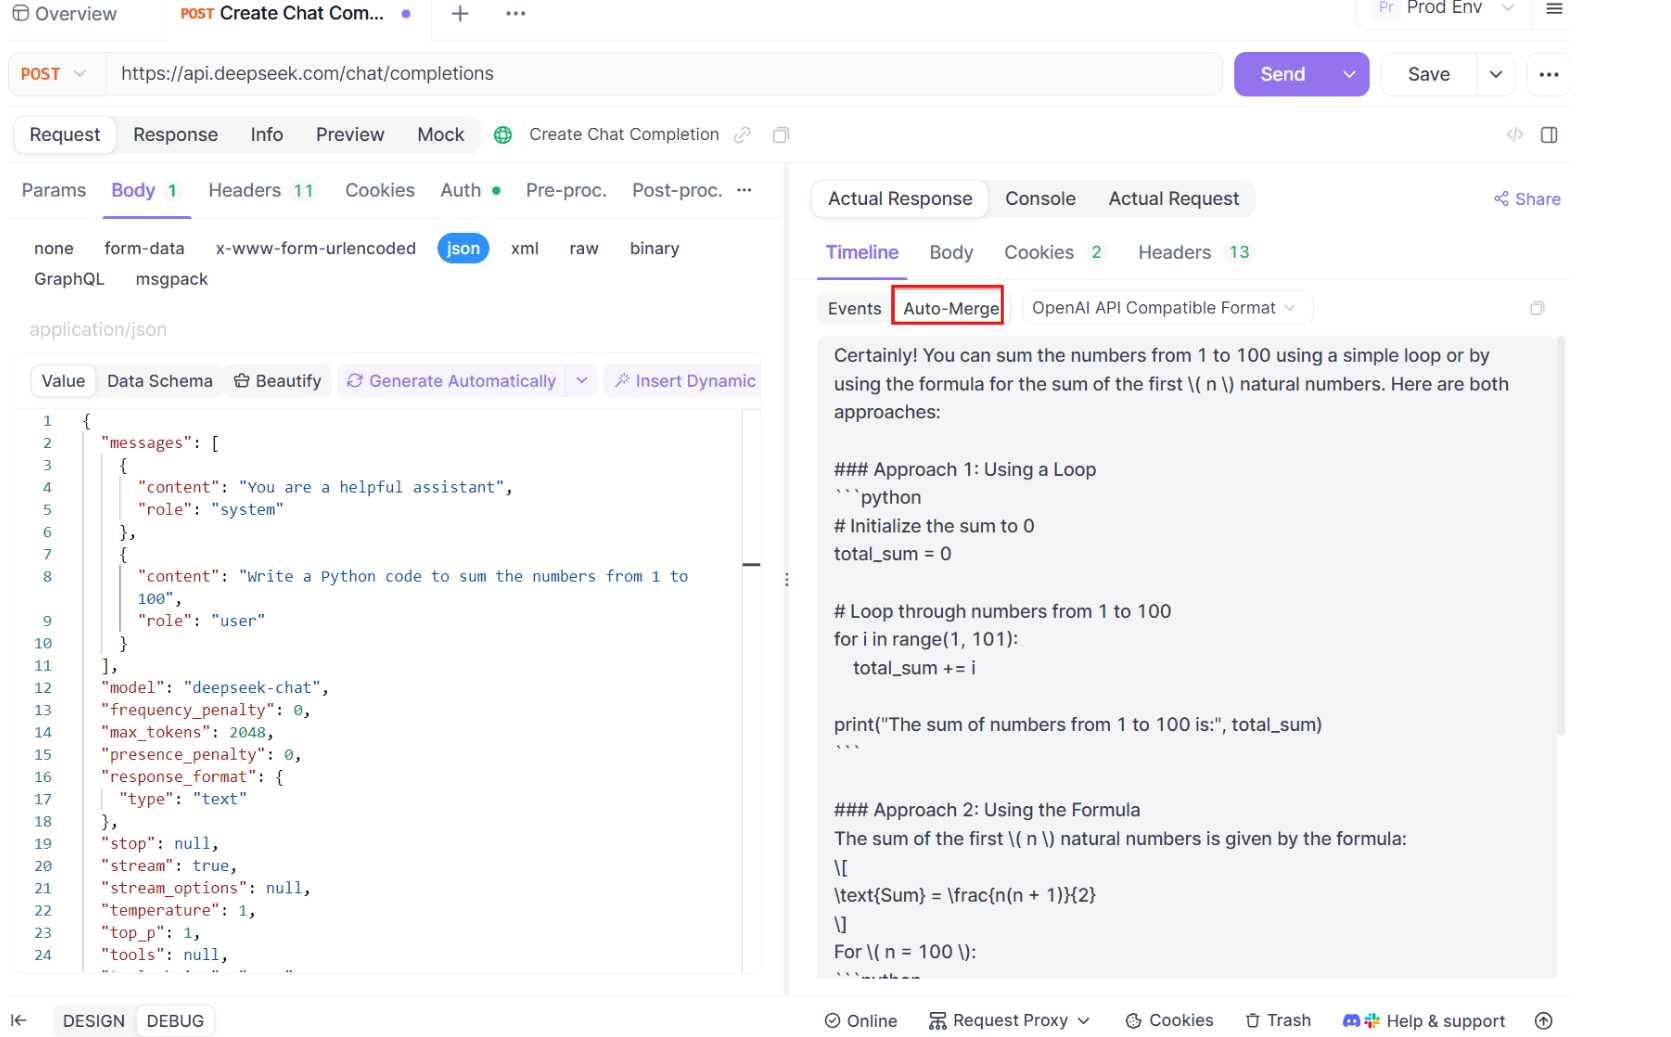
- Gerçek zamanlı uygulamalar için akışı etkinleştirin:
- Apidog'un Otomatik Birleştirme özelliği, akışlı mesajları birleştirerek hata ayıklamayı basitleştirir.
curl http://localhost:11434/api/generate -d '{"model": "gemma3:4b-it-qat", "prompt": "AI hakkında bir şiir yazın.", "stream": true}'
Bu işlem, modelinizin beklendiği gibi çalıştığından emin olur ve Apidog'u değerli bir ek yapar.
Sonuç
Güçlü ve çeşitli Qwen3 model ailesinin piyasaya sürülmesi, Ollama ve vLLM gibi olgun yerel yürütme araçlarıyla birleştiğinde, yapay zeka uygulayıcıları için heyecan verici bir zamanı işaret ediyor. İster kişisel kullanım ve denemeler için Ollama'nın tak ve çalıştır basitliğine, ister sağlam uygulamalar oluşturmak için vLLM'nin yüksek performanslı hizmet yeteneklerine öncelik verin, son teknoloji LLM'leri yerel olarak çalıştırmak her zamankinden daha mümkün.
Qwen3-30B-A3B'yi ve hatta daha büyük yoğun varyantları kendi donanımınıza getirerek, benzeri görülmemiş kontrol, gizlilik ve maliyet etkinliği elde edersiniz. Yenilikçi projeler için hibrit düşünme ve kapsamlı çok dilli destek gibi gelişmiş özelliklerinden yararlanabilirsiniz. Donanım ve yazılım ekosistemleri gelişmeye devam ettikçe, büyük dil modellerinin gücü giderek daha fazla demokratikleşecek ve uzak bulut sunucularından doğrudan yerel makinelerimize taşınacaktır. Bu yerel yapay zeka devriminin ön saflarını deneyimlemek için Ollama ve vLLM'yi kullanarak Qwen3'ü deneyin.
Geliştirici Ekibinizin birlikte maksimum verimlilikle çalışması için entegre, Hepsi Bir Arada bir platform mu istiyorsunuz?
Apidog tüm taleplerinizi karşılıyor ve Postman'in yerini çok daha uygun bir fiyata alıyor!


