
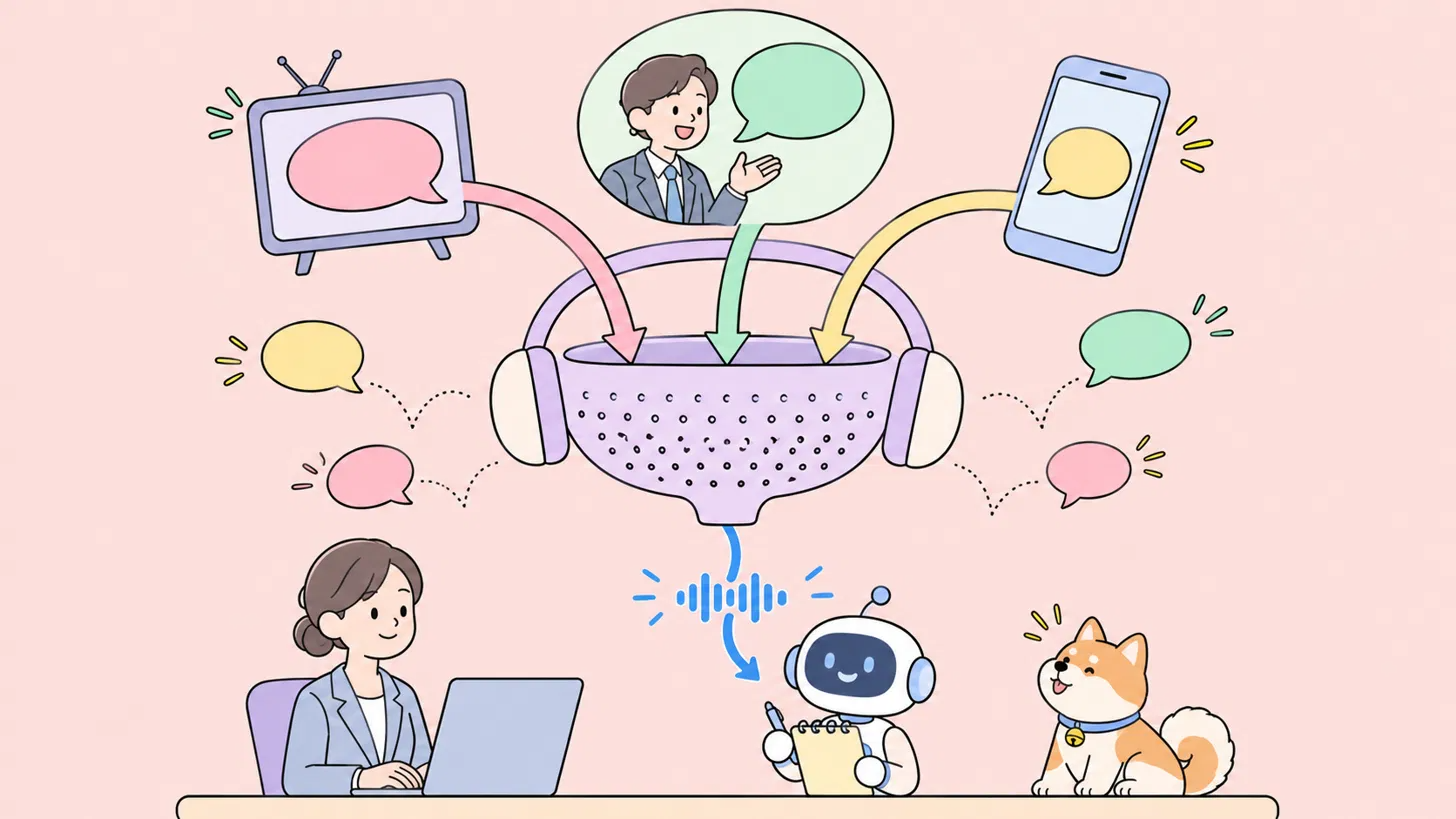
음성 에이전트가 실제 통화에서 문제를 일으킬 때, 원인은 LLM이나 음성이 아닌 경우가 많습니다. 문제는 그보다 한 단계 앞, 즉 에이전트가 듣는 오디오에서 시작됩니다. 오디오가 음성 인식(STT)으로 들어가든, 음성 대 음성(speech-to-speech) 모델로 바로 들어가든 마찬가지입니다. 최신 STT는 교통 소음이나 에어컨 소음은 잘 처리합니다. 하지만 다른 사람이 말하는 목소리는 처리하지 못합니다. 동료의 말소리, TV 소리, 콜센터에서 옆 자리 에이전트의 목소리처럼요. STT는 이런 소리까지 듣고, 상대방이 실제로 말하지 않은 단어를 에이전트가 마치 통화 내용인 것처럼 처리하게 됩니다.
Krisp Voice Isolation은 STT 앞단에 배치되어 주요 화자의 목소리를 제외한 모든 목소리를 제거합니다. 이번 리뷰를 위해 저는 Krisp의 벤치마크와 문서를 읽고, 셀프서비스 API에 가입한 뒤, Krisp의 공개 데이터셋에 있는 실제 녹음 파일 8개를 API에 통과시켜 보았습니다. 그런 다음 처리 전후 오디오를 오픈소스 STT 모델로 전사(transcribe)하여 실제로 무엇이 달라졌는지 확인했습니다.
한 줄 결론: 여러분의 에이전트가 사무실, 가정, 콜센터 등 배경에서 사람들이 말하는 어떤 환경에서도 전화를 받는다면, Voice Isolation을 파이프라인에 넣을 가치가 충분합니다. 제 테스트에서 가짜 전사 결과로 331단어나 된 배경 음성이 0으로 떨어졌습니다. 트레이드오프도 존재하지만 작습니다. 깨끗한 전화 음성에서 약간의 비용, API 지역이 미국으로 한정된 점, 그리고 SDK에 비해 API에서 제공되는 모델이 적다는 점입니다.
문제의 본질: 배경 소음이 아니라 배경 속 목소리
STT 모델은 음성을 인식하도록 학습되었을 뿐, 어떤 목소리가 중요한지 판단하도록 만들어지지 않았습니다. 소음은 음성처럼 보이지 않기 때문에 필터링할 수 있지만, 다른 사람의 목소리는 실제 음성이기 때문에 음성과 완전히 똑같이 보입니다.
Krisp의 예시가 이를 잘 보여줍니다. 전화를 건 사람이 구독을 취소해 달라고 요청하는 동안, 근처에 있던 동료가 점심에 대해 묻는 상황입니다. STT는 어느 말이 전화 건 사람의 것인지 구분할 표시 없이 하나의 텍스트 스트림을 반환하고, 결국 상담 에이전트는 두 요청을 하나로 받아들이게 됩니다.
이 문제는 음성 에이전트를 세 가지 방식으로 무너뜨립니다:
- 잘못된 전사 결과. 주변 사람의 말이 전사 텍스트에 포함되고, LLM은 전화 건 사람이 한 적 없는 말에 응답하게 됩니다.
- 거짓 끼어들기 감지. 에이전트는 주변 사람의 목소리를 듣고 전화 건 사람이 말을 끊었다고 판단해, 하던 말을 중간에 멈춥니다.
- 말차례 판단 실패. 배경 목소리 때문에 전화 건 사람이 아직 말하고 있는 것처럼 보여, 에이전트가 말차례가 끝났는지 알 수 없습니다.
어떤 경우든 에이전트의 로직은 설계된 대로 정상 작동하고 있습니다. 다만 원래 들어서는 안 되는 목소리에 반응하고 있을 뿐입니다.
수치는 이 격차가 얼마나 큰지 보여줍니다. Krisp의 Voice Isolation 2.5 출시 테스트에서 10개 STT 시스템은 깨끗한 단일 화자 오디오에서 평균 2.10%의 단어 오류율(WER)을 기록했습니다. 그러나 다른 사람이 전화 건 사람의 말을 겹쳐 말하면 같은 시스템들의 평균 오류율은 35.92%로 급증했습니다. 소음 억제 기술로는 이 격차를 해소할 수 없는데, 방해 요소가 소음이 아니라 음성이기 때문입니다.
Krisp Voice Isolation이란 무엇인가
Krisp Voice Isolation API & SDK는 실시간 오디오 스트림에서 배경 목소리와 잡음을 제거하고 주 화자의 목소리만 전달합니다. 음성 AI 에이전트를 위해 설계되었으며, Krisp가 Background Voice Cancellation(BVC)이라는 이름으로 일반 통화용으로 제공하는 것과 동일한 핵심 기술입니다.
이 기능은 에이전트 파이프라인의 가장 앞단에 위치하기 때문에, 이후의 모든 모델은 하나의 목소리만 듣게 됩니다:
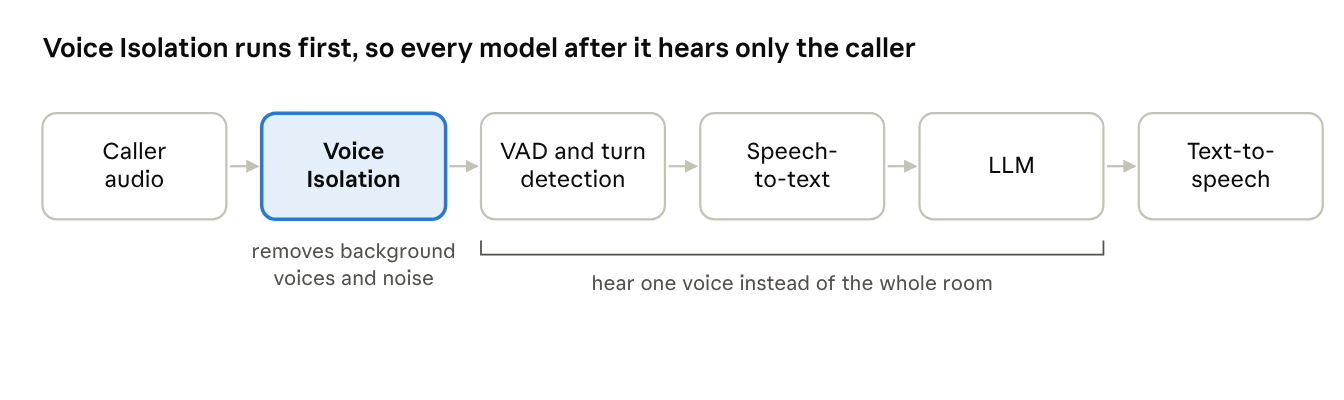
음성 에이전트 파이프라인에서 Voice Isolation이 위치하는 곳
이 위치가 중요한 이유는 다음과 같습니다. Voice Isolation이 없으면 VAD와 발화(turn) 감지가 옆사람의 목소리까지 듣게 되고, 이것이 허위 끼어들기(false interruption)가 발생하는 원인입니다.
Krisp는 약 9년간 음성 AI 분야에 매진해 왔으며, 연간 1조 분 이상의 음성을 처리한다고 밝히고 있습니다. Voice Isolation은 음성 AI API 및 SDK 라인업에 포함된 제품 중 하나입니다. Voice Isolation은 Krisp의 음성 에이전트용 실시간 모델 모음인 VIVA의 일부로, Turn-Taking, Interrupt Prediction, VAD와 함께 제공됩니다. Turn-Taking을 대체하는 것이 아니라 이와 함께 작동합니다.
이 네 가지 모델을 통해 배경 목소리와 소음을 얼마나 공격적으로 제거할지 조절할 수 있습니다. 최대 공격성(기본 설정)인 Default가 가장 많이 제거합니다. Balanced는 동일한 연산량으로 주요 음성을 더 가볍게 처리합니다. Lite는 Default 연산량의 약 3분의 1을 사용합니다. HD는 전화 음성이 아닌 32 kHz WebRTC 스트림용입니다. 공격성은 연산량을 바꾸지 않고도 조정할 수 있는 런타임 설정이며, API에서는 suppression_level 파라미터로 0부터 100까지 지정할 수 있습니다.
미리 알아두면 좋은 한 가지 제한 사항: 음성 제거 모델은 화자가 마이크에 가까이 있다고 가정합니다. 대략적인 기준으로, 약 30cm를 넘으면 주요 화자 본인의 목소리까지 억제될 수 있습니다. 이는 엄격한 규칙이 아니라 일반적인 권장 사항이며, 실제 거리는 음향 환경에 따라 달라집니다. 스마트 스피커와 같은 원거리(far-field) 기기의 경우, Krisp는 소음만 제거하는 별도의 모델을 제공합니다.
버전 2.5는 2026년 8월에 출시되었으며, Krisp는 9월에 공개 벤치마크와 데이터셋을 발표했습니다. 해당 모델은 이제 SDK뿐만 아니라 셀프서비스 API로도 이용할 수 있습니다.
Krisp 벤치마크 결과가 보여주는 것
Krisp의 공개 벤치마크에서 Voice Isolation은 평균 단어 오류율(WER)을 23.24%에서 6.24%로, 무려 73%나 낮췄습니다.
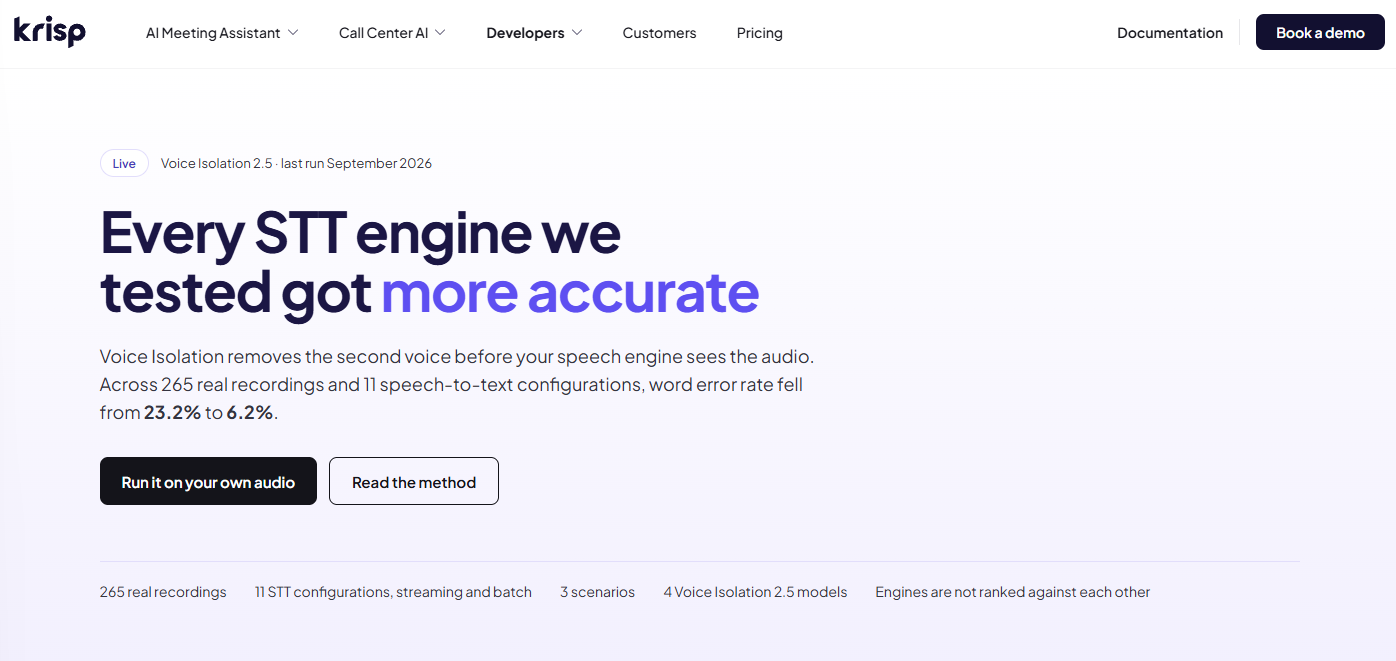
Krisp의 벤치마크 페이지에 핵심 결과가 정리되어 있습니다.
이 벤치마크는 사무실, 가정, 콜센터 4개 작업 층, 자동차에서 수집한 265개의 실제 녹음 파일을 사용했습니다. 시뮬레이션이나 사후 믹싱은 전혀 없습니다. 대부분의 녹음은 같은 시나리오를 따릅니다. 주 화자가 말을 하다가, 다른 사람이 끼어들고, 주 화자가 침묵하는 동안 상대는 계속 말을 한 뒤, 주 화자가 다시 말을 시작합니다. 이 침묵 구간이 진짜 시험 대상인데, 이 구간의 정답 전사(transcript)는 아무것도 없어야 하기 때문입니다. 각 파일은 9개 엔진의 11가지 STT 구성으로, isolation 적용 여부에 따라 각각 테스트되었습니다.
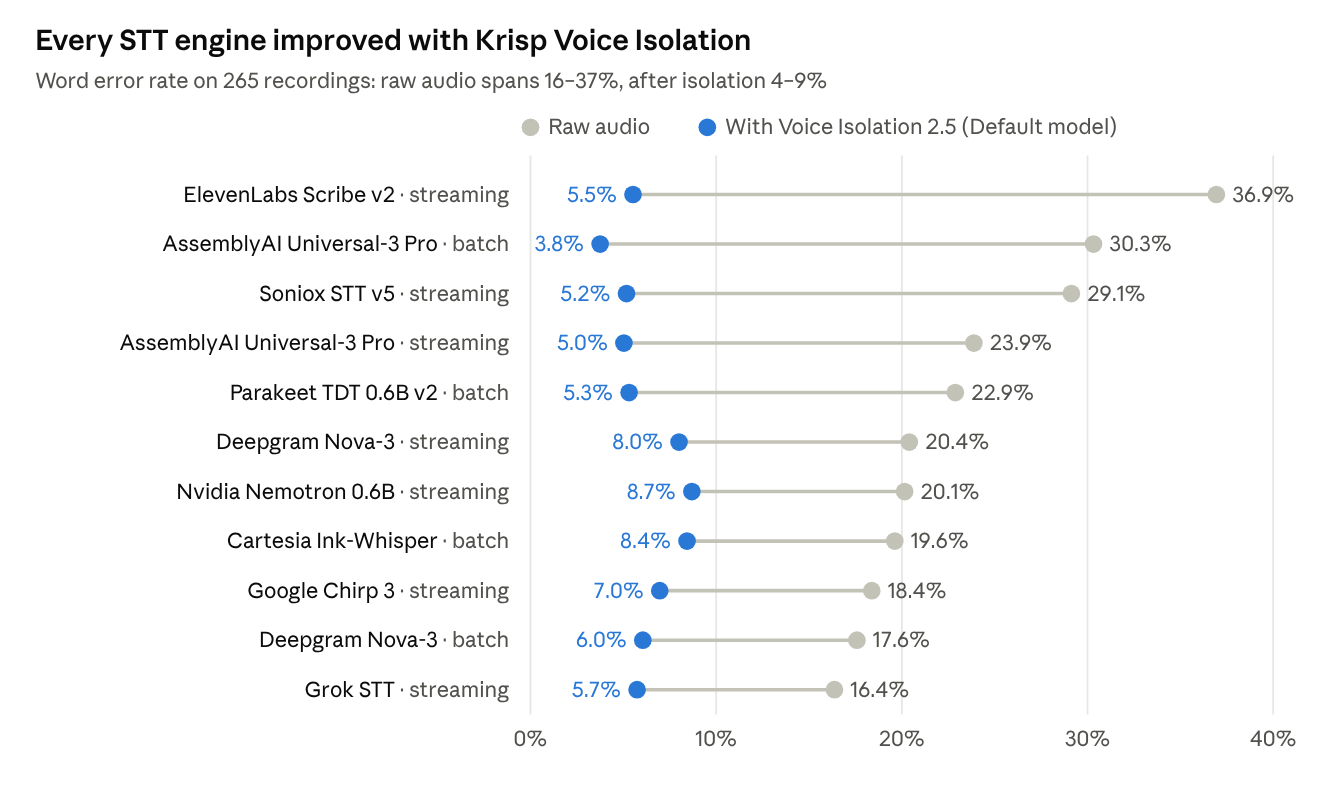
출처: Krisp voice isolation 벤치마크, 2026년 10월 · 11가지 STT 구성, 모든 시나리오 통합
모든 엔진이 개선되었고, 오히려 나빠진 곳은 없습니다. 더 주목할 만한 결과는 엔진 간 격차의 변화입니다. 원본 오디오에서는 약 20포인트에 달하던 격차가 isolation 적용 후 약 5포인트로 좁혀집니다. 즉, 에이전트가 배경 소리를 듣고 있다면, STT 벤더를 바꾸는 것보다 입력 오디오를 정제하는 것이 WER을 더 크게 개선합니다.
시나리오별로 살펴보면, 개선 폭은 다른 사람의 목소리가 존재하는지에 따라 달라집니다.
효과가 없는 경우
Krisp는 자사 제품의 약점을 공개하는데, 이 글에서 가장 설득력 있는 부분이라고 생각합니다.
- 깨끗한 전화 음성은 오히려 약간 나빠집니다. 제거할 두 번째 목소리가 없으면 격리(isolation)는 주요 목소리에만 영향을 줄 수밖에 없습니다. 전화 통화 WER은 3.48%에서 3.91%로 상승했고, 한 파일은 9.42%에서 21.65%로 나빠졌습니다. Balanced 모델이 3.53%로 이 영역에서 가장 좋은 성능을 보입니다.
- 심한 에코는 여전히 문제입니다. 별도로 진행된 2.5 릴리스 테스트에서 열악한 음향 환경의 1인 녹음은 격리 적용 시 11.61%, 미적용 시 8.02%를 기록했습니다. 버전 2.1(15.42%)보다는 훨씬 나아졌지만, 여전히 아무것도 하지 않는 것보다는 나쁩니다.
- 과도한 격리는 무음(침묵) 오류를 유발합니다. Krisp는 이전 모델이 때때로 주요 목소리의 일부까지 제거했다고 설명합니다. 사람은 음성을 여전히 이해할 수 있었지만, STT는 문구 전체를 누락했고, 전사 결과는 겉보기에 깔끔하게 읽히지만 구멍이 뚫린 것처럼 나타났습니다. 이 문제를 해결하기 위해 버전 2.5는 사람의 귀가 아닌 STT에 맞춰 조정되었습니다.
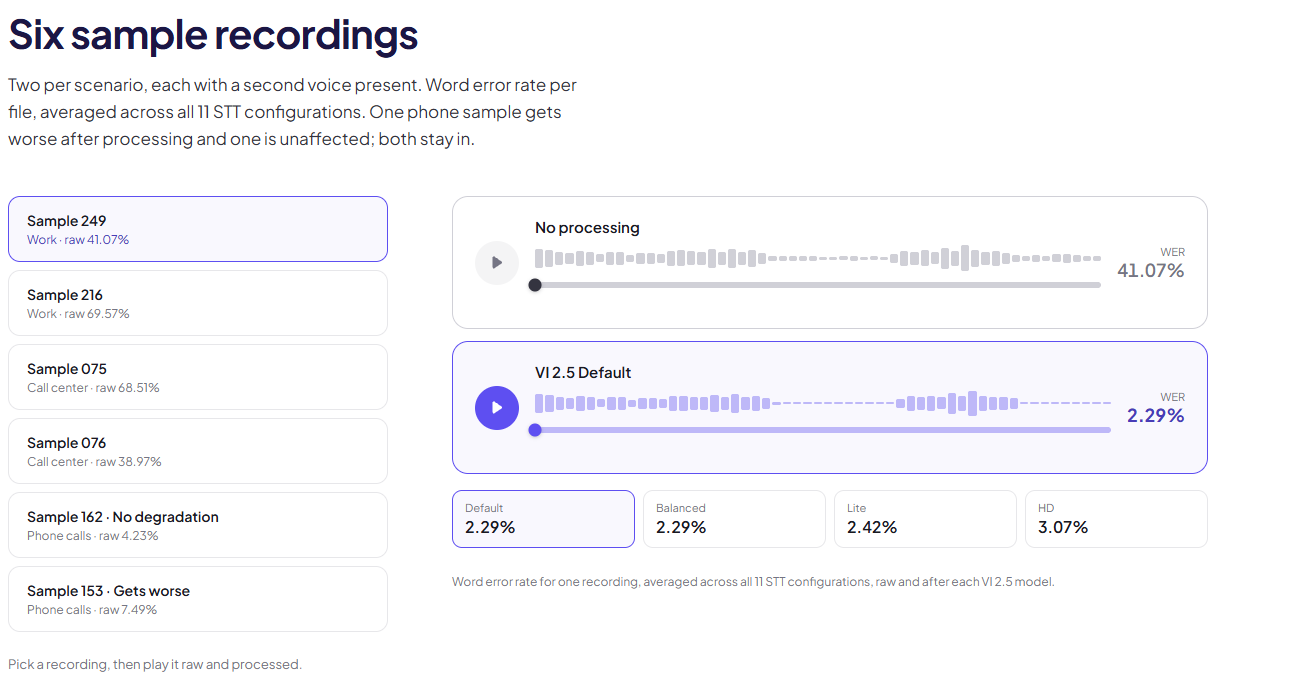
벤치마크 페이지에서는 여섯 개의 녹음 파일을 원본과 처리된 상태로 재생해 볼 수 있습니다. 전화 통화인 샘플 153은 "Gets worse(나빠짐)"로 표시되어 있습니다.
또한 염두에 둘 두 가지가 있습니다. Krisp 사이트에서 볼 수 있는 73% 수치와 46.4% 수치는 서로 다른 테스트에서 나온 것입니다. 하나는 공개 벤치마크의 265개 녹음 파일, 다른 하나는 2.5 릴리스 테스트의 1,685개 녹음 파일입니다. 그리고 Krisp의 결과는 자사 격리 기술 적용 여부에 따른 비교일 뿐, 다른 벤더의 격리 제품과의 비교가 아닙니다.
녹음 파일, 수작업 전사본, 세그먼트 라벨, 모든 모델의 출력 결과는 Hugging Face에 공개되어 있어 누구나 테스트를 다시 실행해 볼 수 있습니다. 저도 그렇게 했고, 그 내용은 다음에 이어집니다.
실습: Voice Isolation API 테스트해 보기
직접 테스트해 본 결과, Voice Isolation은 트랜스크립트에서 배경 대화를 한 단어도 남기지 않고 제거했으며, 전체 WER은 40.1%에서 10.2%로 낮아졌습니다.
설정
Developers Portal 가입은 Google, Microsoft 또는 이메일 로그인으로 빠르게 할 수 있습니다. 체험판에서는 $30 크레딧과 동시 세션 2개라는 제한이 주어집니다. 이후 API Keys → Create key로 이동하면 키가 발급되는데, 이 키는 한 번만 복사할 수 있습니다.
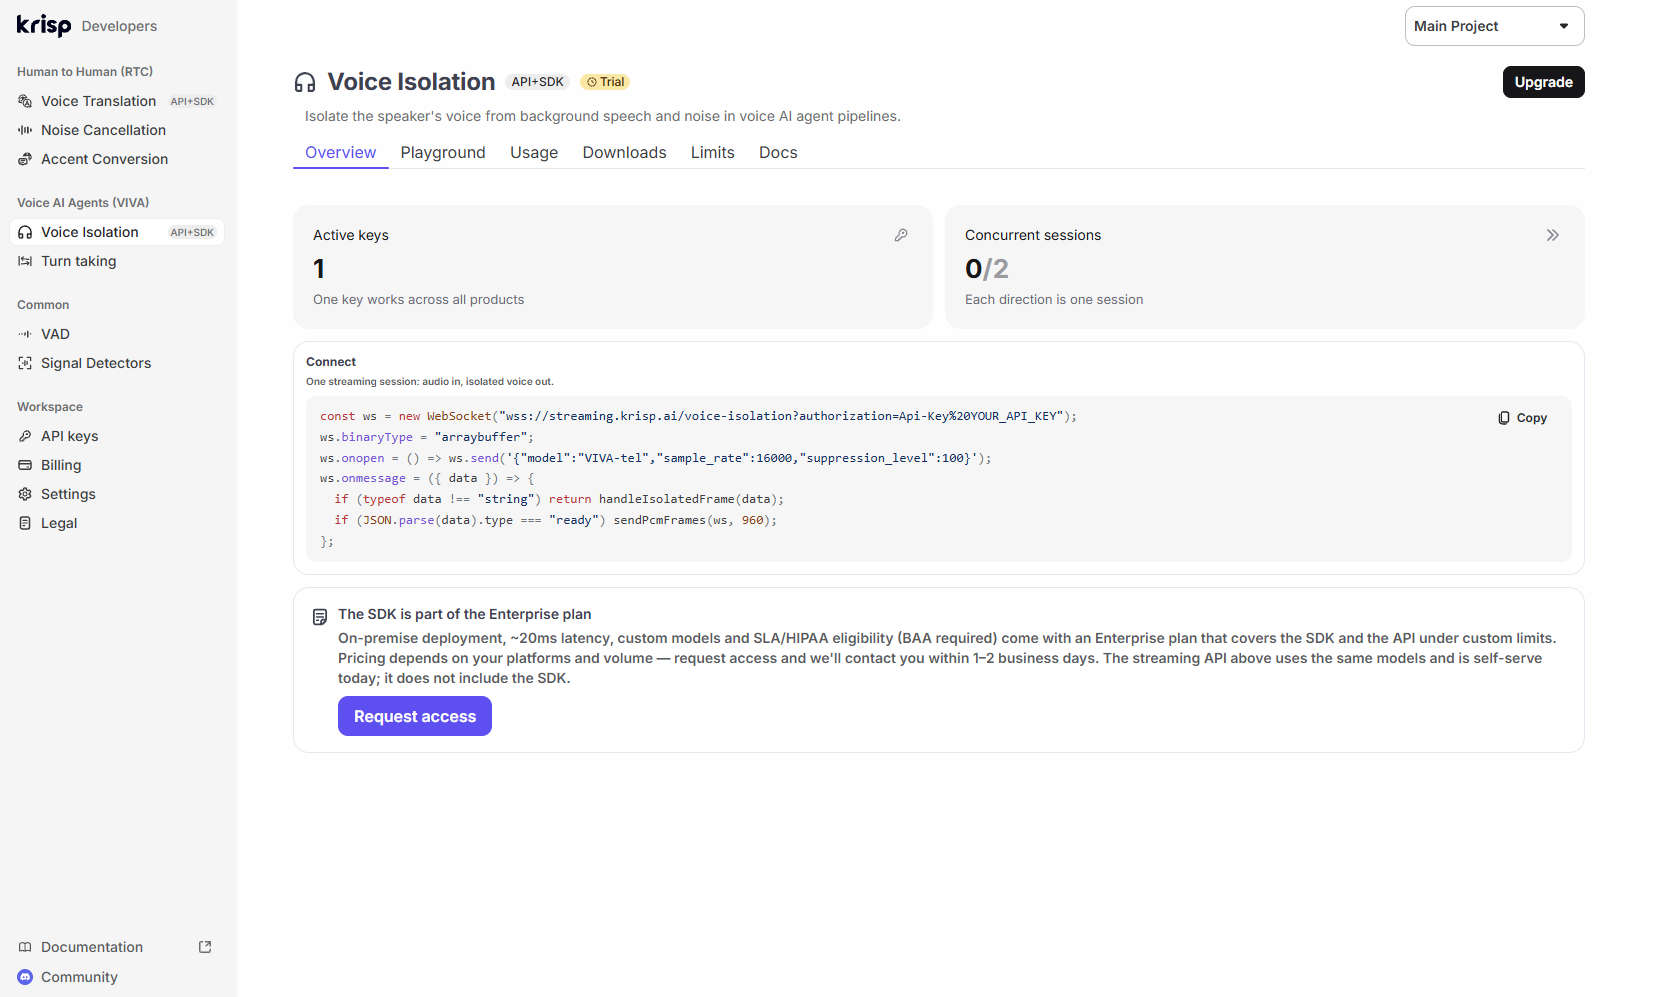
체험 플랜 기준 Developers Portal의 Voice Isolation 페이지.
이 리뷰를 위해 생성한 API 키. 하나의 키로 Voice Translation API를 포함한 모든 Krisp API 제품에서 사용할 수 있습니다.
이 API는 WebSocket 기반입니다. 백엔드에서 API 키를 단기 세션 토큰으로 교환하고, 클라이언트가 작은 JSON hello 메시지를 보내 ready를 기다린 뒤, 16비트 모노 PCM을 스트리밍하면 정제된 오디오를 프레임 단위로 돌려받습니다:
URL = "wss://streaming.krisp.ai/voice-isolation"async with websockets.connect(URL, additional_headers={"Authorization": f"api-key {session_token}"}) as ws: await ws.send(json.dumps({"model": "VIVA-tel", "sample_rate": 16000, "suppression_level": 100})) hello = json.loads(await ws.recv()) # {"type": "ready", ...} # then send exactly 30 ms of audio per message (960 bytes at 16 kHz) # and write each binary message you receive to your output
이 코드는 WAV 파일을 정제하는 짧은 Python 스크립트인 Krisp의 API 퀵스타트와 거의 유사합니다. 한 가지 주의할 규칙이 있습니다. 모든 오디오 메시지는 정확히 30ms여야 합니다. 그렇지 않으면 invalid_frame_duration 오류와 함께 세션이 종료되므로, 마지막 프레임은 무음으로 패딩해야 합니다.
테스트를 위해 Krisp의 공개 데이터셋에서 여덟 개의 녹음 파일을 골랐습니다. 사무실 녹음 3개, 콜센터 현장 녹음 3개, 차량 안에서의 전화 통화 2개로 총 약 11분 분량입니다. 각 파일을 아시아에서 실시간 속도로 API를 통해 스트리밍했습니다. 그런 다음 원본 오디오와 정제된 오디오를 Krisp 벤치마크에 사용된 엔진 중 하나인 NVIDIA의 오픈소스 Parakeet TDT 0.6B v2로 트랜스크립션하고, 각 라벨링된 구간을 사람이 작성한 트랜스크립트와 비교해 점수를 매겼습니다.
결과
거의 모든 개선은 한 가지 지점에서 나왔습니다. 바로 메인 화자가 침묵하고 다른 사람이 계속 말을 하고 있던 구간입니다. 원본 오디오에서는 Parakeet이 그 배경 음성을 331단어 분량의 전사 텍스트로 변환했지만, Voice Isolation 적용 후에는 아무것도 생성하지 않았습니다. 해당 구간에서 배경 목소리는 메인 화자보다 13~34dB 작았으며, 메인 화자의 음량은 거의 변하지 않았습니다(1dB 이내).
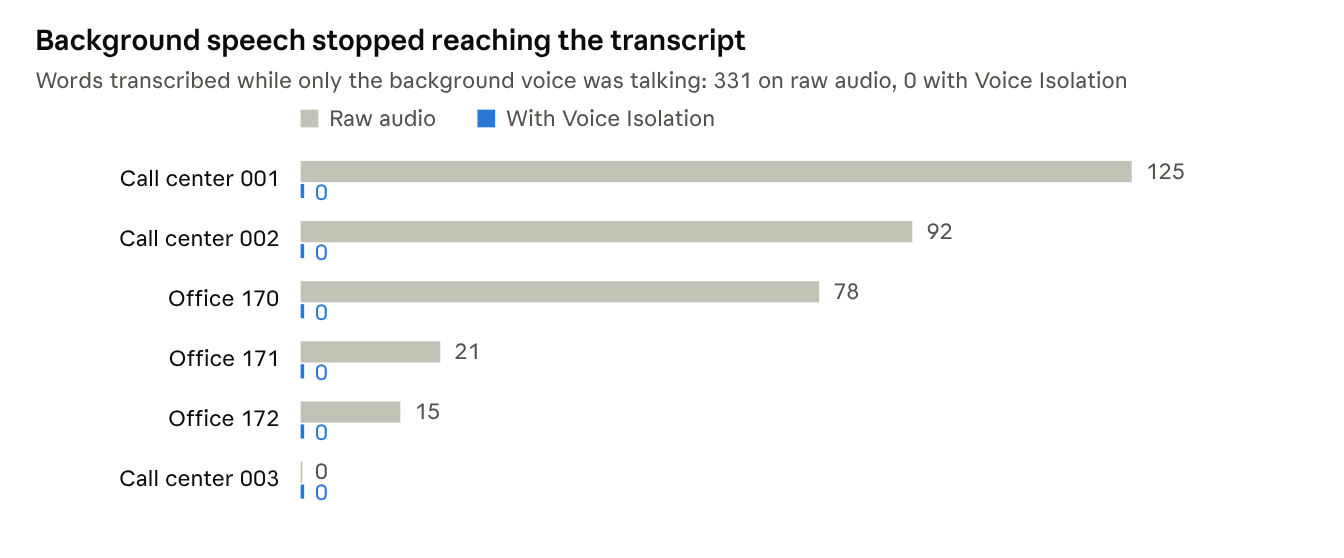
내 테스트 · Krisp API (VIVA-tel), Parakeet TDT 0.6B v2로 전사 · 배경 음성만 있는 구간이 포함된 6개 녹음 파일
콜센터 예시가 왜 이것이 중요한지 보여줍니다. 제가 테스트하던 상담원이 잠시 멈춘 동안, 옆자리 상담원은 다른 통화 중이었습니다. 원본 전사 결과는 그 통화를 한 단어도 빠짐없이 담아냈습니다:
thank you for calling meridian bank before i begin i will need to confirm your identity for security could you give me your full name your date of birth...
음성 에이전트는 이를 호출자의 말로 인식했을 것입니다. Voice Isolation을 적용하자 동일한 구간이 비어 있는 상태로 반환되었습니다.
두 사람이 동시에 말할 때는 변화가 작았습니다. 원본 13.2% 대비 정제 후 12.5%였습니다. Parakeet은 이미 그런 구간에서 더 크고 가까운 목소리를 우선하고 있었습니다. 남은 오류의 대부분은 제 채점 방식의 숫자 형식 문제(전화번호, 가격, 우편번호)로, 두 버전 모두에 동일하게 영향을 미쳤습니다.
깨끗한 두 개의 전화 통화 파일에서는 하나는 오류가 1개 늘었고 다른 하나는 2개 줄었습니다. 이는 깨끗한 오디오에서의 비용이 작다는 Krisp의 자체 분석 결과와 일치합니다.
미국 외 지역에서의 지연 시간과 안정성
이 API는 현재 미국 리전에서만 운영되며, Krisp 문서는 다른 지역의 클라이언트는 추가 지연이 발생할 것이라고 경고합니다. 아시아에서 측정한 프레임 하나의 왕복(전송 후 정제된 오디오 수신) 중앙값은 세션에 따라 260~520ms였고, 세션 설정에는 보통 1.5~3초가 걸렸습니다. 이는 네트워크 거리 때문이지 모델 때문이 아닙니다. Krisp는 알고리즘 지연 시간이 15ms라고 명시하고 있습니다. 하지만 에이전트가 미국에서 먼 지역의 사용자를 서비스한다면 그 차이를 체감하게 되며, 자체 서버에서 SDK를 실행하면 이를 피할 수 있습니다.
아홉 번의 세션 중 하나는 약 70초 지점에서 비정상 종료로 중단되었습니다. 다시 실행하자 정상 작동했습니다. 이는 서비스 자체보다는 아시아에서 오는 긴 네트워크 경로 탓으로 보지만, 프로덕션 환경에서는 재연결 처리를 반드시 해두어야 한다는 점을 상기시켜 줍니다.
이 테스트에 대해: 8개 파일은 작은 표본이며 벤치마크가 아닙니다. 저는 전화용 모델(VIVA-tel)을 위해 32kHz 녹음 파일을 16kHz로 리샘플링했고, 하나의 STT 엔진만 사용했으며, 텍스트 정규화도 단순하게 유지했기 때문에 제 절대 수치는 Krisp의 수치와 비교할 수 없습니다. 제가 확인하려 했던 것은 변화의 방향과 크기였고, 그 결과는 Krisp가 보고한 내용과 일치했습니다.
개발자 경험: API 또는 SDK
Voice Isolation은 두 가지 방식으로 제공되며, 어떤 방식을 사용할 수 있는지는 이용 중인 플랜에 따라 다릅니다.
API는 가장 손쉬운 방법입니다. 모델 파일을 직접 배포할 필요도 없고 CPU에서 돌릴 것도 없습니다. 대신 트레이드오프가 있습니다. 오디오가 Krisp의 클라우드로 전송되고, 네 가지 모델 대신 두 가지 모델만 제공됩니다. 8 또는 16 kHz 전화 오디오용 VIVA-tel과 32 kHz 광대역 오디오용 VIVA-pro가 그것입니다. VIVA-pro는 아직 API 레퍼런스에는 없지만 포털의 Playground에는 있고, 제 테스트에서도 API가 이를 정상적으로 처리했으며 Krisp 측에서도 사용 가능함을 확인해 주었습니다.
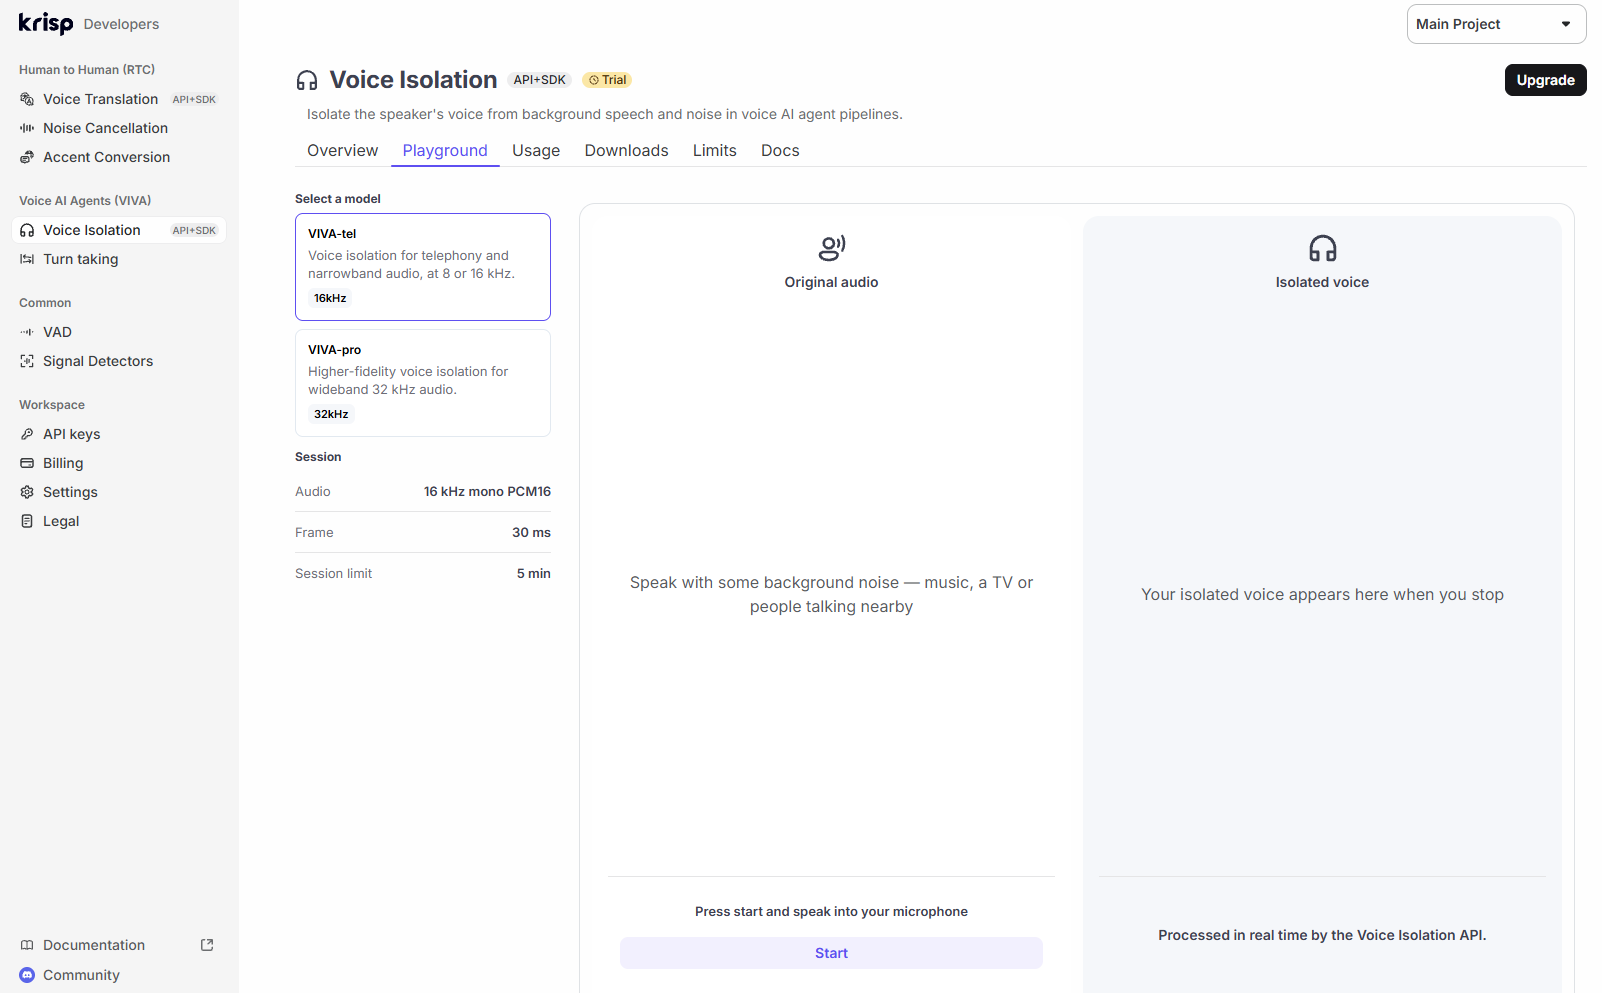
포털의 Playground에서는 코드를 작성하기 전에 자신의 마이크로폰으로 두 API 모델을 모두 테스트해 볼 수 있습니다.
SDK는 오디오를 자체 서버에 보관하고 라이선스 확인을 위해서만 온라인에 접속합니다. 비용 이야기가 흥미로워지는 부분도 바로 여기입니다. Krisp의 CPU 관련 포스트에 따르면, enableLowPrecisionExecution이라는 SDK 플래그 하나만 켜도 FP16을 지원하는 CPU에서 서버가 처리할 수 있는 통화량이 약 두 배가 됩니다. 16 vCPU AWS Graviton3 인스턴스에서는 라이브 통화 처리량이 76건에서 137건으로 늘어났고, Lite 모델은 전체 모델보다 약 3배 많은 스트림을 처리할 수 있습니다. 다만 구형 Intel Ice Lake 칩에서는 이 플래그가 아무 효과가 없습니다.
통합 지원
- Pipecat은 바로 사용할 수 있는 필터를 제공합니다. 트랜스포트의 오디오 입력 필터로 KrispVivaFilter()를 추가하면 되고, 턴 감지를 위해 KrispVivaTurn과 함께 사용할 수도 있습니다. 단, SDK를 사용하므로 API 키만으로는 부족하고 SDK 접근 권한과 모델 파일이 필요합니다.
- LiveKit은 LiveKit Cloud에서 Krisp 모델을 제공하며, 에이전트용 배경 음성 제거(noise_cancellation.BVC())도 포함됩니다. LiveKit의 음성 격리 모델은 추가 요금이 부과됩니다.
- WebRTC 및 전화(telephony) 파이프라인은 SDK를 직접 사용할 수 있고, WebSocket을 열 수 있는 환경이라면 무엇이든 API를 활용할 수 있습니다.
문서는 명확하고 최신 상태입니다. 퀵스타트는 첫 시도에 바로 동작했고, 오류 메시지도 기대 프레임 크기와 수신된 프레임 크기까지 정확히 무엇이 잘못됐는지 알려 줍니다. 유일하게 아쉬운 점은 명명 체계입니다. 블로그에서는 Default, Balanced, Lite, HD로 부르고, SDK 다운로드 파일명은 krisp-viva-vi-tel-v2.5.1 같은 형식이며, API에서는 모델을 VIVA-tel과 VIVA-pro로 부르는데 API 레퍼런스에는 첫 번째 모델만 등재되어 있습니다. 문서에 매핑 표가 있으면 도움이 될 것입니다.
가격 정책
이 API는 오디오 시간 단위로 과금되며, 비용이 저렴해서 가격 때문에 사용 여부를 고민할 일은 없습니다.
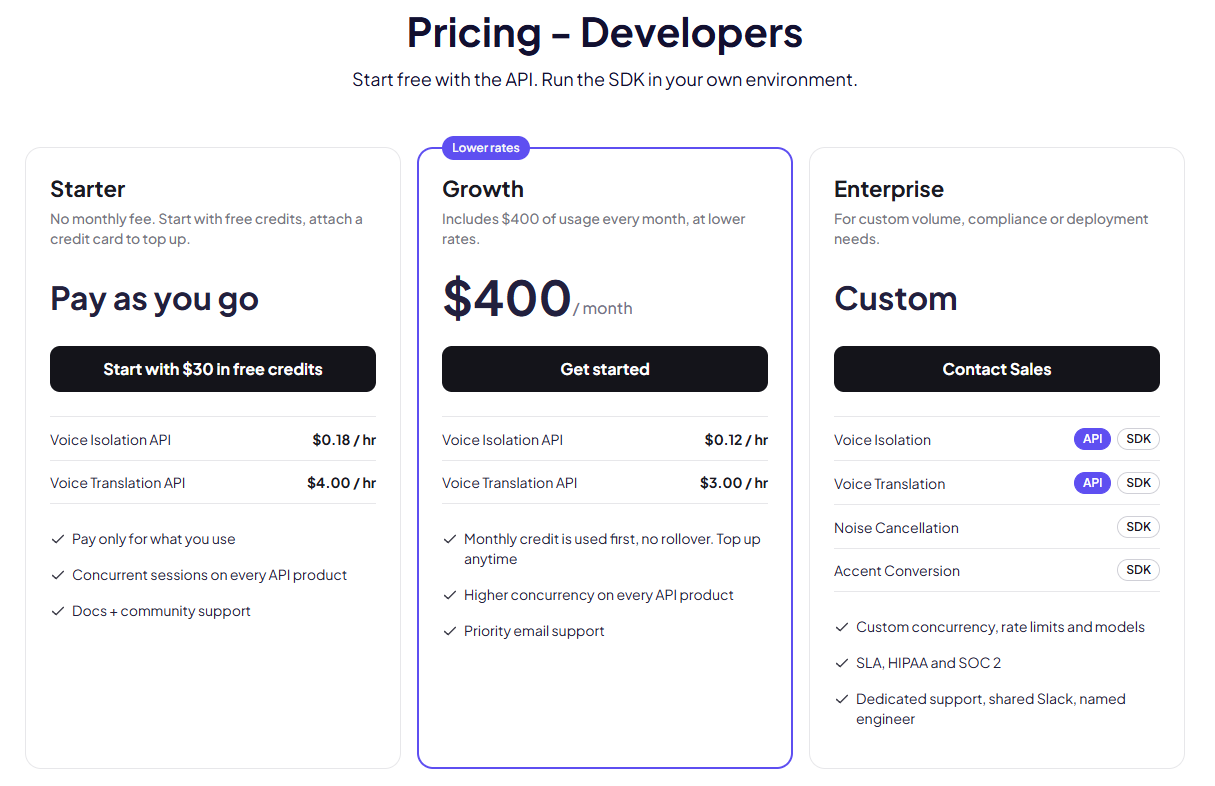
Krisp의 개발자용 가격 정책, 2026년 11월 기준.
종량과금제인 Starter 플랜에서 Voice Isolation API는 오디오 1시간당 $0.18이며 월정액은 없습니다. 요금은 VIVA-tel과 VIVA-pro 두 API 모델 모두 동일합니다. Growth는 월 $400으로, $400의 사용량이 포함되고 시간당 $0.12로 요금이 낮아지며, 더 높은 동시 처리량과 우선 지원이 제공됩니다. Enterprise는 맞춤 견적 방식이며, SDK, SLA, HIPAA 및 SOC 2를 포함하는 유일한 플랜입니다.
기본 제공 크레딧 $30은 Starter 요금 기준으로 약 166시간의 오디오를 처리할 수 있어 테스트용으로는 충분합니다. 크레딧은 12개월간 유효하며, 사용량은 분 단위로 과금됩니다. 참고로 Starter 플랜에서 5분 길이의 통화를 노이즈 제거하는 비용은 약 1.5센트입니다.
SDK는 Enterprise 플랜에서만 협의된 가격으로 제공되므로, 자체 서버에서 모델을 실행하려면 영업팀에 문의해야 합니다. 요금은 Krisp 가격 페이지에서 확인했으며, 2026년 11월 기준입니다.
대안들
Krisp가 배경 목소리 제거의 유일한 선택지는 아니지만, 아직 이러한 제품들을 독립적으로 비교 테스트한 결과는 존재하지 않습니다. 각 벤더가 자사 데이터를 기반으로 자체 수치를 발표하기 때문에, 아래 수치는 주장으로 간주해야 합니다.
Krisp가 돋보이는 점은 바로 그 근거입니다. 11가지 STT 환경을 대상으로 공개되고 재현 가능한 벤치마크를 제공하는 유일한 벤더이며, 자신이 열세인 사례까지 공개합니다. 배포 측면에서도 가장 유연합니다. 클라우드 API, 서버 내 SDK, 또는 LiveKit과 Pipecat에 내장된 형태로 사용할 수 있습니다.
결론
Krisp Voice Isolation은 실제 통화에서는 음성 에이전트가 오작동하지만 테스트 환경에서는 멀쩡히 작동할 때 손을 대볼 해결책입니다. 에이전트가 들어서는 안 되는 목소리를 걸러내고, 이미 사용 중인 어떤 STT와도 함께 동작하며, Krisp의 벤치마크와 제가 직접 진행한 테스트 모두 같은 사실을 보여줍니다. 배경 목소리가 더는 텍스트 변환 결과에 닿지 않습니다.
장점
- 단순 노이즈가 아닌 배경 목소리를 제거합니다. 이는 STT만으로는 해결할 수 없는 문제입니다
- 어떤 STT 엔진과도 호환되며, 언어별 설정이나 음성 등록이 필요 없습니다
- CPU에서 15 ms의 알고리즘 지연 시간으로 실행됩니다
- 자신이 불리한 케이스까지 포함한 공개되고 재현 가능한 벤치마크를 제공합니다
- 무료 크레딧 $30가 제공되는 셀프서브 API이며, 시간당 $0.12–$0.18로 저렴합니다
- 바로 쓸 수 있는 Pipecat 필터와 LiveKit 지원을 제공합니다
단점
- 깨끗한 전화 음성에서는 약간의 정확도 저하가 있고, 잔향이 심한 공간에서는 여전히 원본 오디오보다 성능이 떨어집니다
- API는 미국 리전에서만 실행되어, 다른 지역에서는 체감될 정도의 지연이 추가됩니다
- API는 SDK의 4개 모델 대비 2개 모델만 제공하며, 온프레미스 사용에는 Enterprise SDK가 필요합니다
이런 팀에게 적합합니다: 콜센터, 사무실, 가정, 차량 등 주변에서 다른 사람이 말하는 어떤 환경에서든 에이전트가 통화를 처리하는 팀입니다. 먼저 API로 자체 녹음 데이터에 미치는 효과를 측정해 보고, 다른 모델이 필요하거나 미국 외 지역에서 더 낮은 지연 시간이 필요하거나, 오디오가 자체 서버에 머물러야 한다면 SDK로 전환하세요.
이런 경우에는 불필요합니다: 발신자가 거의 항상 조용한 방에서 혼자만 있는 에이전트나, 스마트 스피커 같은 원거리 음성 기기에는 적합하지 않습니다. 음성 제거 모델은 이런 환경을 위해 설계되지 않았습니다.
무료 크레딧으로 Krisp Voice Isolation API를 사용해 보고, 오후 몇 시간 만에 직접 녹음한 데이터를 돌려 결과를 확인할 수 있습니다.
FAQ
음성 격리는 노이즈 캔슬링과 같은 건가요? 아닙니다. 노이즈 캔슬링은 교통 소음이나 키보드 소리 같은 비음성 소리를 제거합니다. 음성 격리는 여기에 더해 다른 사람의 목소리까지 제거하며, 이는 노이즈 캔슬링이 걸러내지 못하는 부분입니다.
Krisp Voice Isolation은 제 STT 공급자와 함께 작동하나요? 네. 오디오 자체를 처리하기 때문에 어떤 STT 엔진 앞단에서도 작동합니다. Krisp는 Deepgram, AssemblyAI, ElevenLabs, Soniox, Google, Cartesia, NVIDIA 모델을 포함한 11가지 구성으로 테스트했습니다. 또한 스피치 투 스피치(speech-to-speech) 모델 앞단에 배치하는 것도 가능합니다. Krisp가 아직 해당 구성에 대한 결과를 공개하지는 않았지만, 직접 시도해보는 데는 아무런 제약이 없습니다.
턴 감지(turn detection)를 대체하나요? 아닙니다. VAD와 턴 감지 이전 단계에서 더 깨끗한 오디오를 제공하는 역할을 합니다. Krisp는 동일한 VIVA SDK에서 Turn-Taking을 별도 모델로 제공합니다.
사용자가 음성 등록을 해야 하나요? 아닙니다. 등록도 필요 없고, 사용자 음성에 대한 학습도 필요하지 않습니다.
지연 시간은 얼마나 추가되나요? Krisp는 알고리즘 지연 시간이 15ms라고 밝히고 있으며, SDK 문서에서는 추가 지연 시간을 약 20ms로 안내하고 있습니다. 클라우드 API 사용 시에는 여기에 미국 리전까지의 네트워크 시간이 추가로 더해집니다.
전화 통화에서도 작동하나요? 네. 협대역(narrowband) 전화 오디오, G.711, G.722, G.729, Opus 같은 일반적인 코덱, 그리고 블루투스 헤드셋을 지원합니다.
사람 간 통화는 어떤가요? 동일한 기술이 Krisp의 RTC SDK에 Background Voice Cancellation(BVC)이라는 이름으로 포함되어 있으며, 브라우저, 데스크톱, 모바일 앱에서 사용자 기기에서 실행됩니다. 사람 상담원이 있는 컨택트 센터는 Krisp 콜센터 AI 제품을 통해 이 기능을 사용할 수 있으며, 근처 상담원들의 목소리가 고객 통화에 섞이지 않도록 방지해 줍니다.


