
Lorsqu'un agent vocal échoue sur des appels réels, la cause ne vient souvent ni du LLM ni de la voix. Le problème commence une étape plus tôt, dans l'audio que l'agent entend, qu'il soit envoyé vers la reconnaissance vocale (STT) ou directement vers un modèle speech-to-speech. Les STT modernes gèrent très bien le trafic et la climatisation. Ce qu'ils ne gèrent pas, c'est une deuxième personne qui parle : un collègue, une télévision, l'agent au bureau voisin dans un centre d'appels. Il les écoute lui aussi, et l'agent réagit à des mots que l'appelant n'a jamais prononcés.
Krisp Voice Isolation se place devant le STT et supprime toutes les voix excepté celle du locuteur principal. Pour ce test, j'ai lu le benchmark et la documentation de Krisp, créé un compte sur l'API en libre-service, et j'ai envoyé huit enregistrements réels du jeu de données public de Krisp à travers le service. J'ai ensuite transcrit l'audio avant et après avec un modèle STT open source pour voir ce qui avait réellement changé.
Le verdict en bref : si votre agent reçoit des appels depuis des bureaux, des domiciles, des centres d'appels ou partout où des gens parlent en arrière-plan, Voice Isolation mérite sa place dans votre pipeline. Lors de mon test, la voix d'arrière-plan qui avait généré 331 mots de fausse transcription est tombée à zéro. Les compromis existent mais sont minimes : un léger coût sur l'audio téléphonique propre, une API disponible uniquement aux États-Unis, et moins de modèles sur l'API que dans le SDK.
Le problème : les voix d'arrière-plan, pas le bruit de fond
Les modèles STT sont entraînés à capter la parole, pas à déterminer quelle parole compte. Le bruit peut être filtré parce qu'il ne ressemble pas à de la parole. Une deuxième voix ressemble exactement à de la parole, tout simplement parce qu'elle l'est.
L'exemple de Krisp est parlant. Un appelant demande à résilier un abonnement pendant qu'un collègue à proximité demande ce qu'on mange à midi. Le STT renvoie un seul flux de mots, sans rien indiquer sur leur origine, et l'agent reçoit donc les deux comme une seule requête.
Cela casse un agent vocal de trois manières :
- Transcriptions erronées. Les mots du voisin se retrouvent dans la transcription, et le LLM répond à des choses que l'appelant n'a jamais dites.
- Fausses interruptions. L'agent entend le voisin, croit que l'appelant l'interrompt, et s'arrête en pleine phrase.
- Gestion des tours de parole cassée. La parole d'arrière-plan donne l'impression que l'appelant parle encore, si bien que l'agent ne sait pas quand le tour de parole s'est terminé.
Dans chaque cas, la logique de l'agent fonctionne comme prévu. Elle réagit à une voix qu'elle n'aurait jamais dû entendre.
Les chiffres montrent l'ampleur du problème. Dans le test de sortie de Voice Isolation 2.5 de Krisp, 10 systèmes STT affichaient en moyenne un taux d'erreur sur les mots (WER) de 2,10 % sur de l'audio propre à un seul locuteur. Avec une deuxième personne parlant par-dessus l'appelant, ces mêmes systèmes atteignaient 35,92 % en moyenne. La suppression de bruit ne comble pas cet écart, car l'interférence est de la parole.
Qu'est-ce que Krisp Voice Isolation
L'API et SDK Krisp Voice Isolation supprime les voix et le bruit d'arrière-plan d'un flux audio en direct et ne laisse passer que le locuteur principal. Conçu pour les agents vocaux IA, il repose sur la même technologie de base que Krisp propose pour les appels humains sous le nom de Background Voice Cancellation (BVC).
Il se place en tête du pipeline de l'agent, si bien que chaque modèle en aval n'entend qu'une seule voix :
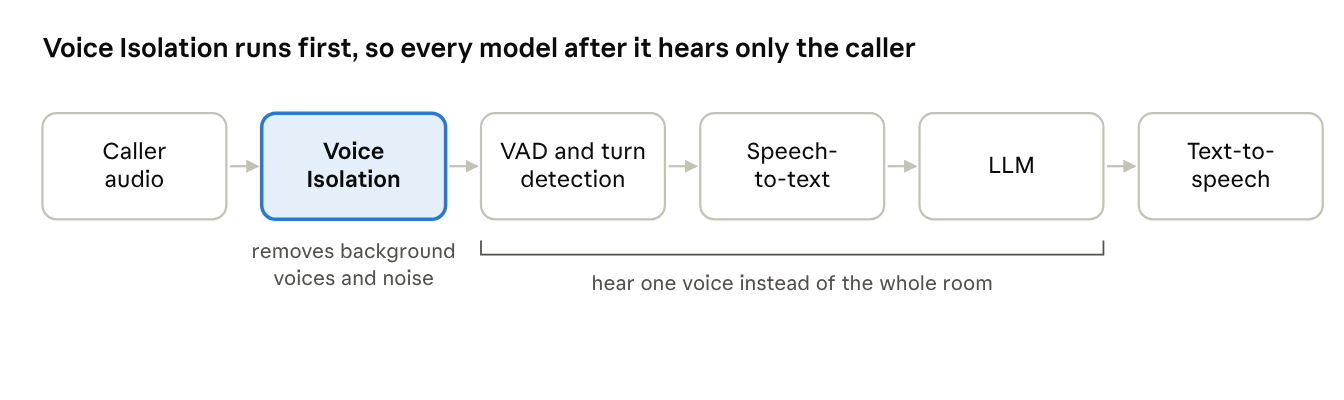
Position de Voice Isolation dans un pipeline d'agent vocal
Cet emplacement compte. Sans cela, le VAD et la détection de tours de parole entendent également le voisin, d'où viennent les fausses interruptions.
Krisp travaille depuis environ neuf ans sur la voix IA et affirme traiter plus de 1 000 milliards de minutes de voix par an. Voice Isolation est l'un des produits de sa gamme d' API vocales IA et de SDK. Voice Isolation fait partie de VIVA, l'ensemble de modèles temps réel de Krisp pour les agents vocaux, aux côtés de Turn-Taking, Interrupt Prediction et VAD. Il complète la gestion des tours de parole sans la remplacer.
Les quatre modèles vous permettent de contrôler l'agressivité de la suppression des voix et du bruit d'arrière-plan. À agressivité maximale (la configuration par défaut), Default supprime le plus. Balanced traite la voix principale plus légèrement, à calcul égal. Lite utilise environ un tiers du calcul de Default. HD est destiné aux flux WebRTC 32 kHz plutôt qu'à l'audio téléphonique. L'agressivité est un paramètre d'exécution que vous pouvez ajuster sans changer le calcul ; dans l'API, c'est le paramètre suppression_level, de 0 à 100.
Une limite à connaître dès le départ : les modèles de suppression de voix supposent que le locuteur est proche du micro. En gros, au-delà d'environ 30 cm, la voix du locuteur principal elle-même peut être supprimée. Ce n'est pas une règle absolue mais une recommandation générale, et la distance réelle dépend des conditions acoustiques. Pour les appareils grand champ comme les enceintes connectées, Krisp propose un modèle distinct qui supprime uniquement le bruit.
La version 2.5 est sortie en août 2026, et Krisp a publié un benchmark et jeu de données ouverts en septembre. Le modèle est désormais disponible sous forme d'API en libre-service en plus du SDK.
Ce que montrent les benchmarks de Krisp
Sur le benchmark ouvert de Krisp, Voice Isolation a réduit le taux d'erreur moyen sur les mots de 23,24 % à 6,24 %, soit une baisse de 73 %.
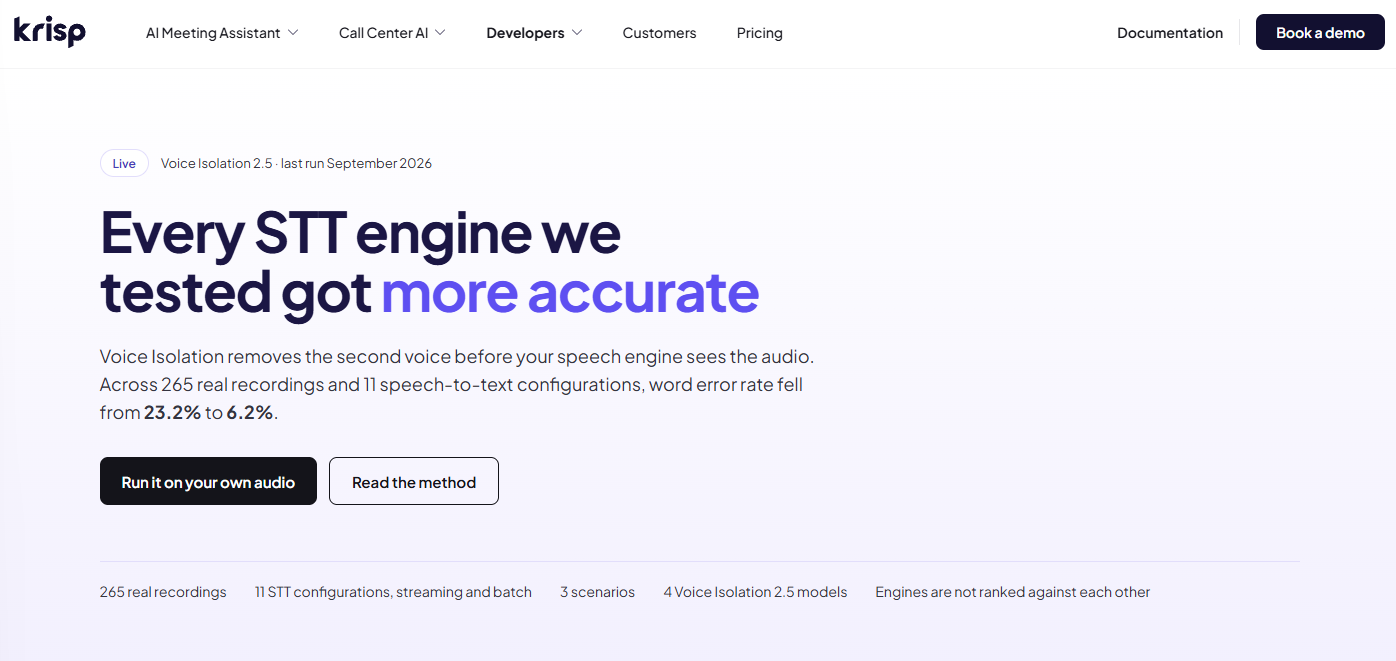
La page benchmark de Krisp résume le résultat principal.
Le benchmark utilise 265 enregistrements réels provenant de bureaux, de domiciles, de quatre plateaux de centres d'appels en activité et de voitures. Rien n'a été simulé ni mixé après coup. La plupart des enregistrements suivent le même scénario : le locuteur principal parle, une deuxième personne intervient, le locuteur principal se tait pendant que l'autre continue, puis le locuteur principal revient. Cette fenêtre de silence est le vrai test, car la transcription correcte pour elle est vide. Chaque fichier a été traité par 11 configurations STT issues de neuf moteurs, avec et sans isolation.
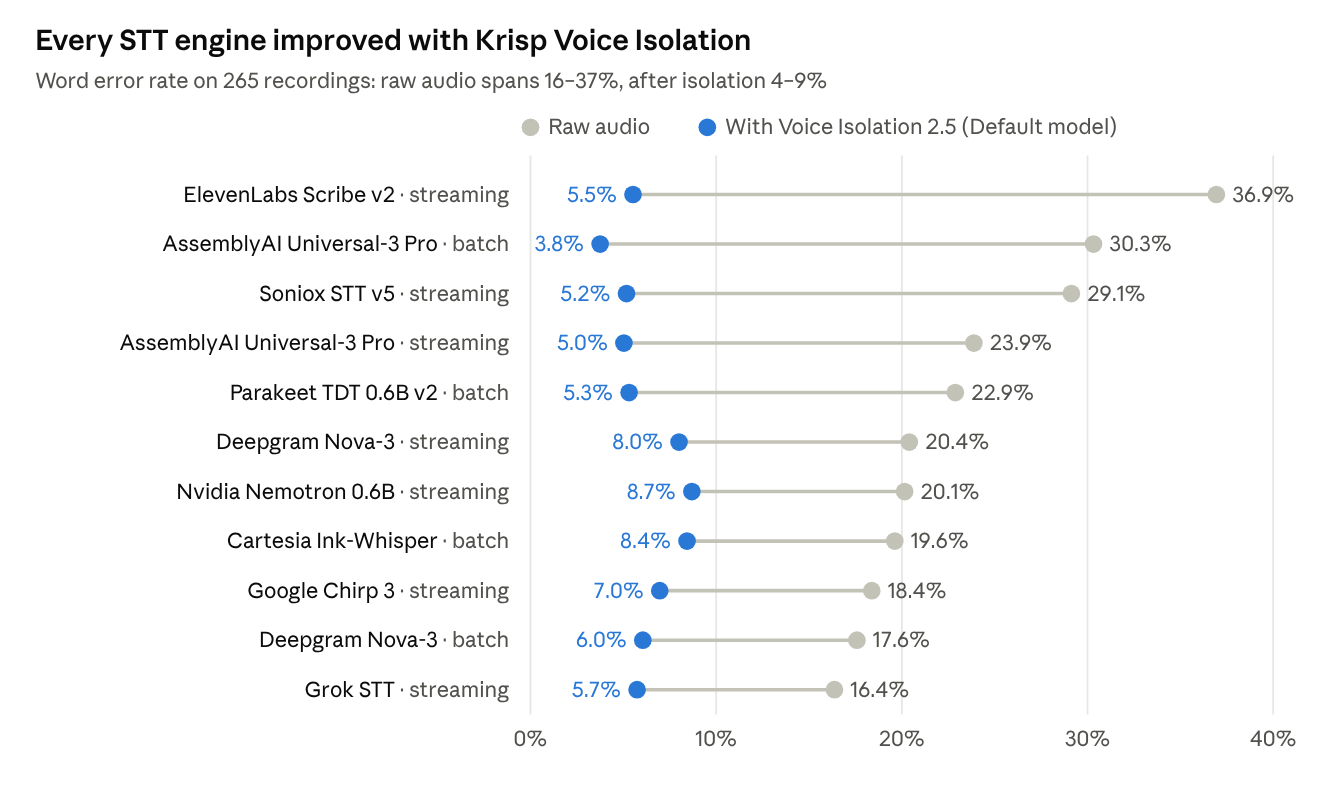
Source : benchmark voice isolation de Krisp, oct. 2026 · 11 configurations STT, tous scénarios confondus
Chaque moteur s'est amélioré et aucun n'a régressé. Le résultat le plus utile concerne l'écart entre moteurs : sur l'audio brut, il est d'environ 20 points, et après isolation il se réduit à environ 5. Si votre agent entend des voix d'arrière-plan, nettoyer l'entrée améliore votre WER davantage que le choix d'un autre fournisseur STT.
Par scénario, le gain dépend de la présence ou non d'une deuxième voix :
Là où ça n'aide pas
Krisp publie ses points faibles, et c'est à mon avis la partie la plus convaincante de leur présentation.
- L'audio téléphonique propre se dégrade légèrement. Sans deuxième voix à supprimer, l'isolation ne peut agir que sur la voix principale. Le WER des appels téléphoniques est passé de 3,48 % à 3,91 %, et un fichier est passé de 9,42 % à 21,65 %. Le modèle Balanced donne les meilleurs résultats ici avec 3,53 %.
- L'écho important reste un problème. Dans le test de sortie de la 2.5 distinct, les enregistrements à un seul locuteur avec une acoustique difficile ont obtenu 11,61 % avec isolation contre 8,02 % sans. C'est bien mieux que la version 2.1 (15,42 %), mais toujours pire que de ne rien faire.
- La sur-isolation provoque des erreurs silencieuses. Krisp explique que les modèles antérieurs supprimaient parfois des fragments de la voix principale. Un humain comprenait encore l'audio, mais le STT supprimait des propositions entières et la transcription paraissait propre avec des trous. La version 2.5 a été ajustée pour le STT plutôt que pour l'oreille humaine afin de corriger cela.
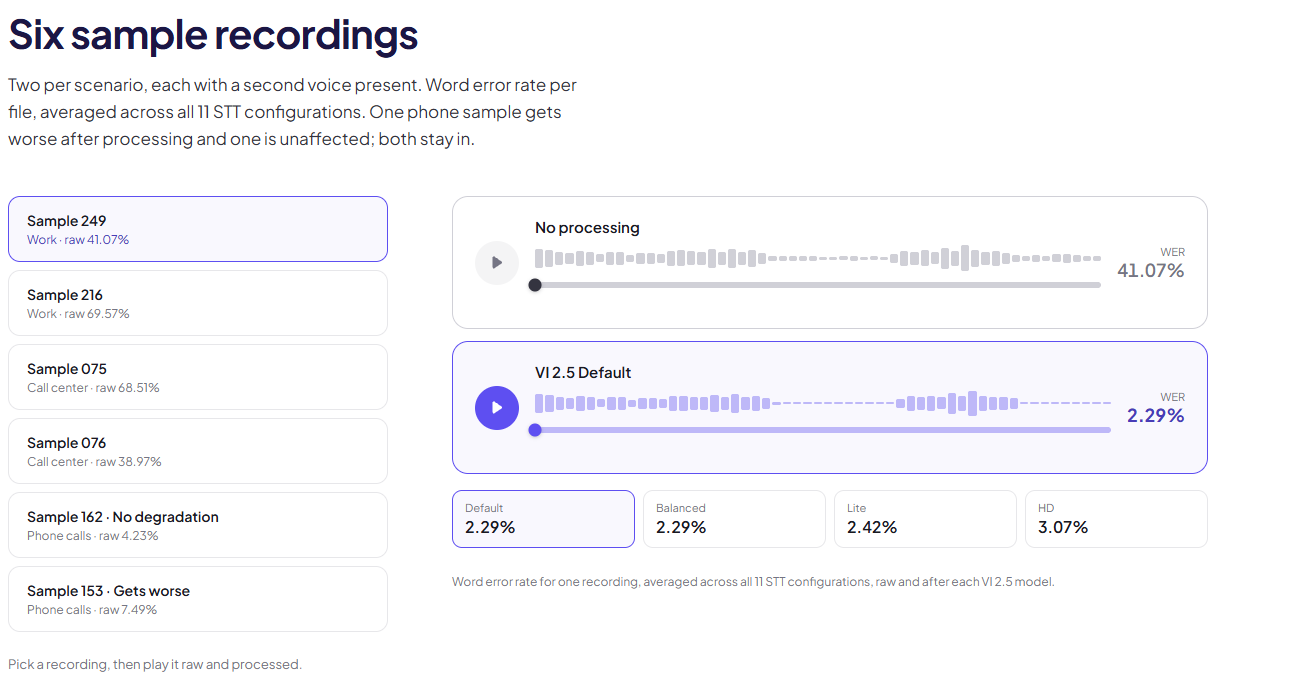
La page benchmark permet d'écouter six enregistrements bruts et traités. L'échantillon 153, un appel téléphonique, est étiqueté « Gets worse » (se dégrade).
Deux autres points à garder à l'esprit. Le chiffre de 73 % et celui de 46,4 % que l'on voit sur le site de Krisp proviennent de tests différents : 265 enregistrements dans le benchmark ouvert, et 1 685 enregistrements dans le test de sortie de la 2.5. Et les résultats de Krisp comparent l'audio avec et sans sa propre isolation, pas avec les produits d'isolation d'autres fournisseurs.
Les enregistrements, transcriptions manuscrites, étiquettes de segments et sorties de chaque modèle sont publics sur Hugging Face, donc n'importe qui peut refaire le test. C'est ce que j'ai fait ensuite.
Test pratique : l'API Voice Isolation
Lors de mon test, Voice Isolation a supprimé tous les mots de la parole d'arrière-plan des transcriptions, et le WER global est passé de 40,1 % à 10,2 %.
Configuration
L'inscription sur le portail des développeurs est rapide, avec connexion Google, Microsoft ou e-mail. L'essai m'a donné 30 $ de crédits et une limite de deux sessions simultanées. Ensuite, c'est API Keys → Create key, et vous obtenez une clé que vous ne pouvez copier qu'une seule fois.
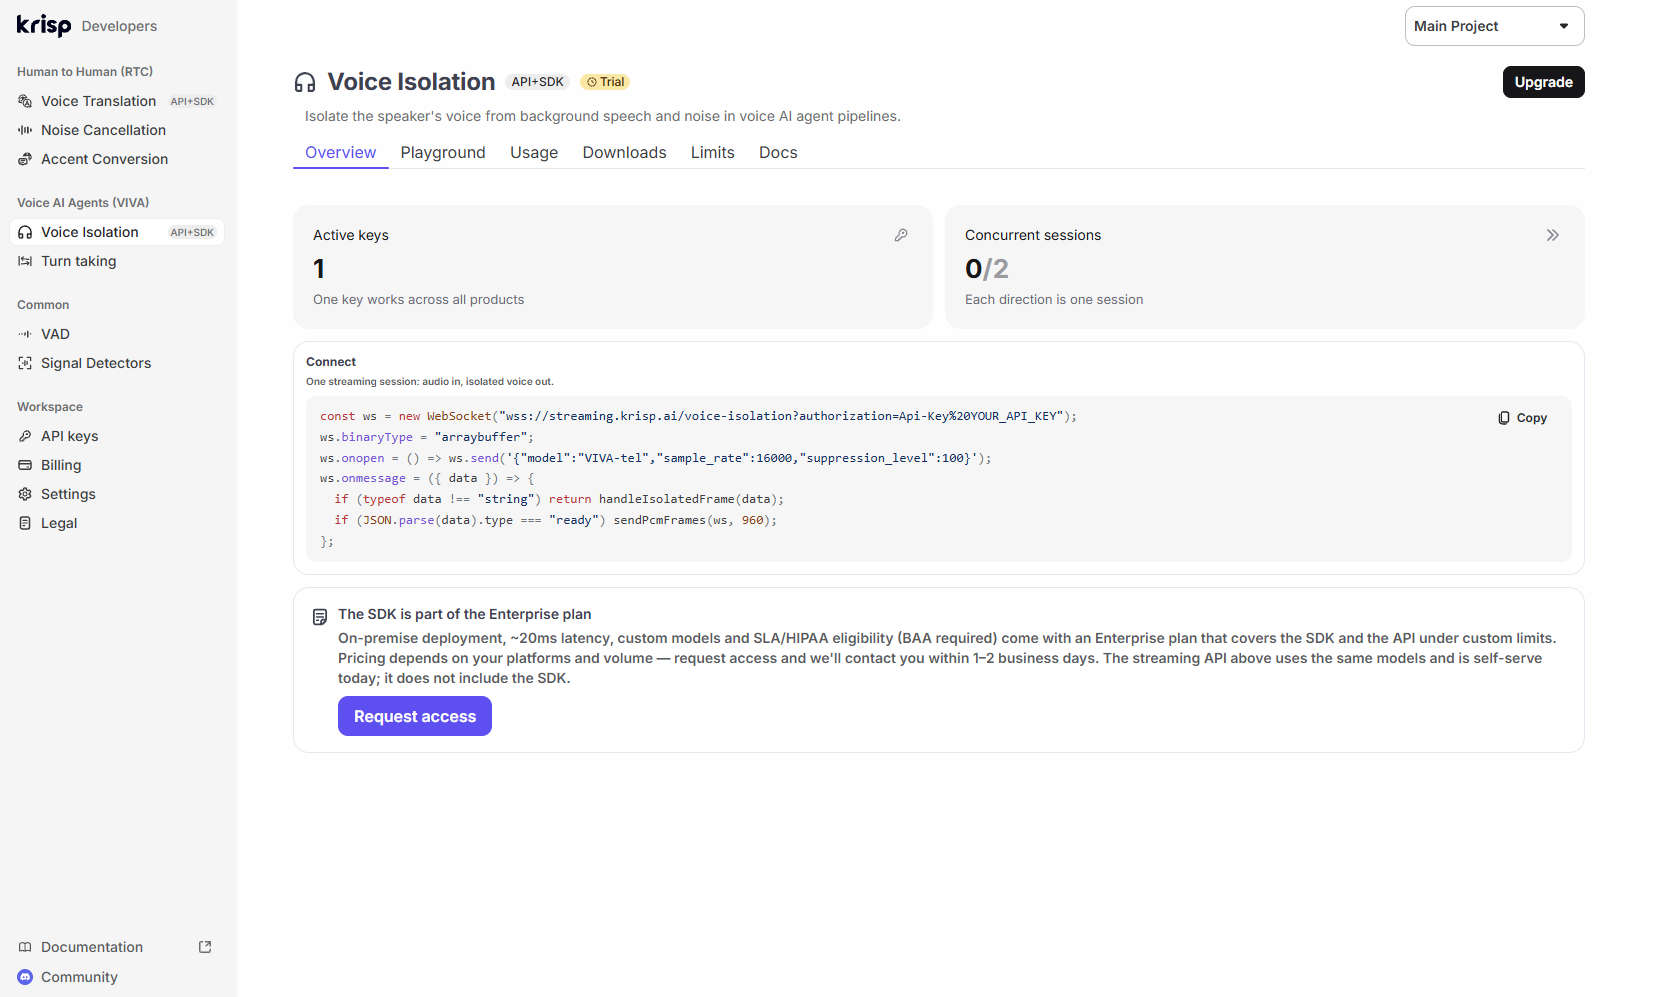
La page Voice Isolation du portail des développeurs, sur le plan d'essai.
La clé API que j'ai créée pour ce test. Une seule clé fonctionne pour tous les produits API de Krisp, y compris la Voice Translation API. .
L'API est un WebSocket. Votre backend échange la clé API contre un jeton de session de courte durée, le client envoie un petit message JSON d'accueil, attend ready, puis diffuse du PCM mono 16 bits et reçoit l'audio nettoyé image par image :
URL = "wss://streaming.krisp.ai/voice-isolation"async with websockets.connect(URL, additional_headers={"Authorization": f"api-key {session_token}"}) as ws: await ws.send(json.dumps({"model": "VIVA-tel", "sample_rate": 16000, "suppression_level": 100})) hello = json.loads(await ws.recv()) # {"type": "ready", ...} # then send exactly 30 ms of audio per message (960 bytes at 16 kHz) # and write each binary message you receive to your output
C'est proche du quickstart de l'API de Krisp, un court script Python qui nettoie un fichier WAV. Une règle piège les utilisateurs : chaque message audio doit faire exactement 30 ms. Sinon, la session se termine avec une erreur invalid_frame_duration, donc complétez la dernière trame avec du silence.
Pour le test, j'ai choisi huit enregistrements du jeu de données public de Krisp : trois enregistrements de bureau, trois de plateaux de centres d'appels et deux appels téléphoniques depuis une voiture, soit environ 11 minutes au total. J'ai diffusé chacun à vitesse temps réel via l'API, depuis l'Asie. J'ai ensuite transcrit l'audio brut et nettoyé avec Parakeet TDT 0.6B v2 open source de NVIDIA, l'un des moteurs du benchmark de Krisp, et j'ai noté chaque segment étiqueté par rapport aux transcriptions humaines.
Résultats
Presque toute l'amélioration est venue d'un seul endroit : les fenêtres où le locuteur principal était silencieux pendant que quelqu'un d'autre continuait de parler. Sur l'audio brut, Parakeet avait transformé cette parole d'arrière-plan en 331 mots de transcription. Après Voice Isolation, il n'en a produit aucun. La voix d'arrière-plan était abaissée de 13 à 34 dB dans ces fenêtres, tandis que le niveau du locuteur principal bougeait à peine (à moins de 1 dB).
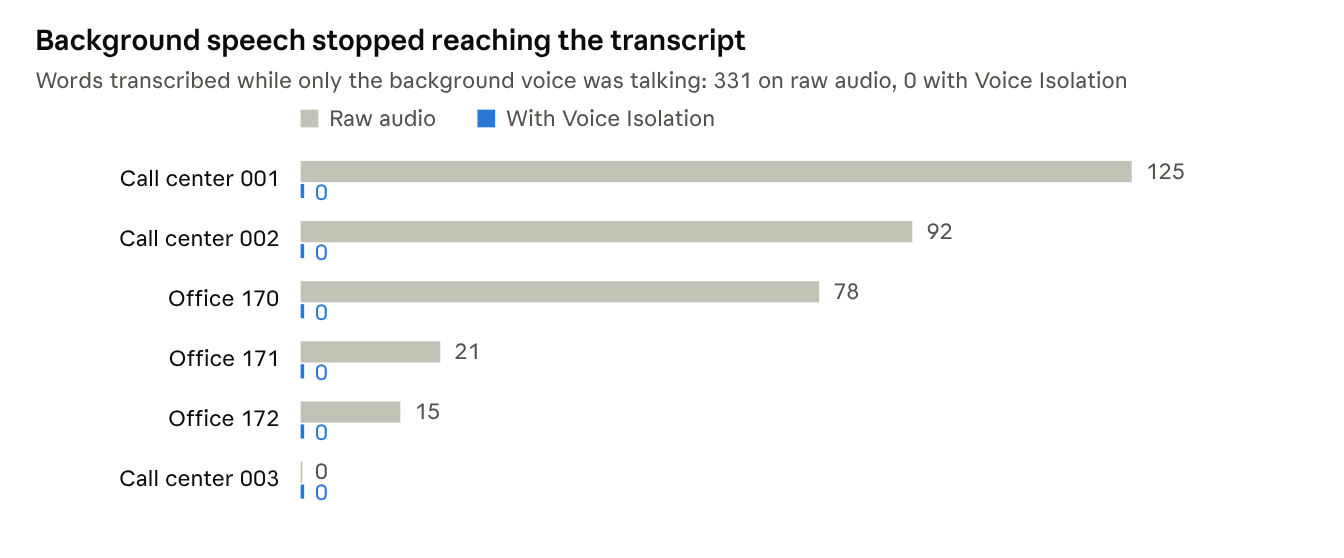
Mon test · API Krisp (VIVA-tel), transcrit avec Parakeet TDT 0.6B v2 · les 6 enregistrements avec une fenêtre d'arrière-plan seul
L'exemple du centre d'appels montre pourquoi c'est important. Pendant que l'agent que je testais marquait une pause, l'agent au bureau voisin était sur un autre appel. La transcription brute reprenait cet appel mot pour mot :
thank you for calling meridian bank before i begin i will need to confirm your identity for security could you give me your full name your date of birth...
Un agent vocal prendrait cela pour la parole de l'appelant. Avec Voice Isolation, la même fenêtre revenait vide.
Quand les deux personnes parlaient en même temps, le changement était faible : 13,2 % brut contre 12,5 % nettoyé. Parakeet favorisait déjà la voix la plus forte et la plus proche dans ces passages. La plupart des erreurs restantes concernent le formatage des nombres dans ma notation (numéros de téléphone, prix, codes postaux), qui pénalisaient également les deux versions.
Sur les deux appels téléphoniques propres, un fichier a accumulé une erreur supplémentaire et l'autre en a perdu deux. C'est conforme à la conclusion de Krisp selon laquelle le coût sur l'audio propre est faible.
Latence et fiabilité depuis l'extérieur des États-Unis
L'API ne tourne actuellement que dans la région américaine, et la documentation de Krisp prévient que les clients situés ailleurs subiront une latence supplémentaire. Depuis l'Asie, le temps aller-retour médian pour une trame (envoi au retour de l'audio nettoyé) était de 260 à 520 ms selon les sessions, et l'établissement d'une session prenait généralement 1,5 à 3 secondes. C'est la distance réseau, pas le modèle : Krisp annonce 15 ms de latence algorithmique. Mais si votre agent sert des utilisateurs loin des États-Unis, vous le ressentirez, et le SDK sur vos propres serveurs permet de l'éviter.
Une de mes neuf sessions s'est interrompue par une fermeture anormale après environ 70 secondes. L'avoir relancée a fonctionné. J'attribue cela à la longue route depuis l'Asie plutôt qu'au service, mais c'est un rappel de gérer les reconnexions en production.
À propos de ce test : huit fichiers constituent un petit échantillon, pas un benchmark. J'ai rééchantillonné les enregistrements 32 kHz en 16 kHz pour le modèle téléphonie (VIVA-tel), j'ai utilisé un seul moteur STT et une normalisation de texte simple, donc mes chiffres absolus ne sont pas comparables à ceux de Krisp. Ce que je vérifiais, c'est le sens et l'ampleur du changement, et cela correspond à ce que Krisp rapporte.
Expérience développeur : API ou SDK
Voice Isolation se présente sous deux formes, et le choix dépend de votre plan.
L'API est le moyen le plus simple : aucun fichier de modèle à déployer et rien à exécuter sur votre CPU. Les compromis : votre audio passe par le cloud de Krisp, et vous n'obtenez que deux modèles au lieu de quatre : VIVA-tel pour l'audio téléphonique 8 ou 16 kHz, et VIVA-pro pour l'audio bande large 32 kHz. VIVA-pro n'est pas encore dans la référence de l'API, mais il est présent dans le Playground du portail, l'API l'a accepté lors de mon test, et Krisp a confirmé sa disponibilité.
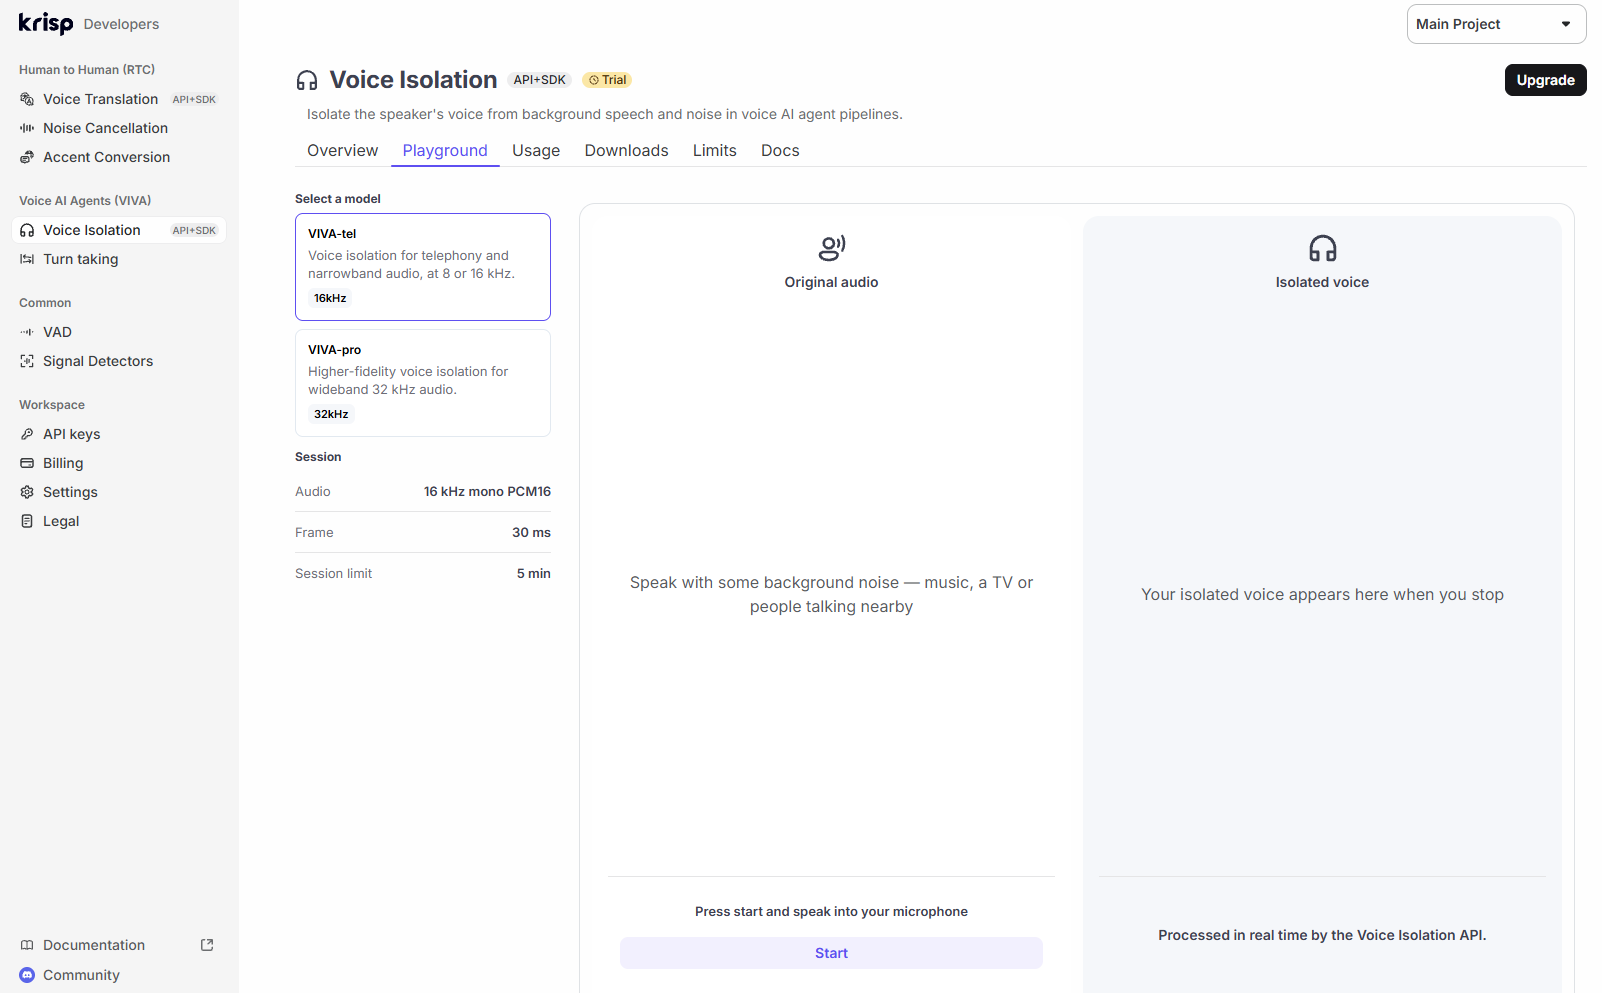
Le Playground du portail permet de tester l'un ou l'autre modèle d'API avec votre propre microphone avant d'écrire du code.
Le SDK garde l'audio sur vos propres serveurs et ne se connecte qu'en ligne pour vérifier sa licence. C'est aussi là que le volet des coûts devient intéressant. L'article de Krisp sur le CPU montre qu'un simple flag du SDK, enableLowPrecisionExecution, double à peu près le nombre d'appels qu'un serveur peut nettoyer sur les CPU avec support FP16. Une instance AWS Graviton3 à 16 vCPU est passée de 76 appels simultanés à 137, et le modèle Lite gère environ trois fois plus de flux que les modèles complets. Sur les anciens puces Intel Ice Lake, le flag ne fait rien.
Intégrations
- Pipecat propose un filtre prêt à l'emploi. Vous ajoutez KrispVivaFilter() comme filtre d'entrée audio de votre transport, et vous pouvez l'associer à KrispVivaTurn pour la détection de tours de parole. Attention, il utilise le SDK : vous devez donc avoir accès au SDK et aux fichiers de modèle, pas seulement une clé API.
- LiveKit propose les modèles Krisp dans LiveKit Cloud, y compris la suppression des voix d'arrière-plan (noise_cancellation.BVC()) pour les agents. LiveKit facture ces modèles d'isolation vocale en supplément.
- Les pipelines WebRTC et téléphonie peuvent utiliser le SDK directement, et l'API fonctionne avec tout ce qui peut ouvrir un WebSocket.
La documentation est claire et à jour. Le quickstart a fonctionné du premier coup, et les messages d'erreur indiquent exactement ce qui s'est mal passé, jusqu'à la taille de trame attendue et reçue. Mon seul bémol concerne le nommage : le blog parle de Default, Balanced, Lite et HD, les téléchargements du SDK utilisent des noms de fichiers comme krisp-viva-vi-tel-v2.5.1, et l'API nomme ses modèles VIVA-tel et VIVA-pro, avec seulement le premier dans la référence API. Un tableau de correspondance dans la documentation aiderait.
Tarifs
L'API est facturée à l'heure d'audio, et c'est assez bon marché pour que le coût ne détermine pas l'usage.
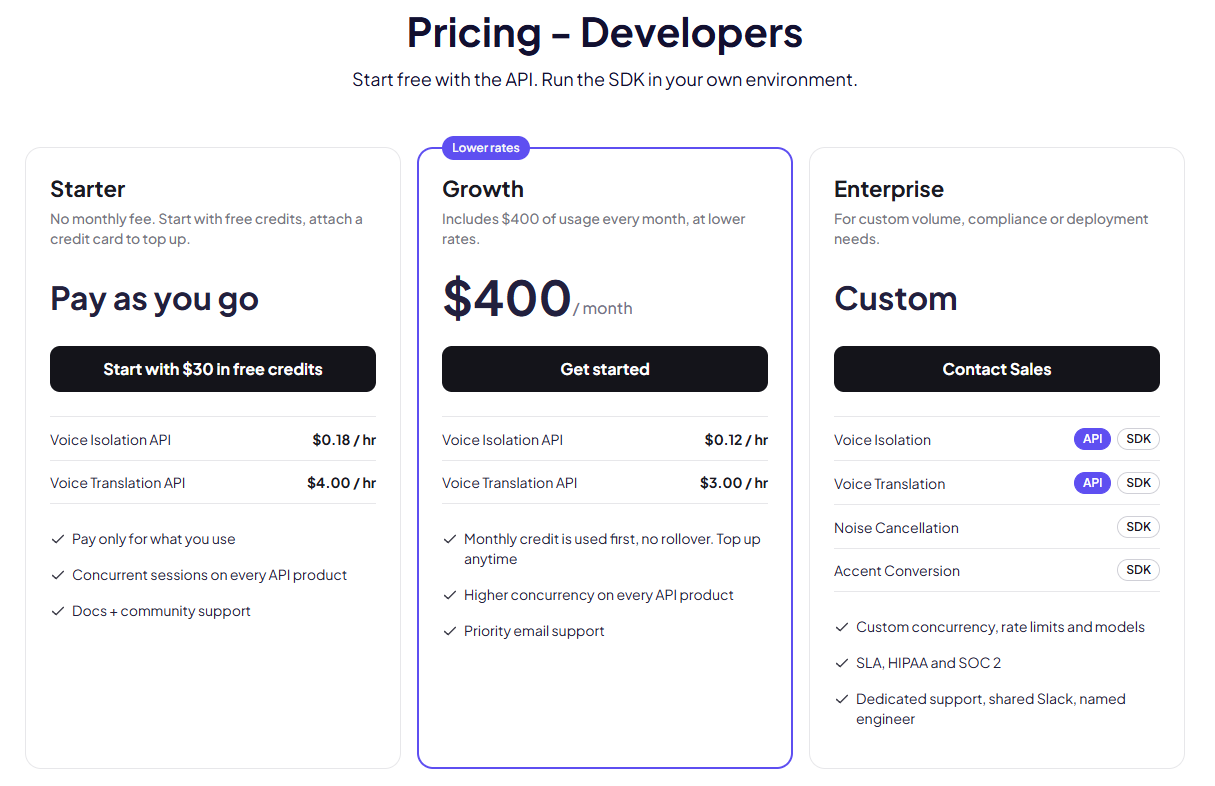
Tarifs développeur de Krisp, novembre 2026.
Sur le plan Starter à l'usage, la Voice Isolation API coûte 0,18 $ par heure d'audio, sans abonnement mensuel. Le tarif est le même pour les deux modèles d'API, VIVA-tel et VIVA-pro. Growth coûte 400 $ par mois, inclut 400 $ d'usage et ramène le tarif à 0,12 $ par heure, avec une concurrence accrue et un support prioritaire. Enterprise est sur devis et est le seul plan qui inclut le SDK, un SLA, ainsi que HIPAA et SOC 2.
Le crédit de bienvenue de 30 $ couvre environ 166 heures d'audio au tarif Starter, largement suffisant pour tester. Les crédits sont valables 12 mois et l'usage est facturé à la minute. Pour donner un ordre d'idée, un appel de 5 minutes coûte environ 1,5 centime à nettoyer sur Starter.
Le SDK n'est disponible que sur le plan Enterprise, à un prix négocié : il faut donc passer par le service commercial pour faire tourner les modèles sur vos propres serveurs. Les tarifs proviennent de la page tarifaire de Krisp, vérifiée en novembre 2026.
Alternatives
Krisp n'est pas la seule option pour supprimer les voix d'arrière-plan, mais il n'existe pas encore de test comparatif indépendant de ces produits. Chaque fournisseur publie ses propres chiffres sur ses propres données, donc considérez les chiffres ci-dessous comme des affirmations.
Ce qui distingue Krisp, c'est la preuve. C'est le seul fournisseur ici à proposer un benchmark ouvert et reproductible couvrant 11 configurations STT, et il publie les cas où il perd. C'est aussi le plus flexible à déployer : API cloud, SDK sur serveur, ou intégré à LiveKit et Pipecat.
Verdict
Krisp Voice Isolation est la solution à retenir quand un agent vocal se comporte mal sur des appels réels alors qu'il fonctionne parfaitement en test. Il supprime les voix que votre agent ne devrait pas entendre, il fonctionne avec n'importe quel STT que vous utilisez déjà, et le benchmark de Krisp comme mon propre test montrent la même chose : la parole d'arrière-plan ne parvient plus jusqu'à la transcription.
Points forts
- Supprime les voix d'arrière-plan, pas seulement le bruit, ce qui est précisément ce que le STT ne peut pas gérer seul
- Fonctionne avec n'importe quel moteur STT, sans configuration par langue ni enrôlement vocal
- Tourne sur CPU avec 15 ms de latence algorithmique
- Benchmark ouvert et reproductible, incluant les cas où il perd
- API en libre-service avec 30 $ de crédit gratuit, et bon marché à 0,12–0,18 $ par heure
- Filtre Pipecat prêt à l'emploi et support LiveKit
Points faibles
- Légère perte de précision sur l'audio téléphonique propre, et toujours pire que l'audio brut dans les pièces avec beaucoup d'écho
- L'API ne fonctionne que dans la région États-Unis, ce qui ajoute une latence notable ailleurs
- L'API offre deux modèles contre quatre pour le SDK ; un usage sur site nécessite le SDK Enterprise
Pour qui : les équipes dont les agents reçoivent des appels depuis des centres d'appels, des bureaux, des domiciles, des voitures ou partout où d'autres personnes parlent à proximité. Commencez par l'API pour mesurer l'effet sur vos propres enregistrements, puis passez au SDK si vous avez besoin des autres modèles, d'une latence réduite hors des États-Unis, ou d'un audio qui reste sur vos serveurs.
Pour qui ce n'est pas utile : les agents dont les appelants sont presque toujours seuls dans des pièces calmes, ou les appareils grand champ comme les enceintes connectées, pour lesquels les modèles de suppression de voix ne sont pas conçus.
Vous pouvez essayer l'API Krisp Voice Isolation avec les crédits gratuits et y passer vos propres enregistrements en un après-midi.
FAQ
L'isolation vocale est-elle la même chose que l'annulation de bruit ? Non. L'annulation de bruit supprime les sons non vocaux comme le trafic et les claviers. L'isolation vocale supprime aussi les voix d'autres personnes, que l'annulation de bruit laisse passer.
Krisp Voice Isolation fonctionne-t-il avec mon fournisseur STT ? Oui. Il traite l'audio lui-même, donc il se place devant n'importe quel moteur STT. Krisp l'a testé avec 11 configurations, dont les modèles Deepgram, AssemblyAI, ElevenLabs, Soniox, Google, Cartesia et NVIDIA. Il peut également se placer devant des modèles speech-to-speech. Krisp n'a pas encore publié de résultats pour cette configuration, mais rien ne vous empêche d'essayer.
Remplace-t-il la détection de tours de parole ? Non. Il se place avant le VAD et la détection de tours de parole et leur fournit un audio plus propre. Krisp propose Turn-Taking comme modèle distinct dans le même SDK VIVA.
Les utilisateurs doivent-ils enrôler leur voix ? Non. Aucun enrôlement ni entraînement sur la voix de l'utilisateur n'est nécessaire.
Quelle latence ajoute-t-il ? Krisp annonce 15 ms de latence algorithmique, et sa documentation SDK indique une latence ajoutée d'environ 20 ms. Avec l'API cloud, le temps réseau vers la région américaine s'ajoute à cela.
Fonctionne-t-il sur les appels téléphoniques ? Oui. Il gère l'audio téléphonique bande étroite, les codecs courants comme G.711, G.722, G.729 et Opus, ainsi que les casques Bluetooth.
Et pour les appels entre humains ? La même technologie est proposée sous le nom de Background Voice Cancellation (BVC) dans le SDK RTC de Krisp, qui tourne sur l'appareil de l'utilisateur dans les navigateurs et les applications de bureau et mobiles. Les centres de contacts avec agents humains y accèdent via le produit call center AI de Krisp, qui empêche les voix des agents voisins de se retrouver dans les appels des clients.


