
Gemini 3.7 Flash ist Googles neuestes Hochleistungs-KI-Modell, das am 13. August 2026, drei Wochen nach Gemini 3.6 Flash, veröffentlicht wurde. Es behält das 1M Token Kontextfenster und den multimodalen Input seines Vorgängers bei, während es große Fortschritte bei den Codierungs- und Agenten-Benchmarks erzielt. Es wird zu einem Einführungspreis von 0,75 $ pro 1M Eingabetokens für die API eingeführt. Google nennt es „unser intelligentestes Arbeitstier-Modell.“
Diese dreiwöchige Lücke zwischen den Veröffentlichungen ist die eigentliche Geschichte. Google liefert Flash-Updates in einem Sprint-Cadence, während Gemini 3.5 Pro weiterhin verzögert ist, was bedeutet, dass das Mid-Tier-Modell jetzt der Ort ist, an dem interessante Engineering-Leistungen zuerst landen. Die Benchmark-Deltas bestätigen dies: DeepSWE springt um 16 Punkte, AutomationBench verdoppelt sich fast, und der Einführungspreis unterbietet den Einführungspreis von 3.6 Flash um die Hälfte.
Dieser Beitrag behandelt alles, was sich geändert hat: die vollständige Benchmark-Tabelle, die Google in seiner Ankündigung verstreut hat, die Preisperioden, die Sie im Kalender markieren müssen, jeden Ort, an dem Sie das Modell heute nutzen können, und eine funktionierende cURL-Anfrage, die Sie in fünf Minuten abfeuern können. Wenn Sie eine detailliertere Endpunkt-Erklärung wünschen, passt der Gemini 3.7 Flash API Quickstart zu dieser Erläuterung, und Apidog bietet Ihnen einen Arbeitsbereich, um das neue Modell gegen Ihre bestehenden Prompts zu testen, bevor Sie sich für einen Wechsel entscheiden.
TL;DR
- Gemini 3.7 Flash wurde am 13. August 2026, drei Wochen nach 3.6 Flash, veröffentlicht. Modell-ID:
gemini-3.7-flash. - Codierungs- und Agenten-Benchmarks stiegen: DeepSWE v1.1 49,0% auf 65,3%, AutomationBench 17,0% auf 30,4%, WebDev Arena Elo 1538 auf 1588.
- Der Einführungspreis der API beträgt 0,75 $ pro 1M Eingabetokens und 3,75 $ pro 1M Ausgabetokens, die Hälfte des Einführungspreises von 3.6 Flash. Die Standardtarife (1,50 $ / 7,50 $) beginnen am 1. Januar 2027.
- Die Spezifikationen bleiben stabil: 1M Token Eingabekontext, 64k Ausgabelimit, multimodaler Input (Text, Bild, Video, Audio, PDF), Funktionsaufrufe, Suche als Werkzeug und Computernutzung.
- Ab sofort in der Gemini API, AI Studio, der Gemini App, Gemini Spark, Google Antigravity, Android Studio und Gemini Enterprise, in über 160 Ländern verfügbar.
- Gemini 3.5 Pro ist immer noch verzögert; Google liefert Flash-Verbesserungen vor seinem nächsten Flaggschiff.
Was Gemini 3.7 Flash ist
Flash ist die mittlere Stufe der Gemini-Linie: billiger und schneller als Pro, intelligenter als Flash-Lite und optimiert für die hohen Arbeitslasten, die den Großteil des produktiven KI-Verkehrs ausmachen. Gemini 3.7 Flash ist die dritte Flash-Veröffentlichung in der 3.x-Linie, und Googles Framing hat sich damit verschoben. Die offizielle Ankündigung positioniert es in erster Linie als Codierungs- und Agentenmodell, in zweiter Linie als Chat-Modell.
Die Spezifikationen wurden von 3.6 Flash übernommen:
- Kontext: 1M Token Eingabefenster, 64k Token Ausgabelimit.
- Eingabemodalitäten: Text, Bild, Video, Audio und PDF. Ausgabe ist Text.
- Tools: Funktionsaufrufe, Suche als Werkzeug und Computernutzung.
- Sicherheit: Aktualisierte CBRN- und Cyber-Sicherheitsmaßnahmen werden mit der Veröffentlichung ausgeliefert.
Was sich geändert hat, ist das Verhalten, nicht die Architektur. Google sagt, dass 3.7 Flash besser debuggt, häufiger bereitstellbaren, produktionsreifen Code beim ersten Versuch generiert, sich anpasst, wenn es auf Hindernisse stößt, klärende Fragen stellt, wenn die Absicht mehrdeutig ist, und Anweisungen mit größerer Genauigkeit befolgt. Das sind die Behauptungen. Die Benchmarks unten sind der Beweis.
Benchmark-Verbesserungen: 3.6 vs. 3.7
Google hat diese Zahlen in einem Blogbeitrag und einer Modellkarte verteilt. Hier sind sie in einer Tabelle, mit den relevanten Deltas:
| Benchmark | Gemini 3.6 Flash | Gemini 3.7 Flash | Änderung |
|---|---|---|---|
| DeepSWE v1.1 (agentische Codierung) | 49.0% | 65.3% | +16.3 Pkt |
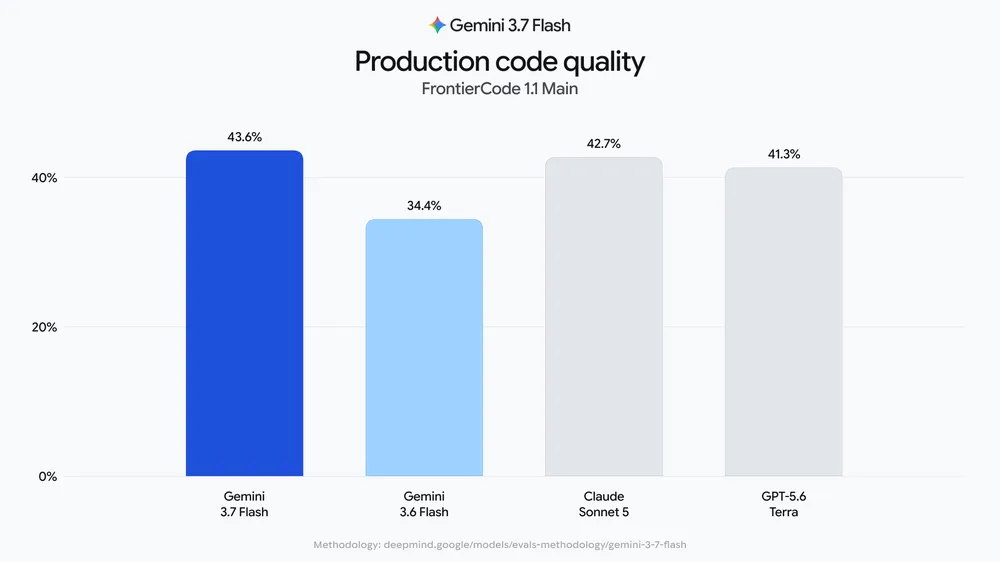
| FrontierCode 1.1 Haupt | 34.4% | 43.6% | +9.2 Pkt |
| WebDev Arena (Elo) | 1538 | 1588 | +50 Elo |
| GDP.pdf (Dokumentenverständnis) | 22.0% | 34.0% | +12.0 Pkt |
| AutomationBench (Agentenaufgaben) | 17.0% | 30.4% | +13.4 Pkt |
Zwei separate Ergebnisse runden das Bild ab: 90,7 % bei Harvey LAB-AA, einem Benchmark für juristische Schlussfolgerungen, und 97,0 % bei der 128k-Needle Long-Context-Retrieval. Diese zweite Zahl ist wichtig, wenn Sie dem Modell lange Dokumente zuführen; die Qualität der Abfrage in der Tiefe ist der Punkt, an dem viele Modelle stillschweigend versagen.
Das Muster in der Tabelle ist konsistent. Die größten Sprünge finden sich bei agentischen Benchmarks, die mehrstufige Aufgaben und nicht nur Einzelschussantworten messen. Die Verschiebung von AutomationBench von 17,0% auf 30,4% ist die Art von Delta, die verändert, welche Aufgaben Sie überhaupt einem Mid-Tier-Modell anvertrauen können. Die Berichterstattung über den Launch hob den DeepSWE-Gewinn als das Hauptergebnis hervor, und das aus gutem Grund: ein 16-Punkte-Sprung bei der agentischen Codierung in drei Wochen ist für jede Modelllinie ungewöhnlich. Zum Kontext, wie sich Benchmark-Deltas über konkurrierende Modelle übertragen, zeigt der Grok 4.6 vs. GPT 5.6 vs. Claude Vergleich, wie sich ähnliche Lücken in realen Arbeitslasten auswirken.
Verbesserungen bei Codierung und Agenten
Die Benchmark-Tabelle zeigt Ihnen, was sich verbessert hat. Googles Release Notes erklären Ihnen, wie sich dies in der Praxis zeigt, und die Behauptungen sind spezifisch genug, um sie zu testen:
- Debugging. Das Modell ist besser darin, die Ursache eines Fehlers zu finden, anstatt nur Symptome zu patchen. Der DeepSWE-Gewinn ist hier die unterstützende Zahl, da dieser Benchmark Fehlerbehebungen in mehreren Dateien in echten Repositories bewertet.
- Bereitstellbarer Code beim ersten Versuch. Google behauptet, dass mehr generierter Code ohne Korrekturrunde läuft. Die 9,2-Punkte-Verbesserung von FrontierCode ist das genaueste öffentliche Maß.
- Umgang mit Hindernissen. Wenn ein Tool-Aufruf fehlschlägt oder eine Datei fehlt, passt 3.7 Flash seinen Plan an, anstatt in einer Schleife zu enden. Dies ist das Verhalten, das AutomationBench testet.
- Absichtsklärung. Das Modell stellt eine Frage, wenn die Anfrage mehrdeutig ist, anstatt zu raten. In einer Agenten-Pipeline ist eine klärende Runde billiger als eine falsche 5.000-Token-Antwort.
- Anweisungsgenauigkeit. Anforderungen an das Ausgabeformat, Längenbeschränkungen und negative Einschränkungen bleiben über lange Konversationen hinweg zuverlässiger.
Der Tool-Stack ist genauso wichtig wie die Rohwerte. Funktionsaufrufe und Suche-als-Tool werden von 3.6 übernommen, und die Unterstützung für die Computernutzung bedeutet, dass das Modell einen Browser steuern kann, wenn keine API für die Aufgabe vorhanden ist. Diese letzte Fähigkeit befindet sich für Entwickler in einer seltsamen Position: mächtig, aber langsamer und weniger deterministisch als ein strukturierter Endpunkt. Die Aufschlüsselung von Computernutzung vs. strukturierten APIs behandelt, wann sich welcher Ansatz lohnt.
Preise: halber Preis bis zum 31. Dezember 2026
Gemini 3.7 Flash wird mit einem zweistufigen Preismodell für die Gemini API eingeführt:
| Zeitraum | Input (pro 1M Tokens) | Output (pro 1M Tokens) |
|---|---|---|
| Bis 31. Dezember 2026 | 0,75 $ | 3,75 $ |
| Ab 1. Januar 2027 | 1,50 $ | 7,50 $ |
Der Einführungspreis beträgt die Hälfte dessen, was Gemini 3.6 Flash bei seiner Einführung kostete, was die nächsten viereinhalb Monate zum günstigsten Zeitraum macht, den diese Modellfamilie je hatte. Der Haken ist die Verdopplung am 1. Januar. Wenn Sie ein Budget um 0,75 $ Input-Tokens aufbauen, wird dieses Budget in fünf Monaten platzen, es sei denn, Sie planen dies jetzt ein.
Zwei praktische Erkenntnisse. Erstens: Überprüfen Sie die aktuellen Tarife auf der offiziellen Preisgestaltungsseite, bevor Sie etwas ausliefern; Einführungsfenster haben sich schon verschoben. Zweitens: Modellieren Sie Ihre Kosten für 2027 mit dem Standardtarif, nicht mit dem Aktionspreis. Die vollständig ausgearbeiteten Beispiele, einschließlich der Token-Berechnung für Chatbots, Dokumenten-Pipelines und Agenten-Schleifen, finden Sie in der Aufschlüsselung der Gemini 3.7 Flash-Preise.
Wo Sie es heute nutzen können
Google hat 3.7 Flash am ersten Tag in über 160 Ländern über seine gesamte Oberfläche ausgeliefert:
- Gemini API. Der Entwicklerpfad. Holen Sie sich einen Schlüssel von AI Studio und rufen Sie
gemini-3.7-flashdirekt auf. - Google AI Studio. Browser-Spielplatz zum Testen von Prompts, bevor Sie Code schreiben.
- Gemini App. Die Consumer-Chat-App hat das neue Modell bei der Einführung übernommen.
- Gemini Spark. Verfügbar für AI Pro und Ultra Abonnenten.
- Google Antigravity. Googles agentische Entwicklungsumgebung läuft darauf.
- Android Studio. Die IDE-Integration erhält das Modell zur Code-Unterstützung.
- Gemini Enterprise. Das verwaltete Angebot für Organisationen mit Compliance-Anforderungen.
Für den API-Zugriff im großen Maßstab steht Ihnen auch der Vertex AI-Pfad unter aiplatform.googleapis.com mit OAuth, IAM und Audit-Logging zur Verfügung. Gleiches Modell, gleiches Anfrageschema, andere Authentifizierungs- und Hosting-Garantien.
Warum Google Flash vor Gemini 3.5 Pro ausgeliefert hat
Die Veröffentlichungsreihenfolge ist ungewöhnlich. Flaggschiff-Modelle führen normalerweise an, und die günstigeren Stufen folgen. Google hat das umgekehrt: 3.6 Flash Ende Juli, 3.7 Flash drei Wochen später, und Gemini 3.5 Pro immer noch ohne Datum. Axios berichtet, dass Google Flash-Updates bewusst vor seinem nächsten Flaggschiff ausliefert, während Pro weiterhin verzögert ist.
Als Strategie statt als Terminüberschreitung betrachtet, ist der Schritt sinnvoll. Der Großteil des Produktionsverkehrs läuft auf Mid-Tier-Modellen, weil dort die Kosten pro Token auf akzeptable Qualität treffen. Die Verbesserung von Flash verbessert das Modell, das die meisten Kunden täglich nutzen. Es hält Google auch im Gespräch über den Release-Zyklus, in einer Zeit, in der jedes große Labor schnell neue Produkte liefert, ohne die Flaggschiff-Ankündigung zu verbrennen.
Für Entwickler ist die praktische Konsequenz, dass die Flash-Stufe nicht mehr das Schlusslicht ist. Agentenfunktionen landen hier zuerst. Wenn Sie die Migration von 3.6-Workloads aufgeschoben haben, weil Sie auf Pro gewartet haben, behandelt der 3.6 zu 3.7 Flash Migrationsleitfaden den Austausch, der für die meisten Codebasen eine einzeilige Änderung der Modell-ID plus einen Regressionstest ist.
Wie man die API in fünf Minuten ausprobiert
Sie benötigen einen API-Schlüssel von AI Studio. Erstellen Sie einen, exportieren Sie ihn und senden Sie Ihre erste Anfrage:
export GEMINI_API_KEY="AIza..."

curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-3.7-flash:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "contents": [{
      "parts": [{ "text": "Review this function for bugs: def dedupe(items): return list(set(items))" }]
    }],
    "generationConfig": {
      "temperature": 0.4,
      "maxOutputTokens": 1024
    }
  }'
Die Antwort wird als candidates-Array mit dem generierten Text in content.parts zurückgegeben, plus einem usageMetadata-Block, der die genaue Anzahl der Input- und Output-Tokens angibt. Beobachten Sie diesen Block vom ersten Tag an; er ist Ihr Kostenmesser. Für Streaming tauschen Sie :generateContent gegen :streamGenerateContent?alt=sse aus, und die API gibt Server-Sent Events zurück.
Sobald der erste Anruf funktioniert, verlagern Sie das Experimentieren aus Ihrem Terminal. Importieren Sie in Apidog die Generative Language API-Spezifikation, binden Sie GEMINI_API_KEY als Umgebungsvariable an den x-goog-api-key-Header und speichern Sie die Modell-ID als Pfadvariable. Jetzt können Sie denselben Prompt gegen gemini-3.6-flash und gemini-3.7-flash nebeneinander ausführen, SSE-Streams live rendern sehen und Antworten als Beispiele speichern, damit Regressionstests keine Tokens verbrennen. Dies ist der schnellste Weg, um Googles Behauptung "bessere Anweisungsbefolgung" anhand Ihrer eigenen Prompts zu überprüfen, anstatt sich auf das Wort des Startposts zu verlassen.
FAQ
Ist Gemini 3.7 Flash kostenlos nutzbar?
Die Gemini API hat einen kostenlosen Tarif über AI Studio mit einem täglichen Kontingent, das Prototypen abdeckt. Die kostenpflichtige Nutzung beginnt mit dem Einführungspreis von 0,75 $ pro 1M Eingabetokens bis zum 31. Dezember 2026. Wenn Sie das kostenlose Kontingent weiter ausschöpfen möchten, beschreibt der Leitfaden zum kostenlosen, unbegrenzten Gemini API-Zugriff die Limits und wie man innerhalb dieser arbeitet.
Was ist der Unterschied zwischen Gemini 3.6 Flash und 3.7 Flash?
Gleiche Spezifikationen, besseres Verhalten. Kontextfenster, Ausgabelimit, Modalitäten und Tool-Unterstützung sind unverändert. Die Verbesserungen liegen bei den Codierungs- und Agenten-Benchmarks: DeepSWE um 16,3 Punkte gestiegen, AutomationBench um 13,4 Punkte gestiegen, WebDev Arena um 50 Elo gestiegen. Google behauptet außerdem ein besseres Debugging, Anweisungsbefolgung und mehrstufige Planung.
Ersetzt Gemini 3.7 Flash Gemini 3.5 Pro?
Nein. Pro bleibt die Flaggschiff-Stufe für die schwierigsten Denkaufgaben, und Gemini 3.5 Pro befindet sich noch in der Entwicklung. Flash 3.7 ist das Modell, das Google für hochvolumige Produktionsarbeiten empfiehlt, bei denen Kosten und Latenz genauso wichtig sind wie Qualität.
Was passiert mit den Preisen am 1. Januar 2027?
Der Einführungspreis endet und die Standardpreise treten in Kraft: 1,50 $ pro 1M Eingabetokens und 7,50 $ pro 1M Ausgabetokens, das Doppelte des Einführungspreises. Planen Sie für jede Arbeitslast, die über 2026 hinausgeht, mit dem Standardtarif.
Kann Gemini 3.7 Flash Bilder und PDFs verarbeiten?
Ja. Die Eingabemodalitäten umfassen Text, Bild, Video, Audio und PDF im selben contents-Array. Die Ausgabe ist nur Text. Der GDP.pdf Benchmark-Score von 34,0 %, gegenüber 22,0 %, ist Googles Beweis dafür, dass das Dokumentenverständnis neben den Codierungsverbesserungen ebenfalls verbessert wurde.
Wo 3.7 Flash in Ihren Stack passt
Gemini 3.7 Flash ist ein Mid-Tier-Modell mit Benchmark-Scores auf Agenten-Niveau und einem viermonatigen Preisnachlass. Diese Kombination macht die Entscheidung weniger zu einer Frage, ob man es evaluieren soll, sondern vielmehr dazu, wie schnell. Die agentischen Gewinne sind reale Zahlen auf öffentlichen Benchmarks, die Spezifikationen entsprechen dem, was Sie heute auf 3.6 ausführen, und der Einführungspreis bedeutet, dass das Testen jetzt nur die Hälfte dessen kostet, was dieselbe Evaluierung im Januar kosten wird.
Die sinnvolle Vorgehensweise: Führen Sie Ihre bestehende Prompt-Suite gegen gemini-3.7-flash aus, vergleichen Sie die Ausgaben und die Token-Nutzung mit Ihrem aktuellen Modell, und lassen Sie die Ergebnisse den Gewinner küren. Laden Sie Apidog herunter, um diesen Vergleich in einem Arbeitsbereich durchzuführen; speichern Sie Ihre 3.6-Antworten als Beispiele, spielen Sie dieselben Anfragen gegen 3.7 ab, und Sie werden innerhalb eines Nachmittags wissen, ob die Benchmark-Story für Ihre Arbeitslast gilt.