TypeSafe AI ist ein KI-Labor aus San Francisco, das Modelle für die Entscheidungsfindung innerhalb von Software entwickelt, nicht für den Chat mit Menschen. Sein erstes öffentliches Modell, Jev, wurde am 16. September 2026 auf dem Vercel AI Gateway veröffentlicht, weshalb der Name diese Woche in Changelogs und Entwickler-Feeds auftauchte.
Wenn Sie „System One Models“ gesehen und sich gefragt haben, ob es sich um eine neue Modellfamilie, eine neue API-Struktur oder Marketing handelt, gibt dieser Leitfaden Antworten darauf. Sie erfahren, wer TypeSafe AI ist, was ein System One Model leistet, wie sich Jev von den LLMs unterscheidet, die Sie bereits aufrufen, wie Sie einen API-Schlüssel und Preise erhalten und wie Sie Ihre erste Anfrage von Apidog senden.
Eine Klarstellung vorab: TypeSafe AI hat keine Verbindung zu Typesafe, dem Scala-Unternehmen, das zu Lightbend wurde, und das Jev-Modell steht in keiner Beziehung zum YouTuber FaZe Jev oder zum JEV-Impfstoff.
Wer ist TypeSafe AI
Das Unternehmen beschreibt sich auf typesafe.ai als „ein KI-Labor, das maschinen-native Intelligenzinfrastruktur für die Automatisierung aufbaut, die darauf ausgelegt ist, Entscheidungen innerhalb von Software zu treffen.“ Der Slogan lautet „Machine-Native Intelligence“, und die Fußzeile liest sich „Made in SF.“
Das Manifest erklärt die Wette. Heutige Modelle sind „darauf trainiert, ein hilfreicher, wortgewandter, angenehmer Assistent zu sein“, was den Menschen bewusst in der Schleife hält. TypeSafe nennt dies ein „pferdeloses Kutschen“-Problem: neue Technologie, die in eine alte Form gezwungen wird. Ihre Antwort ist „maschinen-native, zusammensetzbare KI“, ein Modell, das man wie eine Datenbank oder eine Funktion aufruft, eines, das es Code ermöglicht, „nach gesundem Menschenverstand, Verständnis und Absicht zu verzweigen“, so wie er bereits nach Booleschen Werten verzweigt.
Was ein „System One Model“ ist
TypeSafe prägte die Kategorie in seinem Launch-Post. Ein System One Model ist „darauf ausgelegt, schnelle, strukturierte Entscheidungen zu treffen, die Software direkt nutzen kann.“ Der Name leitet sich vom schnellen, intuitiven „System 1“-Denkmodus ab: schnelle Urteilsfindungen, keine mehrstufigen Überlegungen.
Drei Designentscheidungen definieren die Kategorie:
- Typisierte Entscheidungen als Ausgabe, nicht Text. Das Modell gibt eine Wahrscheinlichkeit, eine Wahl mit einer Verteilung oder einen Score zurück. Es gibt niemals einen Absatz zurück.
- Kalibrierte Wahrscheinlichkeiten. Die Modelle werden mit einer Methode trainiert, die TypeSafe als Reinforcement Learning for Calibrated Decisions (RLCD) bezeichnet, die auf „epistemisch ehrliche Wahrscheinlichkeiten“ optimiert, anstatt auf menschliche Präferenz oder eine verifizierbare Belohnung.
- Keine Zeichenfolgen-Generierung. Der Beitrag ist deutlich: „Jev verzichtet auf die Zeichenfolgen-Generierung.“ Da es niemals freien Text zusammensetzt, behauptet TypeSafe, dass es „nicht halluzinieren kann.“ Lesen Sie das sorgfältig. Jev kann immer noch falsch liegen, aber eine falsche Antwort zeigt sich als eine falsch kalibrierte Wahrscheinlichkeit, nicht als eine erfundene Tatsache oder eine erfundene URL.
Der Launch-Post beschreibt Jev als „einen Frontier-Intelligence-Funktionsaufruf: unstrukturierter Zustand hinein, typisierte probabilistische Entscheidungen heraus.“ Das ist die prägnanteste Zusammenfassung der gesamten Kategorie in einem Satz.
| Typisches LLM | System One Model (Jev) | |
|---|---|---|
| Ausgabe | Freier Text oder eine schema-eingeschränkte Zeichenfolge | Eine Wahrscheinlichkeit, Auswahl oder ein Score |
| Fehlermodus | Plausibler, aber falscher Text | Ein Konfidenzwert, den Sie schwellen können |
| Latenz (Anbieterangaben) | Sekunden, mit Begründung | 70ms bis 500ms End-to-End |
| Am besten geeignet für | Schreiben, Programmieren, mehrstufiges Denken | Klassifizierung, Routing, Verifizierung, Gating |
| Eingabe | Text, Bilder, Audio | Nur Text (Zeichenfolge, Objekt oder Array) |
Die Latenzreihe ist TypeSafes eigener Benchmark, keine unabhängige Messung. Das Unternehmen behauptet auch, dass Jev bei seinen Workflow-Evaluierungen „bis zu 193,6-mal schneller und 444,6-mal günstiger als LLMs“ war. Planen Sie einen eigenen kleinen Test, bevor Sie diese Zahlen wiederholen.
Was Jev leistet
Jev ist TypeSafes erstes öffentliches System One Model. Laut der Modelle-Seite löst der Alias jev-latest zu jev-1.13.0 auf, und jev-preview verweist derzeit auf denselben Build. Aliase verschieben sich bei neuen Releases, daher sollten Sie die versionierte ID festlegen, wenn Sie Schwellenwerte gegen eine bestimmte Version anpassen.
Jede Anfrage beantwortet eine oder mehrere Fragen zu einem gemeinsamen state. Es gibt drei Fragetypen, die TypeSafe als Primitiven bezeichnet:
Noul ist eine Ja/Nein-Entscheidung. Sie erhalten eine einzelne Wahrscheinlichkeit zurück.
{ "type": "noul", "noul": 0.92 }
Choice wählt eine Option aus einem benannten Satz aus. Sie stellen eine criteria-Map von Optionsnamen zu Beschreibungen bereit und erhalten die ausgewählte Option, eine Wahrscheinlichkeit für jede Option und eine Gesamtkonfidenz. Jev unterstützt bis zu 255 Optionen in einer Auswahl.
{
  "type": "choice",
  "choice": "technical",
  "probabilities": { "billing": 0.08, "technical": 0.85, "sales": 0.07 },
  "confidence": 0.82
}
Score bewertet den Zustand entlang einer geordneten Skala von 2 bis 10 Stufen. Die Antwort ist ein interpolierter Score plus eine Legende und eine Wahrscheinlichkeit pro Stufe.
{
  "type": "score",
  "score": 1.6,
  "legend": { "0": "Calm", "1": "Frustrated", "2": "Very angry" },
  "probabilities": { "0": 0.05, "1": 0.3, "2": 0.65 },
  "confidence": 0.78
}
Einschränkungen aus der Dokumentation: nur Text (keine Bild-, Audio- oder Videoeingabe), 64k Tokens pro Anfrage und 32k Tokens für state plus die längste Frage. Das state-Feld nimmt „eine einfache Zeichenfolge für Text oder strukturierte Daten (Objekt/Array) für Dinge wie Chat-Protokolle, Datensätze oder den aktuellen Zustand Ihrer Anwendung“ auf, sodass Sie einen JSON-Datensatz ohne vorherige Serialisierung übergeben können.
Für eine detailliertere Erläuterung des Modells selbst, siehe was Jev ist und wie es funktioniert.
Wie sich Jev von einem LLM-Anbieter unterscheidet
Der häufigste Fehler ist es, TypeSafe neben OpenAI oder Anthropic einzuordnen. Es konkurriert nicht auf derselben Ebene.
Ein LLM-Anbieter verkauft Generierung. Selbst OpenAIs strukturierte Ausgaben funktionieren, indem eine generierte Zeichenfolge an ein JSON-Schema gebunden wird; das Modell schreibt immer noch Tokens, und das Schema hält die Form gültig. Jev überspringt die Generierung. Es bewertet die von Ihnen angegebenen Optionen und gibt die Verteilung zurück. Es gibt keinen Token-Stream zum Parsen, kein JSON zum Reparieren und keinen „Entschuldigung, das kann ich nicht“-Ablehnungstext.
Das macht Jev zu einer Ergänzung Ihres LLM, nicht zu einem Ersatz. Die Aufgaben, für die es geeignet ist:
- Weiterleiten eines Tickets, einer Nachricht oder einer Webhook-Payload an den richtigen Handler
- Steuerung der nächsten Aktion eines Agenten („Ist dieser Tool-Aufruf sicher auszuführen?“)
- Überprüfung der Antwort eines LLM anhand einer Rubrik, bevor Sie sie zurückgeben
- Bewertung von Qualität, Dringlichkeit oder Stimmung für Dashboards und Warnungen
- Massenklassifizierung von Datensätzen, bei der die Kosten pro Aufruf wichtig sind
In einem API-Stack sitzt Jev auf derselben Ebene wie eine Validierungsfunktion oder ein Feature-Flag-Check: ein schneller, günstiger Aufruf, dessen Ergebnis Ihr Code verzweigt.
Wie man Zugang erhält
Es gibt drei Wege, und keiner erfordert eine Chat-Oberfläche.
Konsole und direkte API. Erstellen Sie einen Schlüssel unter console.typesafe.ai unter Einstellungen und rufen Sie dann den im API-Referenz dokumentierten Endpunkt auf:
curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": "Help! My payouts have been failing for 3 days.",
    "questions": {
      "is_urgent": { "type": "noul", "instructions": "Does this convey urgency?" }
    }
  }'
Die Antwort spiegelt die Anfrage wider: ein answers-Objekt, das nach Ihren Fragetypen geschlüsselt ist, plus usage mit Eingabe- und Ausgabe-Token-Zählungen.
SDKs. TypeSafe veröffentlicht ein Python-Paket (typesafe-sdk) und ein JavaScript-SDK, die denselben Endpunkt umschließen.
Vercel AI Gateway. Gemäß dem Changelog vom 16. September ist Jev als typesafe-ai/jev über die Funktion experimental_evaluate in AI SDK 7.0.105 und höher verfügbar. Vercels Evaluierungsdokumentation besagt explizit, dass diese Modalität nur für das AI SDK bestimmt ist; sie wird nicht über die OpenAI-kompatiblen oder Anthropic-kompatiblen Endpunkte bereitgestellt. Wenn Sie bereits Modelle über das Vercel AI SDK routen, lässt sich Jev mit demselben Gateway-Schlüssel einbinden, und Sie können pro Anfrage über providerOptions.gateway Optionen für Null-Datenaufbewahrung und kein Training festlegen. Die Token-Nutzung wird pro Anfrage gemeldet und zu den Raten des Modells abgerechnet.
Preise und Ratenbegrenzungen
Die Preisgestaltung ist eine Zahl. Eingabe-Tokens kosten 0,042 $ pro Million (TypeSafe schreibt es auch als 42 $ pro Milliarde). Ausgabe-Tokens sind kostenlos, was im Launch-Post als „zu günstig zum Messen“ beschrieben wird.
Die Ratenbegrenzungen auf der Modelle-Seite betragen 250.000 Tokens pro Sekunde und 1.200 Anfragen pro Minute, mit dem Hinweis, dass sie sich dynamisch anpassen. Vier Fehlercodes sind relevant:
| Status | Bedeutung | Was zu tun ist |
|---|---|---|
| 401 | Fehlender oder ungültiger Schlüssel | Überprüfen Sie den Bearer-Header |
| 422 | Anfragevalidierung fehlgeschlagen | Überprüfen Sie Fragetypen und Kriteriengestalt |
| 429 | Ratenbegrenzung überschritten | Wiederholen Sie mit exponentiellem Backoff |
| 529 | Dienst überlastet | Wiederholen Sie mit exponentiellem Backoff |
Testen Sie Ihre erste Jev-Anfrage in Apidog
Bevor Sie Jev in einen Router oder eine Agentenschleife einbinden, führen Sie es als einfache HTTP-Anfrage aus und überprüfen Sie das Ergebnis. Das dauert in Apidog etwa zwei Minuten.
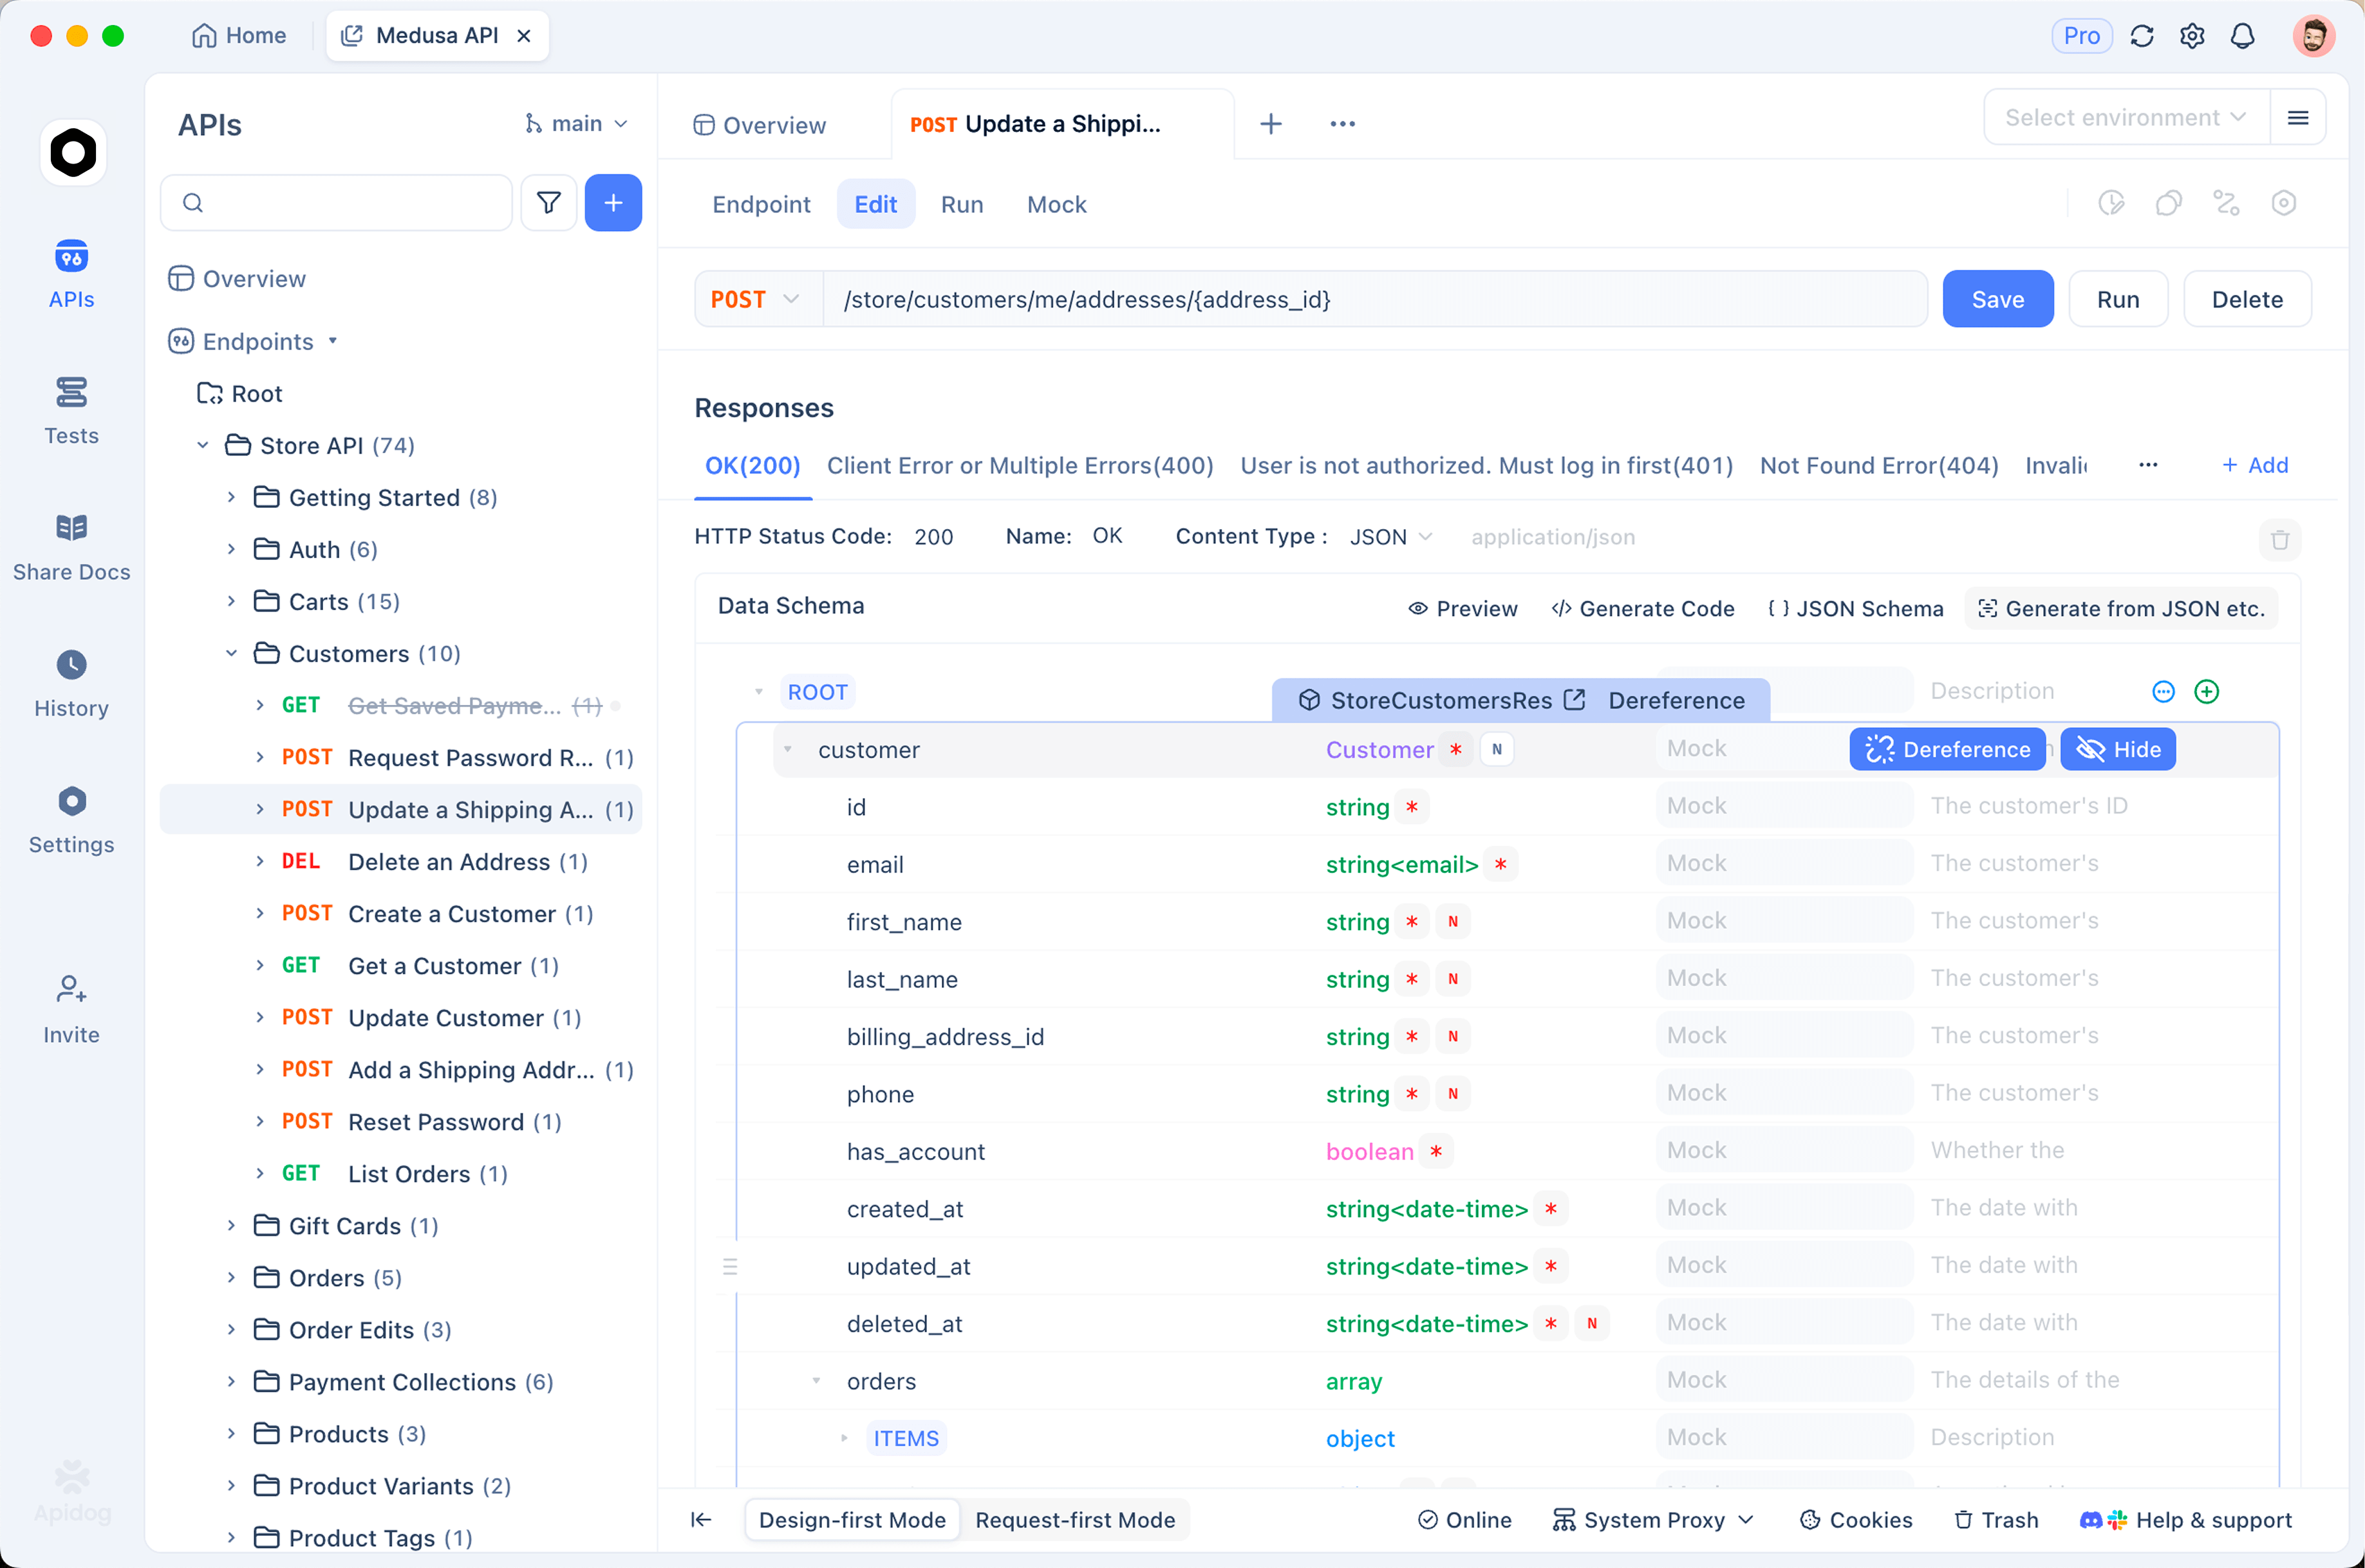
- Erstellen Sie ein Projekt und öffnen Sie das Umgebungsfenster. Fügen Sie eine Variable namens
TYPESAFE_API_KEYhinzu, markieren Sie diese als geheime Variable, damit der Wert in der Benutzeroberfläche maskiert wird und niemals in exportierten Sammlungen landet, und fügen Sie Ihren Schlüssel aus der Konsole ein. - Erstellen Sie eine
POST-Anfrage anhttps://api.typesafe.ai/v1/systemone. Fügen Sie einen HeaderAuthorization: Bearer {{TYPESAFE_API_KEY}}hinzu. Apidog füllt die Variable zum Zeitpunkt des Sendens. - Fügen Sie den JSON-Body aus dem obigen cURL-Beispiel ein und senden Sie die Anfrage. Sie sollten
answers.is_urgent.noulnahe 0,9 sehen. - Öffnen Sie den Post-Prozessor-Tab und fügen Sie eine Assertion hinzu: JSONPath
$.answers.is_urgent.noul, Bedingung größer als0.8. Nun schlägt die Anfrage lautstark fehl, wenn die Konfidenz des Modells abweicht. - Duplizieren Sie die Anfrage, tauschen Sie
"model": "jev-latest"gegen"jev-1.13.0"aus und speichern Sie beides in einem Testszenario. Führen Sie es nach Zeitplan oder in CI aus. Wenn der Alias zu einem neuen Release wechselt, weichen die angeheftete Anfrage und die Alias-Anfrage voneinander ab, und Ihre Assertion fängt dies ab, bevor es die Produktion tut.
Dasselbe Szenario dient auch als Kalibrierungsprüfung. Speisen Sie zehn von Hand beschriftete Zustände ein, überprüfen Sie jede Wahrscheinlichkeit, und Sie haben eine Regressionstestsuite für ein Entscheidungsmodell, die ohne das Schreiben eines Test-Harnesses erstellt wurde. Laden Sie Apidog herunter, um mitzumachen; der kostenlose Plan deckt diesen Workflow für Teams bis zu vier Personen ab.
FAQ
Ist TypeSafe AI dasselbe wie Typesafe, das Scala-Unternehmen? Nein. Typesafe Inc. war das Unternehmen hinter Akka und dem Play Framework, das 2016 in Lightbend umbenannt wurde. TypeSafe AI ist ein separates Labor in San Francisco, das um die Idee der System One Models gegründet wurde, ohne gemeinsame Produkte oder Personen auf beiden Seiten.
Ersetzt Jev mein LLM? Nein. Jev generiert keinen Text, Code oder Zusammenfassungen. Behalten Sie Ihr LLM für diese Aufgaben und setzen Sie Jev davor oder dahinter als Router, Gate oder Verifizierer ein. Der Jev-Deep-Dive behandelt konkrete Muster für die Kombination der beiden.
Benötige ich Vercel, um Jev zu nutzen? Nein. Die direkte API funktioniert mit einem Schlüssel aus der TypeSafe-Konsole. Das Vercel AI Gateway ist eine Annehmlichkeit, wenn Sie bereits das AI SDK verwenden und einen einzigen Schlüssel und eine einzige Abrechnung über alle Anbieter hinweg wünschen.
Kann Jev halluzinieren? Das ist die Behauptung von TypeSafe, und sie stimmt in dem engen Sinne, dass Jev keinen Text erfinden kann, da es niemals welchen ausgibt. Es kann jedoch bei einer Eingabe außerhalb seiner Trainingsverteilung übermäßig selbstbewusst sein. Legen Sie einen Schwellenwert für die confidence fest und testen Sie mit Ihren eigenen beschrifteten Daten, bevor Sie einem Score in der Produktion vertrauen.
Wer finanziert TypeSafe AI? Die Teamseite spricht von „Spitzeninvestoren“ und nichts weiter. Es gibt keine offizielle Seite, die sie namentlich nennt oder einen Betrag angibt, daher ist jede Zahl, die Sie anderswo lesen, unbestätigt.