
REA, kurz für Reverse Engineer Anything, ist ein Open-Source-MCP-Server und CLI, die einem Coding-Agenten die Werkzeuge geben, Software ohne ihren Quellcode zu zerlegen. Richte Claude Code, Codex, Cursor oder einen anderen Agenten auf eine native Binärdatei, eine Electron-App, eine .NET-Assembly, eine Android-APK, eine Website oder einen gespeicherten Netzwerk-Mitschnitt, frage, wie ein Feature funktioniert, und REA liefert Pseudocode, Modulgraphen, Request-Logs und die Belege für jede Aussage zurück. Der Agent erklärt anschließend das Verhalten oder baut es nach.
Das Repository morluto/rea wurde im April 2026 erstellt und blieb bis zur ersten Oktoberwoche weitgehend unbeachtet. Bis zum 12. Oktober hatte es mehr als 115.000 Stars und 25.000 Forks erreicht, einer der schnellsten Anstiege, die GitHub gesehen hat. Dieser Guide behandelt, was REA tut, wie du es installierst, wo es stark ist, wo der Hype weitergeht als die Realität, und den Teil, den die meisten Berichte auslassen: REA liest HAR- und mitmproxy-Mitschnitte und ist damit ein Frontend für API-Reverse-Engineering, das du in Apidog abschließen kannst.
Die Zahlen hinter dem Hype
Trendshifts tägliches Tracking zeigt die Form des Anstiegs. REA erschien am 4. Oktober zum ersten Mal in der Trending-Liste, mit rund 1.400 neuen Stars an einem Tag. Danach wuchs es eine Woche lang weiter compoundiert.
| Datum | Neue Stars an diesem Tag |
|---|---|
| 4. Okt. | 1.373 |
| 7. Okt. | 5.602 |
| 9. Okt. | 19.375 |
| 10. Okt. | 26.572 |
| 11. Okt. | 31.255 |
Das Repository hielt fünf der sieben Tage vom 6. bis 12. Oktober den ersten Platz in den GitHub Trendings. Releases hielten Schritt: Version 3.2 erschien am 3. Oktober, 4.0 am 5. Oktober, 5.0 am 7. Oktober, 6.0 am 8. Oktober und 6.1 bis 6.4 zwischen dem 9. und 11. Oktober. Dieses Tempo ist für jede Person wichtig, die REA einführt, und wir kommen darauf zurück.
Kein einzelner Tweet oder Launch-Post erklärt den Sprung. Der Pitch hat die Arbeit getan: „Sieh ein Feature, das dir gefällt. Verstehe, wie es funktioniert, bis auf die Binärebene.“ Demo-Videos von Agenten, die Desktop-Apps aus ihren Binärdateien nachbauen, verbreiteten sich schnell, zusammen mit den üblichen Behauptungen, Software sei am Ende. Die nützlichere Lesart ist enger. REA ist ein gut verpackter Konnektor zwischen Agenten und Reverse-Engineering-Werkzeugen, die bereits existierten.
Was REA tut
REA läuft als lokaler MCP-Server. Dein Agent ruft dessen Werkzeuge auf, REA untersucht das Ziel mit der passenden Engine, und der Agent erhält strukturierte Erkenntnisse samt Einschränkungen und offenen Fragen. Dieselben Workflows stehen als CLI-Befehle zur Verfügung, sodass du sie auch ganz ohne Agenten skripten kannst.
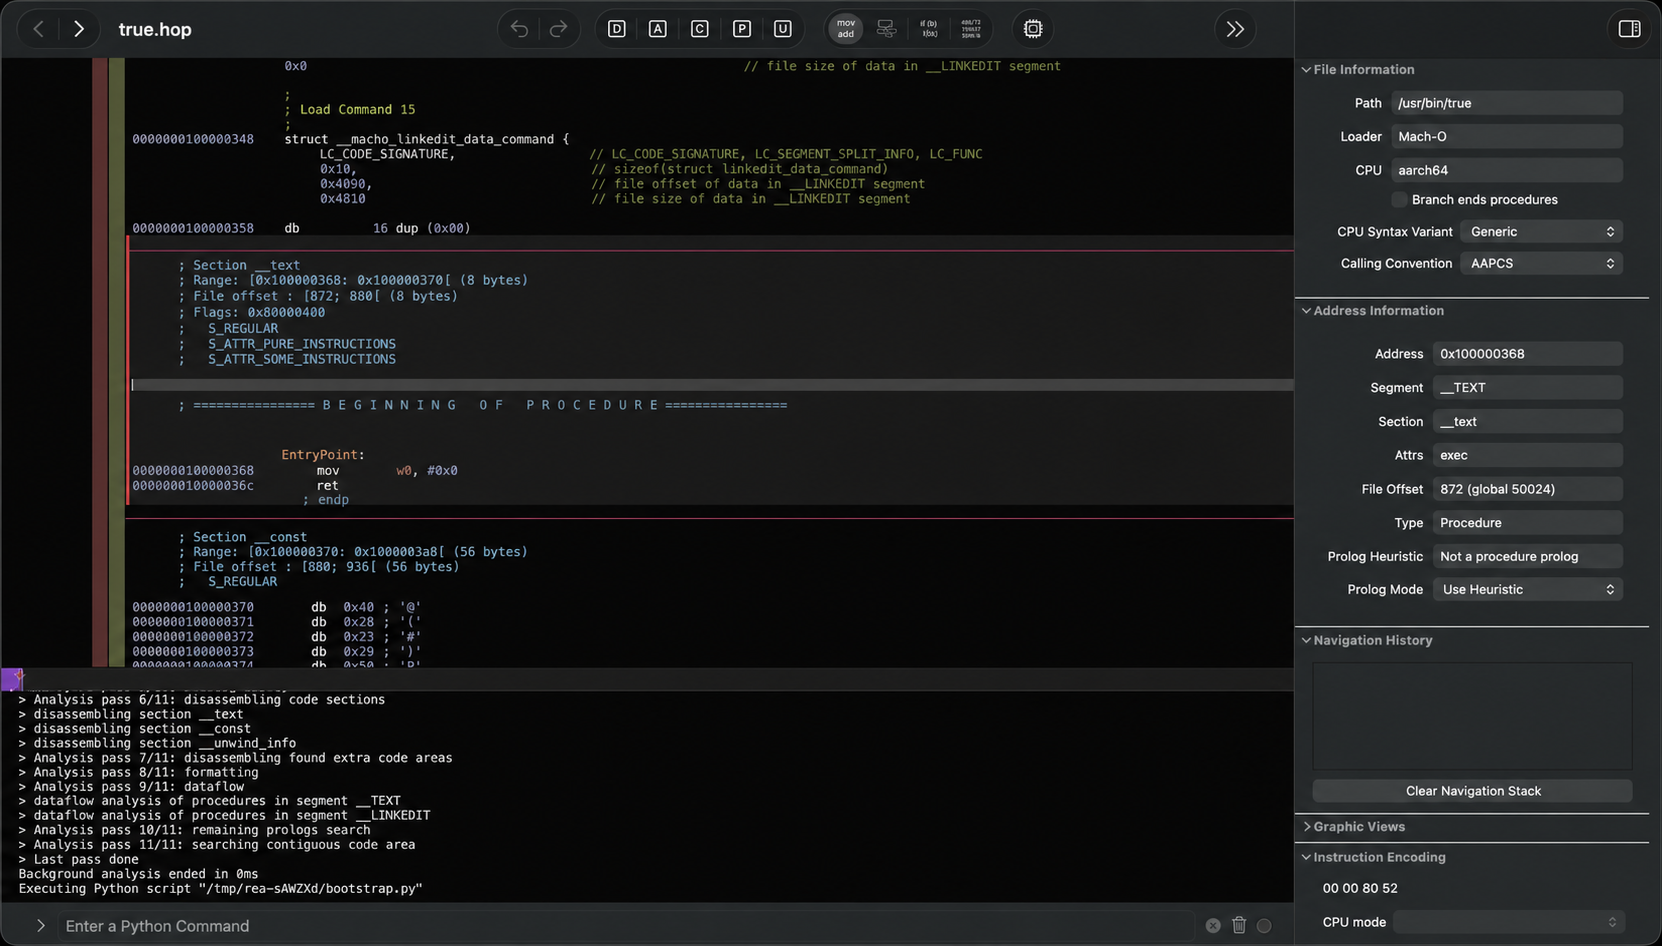
Was es analysiert, laut der Zieltabelle im README:
| Ziel | Was REA zurückgibt | Benötigt |
|---|---|---|
| Native Binärdateien | Pseudocode, Assembly, Strings, Symbole, Querverweise | Hopper, Ghidra oder IDA |
| Go-Binärdateien | Compilerversion, Module, Buildeinstellungen | Nichts zusätzliches |
| JavaScript- und Electron-Apps | Module, Imports, Source Maps, Routen, IPC-Grenzen | Nur Node.js |
| Websites | Seitenstruktur, Skripte, Netzwerkbeobachtungen, Screenshots | Ein Browser aus der Chrome-Familie |
| Gespeicherte Netzwerk-Mitschnitte | Requests, Responses, Payloads, Quellpositionen | HAR; mitmdump unter Linux für mitmproxy |
| .NET-Assemblies | Metadaten, CIL, native Abhängigkeiten | Nichts zusätzliches |
| Android-APKs und Geräte | Manifest, dekompilierte Methoden, Logs, Bildschirmaufnahmen | JADX plus JDK; adb |
| Firmware | Regionen, Extraktionsergebnisse | Binwalk oder Unblob unter Linux |
| WASM- und EVM-Bytecode | Sections, Imports und Exports, Dispatch-Selektoren | WABT; Linux x64 |
Der Entwurfsentscheid, der REA von einem dünnen Wrapper unterscheidet, ist das Belegmodell. Jedes Ergebnis trägt seine Herkunft: Datei-Digests, Bytebereiche, JSON-Pointer in den Mitschnitt und eine explizite Liste dessen, was die Analyse nicht feststellen konnte. Das Projekt weist in seiner Dokumentation wiederholt darauf hin. Die Analyse läuft auf deinem Rechner, aber das FAQ im README sagt unmissverständlich, dass der Modellanbieter des Agenten die Tool-Ergebnisse weiterhin nach seiner eigenen Datenpolitik erhält.
So installierst du REA
Du brauchst Node.js 22.19 oder neuer (23 und 25 werden nicht unterstützt) sowie npm. Ein Befehl registriert den MCP-Server und installiert die passenden Skill-Anweisungen für deinen Agenten:
npx rea-agents setup
Das Setup zeigt einen Plan an, sichert die bestehende Konfiguration und schreibt erst nach deiner Zustimmung. Laut der Installationsanleitung werden Claude Code, Claude Desktop, Codex, Cursor, Gemini CLI, Windsurf, Devin, OpenCode, Antigravity, GitHub Copilot CLI, VS Code, Grok Build, Hermes und weitere unterstützt, jeweils auswählbar mit einem Flag --client. Starte danach den Agenten neu und frage ihn etwa so:
Understand how search works in the Notes app, show me the evidence,
and build a similar feature for my project.
Für eine globale CLI:
npm install --global rea-agents
rea doctor --json
Statische JavaScript-, .NET-, Website- und Mitschnittanalysen funktionieren ohne zusätzliche Engine. Tiefe native Analysen brauchen Hopper, Ghidra 12.1 mit JDK 21 oder neuer, oder IDA. Das Setup kann Hopper mit deiner Zustimmung installieren, aber Hopper ist eigenständige kommerzielle Software mit eigener Lizenz. Ghidra unter Windows gilt als experimentell.
Was REA gut kann, gezeigt an den Showcase-Beispielen
Die eigenen Fallstudien des Projekts sind der ehrlichste Benchmark. In der DX-Boll-Studie folgte der Agent einem Sound-Aufruf bis zur Position-zu-Pan-Hilfsfunktion, wandelte unvollständigen Pseudocode in C um, und die Rekonstruktion bestand 3.205 originale x86-Testfälle, während alle 63 Bytes der kompilierten Funktion reproduziert wurden. In der Notion-Studie verfolgte er die Clipboard-API vom Renderer über Preload und IPC bis in den Electron-Main-Prozess. Eine dritte Studie gewann eine Berechnung des Bullet-Ring-Winkels aus 16-Bit-Instruktionen eines PC-98-Spiels aus den 1990er-Jahren zurück.
Beachte das Muster. Das sind eng begrenzte Fragen zu einer Funktion oder einem Datenpfad, mit einer Möglichkeit, die Antwort zu überprüfen. Genau dort funktioniert agentengesteuertes Reverse-Engineering heute. „Baue diese ganze App neu“-Demos sehen im Video gut aus und erzeugen etwas, das dem Ziel ähnelt, aber eine frühe Review, die REA bei einer einfachen Mac-App gegen einen Vanilla-Agenten testete, fand einen geringen Abstand und einen langsameren REA-Lauf. Der Wert zeigt sich, wenn die Frage konkret und das Ziel komplex ist.
REA für API-Arbeit: vom Mitschnitt zur getesteten Spezifikation
Hier kommt der Teil, der für alle relevant ist, die gegen APIs bauen. REAs Werkzeug inspect_web_network_capture liest eine HAR-Datei (oder einen nativen mitmproxy-Mitschnitt unter Linux) offline. Es ruft aufgezeichnete URLs nie erneut ab. Es validiert jeden Eintrag, bewahrt Request- und Response-Bodies mit ihren Digests und schließt Autorisierungsheader, Cookies und URL-Credentials strukturell aus den Belegen aus.
Danach tut es etwas, das jedes API-Team sofort erkennt. Übergib die bewahrten Belege an inspect_analysis_view mit der Ansicht api-surface, und REA gruppiert jeden Request nach Methode, Origin und abgeleiteter Pfadvorlage. Numerische IDs werden zu {numeric}, UUIDs zu {uuid}, lange Hex-Strings zu {hex} und Daten zu {iso-date}. Jede Gruppe zitiert die Datensätze, aus denen sie stammt, und kennzeichnet gemischte Status oder Content-Types. Der Mitschnitt-Guide betont ausdrücklich, dass die Ansicht keine Schema- oder Handler-Aussagen trifft. Sie ist ein abgeleitetes Inventar, keine Spezifikation.
Dieses Inventar ist genau der Ausgangspunkt für den Workflow in unserem Guide zum Reverse-Engineering von APIs, und Apidog vollendet ihn:
- Einmal aufzeichnen. Reproduziere in den Chrome DevTools den Ablauf und speichere alle Requests als HAR mit Inhalt. Nutze ein Testkonto; eine HAR-Datei enthält aktive Tokens.
- Den Agenten kartieren lassen. Bitte deinen Agenten, REA auf die HAR-Datei anzuwenden und die API-Oberfläche zusammenzufassen. Du erhältst die Endpoint-Liste, die ID-Muster und die fehlschlagenden Calls, mit Zeigern zurück zu den Rohdatensätzen.
- Dieselbe HAR-Datei in Apidog importieren. Apidog wandelt erfasste Requests in Endpoints um, optional mit einem Standardtestfall pro Endpoint und dem Entfernen statischer Assets beim Import. Unsere HAR-Import-Anleitung behandelt die Bereinigung.
- Abgeleitete Vorlagen zu echten Pfadparametern befördern. REAs Platzhalter
{numeric}und{uuid}zeigen, welche Segmente in den Apidog-Endpoint-Definitionen parametrisiert werden müssen. - Mocken und testen. Aktiviere Apidogs Smart Mock, damit dein Client-Code gegen die rekonstruierte API laufen kann, bevor du die echte berührst. Schreibe dann Assertions gegen die erfassten Response-Shapes und führe sie über die Apidog-CLI in CI aus.
Die Aufteilung ist sauber. REA ist gut darin, Belege zu lesen und zu erklären. Apidog ist der Ort, an dem Endpoints zu einem dokumentierten, gemocten und getesteten Contract werden, den dein Team teilen kann. Keines übernimmt die Arbeit des anderen.
Einschränkungen vor der Einführung
Release-Tempo schneidet auf beiden Seiten. Sieben Minor-Versionen erschienen in neun Tagen, und die Projekt-Richtlinie always-bump-minor bedeutet, dass ein Minor-Bump breaking sein kann. Der 6.2-Migrationsguide veränderte die Form jedes MCP-Ergebnisses. Wenn du gegen REAs JSON-Ausgabe skriptest, pinne die Version und lies das Changelog, bevor du aktualisierst.
Es ist ein Konnektor, keine Sandbox. Die Sicherheitsrichtlinie des Projekts sagt, dass seine lokale Provider-Bridge keine Sandbox ist und dass das Öffnen einer nicht vertrauenswürdigen Binärdatei deren Parsing mit deinen Benutzerrechten ausführt. Analysiere nicht vertrauenswürdige Ziele in einer isolierten Umgebung, genauso wie du die Tool-Calls jedes Agenten isolieren würdest.
Plattformgrenzen sind spezifisch. Natives mitmproxy-Decoding benötigt exakt mitmdump 12.2.3, unter Linux, von dir bereitgestellt. Firmware-Extraktion, EVM und WASM laufen auf Linux x64. Für Hopper gibt es keinen Windows-Build.
Die rechtliche Verantwortung bleibt bei dir. Das README beschränkt REA auf rechtmäßige Forschung, Analyse und Rekonstruktion und sagt, dass du für die Autorisierung verantwortlich bist. Ein Wettbewerber-Feature zu kopieren bleibt dieselbe Rechtsfrage wie vor dem Werkzeug. Das Projekt musste zudem erklären, dass es keinen Token ausgegeben hat und Coins, die seinen Namen nutzen, nicht verbunden sind.
Es ist früh. Beim Schreiben gibt es über 100 Contributors sowie mehr als 170 offene Issues und Pull Requests. Die Dokumentation ist gründlich, aber außerhalb der gezeigten Pfade sind rauhe Kanten zu erwarten.
Häufig gestellte Fragen
Ist REA kostenlos? Ja. Der Code steht unter der MIT-Lizenz und das npm-Paket ist kostenlos. Hopper ist ein kostenpflichtiges Produkt, wenn du es für native Analysen wählst; Ghidra ist kostenlos.
Lädt REA meine App oder Binärdatei hoch? Nein. Die Analyse läuft lokal. Die Tool-Ergebnisse gehen an das Modell, das dein Agent nutzt, daher gilt die Datenpolitik dieses Anbieters.
Brauche ich Ghidra oder IDA für den Einstieg? Nicht für JavaScript-, Electron-, .NET-, Website- oder Mitschnittanalysen. Nur die Dekompilierung nativer Binärdateien braucht eine Engine.
Kann REA aus Traffic eine OpenAPI-Spec erzeugen? Nein. Die api-surface-Ansicht ist ein abgeleitetes Inventar mit Pfadvorlagen. Importiere die HAR-Datei in Apidog, um editierbare Endpoint-Definitionen zu erhalten, und exportiere von dort OpenAPI. Lade Apidog herunter, um den Import mit einem vorhandenen Mitschnitt auszuprobieren.
Was das für dich bedeutet
REA hat sich seine Stars verdient, indem es echte Reverse-Engineering-Engines hinter einem MCP-Server bündelte und die zurückgegebenen Belege dokumentierte. Nutze es für präzise begrenzte Fragen: wie eine Funktion funktioniert, welcher IPC-Kanal eine Nachricht trägt oder wie der Traffic einer App aussieht. Behandle die Alles-nachbauen-Demos als Demos.
Für API-Teams liegt der praktische Gewinn im Mitschnitt-Pfad. Lass den Agenten die HAR-Datei mit REA lesen, importiere anschließend dieselbe Datei in Apidog und verwandle das Inventar in Endpoints, die du mocken, testen und dokumentieren kannst.