
Das Qwen-Team von Alibaba hat Qwen-Image-2.1 am 20. September 2026 als Open-Source veröffentlicht. Es ist ein einziges Modell, das Text-zu-Bild-Generierung und Bildbearbeitung durchführt, mit 7 Milliarden Parametern in seiner visuellen Generierungskomponente, und es kann transparente PNGs direkt aus einem Prompt ausgeben, anstatt sie durch einen Hintergrundentfernungsdurchlauf zu fälschen. Der Launch-Post listet vier Änderungen auf: eine leichtere, schnellere Architektur, native Transparenz, Bearbeitung mit bis zu 10 Referenzbildern sowie verbesserte Typografie und Porträtdetails. Die Gewichte sind auf Hugging Face und ModelScope verfügbar, und der Code ist auf GitHub.
Eine Zeile in der Modellkarte ist wichtiger als jede Funktion: Die Lizenz ist die Qwen Research License, nicht Apache 2.0. Kommerzielle Nutzung erfordert eine separate Vereinbarung. Wenn Sie 2.1 für ein Produkt evaluieren, lesen Sie diesen Abschnitt vor den Benchmarks. Wenn Sie es ausführen möchten, enthält die Qwen-Image-2.1-Anleitung den Diffuser-Code und einen HTTP-Wrapper, den Sie in Apidog testen können. Wenn Sie es mit der gehosteten Qwen Image 3.0 API vergleichen, ist der 2.1 vs 3.0 Vergleich die Entscheidungsseite.
Qwen-Image-2.1 auf einen Blick
| Element | Details (Launch-Post, Modellkarte, GitHub README) |
|---|---|
| Veröffentlichungsdatum | 20. September 2026 |
| Funktionsweise | Text-zu-Bild-Generierung und Bildbearbeitung in einem Modell, einschließlich transparenter (RGBA) Ausgabe |
| Visueller Generator | 32 Single-Stream DiT-Ebenen, 7 Mrd. Parameter |
| Text-Encoder | Qwen3-VL 8B |
| VAE | 64-Kanal-RGBA-Autoencoder, 16-fache räumliche Kompression |
| Standardausgabe | 2048 x 2048; sieben Seitenverhältnisse bis zu 2752 x 1536 |
| Referenzbilder | Bis zu 10 pro Bearbeitung |
| Lokale Bearbeitung | Kreise, gemalte Anmerkungen oder ein separates Maskenbild |
| Begleitmodelle | Qwen-Image-2.1-PE-T2I und PE-I2I Prompt-Rewriting-Modelle (Qwen3.5-VL 9B Fine-Tunes) |
| Lizenz | Qwen Research License Agreement; kommerzielle Nutzung erfordert eine separate Lizenz |
| Probieren Sie es aus | Hugging Face Space, Qwen Chat, ComfyUI (native Unterstützung seit dem Launch-Tag) |
Wo es sich in der Qwen-Image-Linie einordnet
Das ursprüngliche Qwen-Image wurde im August 2025 als 20B MMDiT-Modell, bekannt für Text-Rendering, ausgeliefert, mit Qwen-Image-Edit als separatem Bearbeitungsmodell. Bis Ende 2025 spaltete sich die Linie weiter auf: das 2512-Update für Realismus, Edit-2511 für Multi-Personen-Konsistenz und Qwen-Image-Layered im Dezember für transparente Ebenen. Qwen-Image-2.0 im Februar 2026 fasste Generierung und Bearbeitung in einem 7B-Modell mit nativer 2K-Ausgabe zusammen.
Version 2.1 behält die Größe und das vereinheitlichte Design von 2.0 bei und integriert die Transparenz des Layered-Modells, sodass ein Checkpoint nun abdeckt, was früher drei erforderte. Es erhält auch einen neuen Inferenzpfad (mehr dazu unten) und eine Bearbeitungsoberfläche, die auf Masken und mehreren Referenzen basiert. Parallel dazu betreibt Alibaba eine gehostete Linie: Qwen Image 3.0 und 3.0 Pro wurden im Juli 2026 als API-Modelle ohne veröffentlichte Gewichte gestartet. Die Namensgebung ist also eine Gabelung, keine Reihenfolge. 2.1 ist das offene Modell, das Sie herunterladen; 3.0 ist das Modell, das Sie mieten.
Was ist neu in 2.1
Eine leichtere Architektur und ein schnellerer Bearbeitungspfad
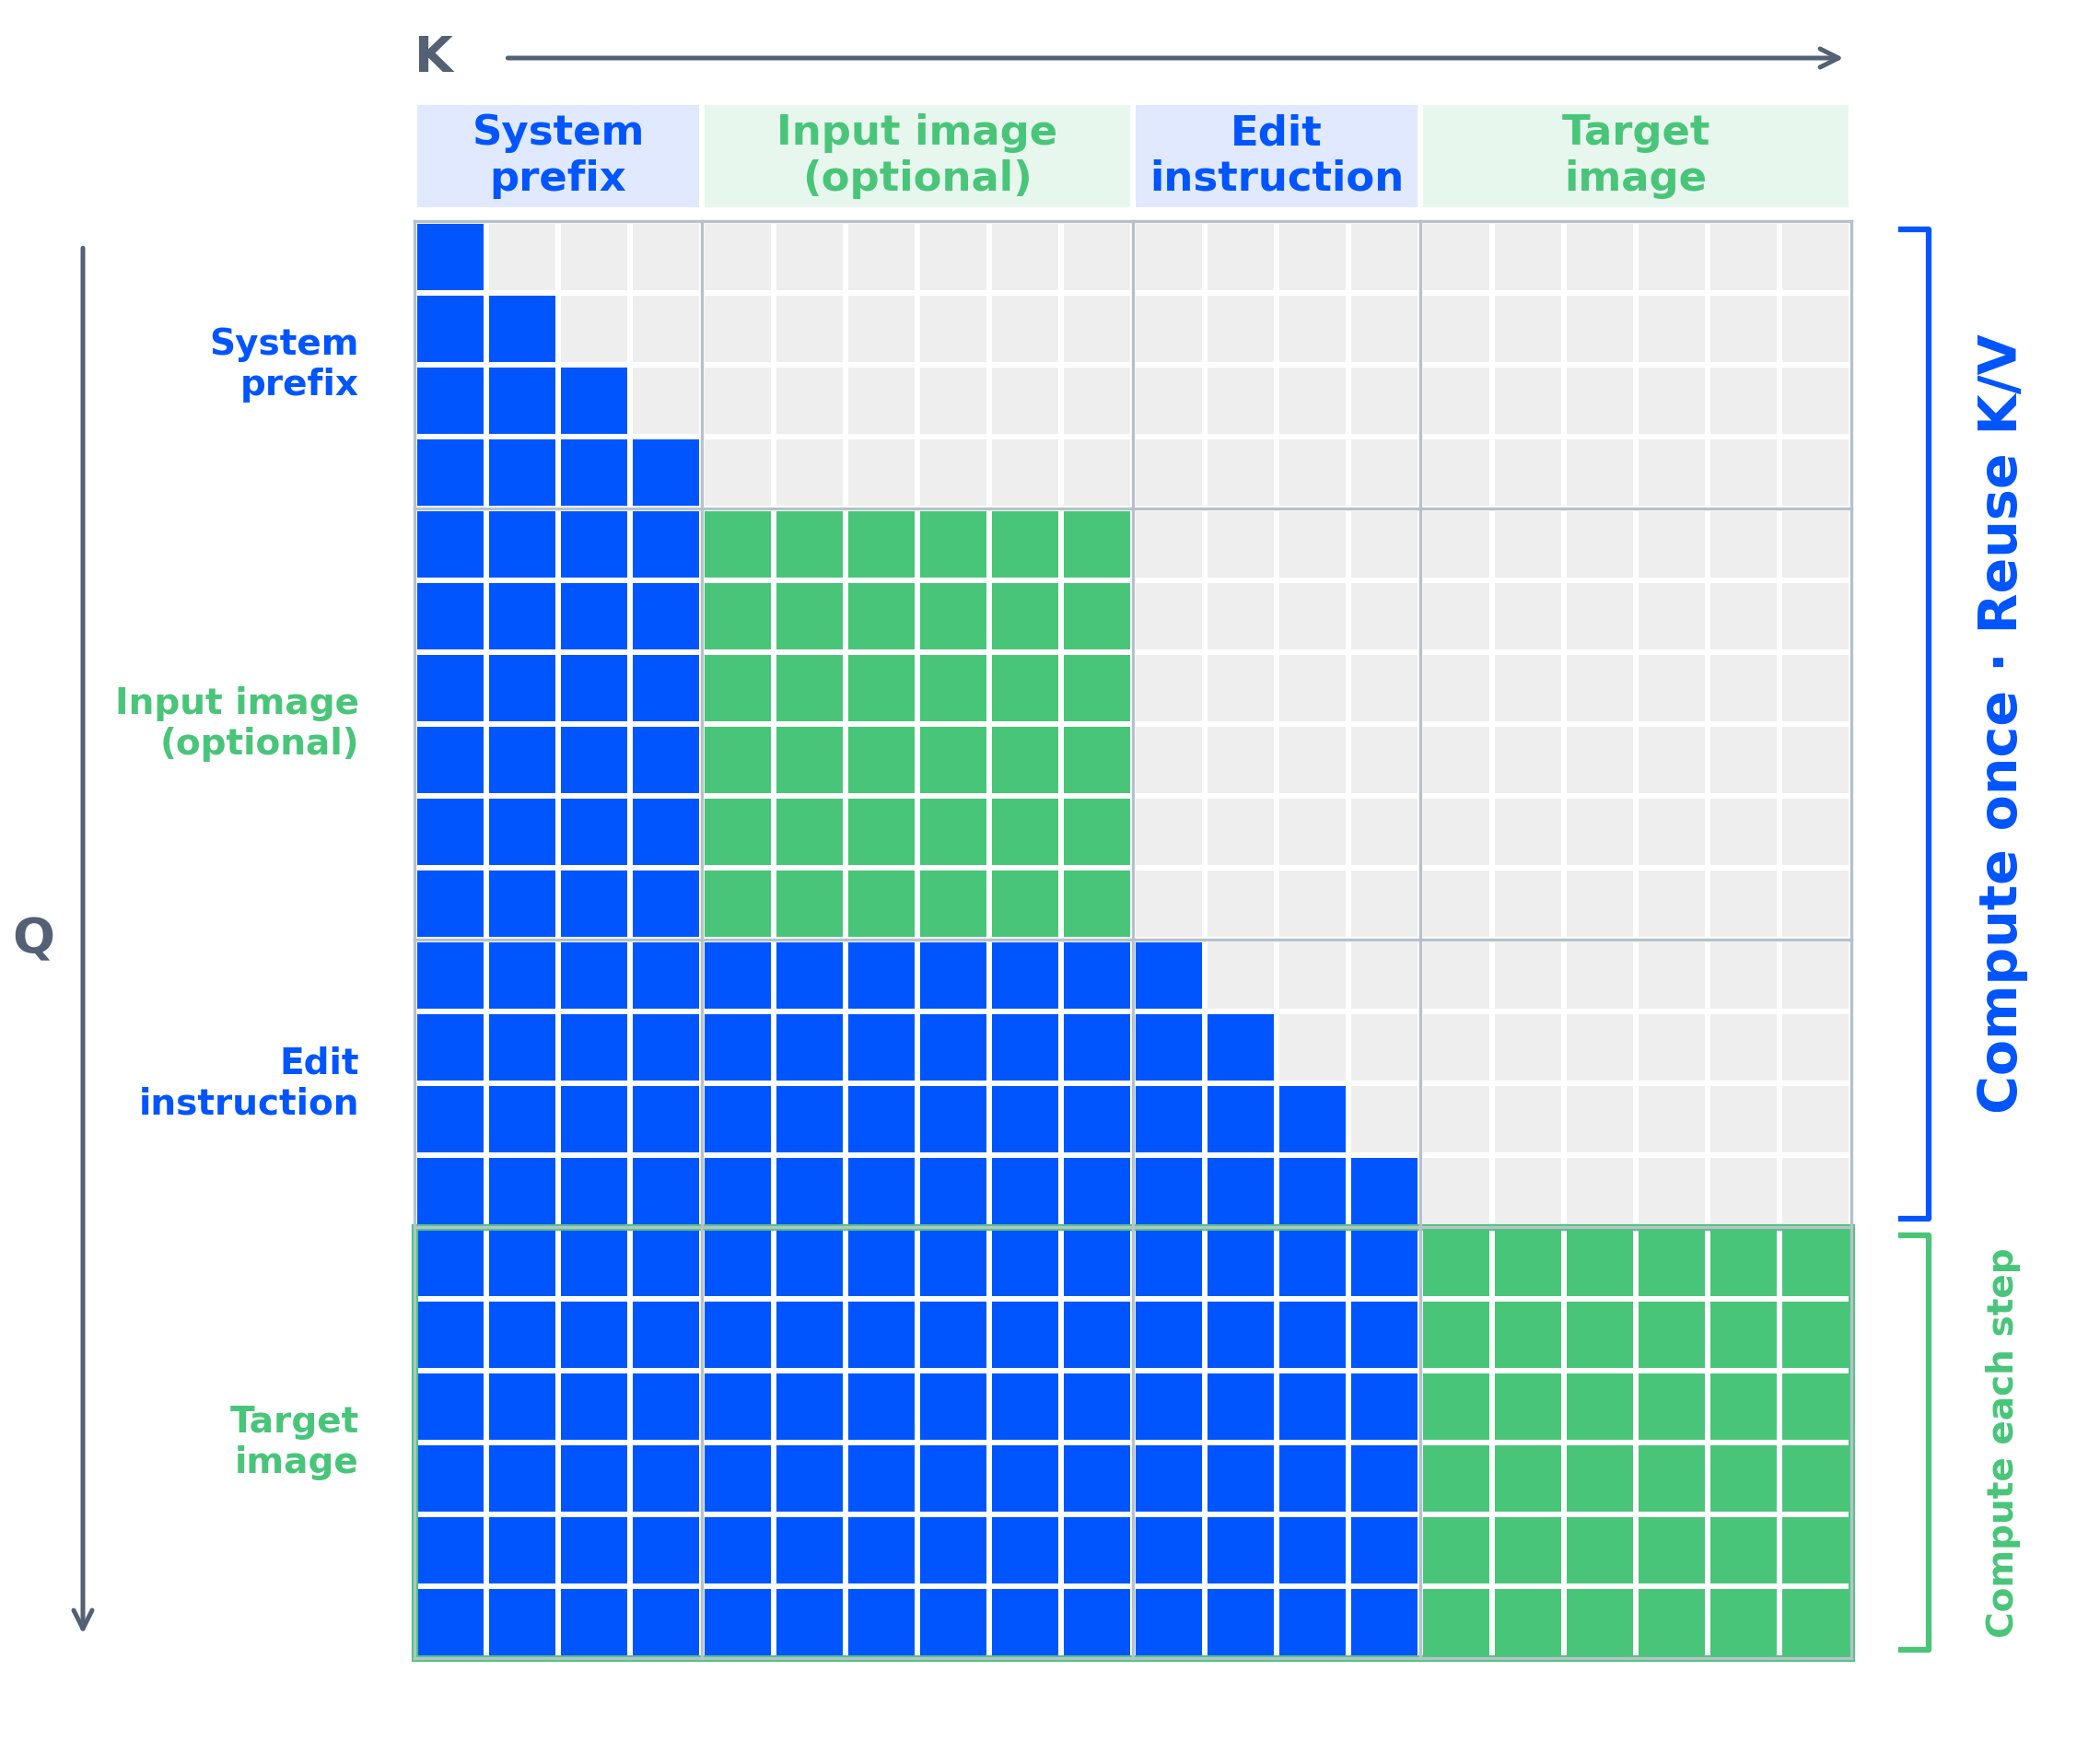
Der visuelle Generator besteht aus 32 Single-Stream DiT-Ebenen mit 7 Mrd. Parametern, gepaart mit dem 8B Qwen3-VL Encoder und einem VAE, der nativ einen Alpha-Kanal trägt. Die interessante Ingenieursleistung liegt in der Aufmerksamkeit. Qwen nennt es gemischte Granularität: Text-Token (das Systempräfix und Ihre Bearbeitungsanweisung) verwenden eine kausale Maske auf Token-Ebene, während die Bildgenerierung eine Maske auf Chunk-Ebene verwendet. Da Eingabebilder und die Anweisung über Denoising-Schritte hinweg statisch sind, berechnet das Modell ihren Key-Value-Cache einmal im ersten Schritt und verwendet ihn wieder. Qwens angegebener Vorteil ist eine geringere Latenz und Speichernutzung beim Bearbeiten mit mehreren Referenzbildern, was genau die Arbeitslast ist, die mit der Begrenzung auf 10 Bilder schwerer wurde.
Der Scheduler verwendet Flow Matching mit Euler-Diskretisierungsschritten, und der Referenzcode läuft standardmäßig mit 40 Schritten.
Native Transparenz im selben Modell
Das ist die Schlagzeile. Sie fragen in der Eingabeaufforderung nach einem transparenten Bild, und das Modell gibt RGBA zurück. Die empfohlene Formulierung aus der README ist wörtlich: Beginnen Sie mit „Dies ist ein RGBA-Bild mit Transparenz“ und geben Sie an, dass der Hintergrund transparent ist. Der Launch-Post zeigt einzelne Motive, Kompositionen mit mehreren Elementen und drei Bearbeitungsfälle bei transparenten Eingaben: Ändern des Ausdrucks eines Motivs unter Beibehaltung des Alpha-Kanals, Ersetzen von Text innerhalb einer transparenten Ebene und Extrahieren eines Motivs aus einem gewöhnlichen RGB-Foto als RGBA-Ausschnitt.
Für Produktteams ersetzt dies eine Zwei-Modell-Pipeline (generieren, dann freistellen) durch einen einzigen Aufruf. Es entfernt auch die Halo-Artefakte, die Hintergrundentferner um Haare und Glas hinterlassen, da der Alpha-Kanal generiert und nicht nachträglich abgeleitet wird. Ob die Kanten bei 2K auf Ihren eigenen Assets halten, ist etwas, das getestet werden sollte, anstatt es anzunehmen; der Free-Tier-Leitfaden zeigt, wo Sie diese Tests ohne GPU durchführen können.
Bearbeitung mit bis zu 10 Referenzen und echter Regionskontrolle
Drei Bearbeitungsfunktionen stechen in den Launch-Beispielen hervor:
- Mehrere Referenzen. Sechs Porträts werden zu einem Gruppenfoto; ein Modell, Kleidung, Schuhe, Tasche und Hut werden zu einem kompletten Outfit; zehn Möbelfotos werden zu einem eingerichteten Zimmer. Die Grenze liegt bei 10 Eingabebildern.
- Lokale Bearbeitung auf drei Arten. Zeichnen Sie farbige Kreise und sprechen Sie jeden im Prompt nach Farbe an („entferne die Uhr im blauen Kreis“), malen Sie über einen Bereich oder übergeben Sie das unberührte Original plus eine separate Maske als zwei Eingaben, sodass nichts in der Quelle verdeckt wird.
- Wiedergabetreue. Qwen sagt, dass Gesichtsidentität und Produkttext, Textur und Form Bearbeitungen besser überstehen als in 2.0. Der Beitrag zeigt Vorher-Nachher-Paare, aber keine Metrik, daher sollte dies als Behauptung betrachtet werden, die auf Ihren eigenen SKUs überprüft werden muss.
Derselbe Bearbeitungspfad verarbeitet Panoramen aus einem Selfie, Infografiken aus einem Produktfoto und Storyboards aus einem Charakterbogen mit drei Ansichten. Sequenzielle lokale Bearbeitungen können zu kurzen Animationen aneinandergereiht werden, was der Beitrag mit einem Capybara-Clip demonstriert.
Typografie und Porträtqualität
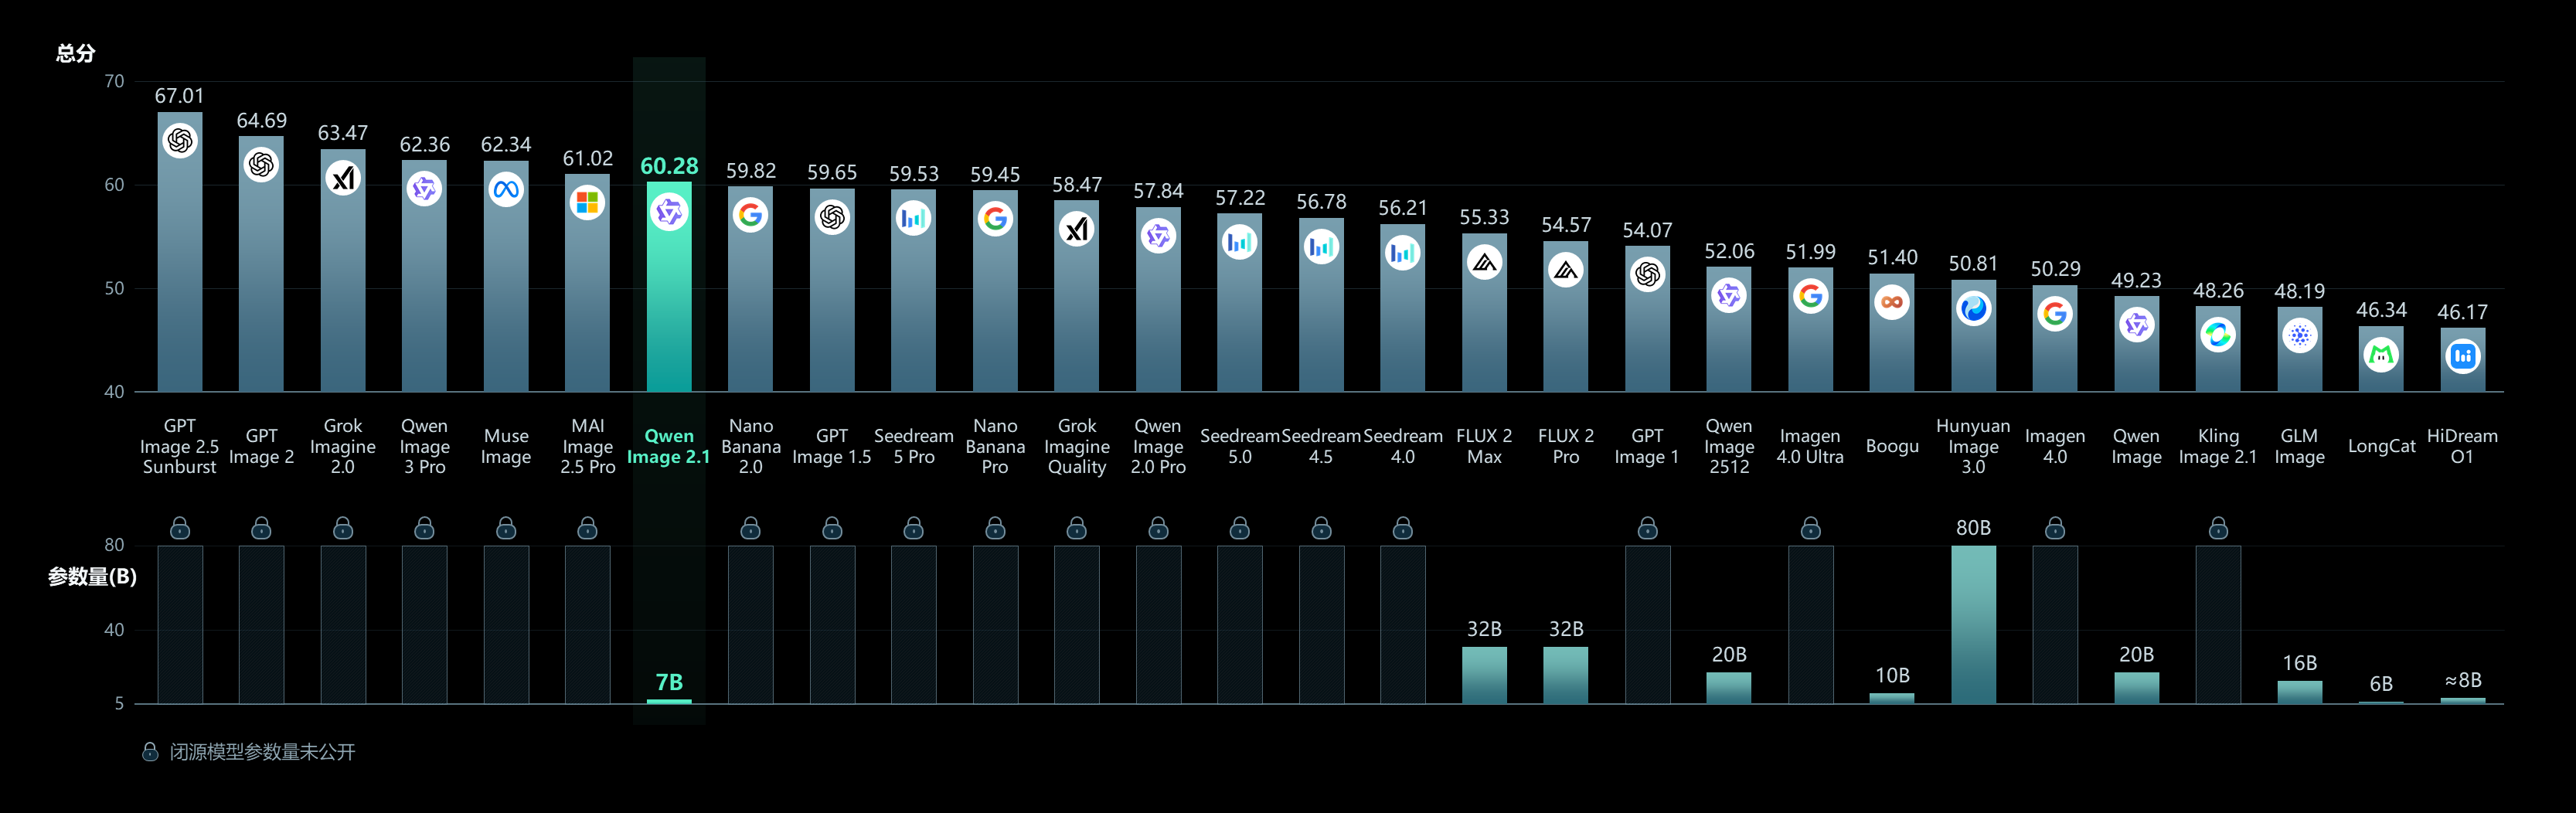
Qwen ist seit dem ersten Qwen-Image führend im Open-Text-Rendering, und 2.1 erweitert dies auf Schriftstil, Layout und die Positionierung von Text in der Komposition, anstatt nur die Rechtschreibung zu berücksichtigen. Porträtbeleuchtung und feine Details erhalten ebenfalls eine Überarbeitung. Der Launch-Post untermauert dies mit einem Qwen-Image-Bench-Diagramm im Vergleich zu offenen und geschlossenen Modellen; das Diagramm ist ein Bild und der Post enthält keine Zahlen, daher zitieren wir hier keine.
Die Lizenz: offene Gewichte, Forschungsbedingungen
Das ursprüngliche Qwen-Image war Apache 2.0. Qwen-Image-2.1 wird unter der Qwen Research License Agreement veröffentlicht, und der Lizenztext ist kurz und klar in dem Punkt, der wichtig ist:
- Sie dürfen das Modell nicht „für kommerzielle Zwecke verwenden, ohne eine separate kommerzielle Lizenz zu erhalten“, die per E-Mail von Qwen angefordert werden muss.
- Weitergabe und Derivate müssen die Lizenz, einen Hinweis „Built with Qwen“ oder „Improved using Qwen“ sowie die Urheberrechtszeile mit dem Namen Hangzhou Tongyi Laboratory enthalten.
- Sie dürfen „Qwen“ nicht als primären Namen eines Derivats verwenden.
- Die Vereinbarung unterliegt chinesischem Recht mit Gerichtsstand in Hangzhou.
Die Prompt-Rewriting-Begleiter werden unter denselben Bedingungen geliefert. Für ein Hobbyprojekt, eine Forschungsarbeit oder eine interne Evaluierung ist dies in Ordnung. Für eine SaaS-Funktion bedeutet dies zuerst ein Gespräch mit Alibaba oder die Nutzung der gehosteten 3.0 API, die mit üblichen kommerziellen Bedingungen und einem Preis pro Bild verbunden ist.
Die beiden Prompt-Rewriting-Modelle
Neben dem Generator veröffentlichte Qwen Qwen-Image-2.1-PE-T2I und Qwen-Image-2.1-PE-I2I. PE-T2I ist ein feinabgestimmtes Qwen3.5-VL 9B, das eine kurze Anfrage in beliebiger Sprache entgegennimmt und JSON mit einem detaillierten englischen Prompt und einem empfohlenen Seitenverhältnis zurückgibt. PE-I2I ist das Bearbeitungs-Gegenstück [VERIFIZIEREN]. Sie sind optional, und sie sind die Art und Weise, wie der Demo Space lange, strukturierte Prompts aus einzeiligen Eingaben erhält. Wenn Sie eine API um 2.1 herum aufbauen, ist dies der „Prompt-Verbesserungs“-Schritt, den Produkte wie ChatGPT Images unsichtbar ausführen.
Was beim Launch nicht gesagt wurde
- Keine VRAM-Angaben nach Auflösung. Die README verweist auf `enable_model_cpu_offload()`, vLLM-Omni mit FP8, SGLang und LightX2V für einen leichteren oder schnelleren Betrieb sowie AMD-Unterstützung, aber keine Tabelle.
- Keine veröffentlichten Benchmark-Zahlen, nur ein Diagramm.
- Keine gehostete API für 2.1 auf Model Studio zum Zeitpunkt des Starts [VERIFIZIEREN]; die gehostete Linie ist 3.0.
- Keine feste Angabe zur Inferenzgeschwindigkeit, nur „verbesserte Effizienz“ durch die Wiederverwendung des KV-Caches.
Es hinter einer API bereitstellen und testen
Die meisten Teams werden keine Diffuser-Pipeline aus Anwendungscode aufrufen. Sie werden es in einen HTTP-Dienst auf einer GPU-Box einpacken und diesen aufrufen. Sobald es ein Endpunkt ist, ist es eine API wie jede andere, und Apidog ist der Ort, an dem Sie sie entwerfen und testen: definieren Sie das Anfrageschema (Prompt, optionale Referenzbilder, Seitenverhältnis, ein Transparenz-Flag), senden Sie echte Aufrufe, stellen Sie sicher, dass die Antwort ein PNG mit einem Alpha-Kanal ist, und verwandeln Sie die erfolgreichen Fälle in eine Regressionstest-Suite, die Sie nach jedem Modell-Update erneut ausführen. Sie können den Endpunkt auch simulieren, damit das Frontend-Team gegen einen stabilen Vertrag entwickeln kann, während die GPU ausgelastet ist. Die Anleitung führt Schritt für Schritt durch diesen Wrapper und die Apidog-Tests.
Laden Sie Apidog herunter, um mitzumachen.
FAQ
Ist Qwen-Image-2.1 kommerziell frei nutzbar? Nein, nicht ohne eine separate kommerzielle Lizenz von Qwen. Die Gewichte können kostenlos für Forschungs- und nicht-kommerzielle Zwecke heruntergeladen und verwendet werden. Siehe den Lizenzabschnitt oben und den Free-Tier-Leitfaden für kostenlose Möglichkeiten, es auszuprobieren.
Wie unterscheidet sich 2.1 von Qwen-Image-2.0? Gleiche 7B-Größe und vereinheitlichtes Generierungs-plus-Bearbeitungsdesign. Neu in 2.1: native RGBA-Ausgabe und -Bearbeitung, bis zu 10 Referenzbilder, masken- und annotationsgesteuerte lokale Bearbeitungen, ein Aufmerksamkeits-Pfad mit gemischter Granularität und KV-Cache-Wiederverwendung für schnellere Bearbeitung mehrerer Bilder sowie verbesserte Typografie und Porträtdetails.
Ist es dasselbe wie Qwen Image 3.0? Nein. 3.0 und 3.0 Pro sind gehostete API-Modelle, die im Juli 2026 ohne offene Gewichte gestartet wurden; 2.1 ist das Modell mit offenen Gewichten. Der Vergleich deckt Preis- und Leistungsunterschiede ab.
Welche Hardware wird benötigt? Qwen hat keine VRAM-Anforderungen veröffentlicht. Der Referenzcode lädt die Pipeline in bfloat16 auf einem CUDA-Gerät und bietet CPU-Offload; Community-Serving-Stacks fügen FP8 hinzu. Erwarten Sie eine Rechenzentrums- oder High-End-Consumer-GPU für 2K-Ausgabe in 40 Schritten.
Kann es transparente Bilder bearbeiten, nicht nur generieren? Ja. Die Launch-Beispiele ändern den Ausdruck eines Motivs und ersetzen Text innerhalb einer transparenten Ebene, während der Alpha-Kanal beibehalten wird, und extrahieren ein RGBA-Motiv aus einem RGB-Foto.
Nächste Schritte
Qwen-Image-2.1 ist ein starkes offenes Bearbeitungsmodell mit einer Funktion, die sonst niemand in einem einzigen Checkpoint liefert, nativer Transparenz, und einer Einschränkung, die entscheidet, ob Sie es verwenden können, der Forschungslizenz. Führen Sie es lokal mit der Anleitung aus, probieren Sie es ohne GPU über die kostenlosen Optionen aus und vergleichen Sie die gehostete 3.0 API, bevor Sie sich festlegen. Egal, wofür Sie sich entscheiden, testen Sie den Endpunkt in Apidog, damit ein Modellwechsel Ihr Produkt niemals stillschweigend beschädigt.