
Alibaba hat Qwen 3.8-Max Anfang August 2026 offiziell veröffentlicht, und es kommt mit einer ungewöhnlichen Kombination: einem 2,4 Billionen Parameter starken Mixture-of-Experts-Modell, das pro Token nur 95 Milliarden Parameter aktiviert, einem pauschalen Preis von 2 $/6 $ pro Million Token über einen vollständigen 1M Kontext und dem Versprechen, dass die Gewichte innerhalb einer Woche auf Hugging Face und ModelScope öffentlich gemacht werden. Dieser letzte Teil ist wichtig. Noch nie zuvor wurde ein Qwen-Max-Klasse-Modell mit offenen Gewichten ausgeliefert.
Die offizielle Ankündigung bezeichnet es als das leistungsfähigste Qwen bis heute, und die Benchmark-Tabelle des Anbieters untermauert dies mit einigen wirklich starken Ergebnissen und ein paar ehrlichen Niederlagen. Dieser Leitfaden erklärt, was Qwen 3.8-Max tatsächlich ist, was die Zahlen aussagen, wo es im Vergleich zu Kimi K3, Fable 5 und GPT-5.6 Sol steht und welche Möglichkeiten Sie heute haben, es auszuführen. Wenn Sie über die API entwickeln möchten, wird das Modell sowohl mit OpenAI-kompatiblen als auch mit Anthropic-kompatiblen Endpunkten ausgeliefert, was einen protokollbewussten Client wie Apidog für das Testen beider Formen mit demselben Schlüssel nützlich macht.
Qwen 3.8-Max auf einen Blick
| Spezifikation | Qwen 3.8-Max |
|---|---|
| Entwickler | Alibaba (Qwen Team) |
| Veröffentlichung | Anfang August 2026 (GA in Model Studio, 3. August) |
| Architektur | MoE, basierend auf der Qwen 3.5-Grundlage |
| Gesamtparameter | 2.4T |
| Aktive Parameter | 95B (~4% Aktivierung) |
| Kontextfenster | 1.000.000 Token |
| Maximale Ausgabe | 65.536 Token |
| Modalitäten | Text- + Bildeingabe, Textausgabe |
| Reasoning-Kontrollen | reasoning_effort: xhigh (Standard), medium, low |
| API Modell-ID | qwen3.8-max |
| Preise | 2 $ Eingabe / 6 $ Ausgabe pro 1M Token, pauschal über den gesamten Kontext |
| Offene Gewichte | Für nächste Woche versprochen (~10. August); derzeit (Anfang August 2026) noch nicht herunterladbar |
| API-Protokolle | OpenAI-kompatibel und Anthropic-kompatibel |
Alles in dieser Tabelle stammt aus Alibabas eigenen Veröffentlichungsmaterialien und der Model Studio Preisseite. Nun zu den Details.
Was Qwen 3.8-Max ist
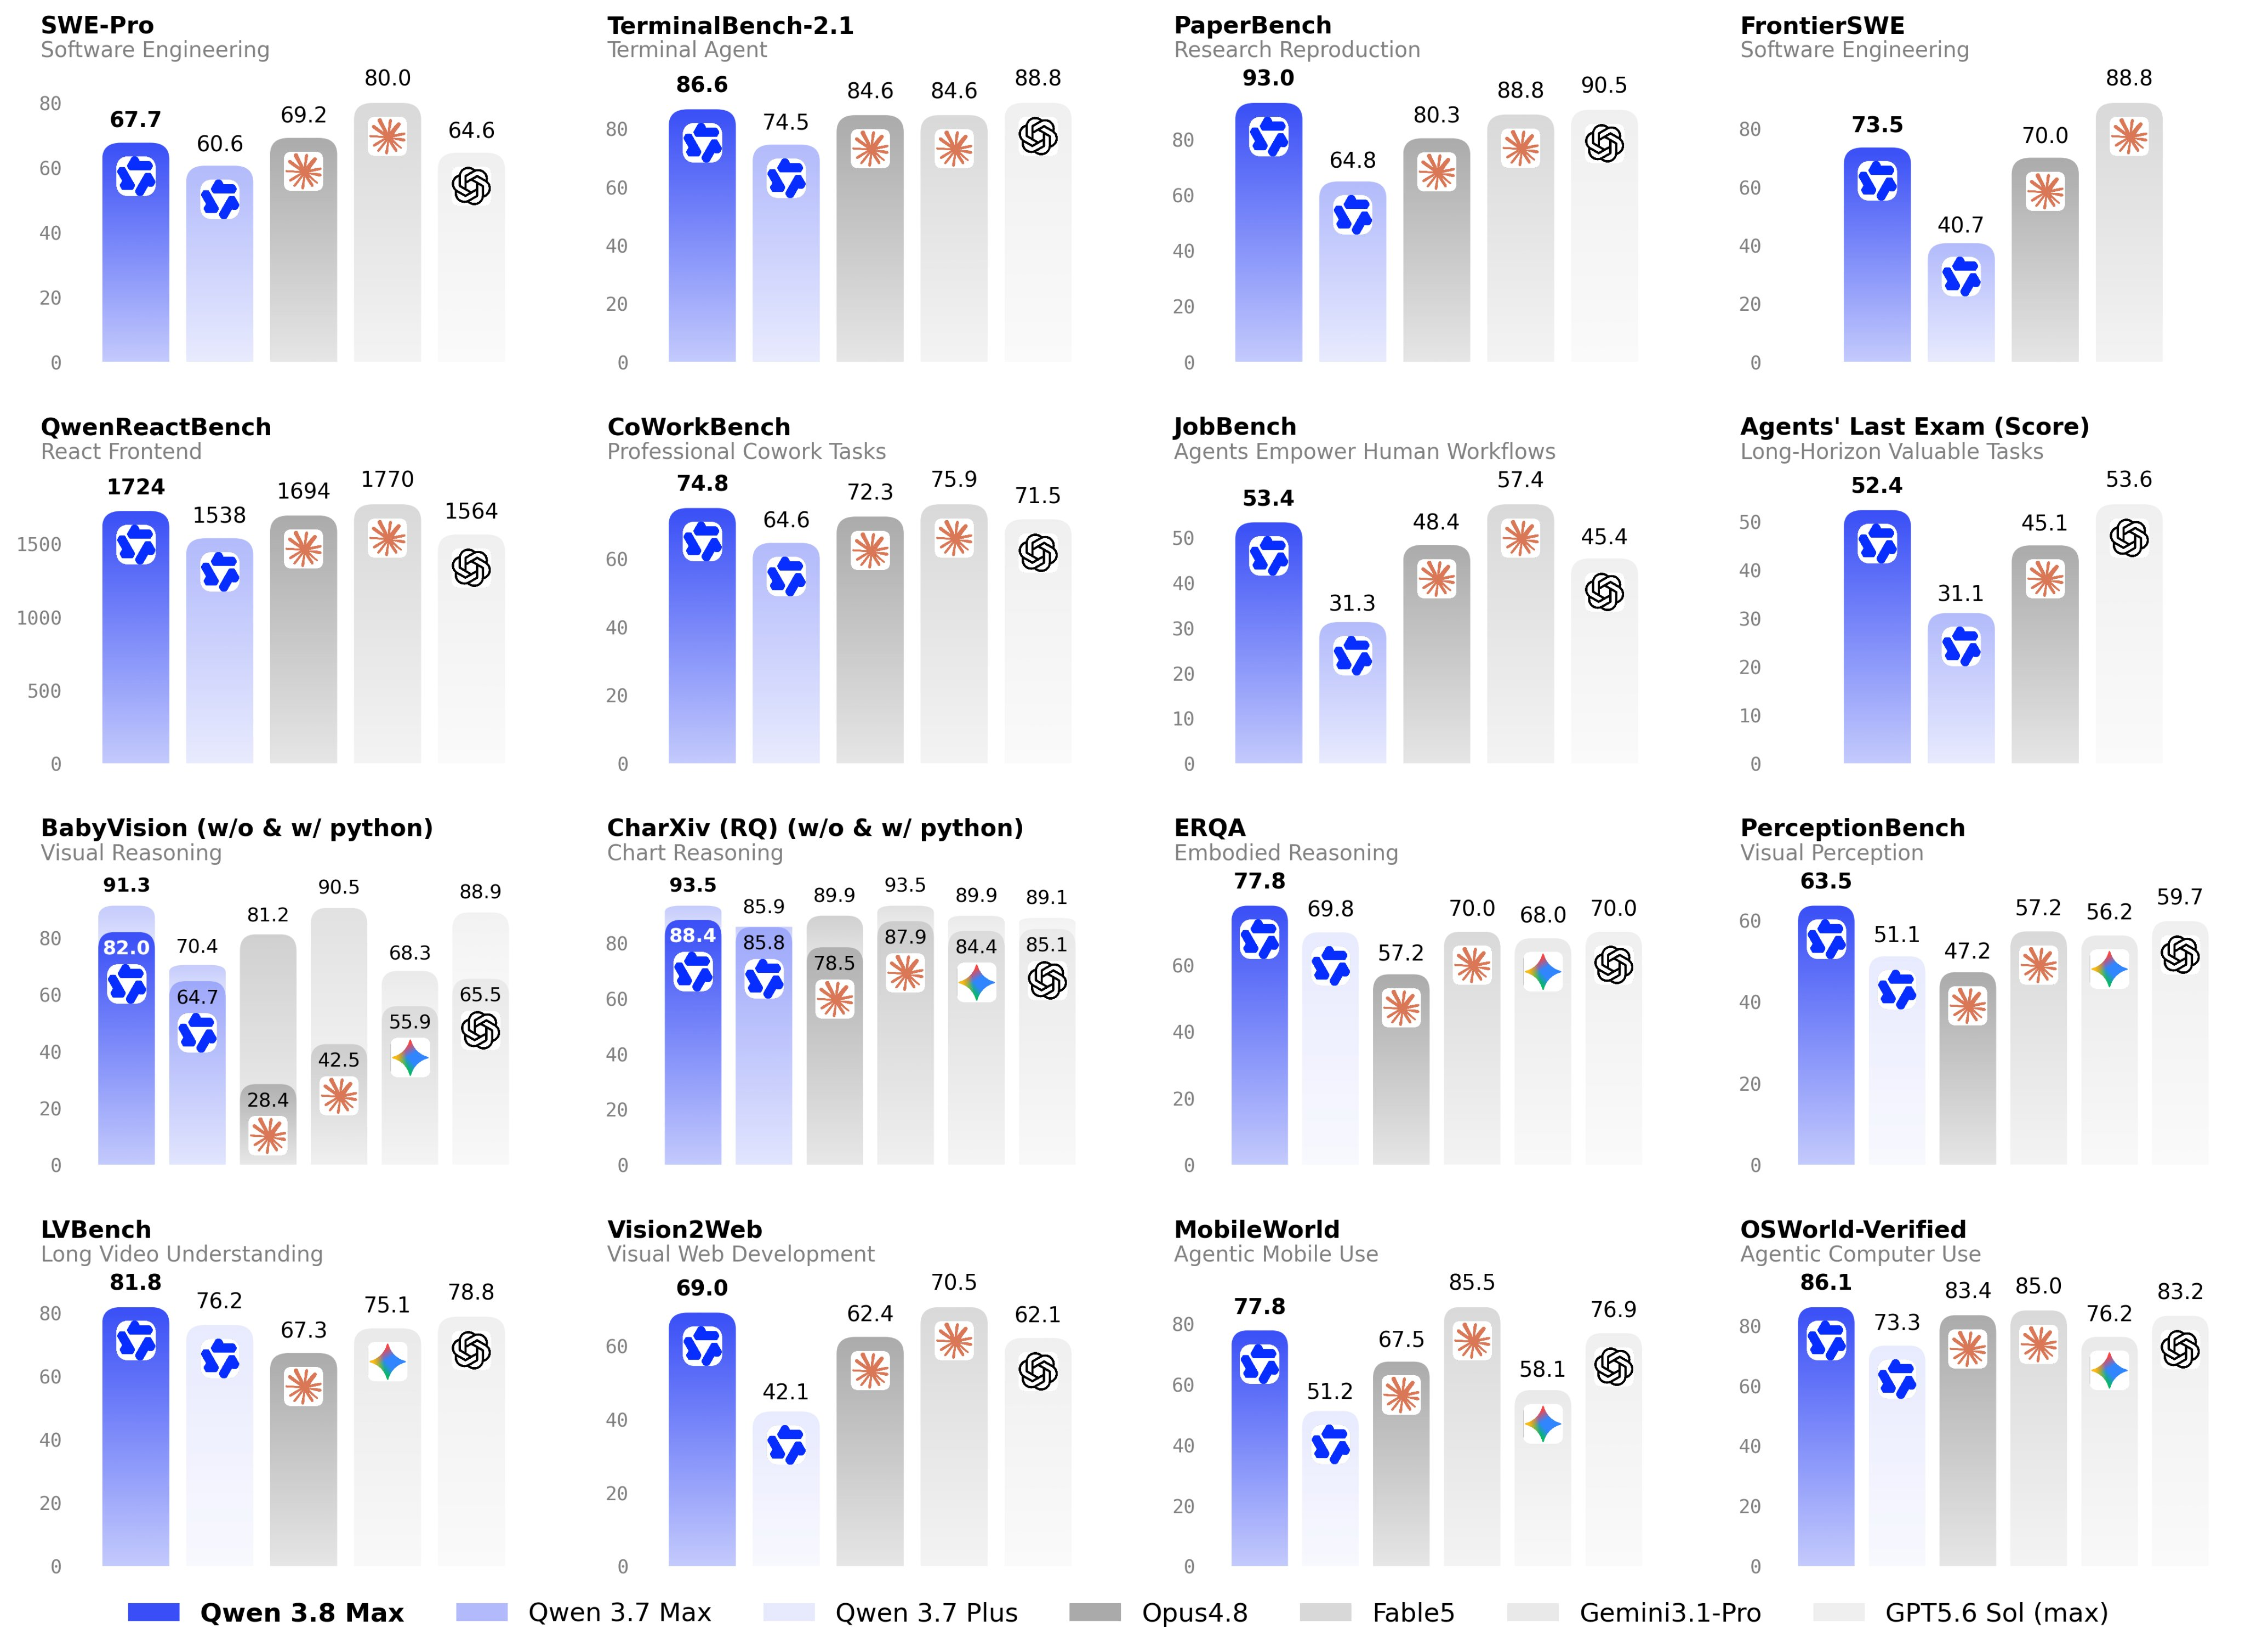
Qwen 3.8-Max ist das neue Flaggschiff der Qwen-Familie von Alibaba, das auf der Qwen 3.5 Architektur aufbaut. Es ersetzt Qwen3.7-Max an der Spitze der Produktlinie, und die Herstellertabelle zeigt deutliche Sprünge gegenüber seinem Vorgänger: Terminal Bench 2.1 steigt von 74,5 auf 86,6 und PaperBench von 64,8 auf 93,0. Wenn Sie sich entscheiden, ob Sie vom älteren Modell umsteigen sollen, sind die Unterschiede in unserem Vergleich von Qwen 3.8 vs. Qwen 3.7 Max aufgeführt.
Die Schlagzeilen-Spezifikation ist die Parameteraufteilung. 2,4 Billionen Gesamtparameter klingen enorm, und das sind sie auch, aber das MoE-Design aktiviert nur 95 Milliarden pro Forward Pass. Dieses Aktivierungsverhältnis von etwa 4 % ist der Grund, warum Alibaba ein so großes Modell für 2 $/6 $ pro Million Token anbieten kann. Zum Vergleich: Kimi K3 läuft mit insgesamt 2,8 Billionen und 104 Milliarden aktiven Parametern, sodass Qwen 3.8-Max in beiden Punkten das kleinere Modell ist.
Auf der Eingabeseite akzeptiert das Modell Text und Bilder über die API. Alibabas Blog demonstriert auch das Verständnis langer Dokumente (200+ Seiten PDFs) und die 100-stündige Videokompetenz über sogenannte Speicherdiagramme (Memory Graphs). Betrachten Sie diese eher als im Blog demonstrierte Fähigkeiten denn als separate API-Eingabetypen; die veröffentlichten API-Konfigurationen listen Text und Bild als Eingabemodalitäten auf.
Die Schlussfolgerung wird über den Parameter reasoning_effort mit drei Stufen gesteuert: xhigh (Standard), medium und low. Es gibt auch enable_thinking und preserve_thinking, wobei das Denken standardmäßig erhalten bleibt. Ein wichtiges Preisdetail, das Sie frühzeitig wissen sollten: Denk- und Nicht-Denk-Modi werden zum gleichen Preis abgerechnet, aber Denk-Token zählen als Ausgabe, sodass die tatsächlichen Kosten bei der Standardeinstellung xhigh höher ausfallen als eine naive Berechnung des Listenpreises.
Das erste offene Gewichts-Qwen der Max-Klasse
Dies ist der größte strategische Schachzug der Veröffentlichung. Alibaba hat im Laufe der Jahre zahlreiche Qwen-Modelle quelloffen gemacht, aber nie die Max-Stufe. Qwen 3.8-Max durchbricht dieses Muster: Das Unternehmen sagt, dass die Gewichte „nächste Woche“, also etwa am 10. August, auf Hugging Face und ModelScope landen werden.
Zwei Einschränkungen, die klar genannt werden:
- Die Gewichte sind noch nicht herunterladbar. Anfang August 2026 ist das Versprechen noch ein Versprechen. Kimi K3 hat hier einen aktuellen Präzedenzfall geschaffen: Seine Gewichte trafen 11 Tage nach dem Start ein, sodass eine kurze Verzögerung nicht überraschend wäre.
- Das Selbst-Hosten eines 2.4T-Modells ist ein Multi-Node-Projekt. Selbst stark quantisiert ist dies nichts, was Sie auf einer Workstation ausführen können. Für die meisten Teams wird „offene Gewichte“ einen günstigeren gehosteten Zugang über Drittanbieter bedeuten, anstatt einer lokalen Bereitstellung.
Wenn Ihr Interesse an Qwen 3.8-Max hauptsächlich darin besteht, den Listenpreis nicht zu zahlen, sind die derzeit realistischen Wege Qwen Chat und das kostenlose Kontingent von Model Studio, die beide in unserem Leitfaden zum kostenlosen Nutzung von Qwen 3.8 behandelt werden.
Was die Benchmarks zeigen, einschließlich der Verluste
Alibaba veröffentlichte eine vollständige Benchmark-Tabelle, die Qwen 3.8-Max mit Claude Opus 4.8, Fable 5, GPT-5.6 Sol und Qwen3.7-Max vergleicht. Zwei Offenlegungen vor den Zahlen: Dies sind vom Anbieter durchgeführte Ergebnisse, und die meisten der Kodierungszeilen wurden für alle Modelle mit dem Claude Code Harness ausgeführt. Mehrere Benchmarks (QwenSWEBench, QwenQoderBench, CoWorkBench, RecreationBench) sind Alibabas eigene interne Entwicklungen. Zum Zeitpunkt der Erstellung dieses Artikels gab es keine unabhängigen Zahlen von Quellen wie Artificial Analysis.
Mit dieser Einordnung sind die herausragenden Zeilen laut Alibabas Tabelle:
Wo es gewinnt:
- PaperBench: 93.0, das beste einzelne Flaggschiff-Ergebnis, vor GPT-5.6 Sol (90.5), Fable 5 (88.8) und Opus 4.8 (80.3)
- IFBench: 82.8, die höchste Punktzahl in der Zeile, vor Sols 72.7
- Terminal Bench 2.1: 86.6, schlägt Opus 4.8 und Fable 5 (beide 84.6), nur von Sol (88.8) übertroffen
- Multimodalität ist seine größte Stärke: MathVision 95.2, LogicVista 91.9, OSWorld-Verified 86.1 und OCR-Zeilen, die fast alles in der Tabelle anführen
Wo es verliert:
- SWE-bench Pro: 67.7, deutlich hinter Fable 5s 80.0 und leicht hinter Opus 4.8s 69.2 (es schlägt jedoch Sols 64.6)
- HLE: 43.6, die schwächste Flaggschiff-Punktzahl in der Zeile; Fable 5 erreicht 53.3, Sol 47.2 und Opus 4.8 45.7
Das ehrliche Fazit: Laut Alibabas eigenen Zahlen schlägt Qwen 3.8-Max Opus 4.8 in mehreren agentischen Zeilen, liegt bei den meisten Kern-Kodierungsarbeiten hinter Fable 5 und gewinnt bei multimodalen und Dokumentenintelligenzen deutlich. Bei GPQA Diamond liegt es bei 92.6, gleichauf mit Fable 5 und knapp hinter Sols 94.1, sodass die reine wissenschaftliche Argumentation wettbewerbsfähig ist. Eine vollständige Erläuterung der Tabelle, einschließlich des Kleingedruckten zu den Harnesses und worauf bei unabhängigen Überprüfungen zu achten ist, finden Sie in unserer Qwen 3.8 Benchmarks Analyse.
Alibaba veröffentlichte auch eine Reihe von Showcase-Läufen: eine 16-tägige autonome Kodierungssitzung in einem öffentlichen Repository (265 Commits, 127 Pull Requests), ein Papier-Reproduktionslauf, der das AIME24-Ergebnis des Originalpapiers übertraf, und eine Tianchi-Wettbewerbsteilnahme, die 458 von 526 menschlichen Teams in 24 Stunden übertraf. Dies sind die eigenen Demos des Anbieters, daher sind sie eher als Fähigkeitsanzeigen denn als kontrollierte Bewertungen zu verstehen. Die Kodierungsgeschichte, einschließlich der Reproduktion der Harness-Setups, wird in Qwen 3.8 für Kodierung ausführlich behandelt.
Wo es im Vergleich zu Kimi K3, Fable 5 und GPT-5.6 Sol steht
Vs Kimi K3. Dies ist die natürliche Rivalität: zwei chinesische Labore, zwei offene Gewichts-MoE-Modelle, die Wochen auseinander veröffentlicht wurden. K3 ist größer (insgesamt 2.8T, 104B aktiv vs. 2.4T/95B), reiner Text, wo Qwen multimodal ist, und seine Gewichte sind bereits live, während Qwens noch ein Versprechen sind. Auch die Preisgestaltung weicht stark ab: K3 berechnet 3 $ Eingabe/15 $ Ausgabe mit 0,30 $ Cache-Hits, gegenüber Qwens pauschal 2 $/6 $. Eine direkte Gegenüberstellung existiert noch nicht; jeder Anbieter veröffentlichte seine eigene Tabelle. Wir vergleichen sie Zeile für Zeile in Qwen 3.8 vs. Kimi K3, und wenn Sie neu bei Moonshots Modell sind, beginnen Sie mit was Kimi K3 ist.
Vs Fable 5. Anthropic's Flaggschiff bleibt der zu schlagende Kodierungs-Benchmark, und Qwen 3.8-Max schlägt ihn nicht: SWE-bench Pro (67.7 vs. 80.0) und HLE (43.6 vs. 53.3) sind laut Alibabas eigener Tabelle klare Lücken. Was Qwen stattdessen bietet, ist der Preis (ein Bruchteil der Spitzentarife), ein 1M-Kontext, offene Gewichte in Kürze und stärkere multimodale Zeilen.
Vs GPT-5.6 Sol. Sol gewinnt Terminal Bench (88.8 vs. 86.6), GPQA (94.1 vs. 92.6) und HLE (47.2 vs. 43.6), während Qwen 3.8-Max PaperBench (93.0 vs. 90.5) und IFBench (82.8 vs. 72.7) gewinnt. Preislich unterbietet Qwens 2 $/6 $ GPT-5.6 Terras 2 $/12 $ bei der Ausgabe, und der Zugriff auf Sol-Ebene kostet noch mehr.
Ein weiterer Anker: Claude Opus 5 kostet 5 $/25 $. Was auch immer Sie von Anbietertabellen halten, Alibaba preist sein Flaggschiff auf einem Niveau ein, das die Rechnung für Hochvolumen-Workloads verändert.
Preise: 2 $/6 $, pauschal über 1M Token
Die Preisgestaltung ist einfach genug, um sie in einem Satz zu formulieren: 2 $ pro Million Eingabe-Token, 6 $ pro Million Ausgabe-Token, eine pauschale Stufe von Token Null bis zur 1M Kontextgrenze, Denkmodus oder nicht.
Die Pauschalstufe ist das Ungewöhnliche. Die meisten Langkontextmodelle erhöhen die Preise, wenn Ihr Prompt länger wird; Qwen 3.8-Max tut dies nicht. Es startet auch günstiger als der Listenpreis von Qwen3.7-Max von 2,5 $/7,5 $, obwohl dieses ältere Modell derzeit eine 50%-Aktion ($1,25/$3,75) hat, was es als Wertanlage relevant hält.
Das Kontext-Caching versüßt wiederholte Präfix-Workloads: Cache-Hits werden zu 10 % des Eingabepreises abgerechnet, und die explizite Cache-Erstellung kostet 125 %. Es gibt auch ein kostenloses Kontingent (1M Token, nur in der Region Singapur, 90 Tage gültig) zum Ausprobieren. Die vollständige Kostenaufschlüsselung, mit durchgerechneten Aufgabenbeispielen und der quantifizierten Tücke der Denk-Token, finden Sie in unserem Qwen 3.8 Preisleitfaden.
So greifen Sie auf Qwen 3.8-Max zu
Die Zugriffsmatrix ist breiter als bei einem typischen Launch. Fünf Routen:
1. Qwen Chat. Die Verbraucher-App, kein API-Schlüssel erforderlich. Der schnellste Weg, sich eine Meinung zu bilden.
2. Die API im Alibaba Cloud Model Studio (DashScope). Besorgen Sie sich einen Schlüssel von home.qwencloud.com, setzen Sie DASHSCOPE_API_KEY und rufen Sie die Modell-ID qwen3.8-max über OpenAI-kompatible Chat-Completions- oder Response-Endpunkte auf. Drei regionale Basis-URLs sind live: Peking (dashscope.aliyuncs.com/compatible-mode/v1), Singapur (dashscope-intl.aliyuncs.com/compatible-mode/v1) und US-Virginia (dashscope-us.aliyuncs.com/compatible-mode/v1). Die Model Studio Modelle Seite listet es an der Spitze des empfohlenen Stacks auf.
3. Der Anthropic-kompatible Endpunkt. Dies ist der wirklich ungewöhnliche: https://dashscope-intl.aliyuncs.com/apps/anthropic spricht das Anthropic Messages Protokoll, sodass für Claude entwickelte Tools mit zwei Umgebungsvariablen auf Qwen zeigen können.
4. Kodierungs-Harnesses. Alibaba veröffentlichte offizielle Konfigurationen für fünf Agenten: Claude Code (über ANTHROPIC_BASE_URL plus ANTHROPIC_MODEL=qwen3.8-max), Codex, Qoder, Qwen Code und OpenClaw. Es ist erwähnenswert, dass Alibaba die meisten seiner Kodierungs-Benchmarks innerhalb des Claude Code Harness ausführte, sodass die veröffentlichte Konfiguration auch die Konfiguration hinter seinen eigenen Zahlen ist.
5. Offene Gewichte, bald. Hugging Face und ModelScope, für nächste Woche versprochen, zum Zeitpunkt der Erstellung Anfang August 2026 noch nicht herunterladbar.
Details zur Einrichtung für die Routen 2 bis 4, mit Python- und cURL-Code zum Kopieren, finden Sie in unserem Qwen 3.8 API-Leitfaden.
Testen der Dual-Protokoll-API
Dasselbe Modell, das über zwei verschiedene Protokollformen antwortet, wirft eine praktische Testfrage auf: Verhält sich Ihre Anfrage auf beiden identisch? Hier verdient ein API-Client seinen Lebensunterhalt. In Apidog können Sie die drei regionalen Basis-URLs als Umgebungen speichern und Regionen wechseln, ohne Anfragen bearbeiten zu müssen, denselben Prompt parallel über den OpenAI-kompatiblen Endpunkt und den Anthropic-Protokoll-Endpunkt senden und den SSE-Stream überprüfen, um reasoning_content-Deltas zu beobachten, bevor die endgültige Antwort eintrifft. Dieser letzte Teil ist nützlich, um zu überprüfen, wie viel Denken die Standardeinstellung xhigh tatsächlich erzeugt, da diese Token Ihre Rechnung als Ausgabe belasten. Laden Sie Apidog herunter, wenn Sie mitmachen möchten, wenn Sie die Endpunkte verbinden; derselbe Arbeitsbereich macht es auch einfach, qwen3.8-max gegen qwen3.7-max oder kimi-k3 mit identischen Prompts A/B zu testen, bevor Sie einen Workload festlegen.
Wo Qwen 3.8-Max in der Produktreihe steht
Wenn Sie die breitere Familie betrachten, liegt Qwen 3.8-Max nun über Qwen3.7-Max und den Plus-Modellen, und unser Leitfaden zu den besten Qwen-Modellen behandelt, welche Stufe für welche Workload geeignet ist. Kurz gesagt: 3.8-Max ist die Wahl, wenn Sie die multimodale und agentische Obergrenze benötigen, 3.7-Max mit 50 % Rabatt ist das preiswerte Flaggschiff, solange die Aktion läuft, und die Plus-Modelle bleiben die günstigen Arbeitspferde für Routineaufgaben.
FAQ
Ist Qwen 3.8 Open Source?
Noch nicht, aber es ist nah dran. Alibaba versprach die Gewichte für Hugging Face und ModelScope "nächste Woche" ab der Veröffentlichung Anfang August 2026, was es zum ersten Open-Weight-Qwen der Max-Klasse machen würde. Zum Zeitpunkt des Schreibens ist noch nichts herunterladbar. Bis dahin erfolgt der Zugriff über die API oder Qwen Chat; siehe wie man Qwen 3.8 kostenlos nutzt für die kostenlosen Routen.
Wie viel kostet Qwen 3.8-Max?
2 $ pro Million Eingabe-Token und 6 $ pro Million Ausgabe-Token, auf einer einzigen Pauschalstufe über den gesamten 1M-Kontext. Cache-Hits werden mit 10 % des Eingabepreises abgerechnet. Denk-Token werden als Ausgabe abgerechnet, und der Standard-Reasoning-Aufwand ist xhigh, daher sollten Sie für reasoning-intensive Arbeiten über dem Listenpreis kalkulieren.
Ist Qwen 3.8-Max besser als Kimi K3?
Es gibt noch keine direkte Gegenüberstellung; beide Anbieter veröffentlichten ihre eigenen Tabellen. Auf dem Papier ist Qwen 3.8-Max kleiner (2.4T/95B aktiv vs. 2.8T/104B), multimodal, wo K3 nur Text ist, und günstiger bei der Ausgabe (6 $ vs. 15 $). K3s Vorteil ist heute, dass seine Gewichte bereits öffentlich sind.
Kann ich Qwen 3.8-Max in Claude Code verwenden?
Ja. Alibaba veröffentlichte eine offizielle Konfiguration: Weisen Sie ANTHROPIC_BASE_URL auf den Anthropic-kompatiblen DashScope-Endpunkt und setzen Sie ANTHROPIC_MODEL=qwen3.8-max. Codex, Qoder, Qwen Code und OpenClaw haben ebenfalls offizielle Konfigurationen.
Was als Nächstes zu tun ist
Qwen 3.8-Max ist eine echte Flaggschiff-Veröffentlichung, keine Pressevorschau: GA in drei API-Regionen, veröffentlichte Preise, eine vollständige (vom Anbieter durchgeführte) Benchmark-Tabelle mit Siegen und Niederlagen, und offene Gewichte stehen kurz bevor. Die ehrliche Lesart ist, dass es Fable 5 bei der Kernprogrammierung nicht entthront, aber es schlägt Opus 4.8 in mehreren agentischen Zeilen, führt bei Dokumenten- und multimodaler Arbeit und kostet dabei 2 $/6 $.
Der vernünftige Schritt ist, es gegen Ihre eigene Arbeitslast zu testen, anstatt sich auf die Tabelle eines anderen zu verlassen. Holen Sie sich das kostenlose Kontingent, verbinden Sie beide Protokollendpunkte und vergleichen Sie die Ausgaben bei Prompts, die Sie tatsächlich verwenden. Beginnen Sie mit dem API-Einrichtungsleitfaden und schauen Sie um den 10. August herum noch einmal nach, ob die Gewichte pünktlich eingetroffen sind.