
Open Responses ist eine offene Spezifikation, veröffentlicht als OpenAPI-3.1-Dokument, die eine Request- und Response-Form für den Aufruf von Sprachmodellen über verschiedene Anbieter hinweg beschreibt. Sie basiert auf der OpenAI Responses API: Du sendest model, input und optional tools an POST /v1/responses und erhältst typisierte Items und semantische Streaming-Events statt eines anbieterspezifischen Formats. OpenAI hat Open Responses am 15.01.2026 veröffentlicht, es steht unter der Apache-2.0-Lizenz, und am 22.10.2026 hat OpenAI es an die Agentic AI Foundation (AAIF) übergeben, die Linux-Foundation-Organisation, die auch MCP hostet.
Dieser letzte Schritt ist die Neuigkeit: Die Spezifikation hat jetzt eine technische Charta, ein Steering Committee und ein neutrales Zuhause. Dieser Beitrag behandelt, was sie definiert, wer sie implementiert, was der AAIF-Schritt ändert und wie du prüfst, ob ein Endpunkt, von dem du abhängst, konform ist. Wenn du mit der zugrunde liegenden API noch nicht vertraut bist, beginne mit how to use the OpenAI Responses API.
Was Open Responses definiert
Die Spezifikation beschreibt das Problem unverblümt: Anbieter sind auf dieselben Bausteine konvergiert (Nachrichten, Tool-Aufrufe, Streaming, multimodale Eingaben), aber jeder kodiert sie anders. Open Responses wählt eine Kodierung und schreibt sie auf.
Das aktuelle OpenAPI-Dokument hat die Version 2026-04-24 und deckt eine kleine Oberfläche ab:
| Operation | Was sie tut |
|---|---|
POST /responses (createResponse) |
Eine Antwort erstellen, mit oder ohne Streaming |
WebSocket auf /responses |
Dasselbe Antwortmodell über einen persistenten Socket (hinzugefügt am 24.04.2026) |
POST /responses/compact (compactResponse) |
Ein kompaktiertes Eingabefenster für lange Gespräche zurückgeben |
Der Request-Body akzeptiert die Felder, die du erwartest, wenn du die API von OpenAI verwendet hast: model, input, instructions, tools, tool_choice, stream, store, previous_response_id, reasoning, text, truncation, temperature, top_p, max_output_tokens, prompt_cache_key und ein paar weitere. Das Antwortobjekt (ResponseResource) enthält id, status, output, usage, error und ein Echo der von dir gesendeten Einstellungen. Das Dokument definiert insgesamt 108 Schemata, die meisten davon Item- und Streaming-Event-Typen.
Drei Ideen tragen das Design.
Items sind die Einheit des Kontexts
Alles, was das Modell liest oder erzeugt, ist ein Item: eine message, ein function_call, ein function_call_output, ein reasoning-Item. Items sind bidirektional, sodass die Ausgabe eines Turns direkt als Eingabe an den nächsten zurückgegeben werden kann. Jeder Item-Typ wird durch sein type-Feld unterschieden und hat sein eigenes Schema.
Items sind außerdem Zustandsmaschinen: Jedes bewegt sich von in_progress zu completed oder incomplete (das Token-Budget ist aufgebraucht), und ein incomplete-Item muss das letzte ausgegebene sein, wobei die gesamte Antwort als incomplete markiert wird. Ein Status sagt nichts darüber aus, ob der Server das Item gespeichert hat; Persistenz ist ein separates Anliegen.
Streaming sind semantische Events, keine Roh-Deltas
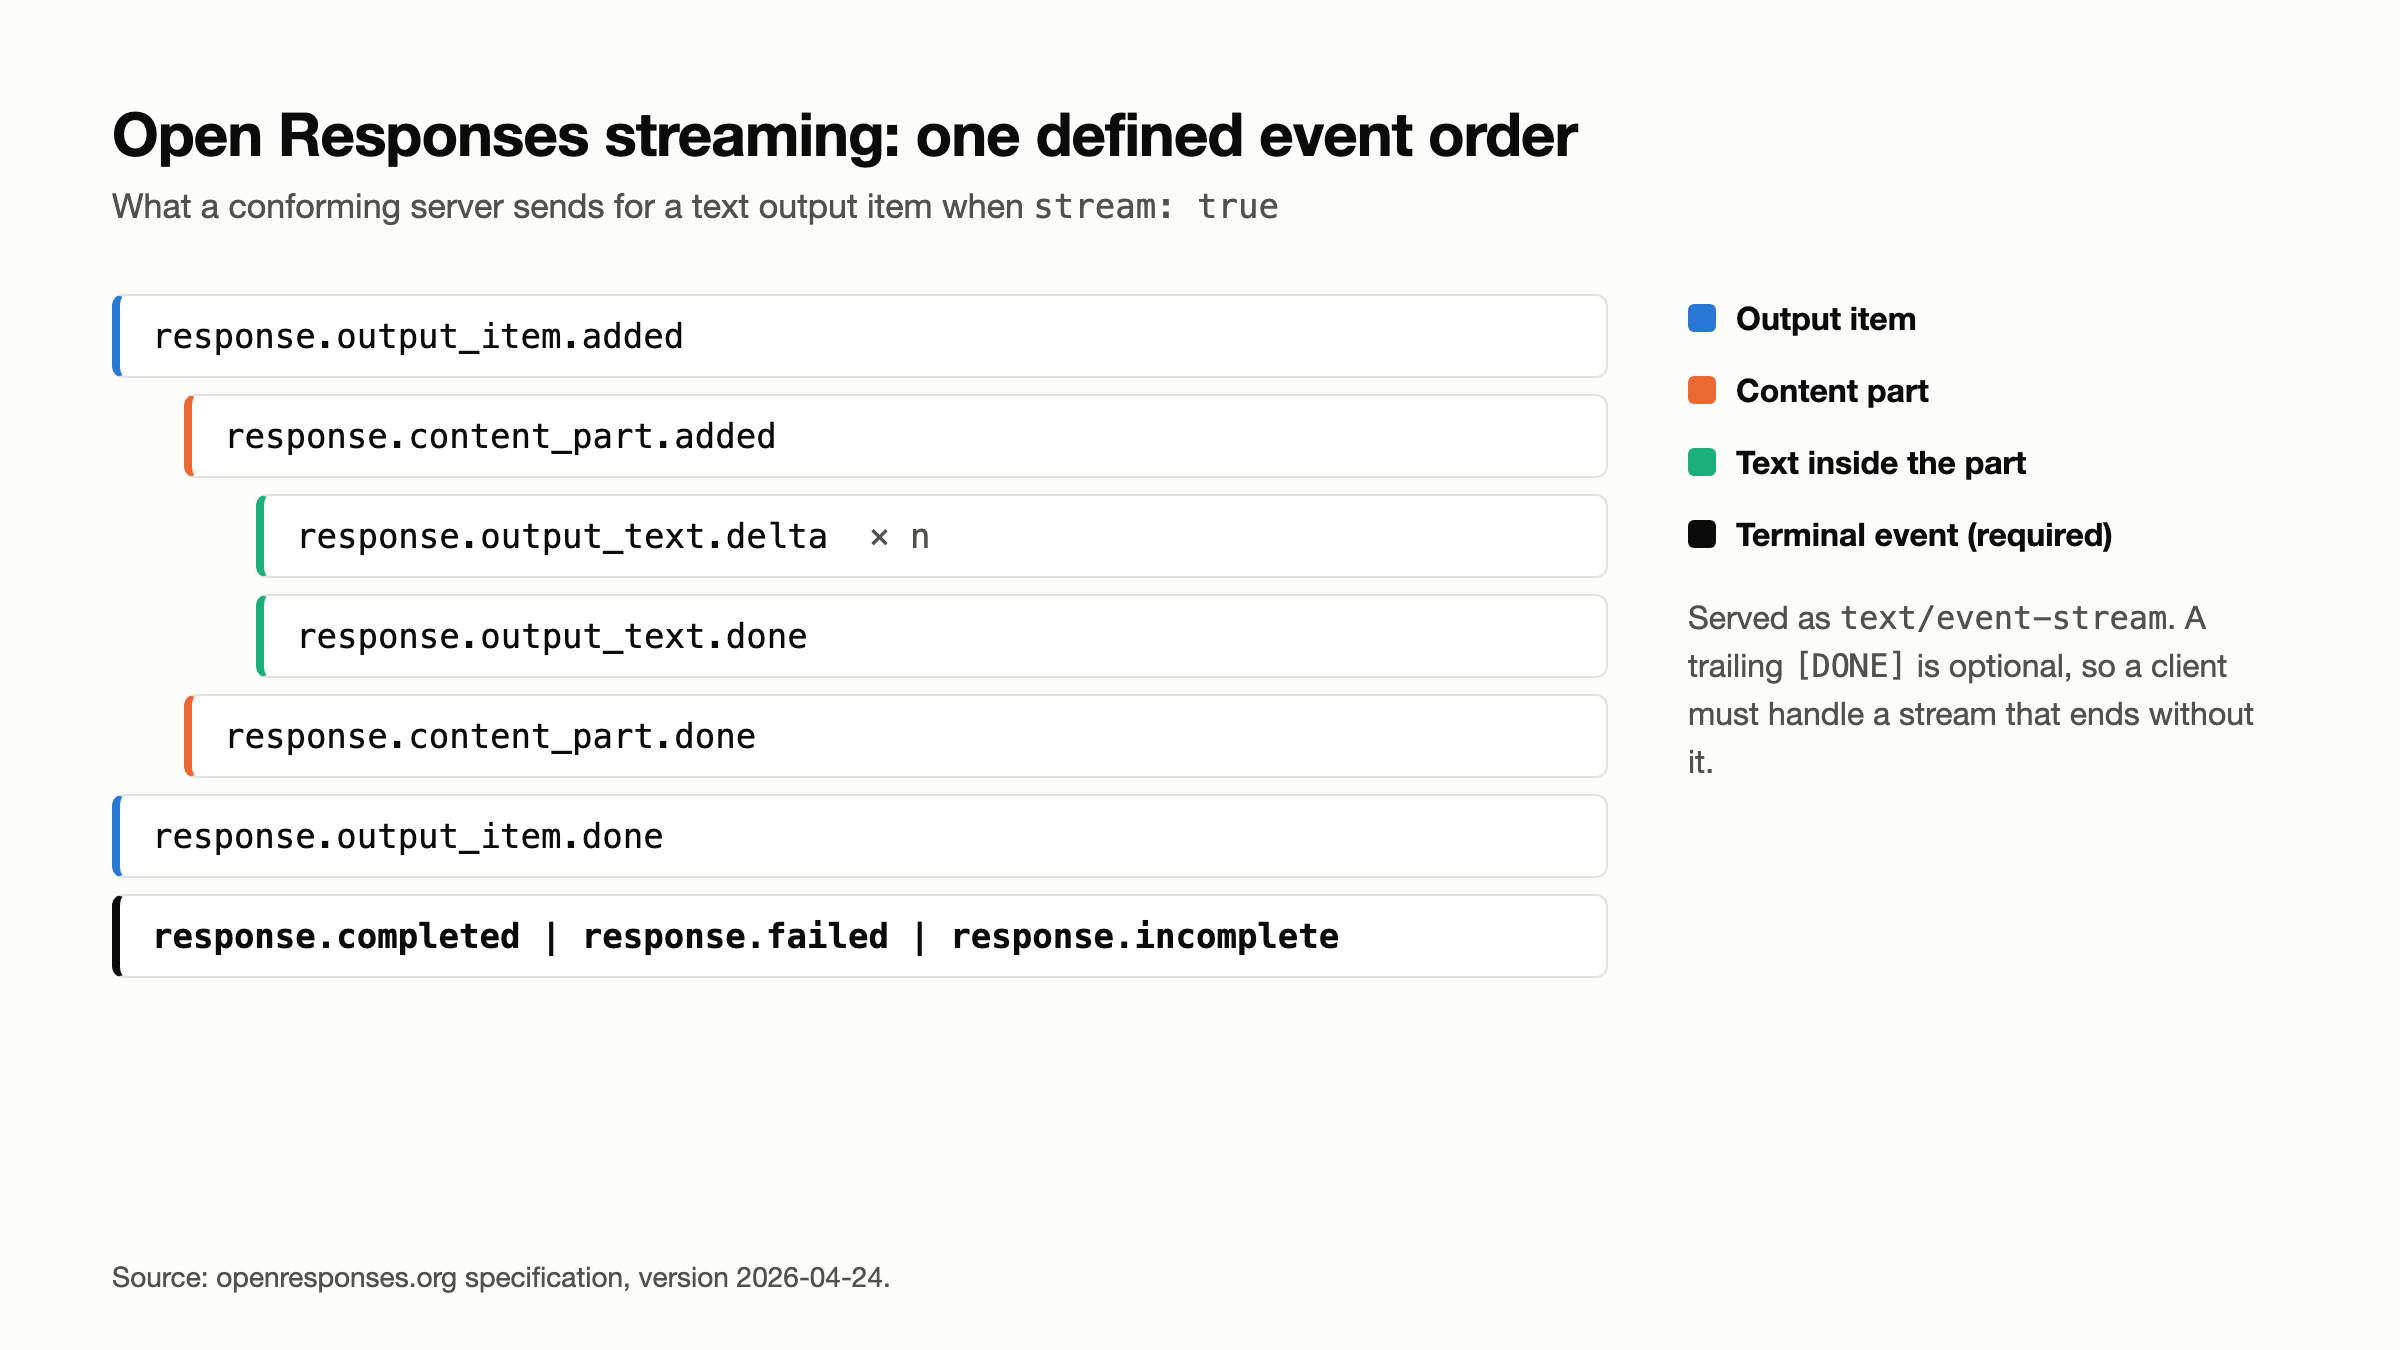
Wenn du stream: true setzt, muss der Server mit Content-Type: text/event-stream und einer definierten Ereignissequenz antworten. Ein Output-Item wird mit response.output_item.added eröffnet; Text darin kommt als response.content_part.added, dann wiederholte response.output_text.delta-Events, dann response.output_text.done und response.content_part.done; das Item schließt mit response.output_item.done. Der Stream muss mit einem terminalen Event enden: response.completed, response.failed oder response.incomplete. Ein abschließendes ist optional, und Clients müssen einen Stream verarbeiten, der ohne dieses endet.
Das ist vor allem für Client-Code wichtig: Wenn zwei Anbieter dieselben Events in derselben Reihenfolge ausgeben, funktioniert ein SSE-Parser für beide. Unser SSE-Testing-Leitfaden zeigt, wie du diese Streams Event für Event untersuchst.
Ein stabiler Kern mit namensräumigen Erweiterungen
Anbieter können ihre eigenen Item-Typen, Tools und Streaming-Events hinzufügen, müssen sie aber mit einem Anbieter-Slug präfixieren. Das Beispiel der Spezifikation selbst ist openai:web_search_call. Ein Client, der einen präfixierten Typ nicht erkennt, kann ihn überspringen, ohne dass etwas kaputtgeht. So bleibt die Spezifikation portabel, während gehostete Tools wie Web Search oder File Search Anbieter-Features bleiben.
Der Rest des Vertrags
Ein paar weitere Regeln lohnen sich zu kennen, bevor du auf der Spezifikation aufbaust:
Zwei Arten von Tools. Extern gehostete Tools (Funktionen, MCP-Server) laufen außerhalb des Anbieters; bei Funktionen gibt das Modell einen function_call aus, du führst ihn aus und sendest ein function_call_output mit der passenden call_id zurück. Intern gehostete Tools (zum Beispiel OpenAIs File Search) laufen innerhalb des Anbieters, ohne die Kontrolle zurückzugeben.tool_choice und allowed_tools. tool_choice akzeptiert auto (der Standard), required, none oder ein Objekt, das eine Funktion benennt. allowed_tools schränkt ein, welche Tools das Modell aufrufen darf, während alle weiterhin angezeigt werden, sodass du einen gecachten Prompt nicht ungültig machst, indem du das tools-Array bearbeitest. Server müssen es als harte Grenze durchsetzen.previous_response_id. Der Server muss die neue Anfrage als previous_response.input + previous_response.output + input behandeln, in dieser Reihenfolge, damit du das Transkript nicht erneut sendest.Reasoning-Items können rohes content, einen undurchsichtigen encrypted_content-Blob, eine benutzersichere summary oder eine beliebige Mischung davon enthalten.Fehler tragen einen type (server_error, invalid_request, not_found, model_error, too_many_requests) sowie code, param und message; mitten im Stream folgt auf einen Fehler response.failed.
Die Revision 2026-04-24 (Changelog) fügte den WebSocket-Transport hinzu: Jeder Turn beginnt mit einer response.create-Nachricht, eine Verbindung verarbeitet jeweils eine Antwort, Verbindungen sind auf 60 Minuten begrenzt (Fehlercode websocket_connection_limit_reached), und store: false-Fortsetzungen leben im verbindungs lokalen Speicher und schlagen mit previous_response_not_found fehl, sobald dieser Zustand weg ist. Dieselbe Revision fügte /responses/compact hinzu, ein optionales phase-Feld bei Assistant-Nachrichten (commentary oder final_answer) und machte logprobs optional.
Open Responses vs. Chat Completions
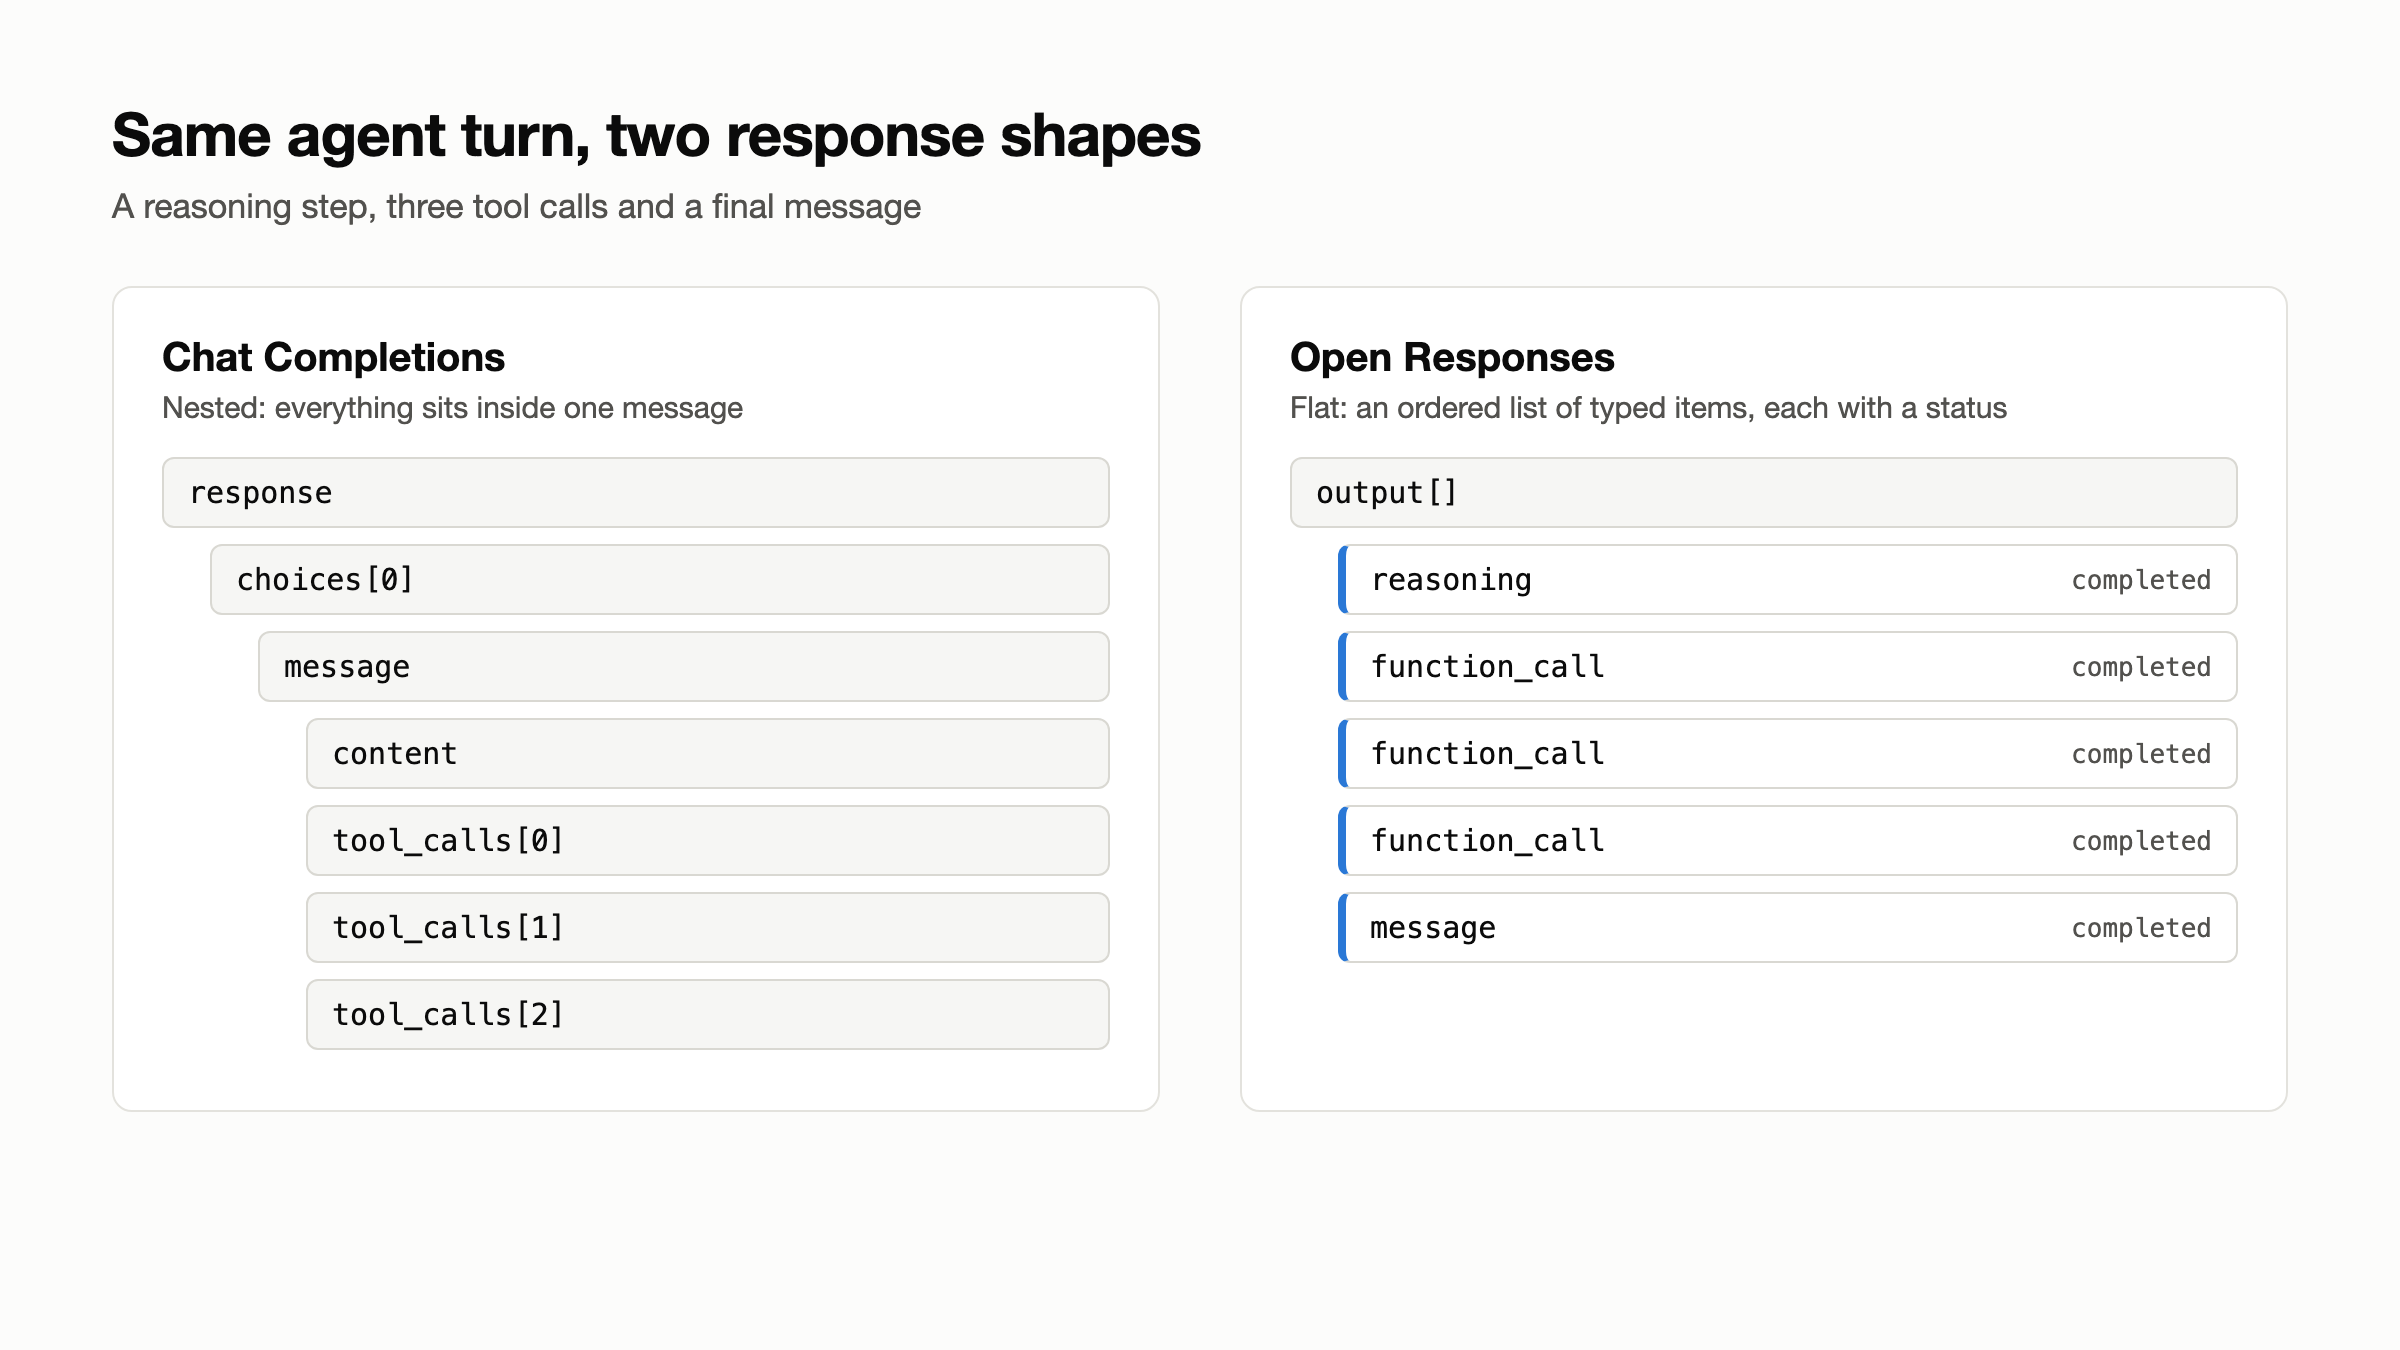
Chat Completions ist nach wie vor die am weitesten kopierte LLM-Schnittstelle. Der Unterschied liegt in der Form: Chat Completions gibt Choices zurück, die eine Nachricht enthalten, mit darin versteckten Tool-Aufrufen, während das Responses-Modell eine flache Liste typisierter Items zurückgibt. Ein Reasoning-Schritt, drei Tool-Aufrufe und eine Abschlussnachricht werden zu separaten, geordneten Objekten mit eigenem Status, was besser zu Agent-Loops passt.
Wir haben die drei dominierenden Formate nebeneinander mit echten Anfragen verglichen, in Chat Completions vs Anthropic Messages vs Responses API. Wenn du zwischen OpenAIs eigenen Oberflächen wählst, deckt die Aufschlüsselung Agents API vs Responses API vs Agents SDK ab, wo Responses einzuordnen ist.
Wer es implementiert
Die Unterstützerliste umfasst AWS Bedrock, Databricks, Hugging Face, LM Studio, Nvidia, Ollama, OpenRouter, Red Hat, Vercel und vLLM, neben OpenAI. Anthropic und Google gehören nicht zu den genannten Unterstützern; beide liefern weiterhin ihre eigenen nativen Formate aus.
„Unterstützt“ deckt eine große Bandbreite ab, also prüfe die Details für die Runtime, die du verwendest:
Ollama fügte POST /v1/responses in v0.13.3 hinzu. SeineKompatibilitätsdokumentationsagt: „only the non-stateful flavor is supported“: Streaming, Funktions-Tools und Reasoning-Zusammenfassungen funktionieren, aber previous_response_id, conversation und truncation nicht. Du sendest den Verlauf selbst erneut.LM Studiomachte seinenEndpunkt http://localhost:1234/v1/responses in Version 0.3.39 kompatibel, einschließlich previous_response_id, Remote-Bild-URLs für Vision-Modelle und logprobs. Siehe unserenLM Studio-Leitfadenfür die Einrichtung.
Für ein Gefühl der Größenordnung hat API Evangelist am 13. September eine Baseline erstellt: Von 120 Anbietern, die OpenAI-Kompatibilität beanspruchen und ein lesbares OpenAPI-Dokument veröffentlichen, deklarieren 26 POST /responses, gegenüber 105, die POST /chat/completions deklarieren. Der Sinn der Baseline ist zu messen, ob neutrale Governance diese Zahl bewegt.
Was der Schritt zur Agentic AI Foundation ändert
AAIF kündigte Open Responses am 22.10.2026 auf der AGNTCon + MCPCon North America in San Jose an, zusammen mit drei weiteren neuen Projekten: Agent Skills (von Anthropic), OpenEnv (von Hugging Face) und OpenSandbox (von Alibaba). Damit kommt AAIF in seinem ersten Jahr auf 10 gehostete Projekte, neben MCP, dem Agent2Agent-Protokoll, AGENTS.md, goose, agentgateway und Agent Router. Wenn du herausfinden willst, wie diese zusammenpassen, ist unsere MCP vs A2A-Erklärung ein guter Anfang.
Was sich ändert:
Governance. Das Projekt ist jetzt „Open Responses a Series of LF Projects, LLC“, mit einer am 21.10.2026 angenommenentechnischen Charta. Ein Technical Steering Committee, zunächst die Maintainer des Projekts, verantwortet technische Entscheidungen, und die Teilnahme steht allen offen, die der Charta folgen.Glaubwürdigkeit für andere Anbieter. Eine Spezifikation, die einem Unternehmen gehört, ist ein Produkt. Eine Spezifikation unter einer Stiftung kann ein Wettbewerber leichter übernehmen, ohne dass es so aussieht, als folge er einem Rivalen.
Was sich nicht ändert:
OpenAIs eigene API. Die Responses API auf api.openai.com behält ihre eigenen Funktionen und ihren eigenen Release-Zeitplan. Open Responses beschreibt den portablen Kern; OpenAI-spezifische Tools bleiben hinter dem Präfix openai:.Das Wire-Format. Mit dem Schritt kam keine neue Spezifikationsversion. Die neueste Veröffentlichung ist weiterhin 2026-04-24, und datierte Veröffentlichungen sind unveränderlich.Konformität. Auf der Unterstützerliste zu stehen bedeutet nicht, dass ein Endpunkt die Tests besteht. Noch veröffentlicht niemand einen Bestanden/Durchgefallen-Index, also prüfst du die Endpunkte, von denen du abhängst, selbst.
Prüfe einen Endpunkt mit den Akzeptanztests
Das Projekt liefert seine eigenen Akzeptanztests mit. Die Compliance-Seite führt 10 Tests im Browser gegen jede beliebige Basis-URL, jedes Modell und jeden Schlüssel aus: einfache Textantwort, Streaming, System-Prompt, Tool-Aufruf, Bildeingabe, Multi-Turn-Verlauf, Assistant-phase-Labels, den Kompaktierungs-Endpunkt und einen Negativtest für eine kompakte Anfrage ohne model. Sieben weitere WebSocket-Tests (sequenzielle Turns, store: false-Fortsetzung, Wiederverbindungserholung, Cache-Eviction nach einer fehlgeschlagenen Fortsetzung) laufen nur über die CLI:
git clone https://github.com/openresponses/openresponses
cd openresponses && bun install
bun run test:compliance --base-url http://localhost:11434/v1 --api-key ollama
Jede HTTP-Anfrage und jeder WebSocket-Turn erhält eine Frist von 30 Sekunden, und ein Timeout lässt nur diesen Test fehlschlagen. Erwartungsgemäß wird eine nicht-zustandsbehaftete Runtime wie Ollama die Fortsetzungstests konstruktionsbedingt nicht bestehen.
Lass deinen Coding-Agent es mit Apidog CLI testen
Die Akzeptanztests sagen dir, ob ein Server heute der Spezifikation folgt. Sie überwachen nicht den Endpunkt, den deine App bei jedem Deploy aufruft, wenn du Ollama aktualisierst oder einen Anbieter wechselst. Importiere dafür die Spezifikation in ein Apidog-Projekt und lass deinen Coding-Agent Regressions-Tests dagegen schreiben und ausführen, mit Apidog CLI.
Installiere die CLI und den Agent-Skill einmalig:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Gib dann Claude Code, Codex oder Cursor einen Prompt:
Download https://www.openresponses.org/openapi/openapi.json and import it into
Apidog project <id>. Create an environment "local-ollama" with base URL
http://localhost:11434/v1. Add test cases for POST /responses: one that expects 200,
status "completed" and an output item of type "message"; one with stream: true that
expects text/event-stream ending in response.completed; one without "model" that
expects a 4xx error with an error.type field. Run them and summarize any failures.
Der Agent liest die Schemata, validiert seine Payloads, bevor er etwas schreibt, und führt die Fälle aus:
curl -sLO https://www.openresponses.org/openapi/openapi.json
apidog import --project <id> --format openapi --file ./openapi.json
apidog environment create local-ollama --project <id> --base-url http://localhost:11434/v1
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Der servers-Eintrag der Spezifikation zeigt auf https://api.openai.com/v1, also füge eine Umgebung pro Anbieter hinzu und führe dieselben Fälle gegen jede aus: Das ist die Portabilitätsbehauptung, getestet. Nimm die Zeile apidog run ... -r junit in deine Pipeline auf, damit ein Runtime-Upgrade, das ein Feld verliert, den Build scheitern lässt (CI/CD-Leitfaden); Apidog CLI in Claude Code behandelt die Agent-Einrichtung im Detail.
FAQ
Ist Open Responses dasselbe wie die OpenAI Responses API? Nein. Open Responses ist eine davon abgeleitete Spezifikation. OpenAIs Responses API ist eine Implementierung mit zusätzlichen OpenAI-eigenen Funktionen; Ollama, LM Studio und vLLM sind andere.
Wem gehört Open Responses jetzt? Seit dem 22.10.2026 ist es ein Projekt der Agentic AI Foundation unter der Linux Foundation, geführt als LF-Projects-Reihe mit einem Technical Steering Committee. Es steht unter der Apache-2.0-Lizenz.
Unterstützt Anthropic Open Responses? Anthropic gehört nicht zu den genannten Unterstützern. Es hat am selben Tag Agent Skills zu AAIF beigetragen, aber Claudes native Schnittstelle ist weiterhin die Messages API.
Wo ist die Spezifikationsdatei? Unter https://www.openresponses.org/openapi/openapi.json, mit datierten Veröffentlichungen im GitHub-Repository.
Nächster Schritt
Wähle den einen Endpunkt, den dein Produkt am häufigsten aufruft, führe die Browser-Akzeptanztests dagegen aus und importiere die Spezifikation in Apidog, damit dein Agent diese Prüfungen bei jedem Deploy weiterlaufen lassen kann. Lade Apidog herunter, um loszulegen.