
Jev ist ein neuartiges Modell von TypeSafe AI. Es schreibt keinen Text. Man übergibt ihm einen Teil des Programmzustands, deklariert die zu beantwortenden Fragen, und es liefert typisierte Antworten mit kalibrierten Wahrscheinlichkeiten: eine Ja/Nein-Wahrscheinlichkeit, eine Auswahl aus einer Liste oder eine Punktzahl auf einer Bewertungsmatrix. TypeSafe nennt dies ein „System One Modell“, und das Konzept ist einfach: Die meisten KI-Aufrufe in Software fragen nicht nach Prosa, sondern nach einer Entscheidung. Wenn Sie ein LLM in einen Klassifikator eingebunden und dann einen Parser geschrieben haben, um ein Label aus dessen Antwort zu extrahieren, ist Jev genau für diese Aufgabe konzipiert, so wie strukturierte Ausgaben ein erster Schritt in diese Richtung waren.
Es wurde am 16. September 2026 auf dem Vercel AI Gateway eingeführt, wodurch es den meisten Entwicklern zugänglich wurde. Dieser Leitfaden behandelt, was Jev ist, wie es sich von einem Sprachmodell unterscheidet, die drei Fragetypen, wie man es direkt und über das Gateway aufruft und wie man es in Apidog testet und simuliert, bevor es Ihre Routing-Logik berührt.
Was Jev ist
Der Einführungsbeitrag von TypeSafe beschreibt Jev als „einen Funktionsaufruf der Frontier-Intelligenz: unstrukturierter Zustand hinein, typisierte probabilistische Entscheidungen heraus.“ Drei Eigenschaften definieren es.
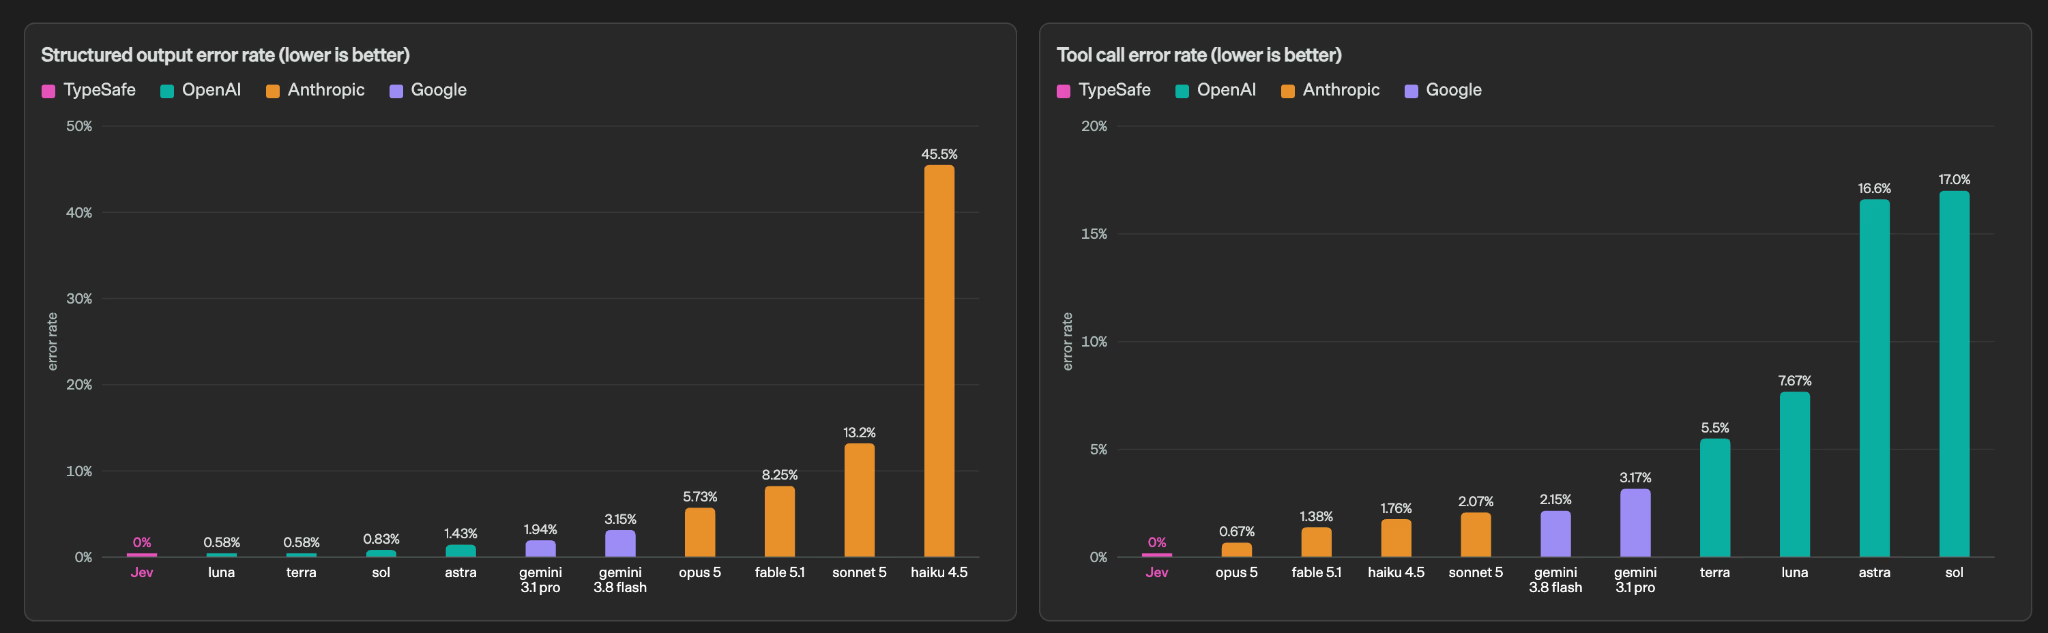
Die Ausgabe ist typisiert und wird vor dem Aufruf deklariert. Sie definieren die Form jeder Frage im Voraus. Das Modell kann nur innerhalb dieser Form antworten, sodass nichts geparst werden muss und keine Schema-Inkompatibilität abgefangen werden muss. TypeSafes Aussage dazu ist, dass Jev „niemals Typfehler macht.“
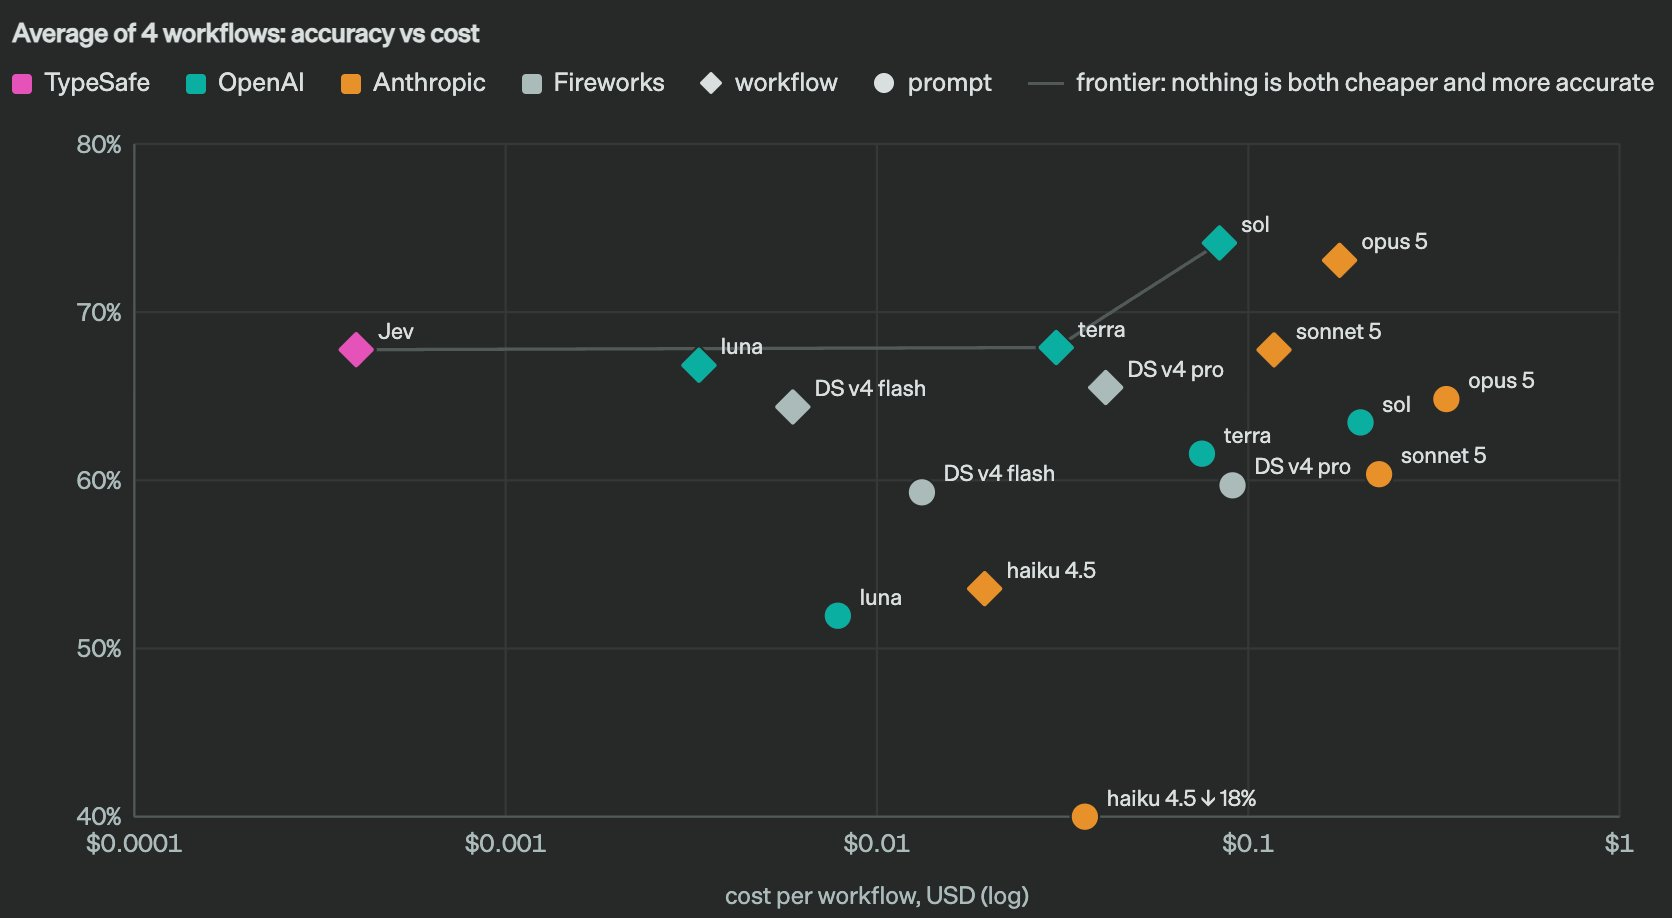
Jede Antwort trägt eine Wahrscheinlichkeit. Eine Ja/Nein-Frage liefert nicht true; sie liefert eine Zahl wie 0.97. Eine Auswahl gibt die vollständige Verteilung über die Optionen zurück. TypeSafe hat das Modell mit einer Methode trainiert, die es Reinforcement Learning for Calibrated Decisions nennt, und die Behauptung ist, dass höheres Vertrauen eine höhere Genauigkeit bedeutet, sodass Sie einen Schwellenwert festlegen können: die klaren Fälle automatisieren, die unsicheren an einen Menschen weiterleiten.
Fragen werden parallel in einer einzigen Anfrage beantwortet. Ein Sprachmodell produziert ein Token nach dem anderen. Jev bewertet jede deklarierte Frage gleichzeitig gegen denselben Zustand, weshalb TypeSafe End-to-End-Antwortzeiten von 70ms bis 500ms angibt. Dies sind die eigenen Zahlen des Anbieters; behandeln Sie sie als Behauptung, die Sie mit Ihrer Arbeitslast überprüfen müssen, und nicht als Benchmark.
Wie Jev sich von einem Sprachmodell unterscheidet
| Sprachmodell | Jev | |
|---|---|---|
| Ausgabe | Freier Text, den Sie parsen | Typisierte Werte, die Sie deklariert haben |
| Sampling | Sequenziell, Token für Token | Alle Fragen parallel |
| Zuverlässigkeit | Standardmäßig nicht offengelegt | Eine Wahrscheinlichkeit bei jeder Antwort |
| Am besten für | Schreiben, Chatten, Zusammenfassen | Entscheiden, Routen, Bewerten, Verifizieren |
| Eingabe | Nachrichten | Strukturierter Zustand: ein String, Objekt oder Array |
| Bilder | Oft unterstützt | Vorerst nur Text |
Der Kompromiss ist explizit: Jev verzichtet vollständig auf die String-Generierung. Es ist kein Chat-Modell und wird kein Dokument zusammenfassen. Es passt dort, wo es um die „intelligente If-Anweisung“ innerhalb einer Anwendung geht: welches Team dieses Ticket bearbeitet, wie schwerwiegend dieser Fehler ist, ob diese Antwort sicher gesendet werden kann, ob der Build erfolgreich war.
Die drei Fragetypen
Jevs direkte API stellt drei primitive Typen zur Verfügung. Jeder ist ein JSON-Objekt unter einem von Ihnen gewählten Schlüssel.
Noul: eine Ja/Nein-Wahrscheinlichkeit. TypeSafes Name für den booleschen Typ. Es gibt die Wahrscheinlichkeit zurück, dass die Antwort Ja ist, und Sie schwellen diese im Code ab.
{ "is_urgent": { "type": "noul", "instructions": "Does this message express urgency?" } }
Antwort: { "type": "noul", "noul": 0.99 }.
Choice: wählen Sie eine Option aus einem benannten Satz. criteria ordnet Optionsnamen Beschreibungen zu, bis zu 255 Optionen. Die Antwort enthält die beste Wahl sowie die vollständige Verteilung und einen Konfidenzwert.
{ "department": { "type": "choice", "instructions": "Which team should handle this?",
  "criteria": { "billing": "Charges, invoices, payment problems",
                "shipping": "Delivery status, delays, lost packages",
                "returns":  "Exchanges, refunds, damaged items" } } }
Antwort: { "type": "choice", "choice": "returns", "confidence": 1.0, "probabilities": { "returns": 1.0, "shipping": 0.0, "billing": 0.0 } }.
Score: eine Position auf einer geordneten Skala. criteria ist ein Array von 2 bis 10 Level-Beschreibungen, beginnend mit dem niedrigsten. Der Score ist die wahrscheinlichkeitsgewichtete Position, sodass er zwischen den Stufen liegen kann.
{ "bug_severity": { "type": "score", "instructions": "How severe is the reported issue?",
  "criteria": [ "Cosmetic; no impact to functionality",
                "Broken feature, but a workaround exists",
                "Blocking issue; no workaround" ] } }
Antwort: { "type": "score", "score": 1.3, "confidence": 0.54, "probabilities": { "0": 0.0, "1": 0.7, "2": 0.3 }, "legend": { "0": "Cosmetic...", "1": "Broken...", "2": "Blocking..." } }.
Eine Besonderheit bei der Benennung: Über das Vercel AI SDK wird der Ja/Nein-Typ boolean genannt und das Antwortfeld ist probability. Gegenüber der eigenen API von TypeSafe ist es noul. Gleiche Idee, anderer Schlüssel.
Zwei Wege, Jev aufzurufen
Direkt. Holen Sie sich einen Schlüssel unter console.typesafe.ai/settings/keys und senden Sie dann POST https://api.typesafe.ai/v1/systemone mit einem Bearer-Token. Die Modell-ID ist jev-latest, die derzeit zu jev-1.13.0 auflöst; jev-preview verweist auf den neuesten Build, ob offiziell oder nicht. Python- und JavaScript-SDKs existieren gemäß dem Quickstart, aber der Roh-Endpunkt ist ein einzelner POST, was die Form ist, die wir in Apidog verwenden werden.
Über Vercel AI Gateway. Die Modell-ID ist typesafe-ai/jev und Sie rufen sie mit experimental_evaluate aus dem AI SDK (Version 7 oder höher) auf. Ein Hinweis aus den Evaluierungs-Dokumenten: Die Evaluierung ist nur über das AI SDK verfügbar, nicht über die OpenAI-kompatiblen oder Anthropic-kompatiblen Endpunkte des Gateways. Wenn Sie Modelle bereits über das Gateway routen, wie in unserer Anleitung zu GPT-5.6 Sol on AI Gateway beschrieben, ist dies der natürliche Weg; unser Vercel AI SDK Leitfaden behandelt die Einrichtung.
import { experimental_evaluate as evaluate } from 'ai';

const result = await evaluate({
  model: 'typesafe-ai/jev',
  state: 'The support agent issued a full refund to the customer.',
  questions: { refunded: { type: 'boolean', instructions: 'Was a refund issued?' } },
});
// result.answers.refunded -> { type: 'boolean', probability: 0.99 }
Ihre erste Anfrage mit Curl
Dies triagiert eine Supportnachricht mit allen drei Typen in einem Aufruf:
export TYPESAFE_API_KEY="..."

curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": "My card was charged twice for one order and I need this fixed today.",
    "questions": {
      "department": { "type": "choice", "instructions": "Which team handles this?",
        "criteria": { "billing": "charges and refunds", "shipping": "delivery", "technical": "bugs" } },
      "urgency": { "type": "score", "instructions": "How urgent is this?",
        "criteria": ["low", "medium", "high"] },
      "wants_refund": { "type": "noul", "instructions": "Is the customer asking for money back?" }
    }
  }'
Die Antwort enthält model, ein answers-Objekt, das durch Ihre Fragen-IDs geschlüsselt ist, und usage mit input_tokens und output_tokens. Lesen Sie answers.department.choice, answers.urgency.score und answers.wants_refund.noul und wenden Sie dann Ihre Schwellenwerte an.
Jev in Apidog testen und simulieren
Ein Modell, das Wahrscheinlichkeiten zurückgibt, verändert das Aussehen eines Tests. Sie prüfen nicht länger einen String; Sie prüfen, ob eine Zahl einen Schwellenwert überschreitet. Apidog macht daraus eine gespeicherte, wiederholbare Prüfung anstatt eines einmaligen Curl-Aufrufs.
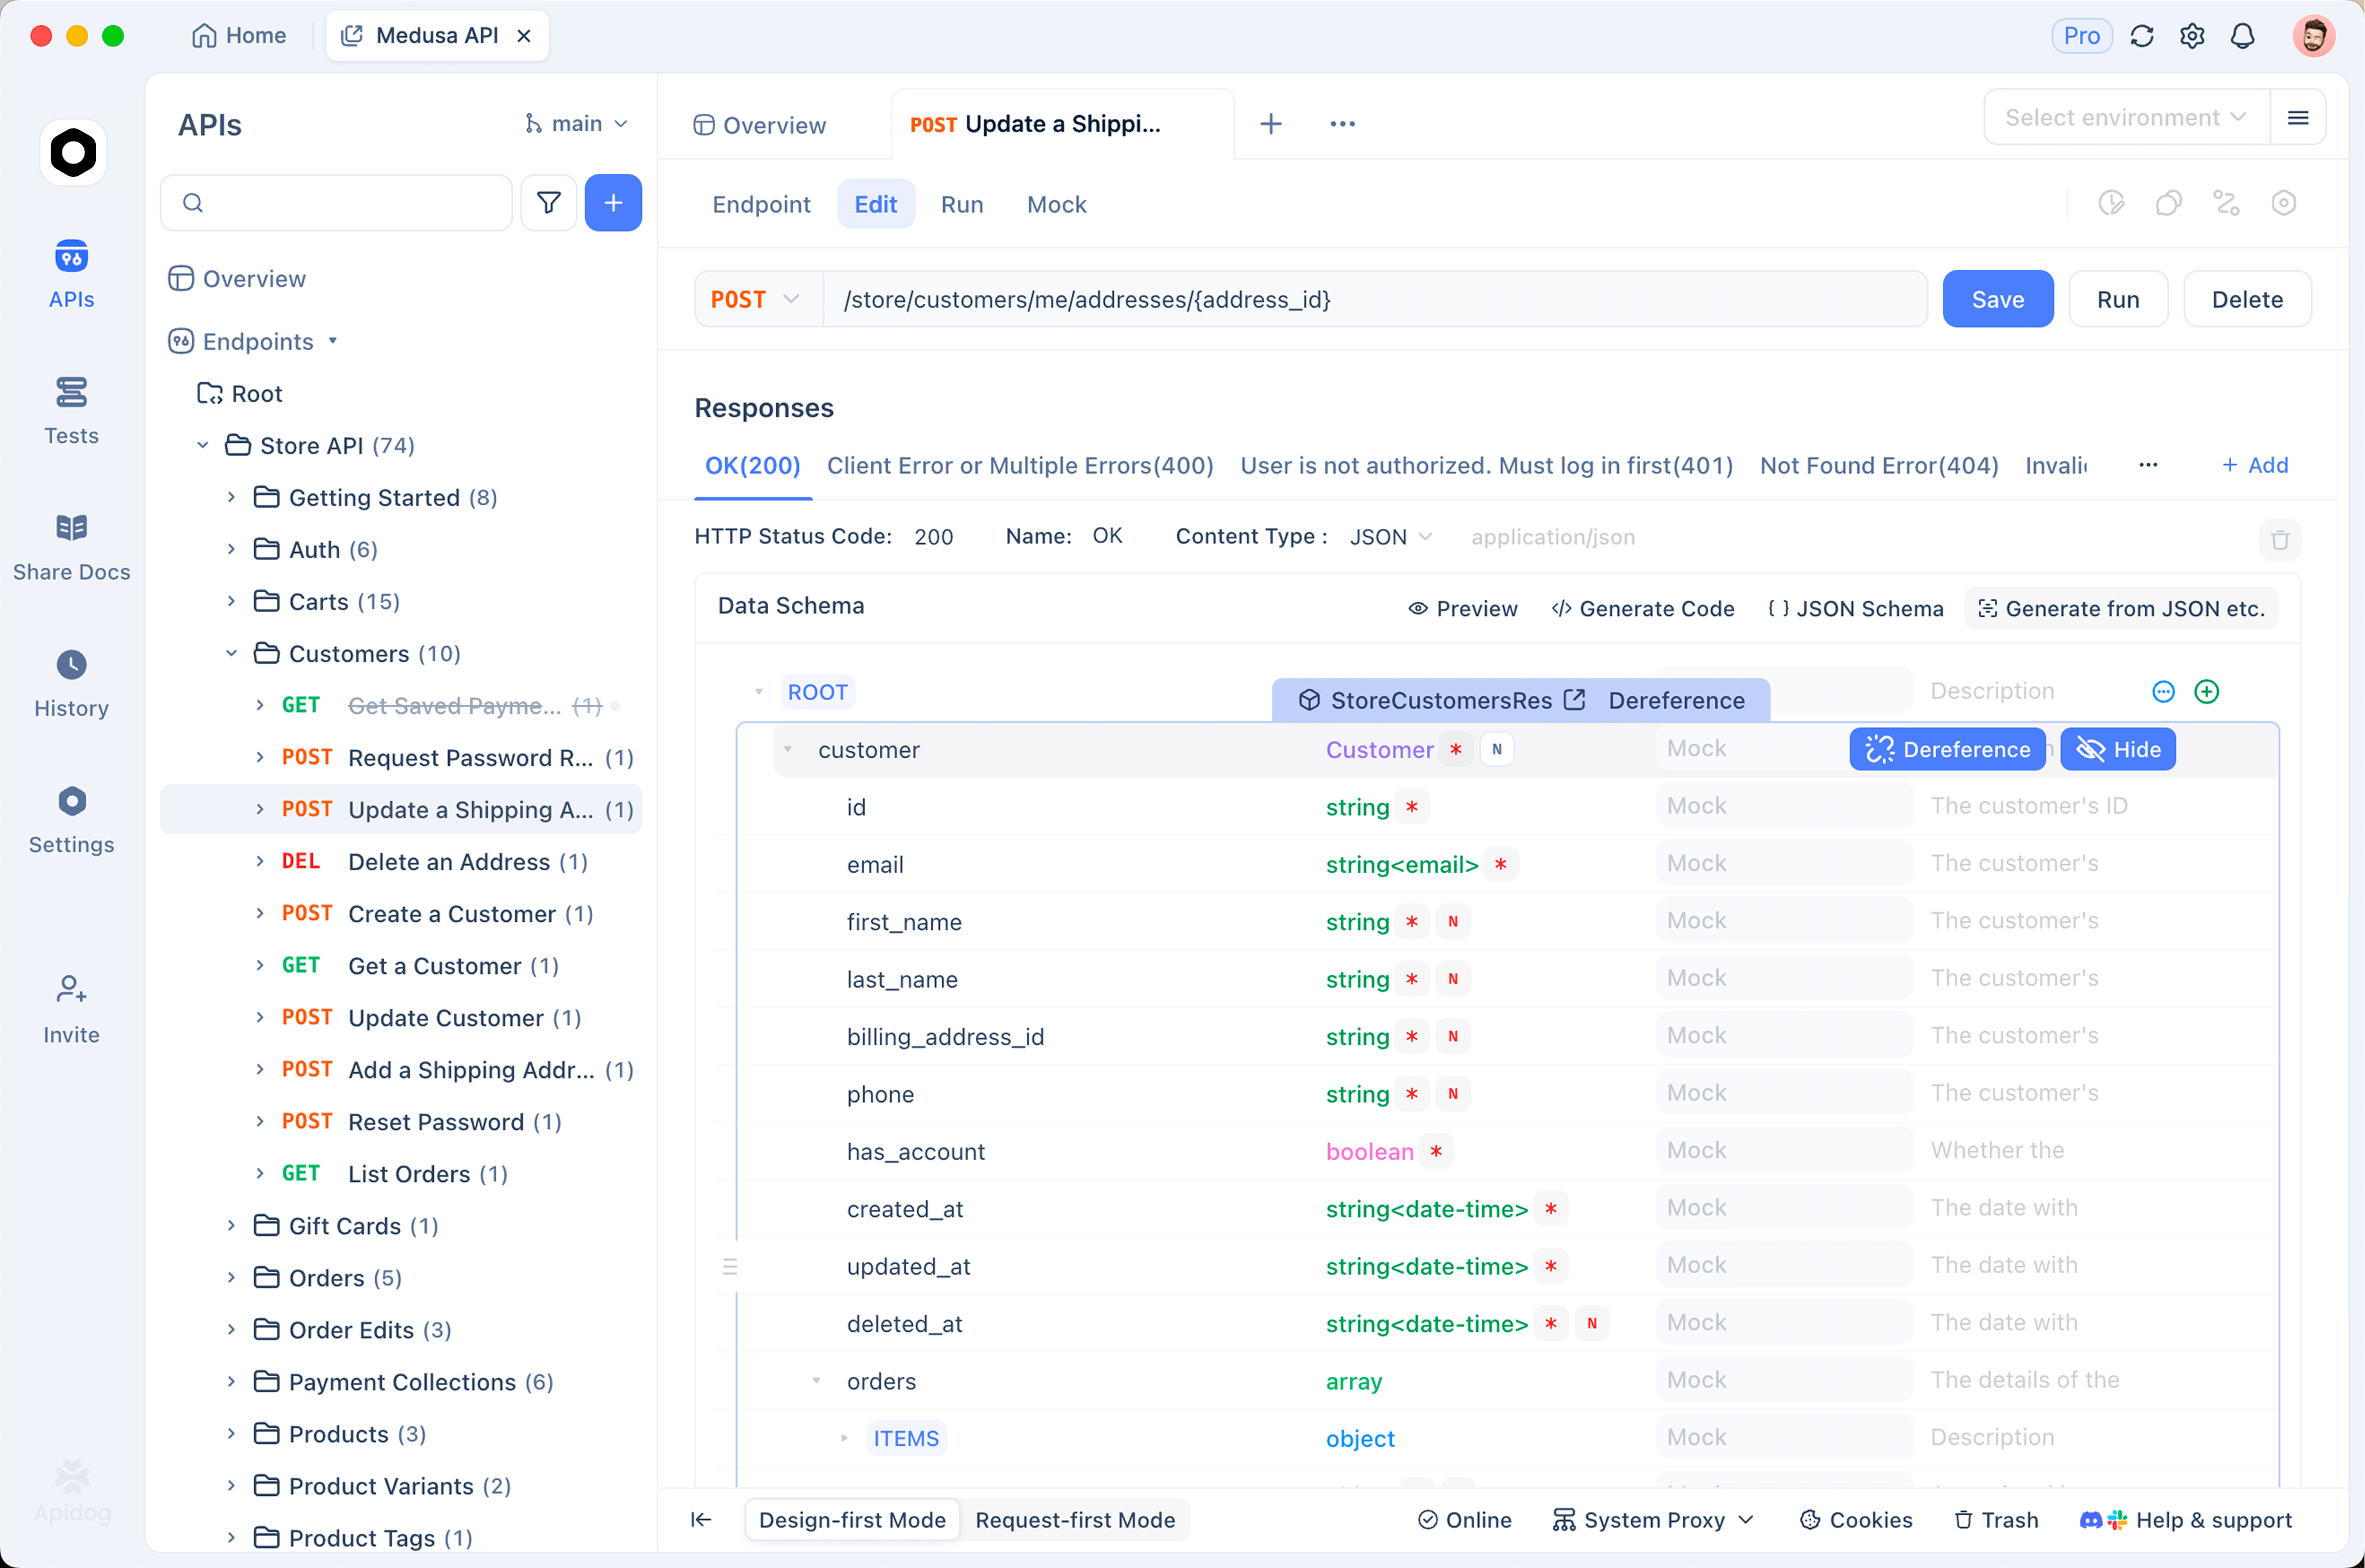
Schlüssel speichern. Öffnen Sie die Umgebungsverwaltung, erstellen Sie eine Umgebung namens TypeSafe und fügen Sie TYPESAFE_API_KEY mit dem tatsächlichen Wert in das lokale Feld ein, damit es auf Ihrem Rechner verbleibt und niemals mit dem Team synchronisiert wird. Unser Leitfaden zu Umgebungen und geheimen Variablen behandelt die Gültigkeitsregeln.
Anfrage erstellen. Neue Anfrage, POST https://api.typesafe.ai/v1/systemone, Authentifizierungstyp Bearer Token mit {{TYPESAFE_API_KEY}}, JSON-Body aus dem Curl-Beispiel. Senden Sie es und lesen Sie die Antworten im Antwortfeld.
Entscheidung prüfen, nicht den Text. Fügen Sie Post-Prozessor-Assertions hinzu, wie z.B. answers.department.choice gleich billing, answers.wants_refund.noul größer als 0.9 und answers.urgency.score größer als 1.5. Nun führt eine Regression im Verhalten von Jev oder in Ihrer eigenen Kriterienformulierung zu einem Fehlschlag eines Tests, anstatt Tickets stillschweigend falsch zu routen.
Für das Frontend simulieren. Speichern Sie die Antwort als Mock, und Ihre Ticket-Benutzeroberfläche kann gegen ein stabiles answers-Objekt erstellt und demonstriert werden, ohne Token auszugeben oder auf das Modell zu warten. Da die Form deklariert ist, können Mock und echte Antwort nicht auseinanderdriften.
Als Szenario speichern. Verketten Sie einige Zustände, eine ruhige Nachricht, eine wütende, eine zweideutige, und stellen Sie sicher, dass die Zuverlässigkeit im zweideutigen Fall sinkt. Das ist die Überprüfung, die Ihnen sagt, dass Ihr Schwellenwert seine Aufgabe erfüllt. Laden Sie Apidog herunter, um dies einzurichten; der kostenlose Plan deckt ein Team von vier Personen ab.
Preise, Limits und Fehler
Von der Modellseite von TypeSafe:
- Preis: 0,042 $ pro Million Eingabe-Tokens. Ausgabe-Tokens werden nicht berechnet. Das Gateway listet die gleichen 0,042 $ pro Million Eingabe-Tokens auf.
- Ratenbegrenzungen: 250.000 Tokens pro Sekunde und 1.200 Anfragen pro Minute, dynamisch angepasst.
- Kontext: 64k Tokens pro Anfrage, davon 32k für
stateplus die längste Frage. - Eingabe: nur Text. Ein String, ein JSON-Objekt oder ein Array von Text. Keine Bilder, Audio oder Video.
- Sprache: Englisch ist am besten; andere Sprachen funktionieren mit geringerer Genauigkeit.
Fehler werden als HTTP-Statuscodes zurückgegeben: 401 für einen fehlenden oder ungültigen Schlüssel, 422 wenn der Body die Validierung fehlschlägt (ein Score mit einem Level, eine Choice ohne Kriterien), 429 für Ratenbegrenzungen und 529 wenn der Dienst überlastet ist. Bei den letzten beiden Fällen zurücktreten und erneut versuchen; die SDKs tun dies standardmäßig.
Häufig gestellte Fragen (FAQ)
Ist Jev ein Ersatz für ein LLM?
Nein. Es ersetzt den Teil eines LLM-Aufrufs, bei dem Sie eine Entscheidung anfragten und Text parsten, um diese zu erhalten. Generierung, Chat und Zusammenfassung benötigen weiterhin ein Sprachmodell.
Kann Jev halluzinieren?
Es kann falsch sein, aber es kann keine Antwort außerhalb des von Ihnen deklarierten Schemas produzieren. TypeSafes Argument ist, dass die Schema-Übereinstimmung garantiert ist, sodass ein „halluziniertes“ Label unmöglich ist; ein falsches Label mit geringer Zuverlässigkeit ist jedoch weiterhin möglich, weshalb die Wahrscheinlichkeit wichtig ist.
Was bedeutet „kalibriert“ in der Praxis?
Wenn das Modell 0.9 angibt, sollte es bei dieser Art von Frage in etwa 90% der Fälle richtig liegen. Das ermöglicht es Ihnen, einen Schwellenwert zu wählen und darüber zu automatisieren. Testen Sie es mit Ihren eigenen Daten, bevor Sie der Zahl vertrauen; ein gespeichertes Szenario in Apidog mit gelabelten Zuständen ist eine kostengünstige Möglichkeit dazu.
Benötige ich Vercel, um Jev zu nutzen?
Nein. Die direkte API unter api.typesafe.ai funktioniert eigenständig mit einem Bearer-Schlüssel. Vercel AI Gateway ist eine Annehmlichkeit, wenn Sie das AI SDK bereits verwenden, und es ist der einzige Weg, der experimental_evaluate unterstützt. In jedem Fall sind die Grundlagen des JSON-Schemas hinter deklarierten Formen wissenswert.
Wo Jev passt
Greifen Sie zu Jev, wenn die Frage eine feste Menge von Antworten hat und Sie eine Wahrscheinlichkeit dazu benötigen: Routing, Klassifizierung, Bewertung, Verifizierung, Schutzmechanismen. Behalten Sie Ihr Sprachmodell für alles bei, was Worte benötigt. Deklarieren Sie die Form, testen Sie die Schwellenwerte in Apidog und lassen Sie die Zuverlässigkeitszahl entscheiden, was automatisiert wird.