
GPT-Live-1.1 ist OpenAIs vollduplex Sprachmodell, das seit dem 20. November 2026 in der API verfügbar ist. Es hört zu, während es spricht, übergibt Reasoning- und Tool-Aufrufe an ein Backend-Modell Ihrer Wahl und wird pro Minute abgerechnet: 0,05 $ pro aktiver Minute und 0,02 $ pro Standby-Minute. Sie erreichen es über einen einzigen Endpunkt, v1/live/sessions, nicht über die Realtime API.
Unser früherer Beitrag zu dem, was GPT-Live ist, behandelte die ChatGPT-Sprachfunktion, bevor Entwickler sie per API aufrufen konnten. Dieser Leitfaden behandelt das API-Modell: was neu ist, was es kostet, wie eine Session funktioniert und wie es sich mit GPT-Realtime vergleichen lässt.
Was ist GPT-Live-1.1?
GPT-Live-1.1 ist ein Sprachmodell, das ein gesprochenes Gespräch in Echtzeit führt, während ein separates Backend-Modell das Denken übernimmt. Es akzeptiert Audio und Text, gibt Audio und Text zurück und hört weiter zu, während es spricht, sodass Anrufer mittendrin unterbrechen oder Details ergänzen können. Seine Modell-ID ist gpt-live-1.1, und es unterstützt Streaming und Function Calling.
Die Modellseite zu GPT-Live-1.1 bezeichnet es als „Vollduplex-Sprachmodell für mehrsprachige Gespräche“. Vollduplex bedeutet, dass Audio gleichzeitig in beide Richtungen fließt – wie ein Telefongespräch, nicht wie ein Walkie-Talkie, bei dem eine Seite warten muss.
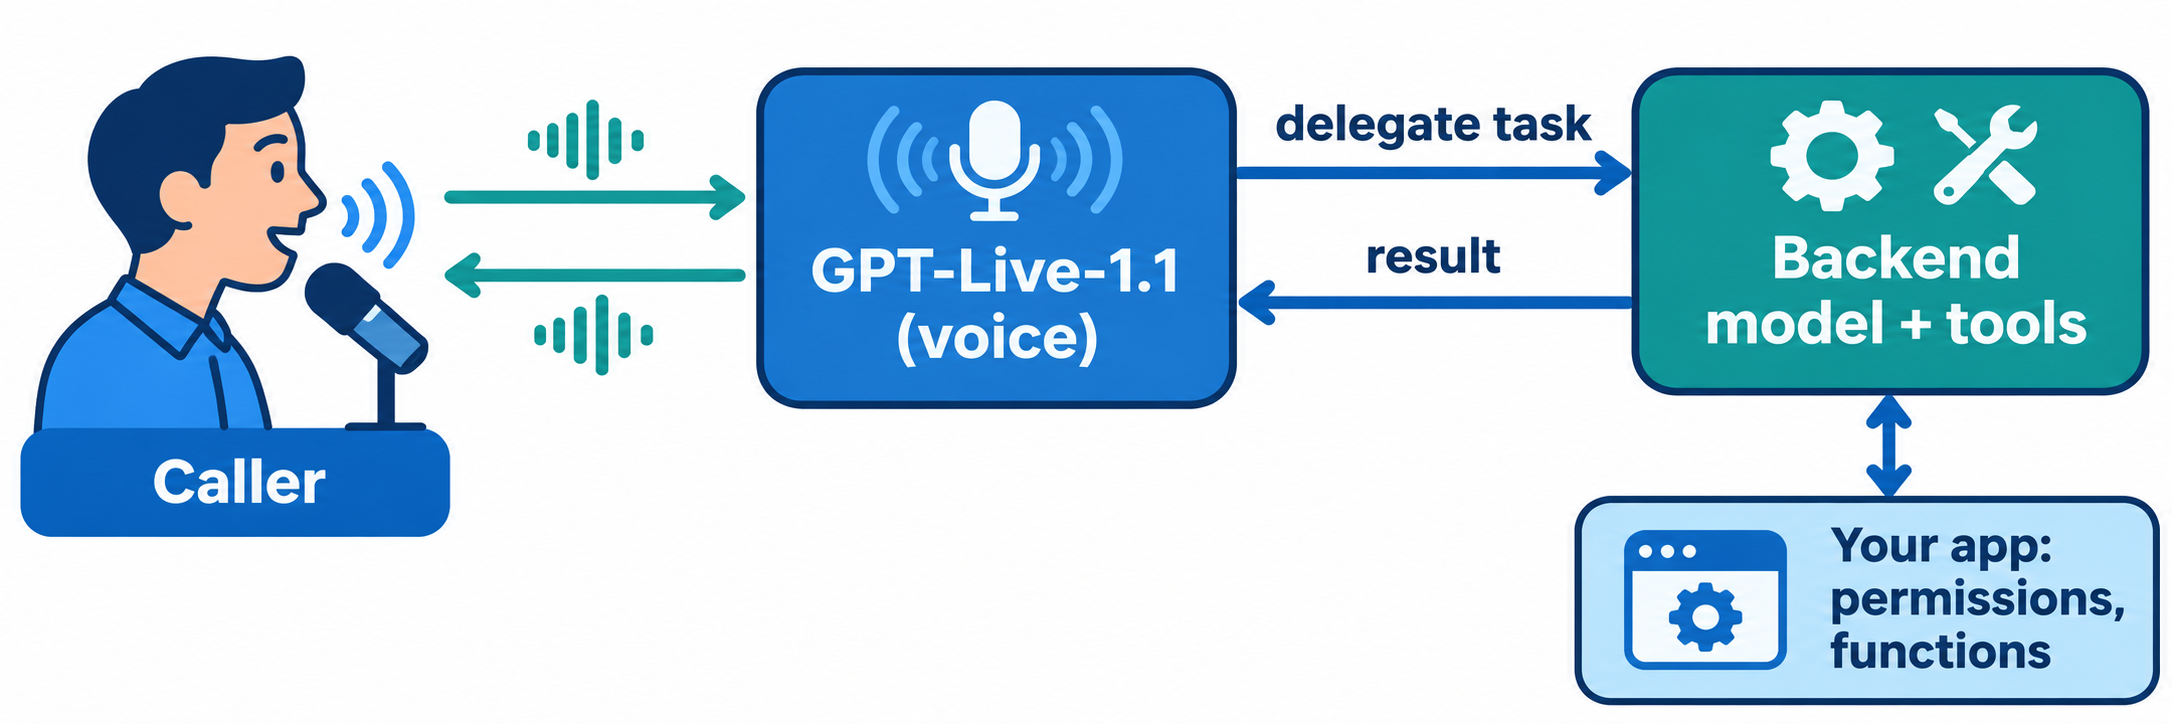
Die andere Hälfte des Designs ist die Delegation. GPT-Live entscheidet, wann eine Anfrage echte Arbeit erfordert, sendet sie an ein Backend (ein OpenAI-Responses-Modell oder Ihren eigenen Agenten), spricht weiter, während das Backend arbeitet, und erklärt dann das Ergebnis laut.
Was sich gegenüber GPT-Live-1 geändert hat
GPT-Live-1.1 behält denselben Endpunkt, dieselbe Preisgestaltung und denselben Funktionsumfang wie GPT-Live-1. Die Änderungen betreffen die Sprachqualität und die Aufgabenbearbeitung. Hier ist, was OpenAI in den Modelldokumenten und in seiner Ankündigung auf X auflistet:
| Bereich | GPT-Live-1 | GPT-Live-1.1 |
|---|---|---|
| Sprachtranskription | Basisniveau | Genauer, laut Modellseite |
| Akzent und Stimme über Sprachen hinweg | Basisniveau | Konsistenter, laut Modellseite |
| Leerlauf-Sessions | Standby-Tarif auf der eigenen Seite gelistet | Standby als neue Option angekündigt, 0,02 $/min |
| Aufgabenerledigung | Basisniveau | „Erledigt Aufgaben noch zuverlässiger“, laut OpenAIs Ankündigung |
| Endpunkt | v1/live/sessions |
v1/live/sessions |
| Preis (aktiv) | 0,05 $/min | 0,05 $/min |
| Rate Limits | Gleichzeitige Sessions | Separates Limit für gleichzeitige Sessions |
OpenAI hat keine Benchmark-Zahlen für die Verbesserungen bei Transkription oder Zuverlässigkeit veröffentlicht – betrachten Sie sie daher als Herstellerangaben, bis Sie sie selbst messen. Außerdem bezeichnet OpenAIs Ankündigung Standby als neu in dieser Version, während die GPT-Live-1-Seite mittlerweile denselben Standby-Tarif von 0,02 $ aufführt.
Da beide Modelle Endpunkt und Preise teilen, beginnt der Wechsel damit, das model der Session auf gpt-live-1.1 zu setzen. Führen Sie anschließend Ihre eigenen Voice-Evals erneut aus, um die Verbesserungen auf Ihrem Traffic zu bestätigen.
Preise für GPT-Live-1.1
GPT-Live-1.1 rechnet Sprach-Sessions nach Dauer ab, nicht nach Tokens. Dies sind die Tarife auf der Preisseite von OpenAI, geprüft am 20. November 2026:
| Metrik | Preis |
|---|---|
| Aktive Session-Zeit | 0,05 $ pro Minute |
| Standby-Session-Zeit | 0,02 $ pro Minute |
| Backend-Modell und Tools | Separat zu den normalen Tarifen des jeweiligen Modells abgerechnet |
Einige Abrechnungsdetails sind wichtig, wenn Sie Kosten schätzen:
- Abrechnung pro Sekunde. Die Dauer wird nicht auf die nächste volle Minute aufgerundet.
- Standby ist nur mit WebRTC möglich. Der reduzierte Tarif gilt für WebRTC-Sessions, während die Inferenz pausiert ist.
- Initialisierungsgebühr. Beim Erstellen einer WebRTC-Session werden 15 Sekunden abgerechnet, die nach Beginn der Session auf die Dauer-Gebühren angerechnet werden.
- Das Backend ist eine zweite Rechnung. Delegierte Responses-Tokens und Tool-Aufrufe werden ebenfalls berechnet.
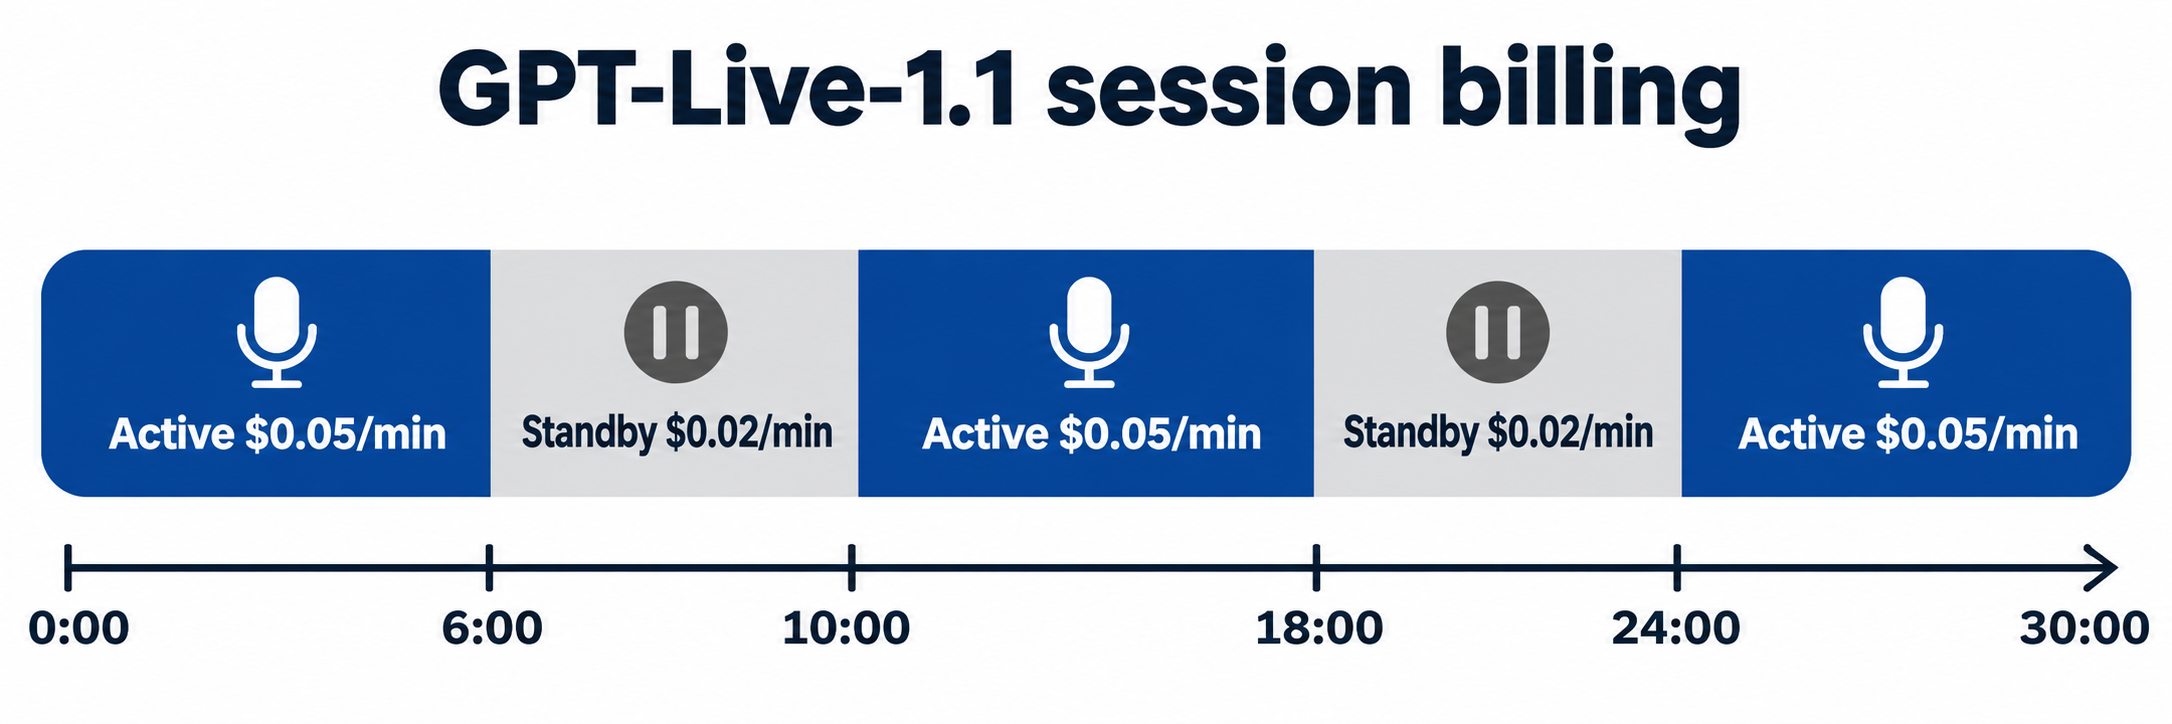
Rechenbeispiel zur obigen Zeitleiste: Eine 30-minütige Support-Session verbringt 20 Minuten aktiv und 10 Minuten im Standby, während der Anrufer etwas nachschlägt. Sprachkosten: 20 × 0,05 $ + 10 × 0,02 $ = 1,20 $. Ohne Standby kostet dieselbe Session 30 × 0,05 $ = 1,50 $. Addieren Sie noch, was das Backend-Modell für seine delegierten Aufgaben ausgibt.
Wie GPT-Live-1.1 funktioniert: Sprache plus Delegation
Eine GPT-Live-Anwendung besteht aus zwei Teilen. Der Einstiegsleitfaden gliedert sie so:
- GPT-Live führt das Gespräch. Es hört zu, spricht und entscheidet, wann es das Backend um Hilfe bitten soll. Sie geben ihm einen kurzen Prompt zum Sprachstil und dazu, wann delegiert werden soll.
- Das Backend übernimmt delegierte Aufgaben. Es reasoningt, ruft Tools auf und liefert Ergebnisse zurück, die GPT-Live laut vorliest. Detaillierte Anweisungen, Geschäftsregeln und Tool-Workflows liegen hier.
- Ihre Anwendung besitzt die risikoreichen Teile. Sie prüft Berechtigungen, sammelt Bestätigungen ein, führt Funktionen aus, die Ihre Systeme berühren, und speichert den Aufgabenfortschritt.
Beim Erstellen der Session wählen Sie einen von zwei Delegationsmodi, und ein Wechsel des Moduls ist innerhalb einer Session nicht möglich:
| Modus | Wer betreibt das Backend | Wann Sie ihn wählen |
|---|---|---|
| Responses-Delegation | OpenAI ruft das von Ihnen konfigurierte Responses-Modell auf und übermittelt Kontext und Ergebnisse | Sie möchten, dass GPT-Live Backend-Anfragen für Sie verwaltet |
| Client-Delegation | Ihre Anwendung betreibt ein beliebiges Modell, einen Agenten oder Dienst und sendet Ergebnisse zurück | Sie müssen Ergebnisse validieren, anonymisieren oder kombinieren, oder ein Nicht-OpenAI-Backend verwenden |
Der Delegationsleitfaden empfiehlt, mit Responses-Delegation zu starten. Client-Delegation eignet sich für Teams, die einen bestehenden Text-Agenten mit einer Sprachschnittstelle versehen möchten.
Erstellen Sie Ihre erste GPT-Live-1.1-Session
GPT-Live hat einen eigenen Endpunkt. Die Modellseite listet v1/live/sessions als unterstützt und markiert Chat Completions, Responses und v1/realtime als nicht unterstützt. OpenAI empfiehlt WebRTC für Audio, mit WebSockets und SIP als Alternativen.
Der WebRTC-Ablauf aus dem Quickstart läuft in fünf Schritten:
- Der Browser fordert Mikrofonzugriff an und fügt seine Tracks zu einer Peer-Verbindung hinzu.
- Er erstellt einen Datenkanal und danach ein SDP-Offer.
- Der Browser sendet das Offer an Ihren Server.
- Ihr Server sendet
sessionundtransport: { type: "webrtc", sdp }per POST anPOST /v1/live/sessions, mit Ihrem API-Schlüssel. - Der Browser wendet die zurückgegebene SDP-Answer an und wartet auf
session.started.
Hier ist der Server-Aufruf aus OpenAIs TypeScript-Beispiel, gekürzt auf die Session-Konfiguration:
const result = await client.live.create({
  session: {
    model: "gpt-live-1.1",
    instructions:
      "Be concise. Delegate requests needing current information to the backend, which can search the web.",
    delegation: {
      type: "responses",
      responses: {
        model: "gpt-5.6-terra",
        instructions:
          "Use web search when current facts are needed. Return concise, grounded results for a spoken conversation.",
        tools: [{ type: "web_search" }],
        tool_choice: "auto",
      },
    },
  },
  transport: { type: "webrtc", sdp: request.body.sdp },
});
Halten Sie den API-Schlüssel auf dem Server und senden Sie kein session.start über den Datenkanal: Die HTTP-Anfrage startet die Session bereits. OpenAI stellt außerdem die OpenAI Live Console bereit, eine lokale Beispiel-App zum Beobachten von Gesprächen, Delegation und Backend-Tool-Aktivität.
Standby-Modus: Leerlaufkosten senken
Standby hält eine WebRTC-Verbindung offen, während niemand spricht, und nimmt die Inferenz wieder auf, sobald jemand spricht. Verbindung und Session-ID bleiben dieselben, und der Gesprächsverlauf ist wieder da, wenn die Session fortgesetzt wird.
Sie aktivieren es mit zwei Session-Feldern:
{
  "session": {
    "model": "gpt-live-1.1",
    "wake_policy": { "type": "speech", "vad_threshold": 0.5 },
    "idle_timeout_s": 20
  }
}
wake_policy.type: "speech"wartet auf Sprache, bevor die Inferenz startet.idle_timeout_snimmt eine ganze Zahl von 5 bis 60. Nach so vielen Sekunden ohne Ein- oder Ausgabetranskript geht die Session in den Standby.vad_thresholdreicht von 0 bis 1 und ist standardmäßig 0,5. Höhere Werte erfordern stärkere Hinweise auf Sprache, um aufzuwachen.
Achten Sie auf session.paused und session.resumed, um den Zustand zu verfolgen, und lassen Sie den Mikrofon-Track aktiv. Ein Kompromiss aus dem Leitfaden zur Session-Verwaltung: Die erste Antwort auf eine kurze Äußerung nach dem Standby kann länger dauern. Bei langen Pausen kann es günstiger sein, die Session zu schließen und eine neue zu starten, statt Standby zu nutzen.
GPT-Live-1.1 vs. GPT-Realtime
OpenAIs Leitfaden zu Voice Agents rahmt die Entscheidung über die Architektur ein. GPT-Live eignet sich für Vollduplex-Gespräche mit separatem Backend. Die Realtime API eignet sich für ein einzelnes Modell, das in einer Session hört, reasoningt, Tools aufruft und spricht.
| GPT-Live-1.1 | GPT-Realtime-2.1 | |
|---|---|---|
| Endpunkt | v1/live/sessions |
v1/realtime |
| Design | Sprach-Frontend plus delegiertes Backend | Ein Speech-to-Speech-Modell |
| Eingabe | Audio, Text | Text, Audio, Bild |
| Abrechnung | 0,05 $/min aktiv, 0,02 $/min Standby | Pro Token: 32 $ rein, 64 $ raus pro 1M Audio-Tokens |
| Backend-Kosten | Separat abgerechnet | Im Token-Preis enthalten |
| Am besten für | Sprache zu einem bestehenden Text-Agenten hinzufügen | In sich geschlossene Sprach-Agenten |
Die Abrechnung pro Minute macht die Sprachkosten von GPT-Live bei langen Anrufen leicht vorhersehbar. Die Token-Abrechnung bei Realtime hängt davon ab, wie viel Audio und Text fließt, und bündelt das Reasoning in einem Preis. Für einen tieferen Blick auf den früheren Vergleich siehe GPT-Live vs. GPT-Realtime und unseren GPT-Realtime-2-API-Leitfaden.
Rate Limits und Zugang
Die Limits von GPT-Live zählen gleichzeitige Sessions, nicht Tokens. GPT-Live-1.1 und GPT-Live-1 haben separate Limits, die über Inferenz-Regionen hinweg gelten. Die GPT-Live-1-Seite listet 50 gleichzeitige Sessions im Build-Tier, 300 bei Launch und 500 bei Grow auf und markiert den Free-Tier als nicht unterstützt. Die GPT-Live-1.1-Seite veröffentlicht noch keine eigene Tabelle – prüfen Sie daher vor der Lastplanung die Limits-Seite Ihrer Organisation.
Testen Sie Ihren Session-Server mit Apidog CLI
Ihre GPT-Live-Integration hat eine HTTP-Oberfläche, die Sie besitzen: den /api/session-Endpunkt, der SDP-Offer-Austausch ermöglicht. OpenAIs Beispiel liefert 403 bei einem unerwarteten Origin und 400 bei fehlendem SDP-Offer. Diese Pfade erreichen OpenAI nie, sodass Sie sie bei jedem Commit zu null Sprachkosten testen können. Lassen Sie Ihren Coding-Agent die Tests mit Apidog CLI schreiben und ausführen.
Installieren Sie die CLI, melden Sie sich an und fügen Sie Ihrem Agenten die Apidog-Skill hinzu:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Geben Sie Ihrem Agenten dann einen Prompt:
In Apidog project <projectId>, add POST /api/session for my GPT-Live-1.1 server.
Create test cases that assert: a request with a wrong Origin header returns 403,
a request with no sdp field returns 400. Run them against the local environment
and summarize any failures.
Der Agent liest die Schemas, validiert seine Payloads, erstellt Endpunkt und Testfälle und führt sie aus:
apidog cli-schema get endpoint-create
apidog endpoint create --project <projectId> --file ./endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case.json
apidog test-case create --project <projectId> --file ./case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
Derselbe apidog run-Befehl mit -r junit lässt sich in CI integrieren; siehe Apidog CLI in einer CI/CD-Pipeline ausführen. Wenn Sie Claude Code verwenden, führt Sie der Leitfaden zu Apidog CLI in Claude Code durch die Einrichtung. Apidogs Free-Plan deckt Teams von bis zu 4 Nutzern ab.
FAQ
Ist GPT-Live-1.1 in der API verfügbar? Ja. OpenAI hat GPT-Live-1.1 am 20. November 2026 in der API verfügbar gemacht, mit der Modell-ID gpt-live-1.1 über den Endpunkt v1/live/sessions. Unser früherer Beitrag zur GPT-Live-API stammt noch von vor dieser Veröffentlichung.
Wie viel kostet GPT-Live-1.1? 0,05 $ pro aktiver Minute und 0,02 $ pro Standby-Minute, sekundengenau abgerechnet. Backend-Modell und Tool-Nutzung werden separat zu ihren normalen Tarifen berechnet.
Was ist der Unterschied zwischen GPT-Live-1 und GPT-Live-1.1? GPT-Live-1.1 transkribiert Sprache genauer, hält Akzent und Stimme über Sprachen hinweg konsistenter und bietet eine Standby-Option für Leerlauf-Sessions. Preise und Endpunkt sind gleich.
Kann GPT-Live-1.1 Bilder sehen? Nicht direkt. Senden Sie Bilder an ein vision-fähiges Backend-Modell, das Text zurückgibt, den GPT-Live verwenden kann.
Unterstützt GPT-Live-1.1 Function Calling? Ja. Die Modellseite listet Streaming und Function Calling auf. In der Praxis behandelt Ihr Backend die Tool-Aufrufe per Delegation, und Ihre Anwendung führt die benutzerdefinierten Funktionen aus.