
Die günstigste Stufe in einer Modellfamilie war früher die Stufe, der man nicht vertraute. Man schickte Klassifizierungs-, Zusammenfassungs- und Wiederholungsverkehr dorthin, behielt alles Agenten-basierte auf dem Flaggschiff und akzeptierte, dass das Budget-Modell zusammenbrechen würde, sobald eine Aufgabe mehr als einen Schritt erforderte.
GPT-6 Luna, angekündigt am 22. September 2026, ist wie diese Stufe bepreist und verhält sich nicht so. Es kostet 0,10 $ pro Million Eingabe-Tokens und 0,50 $ pro Million Ausgabe-Tokens, es verfügt über ein Kontextfenster von 1 Million Tokens, und die von OpenAI veröffentlichten Zahlen platzieren es im Bereich der Grenzmodelle bei agentenbasierten Coding-Benchmarks zu einem Bruchteil ihrer Kosten pro Aufgabe.
Eines zuerst klargestellt: Dies ist nicht das GPT-5.6 Luna, das Sie möglicherweise bereits in eine Fallback-Kette integriert haben. Gleicher Stufenname, neues Modell, neuer Preis, neues Kontextfenster. Das Gegenteil anzunehmen ist ein einfacher Weg, eine lautlose Verhaltensänderung auszuliefern und dies erst über ein Support-Ticket herauszufinden.
GPT-6 Luna auf einen Blick
| Position | Wert |
|---|---|
| API-Modell-ID | gpt-6-luna |
| Eingabepreis | 0,10 $ pro Million Tokens |
| Ausgabepreis | 0,50 $ pro Million Tokens |
| Gecachte Eingabelesevorgänge | 90 % Rabatt |
| Kontextfenster | 1.000.000 Tokens |
| Artificial Analysis Intelligence Index | 37 |
| Angekündigt | 22. September 2026, zusammen mit GPT-6 Sol |
| Verfügbar in | ChatGPT Work und Codex, die Desktop-App für Free- und Go-Benutzer, plus die API |
| Nicht verfügbar in | Chat, zum Zeitpunkt der Markteinführung |
Innerhalb derselben Familie kostet GPT-6 Sol 2 $/10 $ mit einem 872.000-Token-Fenster und einem Index von 48, und GPT-6 Astra kostet 10 $/50 $. OpenAI gibt an, dass Astra „weiterhin unser bestes Modell auf ganzer Linie ist“, daher wird Luna nicht als das intelligenteste Modell verkauft. Es wird als das Modell verkauft, bei dem die Kosten pro Aufgabe drastisch gesunken sind.
Es ist ein neues Modell, keine umbenannte Stufe
Die GPT-5.6-Familie bestand aus Sol, Terra und Luna. Die GPT-6-Familie besteht aus Astra, Sol und Luna. Zwei Namen wurden übernommen, Terra nicht, und Astra ist neu. OpenAI beschreibt Sol und Luna als mit ähnlichen Methoden wie GPT-6 Astra trainiert, was bedeutet, dass es sich um neue Modelle handelt, die eine Namenskonvention mit den alten teilen.
Es gibt kein GPT-6 Terra. Wenn Sie eine Routing-Struktur um das GPT-5.6-Namensschema herum aufgebaut haben, existiert die mittlere Sprosse nicht mehr, und unser früherer Vergleich von Sol mit Terra und Luna liest sich jetzt eher als Geschichte denn als aktuelle Anleitung.
Die Preisentwicklung zeigt, wie weit sich die Stufe verschoben hat:
| Stufe | GPT-5.6 Liste | GPT-5.6 Aktionspreis | GPT-6 |
|---|---|---|---|
| Sol | 5 $ / 30 $ | 4 $ / 20 $ | 2 $ / 10 $ |
| Terra | 2,50 $ / 15 $ | 2 $ / 12 $ | kein GPT-6 Terra |
| Luna | 1 $ / 6 $ | 0,20 $ / 1,20 $ | 0,10 $ / 0,50 $ |
Alle Angaben beziehen sich auf eine Million Eingabe-Tokens und eine Million Ausgabe-Tokens. Die GPT-5.6-Zeilen stammen aus unserer damaligen Berichterstattung, GPT-5.6-Preise und der GPT-5.6-Preissenkung.
OpenAI beschreibt Sol und Luna als 50 % günstiger als die **Aktionspreise** von GPT-5.6. Das Wort 'Aktionspreise' stammt von OpenAI selbst und ändert die Bedeutung der Behauptung: Der Vergleich bezieht sich auf einen reduzierten Preis, nicht auf den Einführungspreis von GPT-5.6. Gemessen am Listenpreis von GPT-5.6 Luna von 1 $/6 $ stellt GPT-6 Luna mit 0,10 $/0,50 $ eine Senkung von 90 % bei den Eingaben und 92 % bei den Ausgaben dar. Die tatsächliche Reduzierung ist größer als die Schlagzeile, und die Schlagzeile basiert auf einem Rabatt. Verwenden Sie die zweite Zahl in Ihrem Budgetmodell, nicht die erste.
Das günstige Modell hat das größere Kontextfenster
Dies ist das Detail, das die meisten Berichterstattungen zur Einführung übersprungen haben. Luna wird mit einem Kontextfenster von 1.000.000 Tokens ausgeliefert. Sol, zum zwanzigfachen Preis, wird mit 872.000 ausgeliefert.
Das kehrt eine Annahme um, die viele Routing-Codes beinhalten: dass man eine Anfrage an ein teureres Modell weiterleitet, wenn die Nutzlast wächst. Bei GPT-6 befindet sich das größte Fenster der Familie am unteren Ende der Preisliste. Ein Dokument mit 900.000 Tokens passt nicht in Sol, aber in Luna.
Die Arithmetik ergibt sich aus den beiden Preisen. Das einmalige Füllen von Lunas vollem Fenster kostet 0,10 $ an Eingabe-Tokens. Das einmalige Füllen von Sols 872.000-Token-Fenster kostet ungefähr 1,74 $. Das Füllen von Claude Opus 5.5s 1M-Fenster zu 4 $ pro Million kostet 4,00 $. Dieselbe Nutzlastklasse, eine vierzigfache Spanne bei dem, was Sie für das Lesen bezahlen.
Berücksichtigt man OpenAIs Caching-Arbeit, vergrößert sich die Lücke erneut. GPT-6 gewährt einen Rabatt von 90 % auf gecachte Eingabelesevorgänge, sodass ein 1M-Token-Präfix, das über mehrere Aufrufe hinweg gecacht bleibt, etwa 0,01 $ anstatt 0,10 $ für das erneute Lesen kostet. OpenAI gibt außerdem an, dass GPT-6 standardmäßig höhere Cache-Trefferquoten erzielt, dass eine Änderung des Denkaufwands oder der Werkzeugverfügbarkeit den Cache nicht mehr ungültig macht und dass explizite Haltepunkte es Ihnen ermöglichen, zu steuern, wo ein gecachtes Präfix endet. GitHub meldet mehr als 50 % weniger Prompt-Tokens, die über Milliarden von Anfragen hinweg eine neue Verarbeitung benötigen.
Was OpenAI veröffentlichte
Jede Zahl unten stammt aus OpenAIs Startmaterial. Einstellungen für den Denkaufwand erscheinen in Klammern, da diese Modelle bei unterschiedlichen Anstrengungsniveaus sehr unterschiedlich abschneiden und eine Benchmark-Zeile ohne ihre Anstrengungseinstellung keine brauchbare Zahl ist.
| Benchmark | GPT-6 Luna | Vergleichspunkt |
|---|---|---|
| DeepSWE 1.1 | 66,6 % (max) | Vergleichbar mit Claude Opus 5 und Claude Fable 5 auf mittlerem Niveau, 93 % günstiger pro Aufgabe als Opus 5 und 96 % günstiger als Fable 5 |
| AutomationBench 1.0.6 | Übertrifft seinen Vorgänger um 5,4 Punkte (hoch) | Zu 58 % geringeren Kosten pro Aufgabe |
| OSWorld 2.0 offline | Übertrifft GPT-5.6 Sol (mittel) bei maximalem Aufwand | Zu etwa einem Zehntel der Kosten |
| Faktizität | Entspricht GPT-5.6 Sol bei höherem Aufwand | Zu etwa einem Hundertstel der Kosten |
Die DeepSWE-Zeile ist diejenige, die man genauer betrachten sollte. Ein Modell, das für 0,10 $ pro Million Eingabe-Tokens bei einem agentenbasierten Software-Engineering-Benchmark 66,6 % erreicht, im gleichen Bereich wie zwei Grenzmodelle mit mittlerem Aufwand, und das 93 % weniger pro Aufgabe kostet als eines davon, ist ein anderes Angebot als eine Budget-Stufe. Das bedeutet nicht, dass Luna ein Grenzmodell bei Ihrer anspruchsvollsten Arbeit ersetzt. Es bedeutet vielmehr, dass sich die Grenze zwischen „Dies an das günstige Modell weiterleiten“ und „Dies erfordert das teure Modell“ verschoben hat, und wo immer Sie diese Linie vor September 2026 gezogen haben, ist sie jetzt falsch gezeichnet.
Das Faktizitätsergebnis ist dasjenige, das für die normale Produktarbeit am wichtigsten sein dürfte. Die Übereinstimmung mit der mittleren Stufe der vorherigen Generation bei der faktischen Genauigkeit, zu etwa einem Hundertstel ihrer Kosten, macht Luna für benutzerorientierte Zusammenfassungen und Extraktionen brauchbar, anstatt nur für interne Batch-Jobs.
Jeder Vergleich hier ist gegen Claude Opus 5
Beachten Sie, gegen welches Claude-Modell diese Zeilen im Benchmark verglichen werden. Claude Opus 5.
Anthropic lieferte Claude Opus 5.5 am selben Tag aus, zu 4 $/20 $ gegenüber Opus 5s 5 $/25 $, und es belegte den Spitzenplatz im Artificial Analysis Intelligence Index mit 58, auf Platz eins von 212 Modellen. OpenAIs Veröffentlichungsbeitrag wurde verfasst, bevor Opus 5.5 existierte, sodass jeder Kosten-pro-Aufgabe-Vergleich mit Opus 5 gegen ein Modell gemessen wird, das innerhalb von Stunden nach der Veröffentlichung abgelöst wurde.
Das macht OpenAIs Zahlen nicht falsch. Sie sind genau für den durchgeführten Vergleich. Es bedeutet jedoch, dass Sie „93 % günstiger als Opus 5“ nicht als aktuellen Stand des Marktes in ein Beschaffungsdokument übernehmen sollten, ohne anzugeben, auf welches Opus es sich bezieht. Kein Anbieter hat einen direkten Vergleich von Luna mit Opus 5.5 veröffentlicht, und die in sozialen Medien kursierenden Vergleiche stammen von einzelnen Testern und nicht von einem der Labore. Unsere Preiskampf-Übersicht verfolgt alle drei Markteinführungen in einer Tabelle gegeneinander.
Latenz: Das günstige Modell ist nicht das schnelle Modell
Drittanbieter-Messungen von Artificial Analysis beziffern GPT-6 Luna auf 153,9 Ausgabe-Tokens pro Sekunde mit einer Zeit bis zum ersten Token von 124,23 Sekunden. Zwei Vorbehalte gelten, und beide sind wesentlich. Dies sind Zahlen von Drittanbietern, nicht vom Hersteller veröffentlicht. Und sie wurden an der Variante mit maximalem Denkaufwand gemessen, der langsamsten und teuersten verfügbaren Konfiguration.
Selbst mit beiden Vorbehalten ist die Tendenz beachtenswert: Luna ist langsamer beim ersten Token als Sol, das bei 102,15 Sekunden liegt. Preis und Latenz korrelieren in dieser Familie nicht. Eine zweiminütige Wartezeit, bevor das erste Token ankommt, wird ein Standard-HTTP-Client-Timeout unterbrechen, einen Load Balancer in den Leerlauf versetzen und die Ausführungsobergrenze der meisten Serverless-Laufzeiten überschreiten. Wenn Sie einen synchronen Endpunkt mit hohem Aufwand an Luna leiten, liegt die Integrationsarbeit in Ihrer Timeout- und Streaming-Schicht, nicht in Ihrem Prompt.
Testen Sie es mit Ihrer eigenen Arbeitslast, bevor Sie es dorthin leiten
Benchmark-Tabellen sind aggregiert. Ihr Prompt ist es nicht. Die nützliche Frage ist, ob Luna Ihre Anforderungen bei einem vertretbaren Aufwand bewältigt, und diese Frage lässt sich in etwa zehn Minuten richtig beantworten.
Richten Sie eine Anfrage pro Modell ein, parametrisieren Sie die Modell-ID und führen Sie dieselbe Nutzlast über die Stufe hinweg aus:
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "Extract every endpoint, method and required parameter from the OpenAPI document below as JSON.",
    "reasoning": { "effort": "high" }
  }'
Bestätigen Sie die Endpunkt- und Parameternamen anhand der aktuellen Modellreferenz von OpenAI, bevor Sie auf dieser Struktur aufbauen. Die Modell-ID gpt-6-luna ist der Teil, der aus dem Startmaterial bestätigt wird.
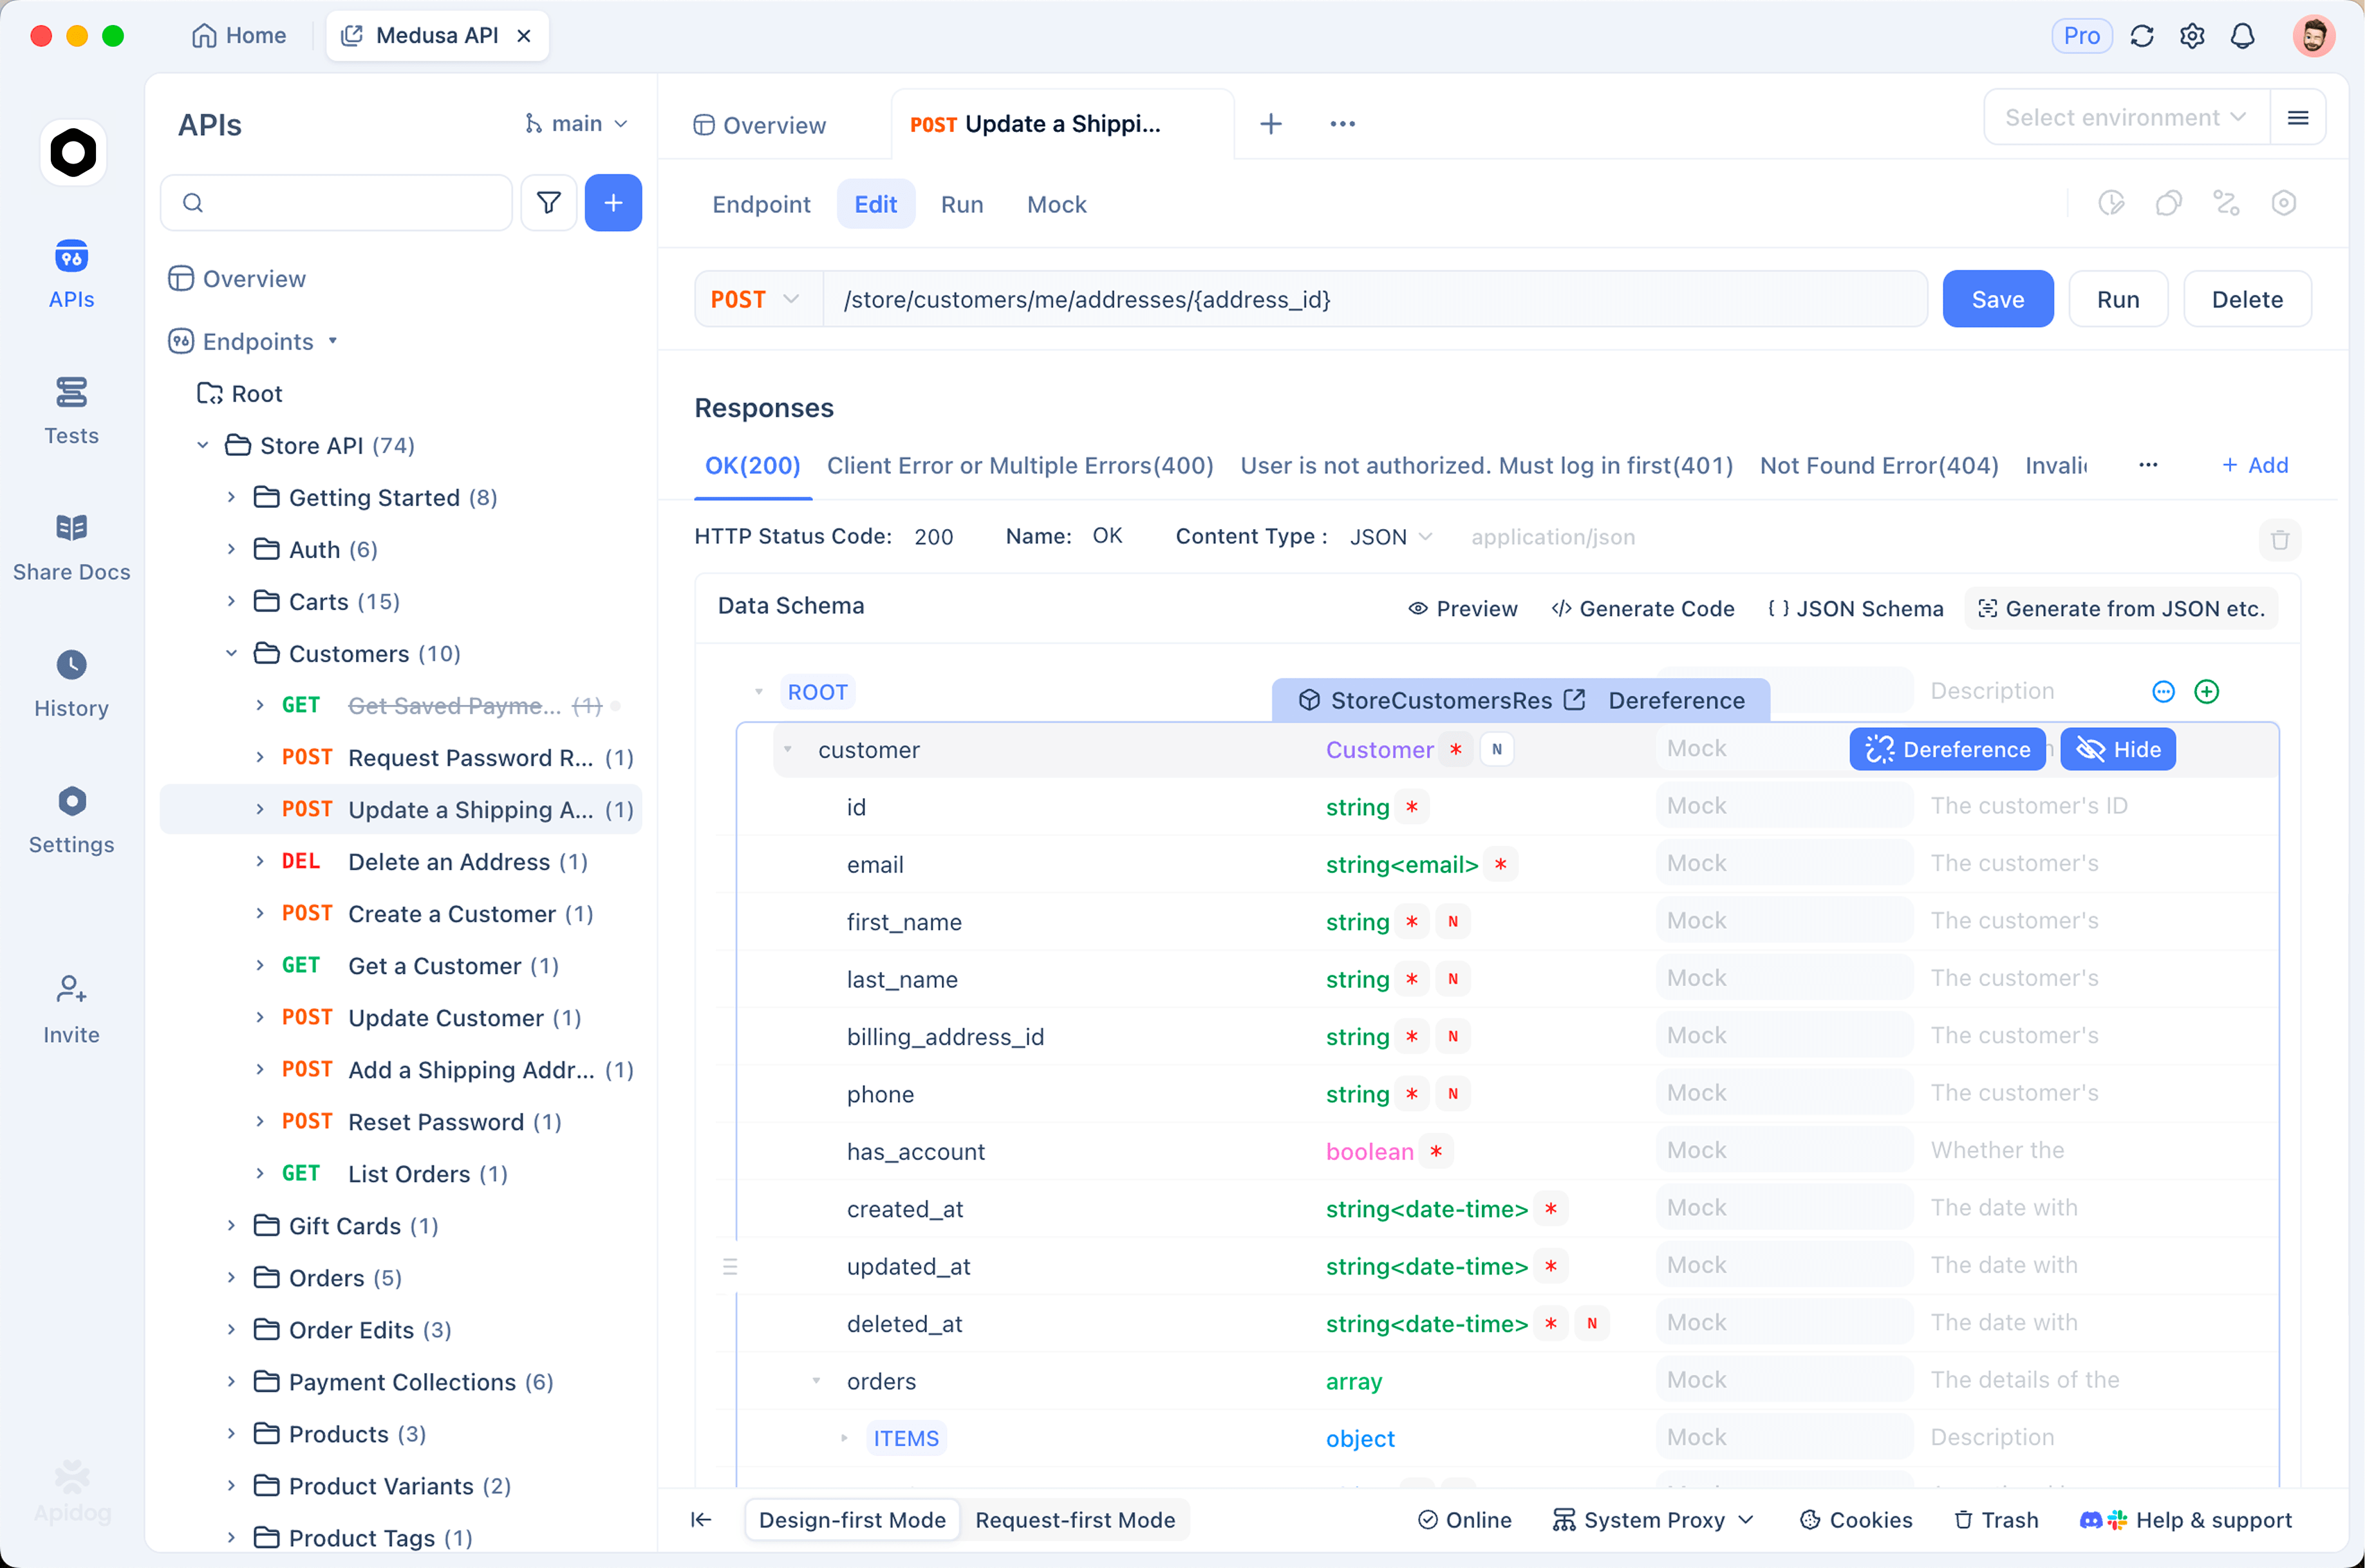
In Apidog wird dieselbe Anfrage zu einem gespeicherten Endpunkt mit der Modell-ID als Umgebungsvariable, sodass eine einzige Sammlung Luna, Sol und Astra abdeckt, ohne etwas zu duplizieren. Führen Sie es als Testszenario aus, und Sie erhalten die Antwortzeit und Token-Nutzung pro Ausführung, plus Zusicherungen zur Antwortform, die den tatsächlichen Fehlerfall eines günstigeren Modells aufdecken: nicht eine falsche Antwort, sondern eine Antwort, die nicht mehr dem JSON-Schema entspricht, das Ihr Parser erwartet. Führen Sie dasselbe Szenario auf drei Anstrengungsniveaus aus, und Sie erhalten eine Kosten-, Latenz- und Zuverlässigkeitstabelle für Ihre eigenen Prompts anstelle der Benchmark-Suite eines anderen.
Wann Luna die richtige Wahl ist
Leiten Sie Anfragen an Luna weiter, wenn die Nutzlast groß ist, die Aufgabe gut spezifiziert ist und Sie die Ausgabe programmatisch überprüfen können. Dokumentenextraktion, Spezifikationsanalyse, Log-Triage, Testgenerierung, Klassifizierung großer Mengen und jeder Batch-Job, bei dem ein 1M-Fenster eine Chunking-Pipeline überflüssig macht, kommen alle in Frage, und der Caching-Rabatt verstärkt sich, wenn ein langes Präfix über mehrere Aufrufe hinweg stabil bleibt.
Behalten Sie die teure Stufe für Arbeiten bei, bei denen Sie die Antwort nicht günstig überprüfen können, und für alles, was latenzempfindlich ist, bis Sie die Zeit bis zum ersten Token bei Ihrem eigenen Traffic gemessen haben. Luna hat die Grenze verschoben. Es hat sie nicht ausgelöscht.