
Gemini 4 Neon ist Googles neues Mittelklasse-Modell der Gemini-4-Familie, veröffentlicht am 18. November 2026, für komplexe Programmieraufgaben, Analysen und Enterprise-Workflows mit hoher Lauf Frequenz. Es kostet 3 $ pro Million Eingabe-Tokens und 15 $ pro Million Ausgabe-Tokens, teilt sich ein Kontextfenster von 1M Tokens mit seiner Ausgabe, bietet vier Thinking-Level und ist ausschließlich über die kostenpflichtige Gemini-API-Stufe verfügbar.
Wenn Hydrogen für Ihre schwierigen Aufgaben zu leichtgewichtig ist und Carbon zu teuer, um es den ganzen Tag laufen zu lassen, ist Neon Googles Antwort. Hier finden Sie, was neu ist, wo das Modell einzuordnen ist und was noch unklar bleibt.
Was ist Gemini 4 Neon?
Gemini 4 Neon (gemini-4-neon) ist die Ausgleichsstufe von Googles Gemini-4-Familie. Google beschreibt es als „Intelligenz auf Frontier-Niveau mit schneller End-to-End-Aufgabenerledigung" für Softwareentwicklung, Wissensarbeit und Wissenschaft. Es positioniert sich zwischen Gemini 4 Hydrogen, dem schnellen Alltagsmodell, und Gemini 4 Carbon, dem Modell für Ihre anspruchsvollsten Projekte mit langem Horizont.
Die wichtigsten Fakten, aus Googles Launch-Beitrag und der AI-Studio-Modellseite:
| Spezifikation | Gemini 4 Neon |
|---|---|
| Modell-ID | gemini-4-neon (stabil) |
| Veröffentlicht | 18. November 2026 |
| Eingabe | Text, Bild, Video, Audio, PDF |
| Ausgabe | Nur Text |
| Kontextfenster | 1.048.576 Tokens, von Ein- und Ausgabe gemeinsam genutzt |
| Maximale Ausgabe | 65.536 pro Anfrage, bis zu 1.048.576 mit Long Decode |
| Thinking-Level | low, medium, high (Standard), xhigh |
| Preis (Standard) | 3,00 $ Eingabe, 15,00 $ Ausgabe pro 1M Tokens |
| Gecachte Eingabe | 0,15 $ pro 1M Tokens (nur implizites Caching) |
| Kostenlose API-Stufe | Nein |
Es unterstützt Function Calling, strukturierte Ausgaben, Code-Ausführung, Computer Use, Dateisuche, URL-Kontext sowie Grounding mit Google Search und Google Maps. Es erzeugt keine Bilder oder Audio und ist nicht über die Live API verfügbar.
Gemini 4 Neon vs. Carbon vs. Hydrogen
Kurz zusammengefasst: Hydrogen für Volumen, Neon für komplexe Aufgaben, die häufig laufen, Carbon für die schwierigsten Einzelprobleme. Googles Leitfaden What’s new in Gemini 4 Neon formuliert es so: Nutzen Sie Neon für komplexe Engineering- und Analysearbeit, Carbon für Ihre anspruchsvollsten Architektur-, Debugging-, Wissenschafts- und Sicherheitsprobleme, und behalten Sie Hydrogen als Standard für alltägliche Programmier- und Agentenaufgaben.
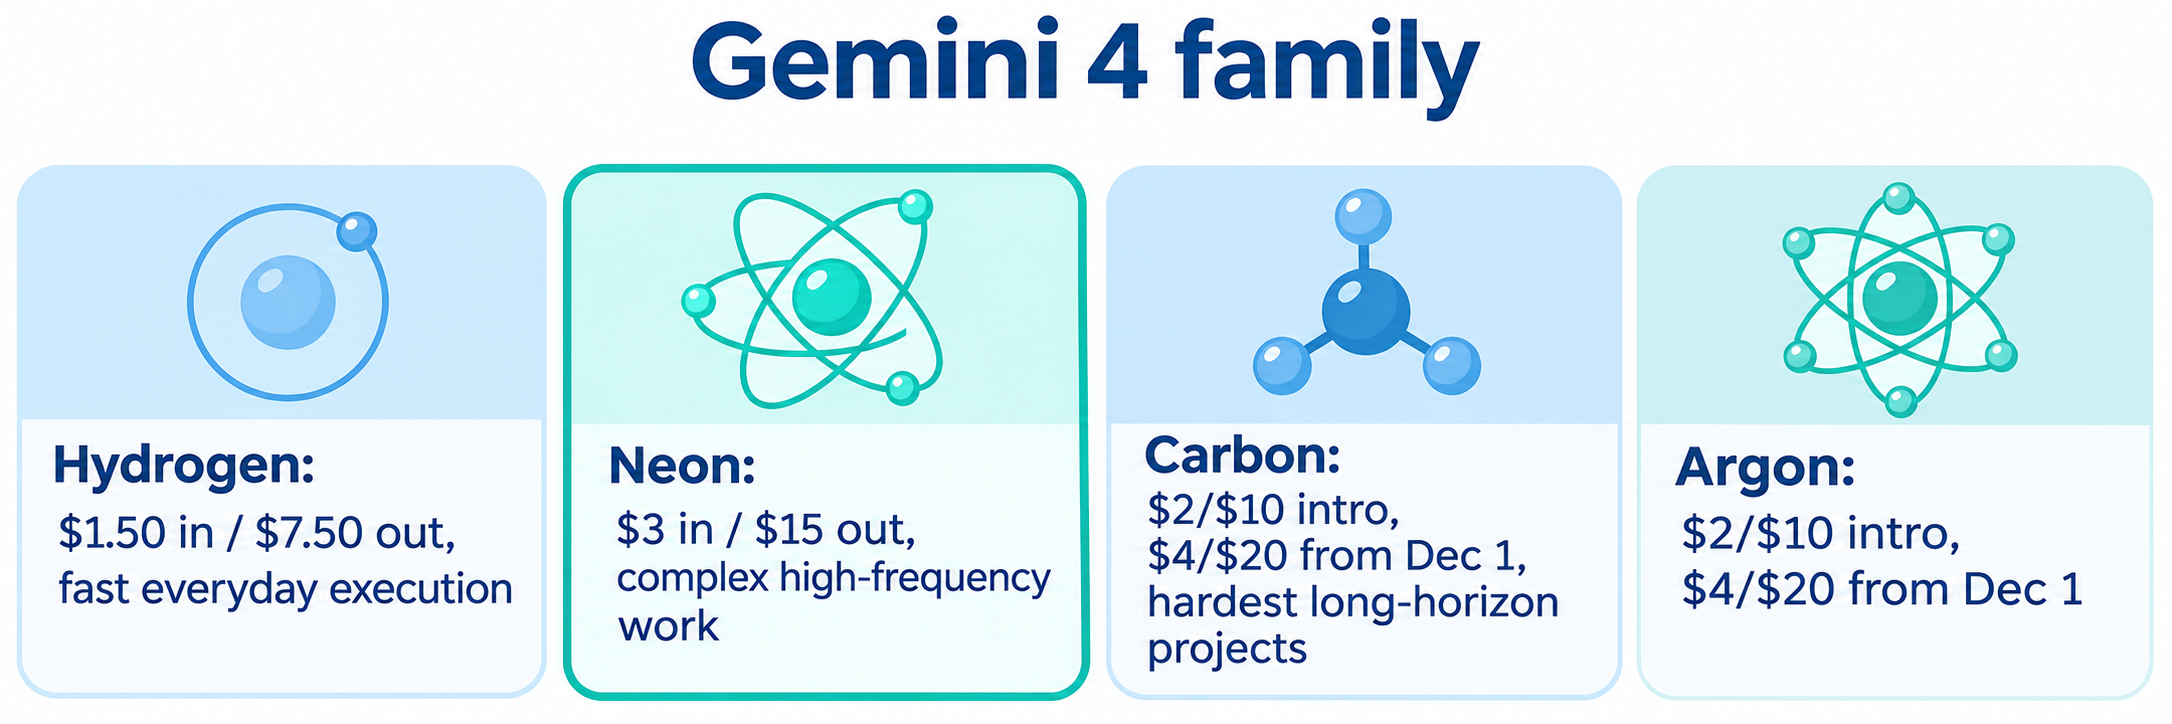
| Modell | Eingabe/Ausgabe pro 1M Tokens | Am besten geeignet für |
|---|---|---|
| Gemini 4 Hydrogen | 1,50 $ / 7,50 $ | Schnelles tägliches Programmieren und Agentenschritte |
| Gemini 4 Neon | 3,00 $ / 15,00 $ | Komplexe, häufige Programmier- und Analyseaufgaben |
| Gemini 4 Carbon | 2 $ / 10 $ Einführungspreis, 4 $ / 20 $ ab 1. Dezember | Anspruchsvollste Projekte mit langem Horizont |
| Gemini 4 Argon | 2 $ / 10 $ Einführungspreis, 4 $ / 20 $ ab 1. Dezember | Früheres Gemini-4-Frontier-Modell |
Die Preisgestaltung wirkt noch einige Tage seltsam. Bis zum 30. November liegt Carbons Einführungspreis unter Neons Listenpreis. Ab dem 1. Dezember verdoppelt sich Carbons Preis auf 4 $/20 $ (siehe unsere Preis-Analyse zu Gemini 4 Carbon), und Neon wird das günstigere der beiden Modelle pro Token.
Der Preis pro Token ist aber nicht die ganze Geschichte. Google gibt an, dass Neon auf high 32 % weniger pro Aufgabe kostet als Carbon, weil es mit weniger Schritten fertig wird. Artificial Analysis hat rund 17 % geringere Kosten pro Aufgabe gemessen. Testen Sie Ihre eigenen Prompts, bevor Sie einer der beiden Zahlen vertrauen.
Gemini 4 Neon Thinking-Level
Das Thinking-Level ist Ihr wichtigster Regler für Qualität, Latenz und Kosten. Neon ist standardmäßig auf high eingestellt, und Google empfiehlt, dort zu beginnen:
low: wenige Tokens und niedrigste Latenz, für schnelle Chats und High-Throughput-Verarbeitung.medium: interaktives Programmieren, Live-UI-Prototyping und latenzempfindliche Tool-Aufrufe.high(Standard): komplexe Programmierung, Agentenausführung, Tool Calling und multimodale Wissensarbeit.xhigh: die schwierigsten mehrstufigen Engineering-, Analyse- und wissenschaftlichen Probleme, mit höherer Latenz und höherem Tokenverbrauch.
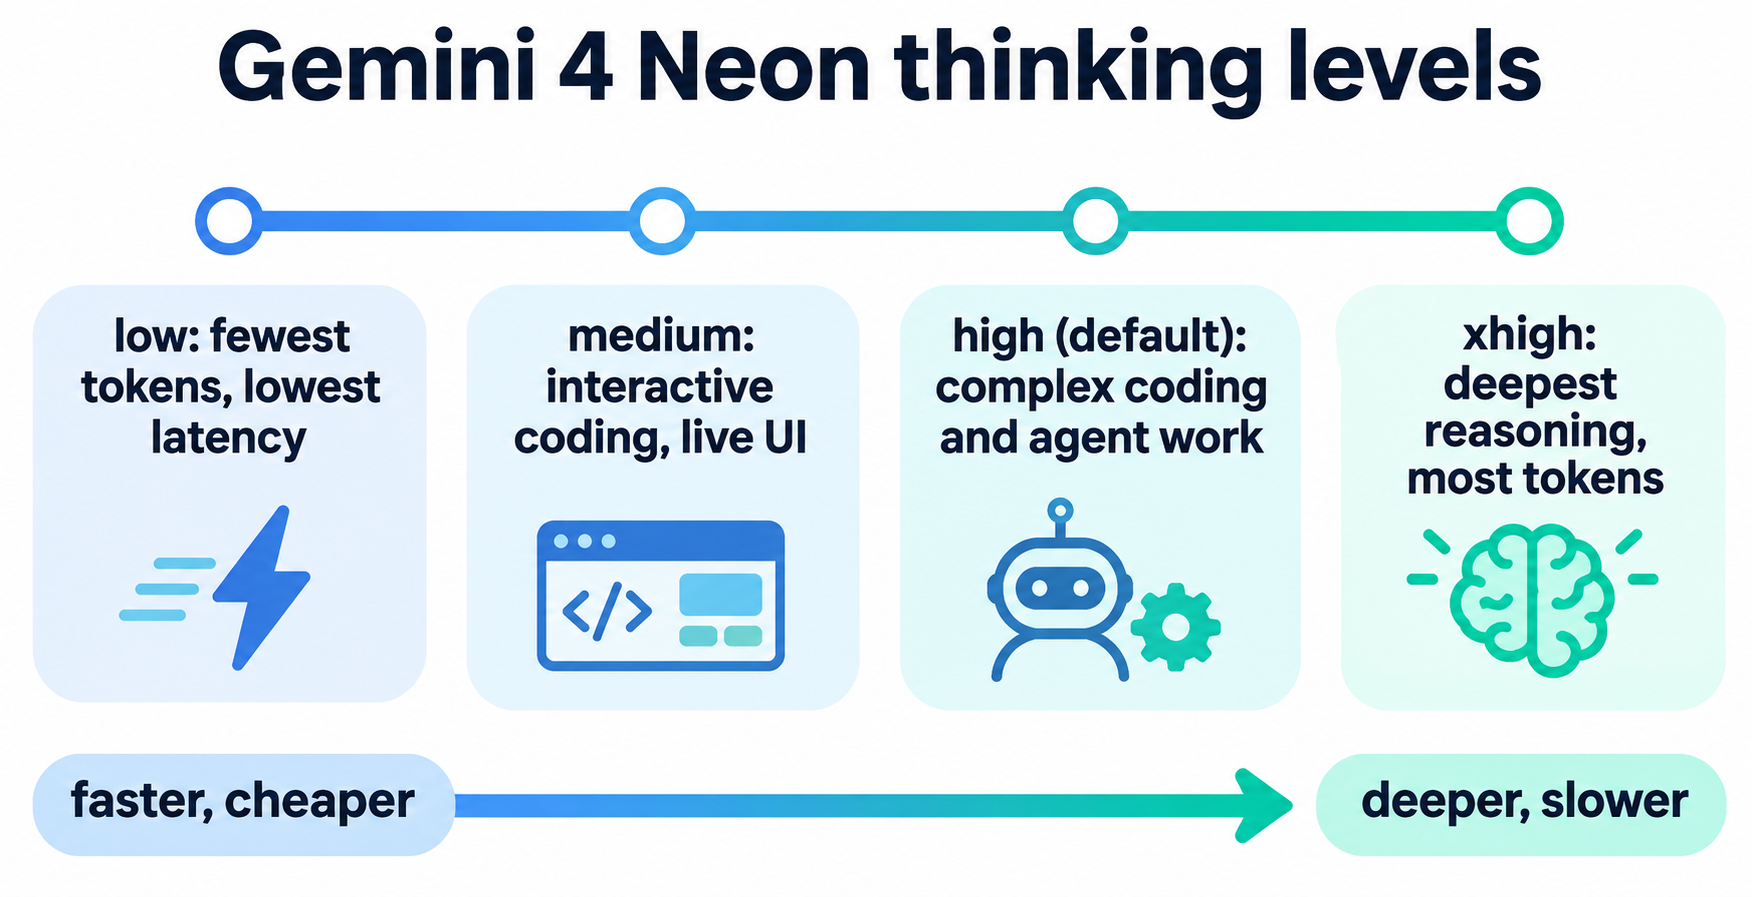
Googles Empfehlung: Bewerten Sie alle vier Level mit einem hohen max_output_tokens-Wert und wählen Sie dann das niedrigste Level, das Ihre Anforderungen erfüllt. Thinking-Tokens werden als Ausgabe mit 15 $ pro Million abgerechnet.
Zwei Migrationsfallen aus dem Google-Cloud-Entwicklerleitfaden: Das MINIMAL-Level älterer Flash-Modelle wird nicht unterstützt, und der alte Parameter thinking_budget liefert einen HTTP 400 zurück, statt stillschweigend gemappt zu werden. Benutzerdefinierte Werte für temperature, top_k und top_p werden ignoriert, und frequency_penalty oder presence_penalty führen zu einem 400-Fehler.
Gemini 4 Neon Benchmarks
Alle folgenden Zahlen stammen aus Googles Launch-Beitrag, der sich auf mehrere unabhängige Bestenlisten bezieht. Eigene Tests mit Ihrer Arbeitslast sind wichtiger, aber diese Zahlen zeigen, wo Google das Modell positioniert:
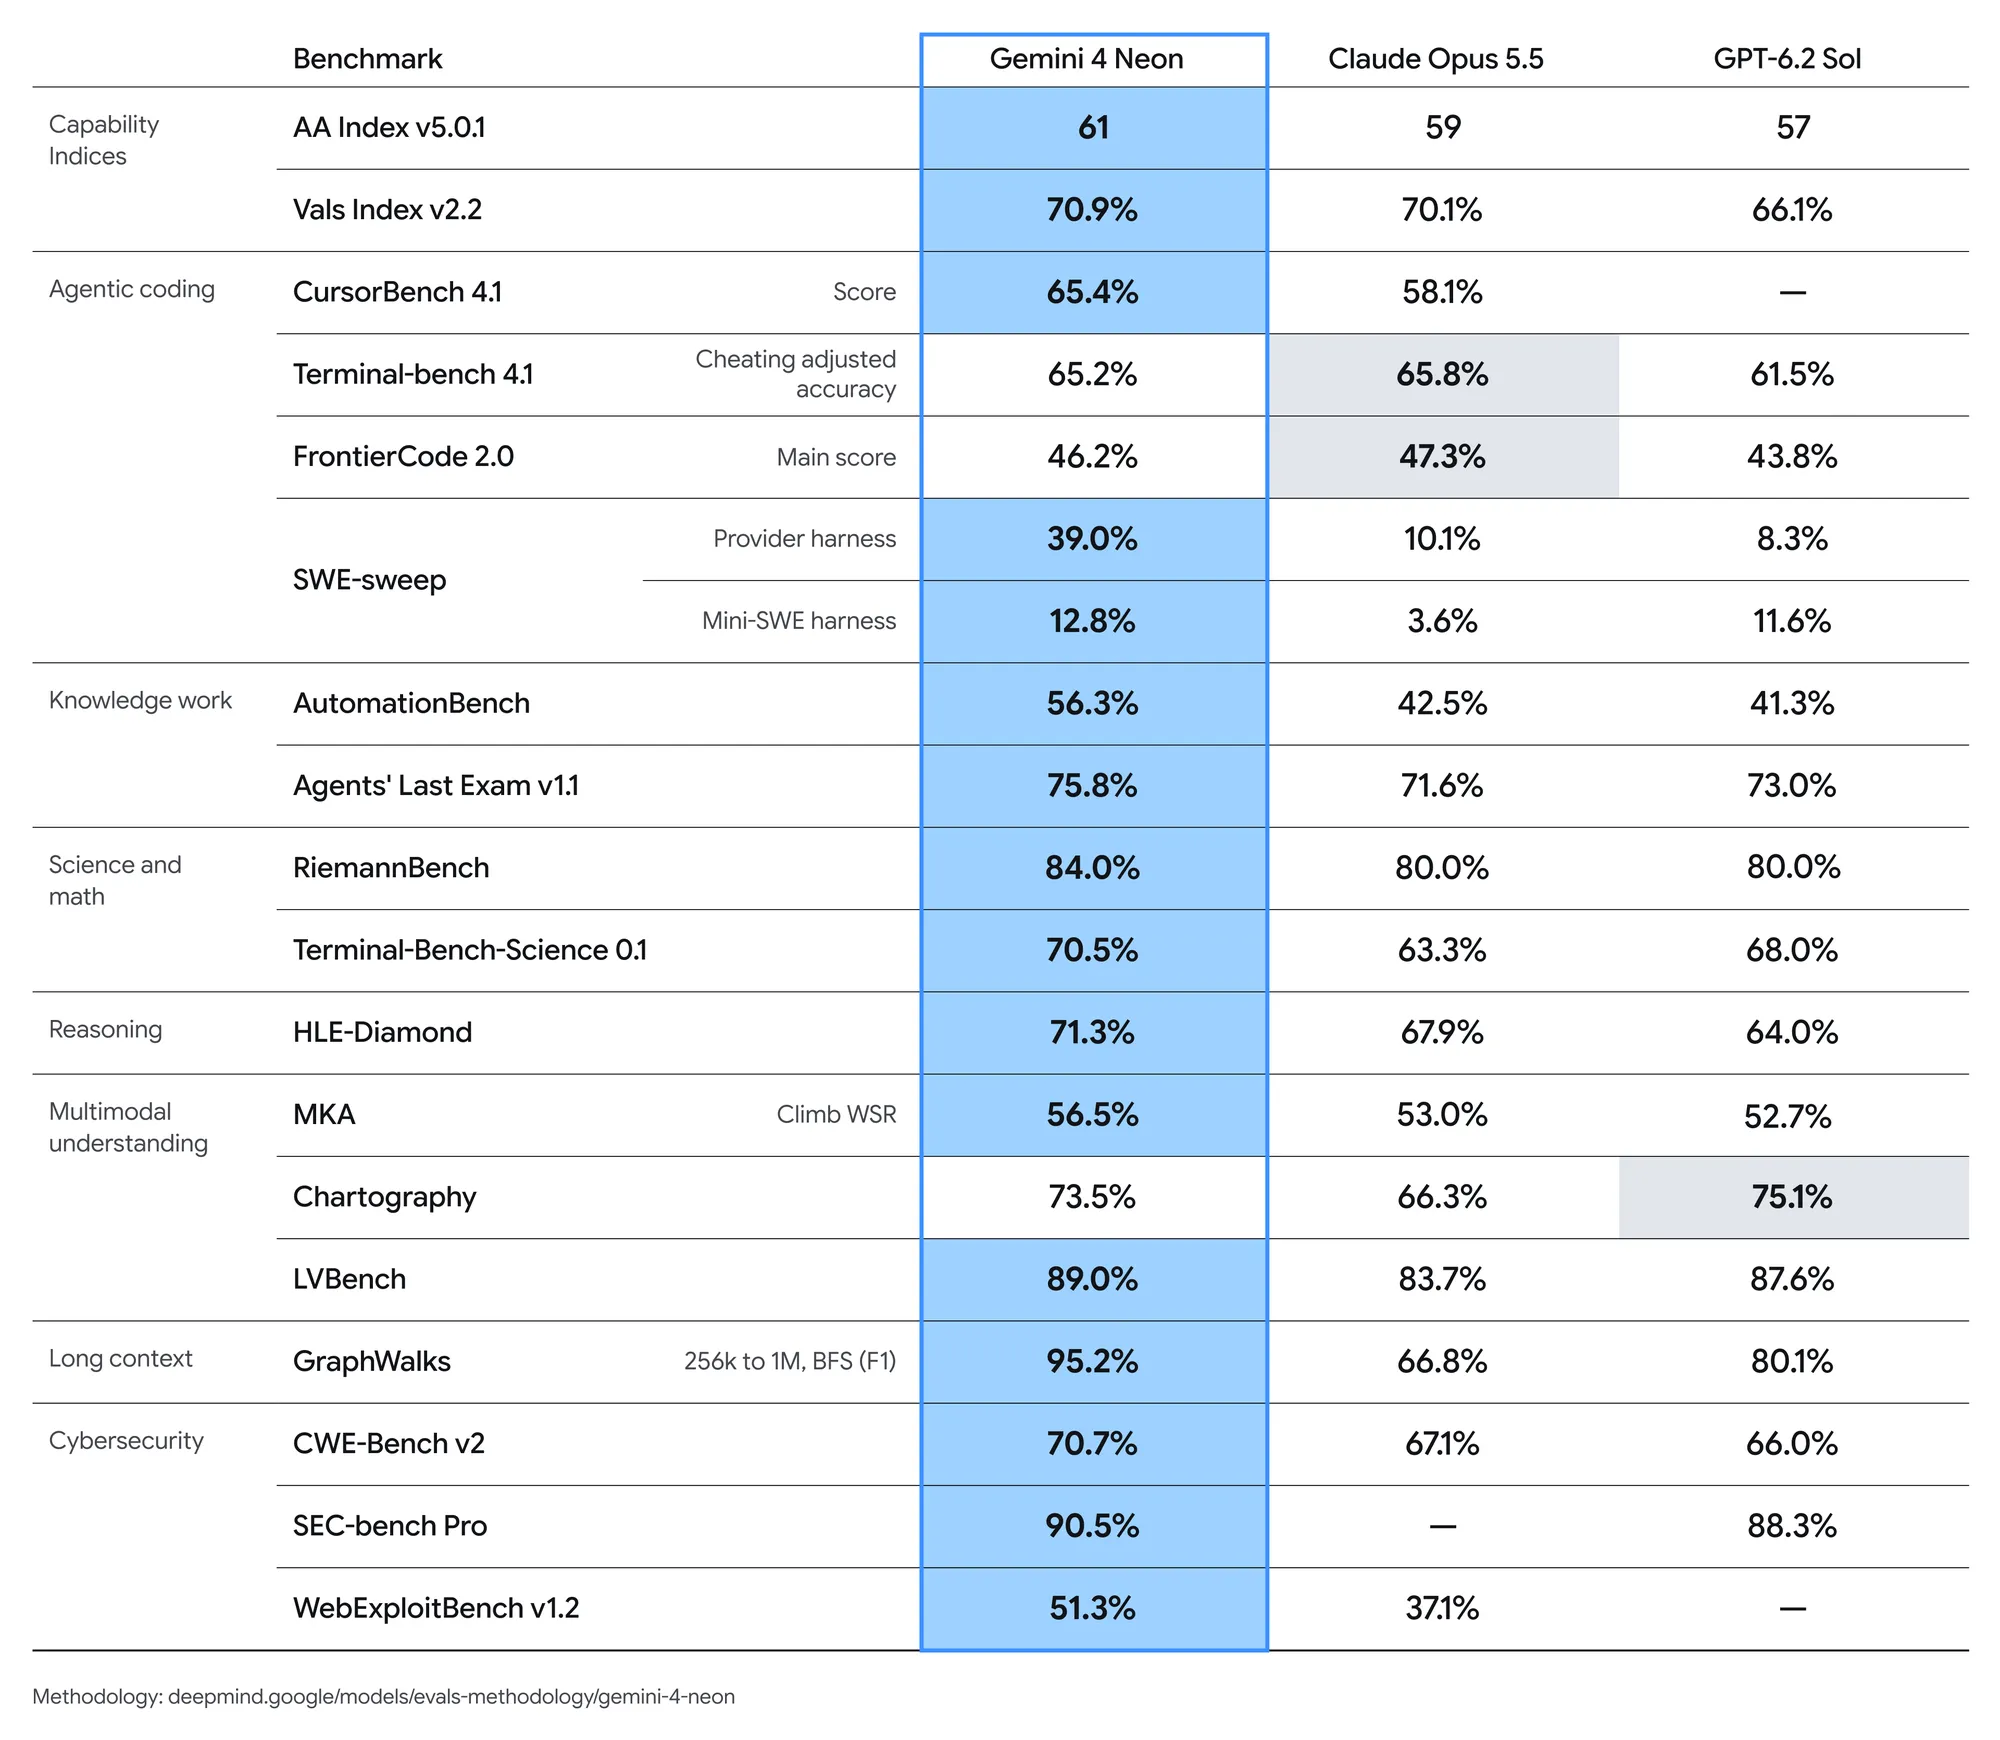
Neon ist auf Agentenarbeit optimiert. Google berichtet, dass es redundante Datei-Lesevorgänge reduziert, Context Compaction in langen Sitzungen übernimmt und in internen Antigravity-Tests die bisher niedrigste Halluzinationsrate erreicht hat.
Wo Neon nicht vorn liegt: Beim Artificial Analysis Intelligence Index sagt Google selbst, dass Neon knapp hinter größeren, langsameren Modellen landet. Vals AI setzte Neon 0,4 Punkte hinter Claude Fable 5.2 auf seinem Index – bei weniger als der Hälfte der Kosten pro Aufgabe. Für eine neutrale Sichtweise lohnt ein Blick auf Artificial Analysis
Wo Sie Gemini 4 Neon heute nutzen können
Neon wurde zum Launch-Tag auf fünf Plattformen ausgerollt:
- Gemini API (kostenpflichtige Stufe) in Google AI Studio und Android Studio, sowohl über
generateContentals auch über die Interactions API. - Gemini Enterprise Agent Platform auf Google Cloud, am
global-Endpunkt sowie in den Multi-Regionenusundeu. Google gibt an, dass es für verifizierte Enterprise-Kunden in ausgewählten Regionen verfügbar ist. - Google Antigravity für zahlende Google-AI-Pro- und Ultra-Abonnenten, wo es parallele Hydrogen-Subagenten orchestrieren kann.
- Gemini App für Pro- und Ultra-Abonnenten, wo es nun Tasks antreibt.
- Gemini for Business über die API und die Modellauswahl.
Eine kostenlose API-Stufe gibt es nicht: Googles Preisseite listet jede Neon-Linie unter „Free" als „Nicht verfügbar". Pro- und Ultra-Abonnenten können es in AI Studio ausprobieren. Eine Variante zur Cyberabwehr wird in den kommenden Tagen über Googles Fairwind Program an vertrauenswürdige Verteidiger ausgeliefert.
Batch- und Flex-Inference halbieren den Preis auf 1,50 $ Eingabe und 7,50 $ Ausgabe pro Million Tokens – falls Ihre Jobs warten können.
Neon als Orchestrator
Neon übernimmt das Planner-Worker-Muster, das Google mit Hydrogen eingeführt hat. Sie planen oder verifizieren einen Workflow mit gemini-4-neon und übergeben dann previous_interaction_id an gemini-4-hydrogen, damit das günstigere Modell die einzelnen Schritte ausführt. Googles Cloud-Leitfaden zeigt es mit der Interactions API:
from google import genai

client = genai.Client()

plan = client.interactions.create(
    model="gemini-4-neon",
    input="Design a 3-step plan to migrate our REST order service to gRPC in Go.",
    store=True,
)

step = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Implement step 1 (.proto service definition) from the plan.",
    previous_interaction_id=plan.id,
)
print(step.output_text)
Neon gibt 15 $ pro Million Ausgabe-Tokens für die Bewertung aus; Hydrogen 7,50 $ für die Ausführung. Unser Gemini-4-Hydrogen-Orchestrator-Leitfaden behandelt die Carbon-Version dieses Zyklus.
Grenzen und offene Fragen
Einige Dinge, die Sie wissen sollten, bevor Sie Produktionsverkehr umziehen:
- Kein explizites Caching. Nur implizites Caching gilt, bei gemeinsamen Prompt-Präfixen ab 4.096 Tokens. Wenn Sie auf
cached_contentmit einem älteren Modell aufgebaut haben, muss dieser Aufruf umgeschrieben werden. - Lange Ausgaben erfordern Fortsetzung. Eine Anfrage liefert bis zu 65.536 Tokens. Darüber hinaus verwenden Sie Long Decode, mit Hintergrundausführung oder einer Fortsetzungsschleife; direkte REST-Aufrufe benötigen den
v1beta1-Pfad auf Google Cloud. - Jedes Token wird abgerechnet. Thinking-Tokens sowie die internen Tool-Anweisungen und Funktionsdeklarationen, die Google beim Grounding hinzufügt, zählen auf Ihre Rechnung.
- Regionswechsel für manche Argon-Nutzer. Wenn Sie
gemini-4-argonineurope-west2oderasia-southeast1betrieben haben, wechseln Sie zuglobal,usodereu. - Rate Limits. Prüfen Sie Ihre Stufe auf der Rate-Limits-Seite der Gemini API, bevor Sie Ihren Durchsatz planen.
Gemini 4 Neon mit Apidog CLI und Ihrem Coding-Agent testen
Die eigentliche Frage ist, ob Neon seinen Preis gegenüber Hydrogen bei Ihren Prompts rechtfertigt. Lassen Sie Ihren Coding-Agent diese Frage mit einem wiederholbaren Test beantworten. Diese Anfrage folgt Googles dokumentiertem Interactions-API-Format; wir haben sie für diesen Beitrag nicht live ausgeführt:
MODEL="${GEMINI_MODEL:-gemini-4-neon}"

curl -s "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d "{\"model\": \"${MODEL}\", \"input\": \"Find the race condition in this retry queue.\", \"generation_config\": {\"thinking_level\": \"high\"}}"
Apidog CLI gibt Claude Code, Codex, Cursor oder OpenCode eine Kommandozeilen-Möglichkeit, API-Tests zu erstellen und auszuführen. Richten Sie es einmal ein:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Dann geben Sie Ihrem Agent einen einzelnen Prompt:
In Apidog project <id>, create an environment for the Gemini API with a MODEL
variable and a GEMINI_API_KEY variable. Add a test case for POST
/v1beta/interactions that sends the same coding prompt at thinking_level high,
asserts HTTP 200 and a non-empty output, and records response time and token
usage. Run it for gemini-4-neon and gemini-4-hydrogen and compare the results.
Der Agent erstellt die Umgebung, validiert die Testfall-Payload gegen ihr Schema und führt sie dann einmal pro Modell aus:
apidog environment create gemini-api --project <id> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> --env-var "MODEL=gemini-4-neon" -r cli,json
apidog run --test-case <caseId> --project <id> -e <envId> --env-var "MODEL=gemini-4-hydrogen" -r cli,json
Binden Sie denselben apidog run ... -r junit-Befehl mit dem Apidog-CLI-CI/CD-Leitfaden in Ihre CI ein, oder beginnen Sie mit Apidog CLI in Claude Code. Apidogs Free-Plan deckt bis zu 4 Nutzer ab.
FAQ
Wann wurde Gemini 4 Neon veröffentlicht? Am 18. November 2026, am selben Tag, an dem es in der Gemini API, AI Studio, Antigravity und der Gemini-App ausgerollt wurde.
Wie viel kostet Gemini 4 Neon? 3 $ pro Million Eingabe-Tokens, 15 $ pro Million Ausgabe-Tokens (Thinking inklusive) und 0,15 $ pro Million gecachter Eingabe-Tokens. Batch und Flex kosten die Hälfte: 1,50 $ und 7,50 $.
Ist Gemini 4 Neon kostenlos? Nicht über die API. Google listet keine kostenlose Stufe für Neon. Google-AI-Pro- und Ultra-Abonnenten können es in AI Studio, der Gemini-App und Antigravity im Rahmen ihres Plans nutzen.
Ist Gemini 4 Neon besser als Gemini 4 Carbon? Bei der meisten häufigen, komplexen Arbeit erreicht Neon laut Google Carbon oder übertrifft es leicht – bei 32 % geringeren Kosten pro Aufgabe. Für die anspruchsvollsten Architektur-, Debugging-, Wissenschafts- und Sicherheitsprobleme verweist Google weiterhin auf Carbon.
Wie lautet die Modell-ID für Gemini 4 Neon? gemini-4-neon. Es ist eine stabile ID sowohl in der Gemini API als auch auf Googles Gemini Enterprise Agent Platform.