
Gemini 4 Hydrogen ist Googles schnelles, günstigeres Gemini-4-Modell, veröffentlicht am 12. November 2026 und entwickelt für alltägliche Coding- und Agent-Aufgaben. Es kostet 1,50 $ pro Million Eingabe-Tokens und 7,50 $ pro Million Ausgabe-Tokens bei einem Kontext von 1M Tokens, bietet vier Thinking-Levels (low, medium, high, xhigh) und ist im Free Tier der Gemini API verfügbar.
Wenn Sie Gemini 3.8 Flash nutzen, ist Hydrogen Googles empfohlenes Upgrade. Wenn Sie für Carbon oder Argon bei Routineaufgaben bezahlen, soll Hydrogen diese Aufgaben übernehmen. Hier finden Sie alles, was neu ist, wie das Modell sich einordnet und was noch offen ist.
Was ist Gemini 4 Hydrogen?
Gemini 4 Hydrogen (gemini-4-hydrogen) ist die Geschwindigkeitsstufe der Gemini-4-Familie von Google. Google nennt es den „daily driver für agentische Workflows“: ein Modell, das Code schreibt, Tools aufruft, Tests ausführt und Dokumente liest – entweder eigenständig oder als Ausführungs-Engine unter einem Frontier-Modell wie Gemini 4 Carbon.
Die wichtigsten Fakten, aus Googles Launch-Beitrag und dem „What’s new“-Leitfaden von AI Studio:
| Spezifikation | Gemini 4 Hydrogen |
|---|---|
| Model ID | gemini-4-hydrogen |
| Veröffentlicht | 12. November 2026 |
| Preis (bezahlt) | 1,50 $ / 1M Eingabe, 7,50 $ / 1M Ausgabe (pauschal über den gesamten Kontext) |
| Gecachte Eingabe | 0,075 $ / 1M Tokens über implizites Caching |
| Kontextfenster | 1.048.576 Tokens, geteilt zwischen Eingabe, Thinking und Ausgabe |
| Ausgabe pro Anfrage | 65.536 Tokens synchron; bis zu 1M mit Background Execution |
| Thinking-Levels | low, medium, high (Standard), xhigh |
| Eingaben | Text, Bilder, PDFs, Tabellen, Diagramme, Audio, Video |
| Free Tier | Ja, ratenlimitiert, in AI Studio und der Gemini API |
| APIs | generateContent und die Interactions API |
Ausgabe-Tokens umfassen Thinking-Tokens. Eine Anfrage mit xhigh kostet also mehr als dieselbe Anfrage mit low, selbst wenn die sichtbare Antwort gleich lang ist.
Hydrogen vs. Carbon vs. Argon: Wo Hydrogen einzuordnen ist
Alle drei Gemini-4-Modelle teilen sich denselben 1M-Kontext, das Long-Decode-Design und die integrierten Tools. Sie unterscheiden sich darin, wie viel jedes Modell pro Durchgang nachdenkt und was das kostet.
| Hydrogen | Argon | Carbon | |
|---|---|---|---|
| Rolle | Schnelle Ausführung, alltägliche Coding-Aufgaben | Die meisten langfristigen Aufgaben, weniger Tokens als Carbon | Stärkstes Frontier-Modell |
| Standard-Thinking | high |
medium |
medium |
| Höchstes Thinking | xhigh |
high |
high |
| Nicht-Streaming-Hop | 65.536 Tokens | 32.768 Tokens (REST) | 32.768 Tokens (REST) |
| Googles Empfehlung | Upgrade-Pfad von 3.8 Flash | Anspruchsvolle Langzeitaufgaben | Schwere Architektur, Sicherheit, Wissenschaft |
Googles eigene Empfehlung lautet, die Modelle zu kombinieren: Carbon plant Schnittstellen oder entwirrt einen kniffligen Bug, dann übernimmt Hydrogen Code-Änderungen, parallele Subagent-Arbeit und Testläufe. Der Modellwechsel innerhalb einer Konversation funktioniert über previous_interaction_id in der Interactions API – ohne Änderungen am Request-Schema.
Für einen detaillierteren Vergleich der beiden Frontier-Modelle lesen Sie Gemini 4 Carbon vs Argon. Zu den Kosten gibt es die Aufschlüsselungen zur Carbon-Preisgestaltung und zur Argon-Preisgestaltung.
Die vier Thinking-Levels
Das Thinking-Level von Hydrogen ist Ihre wichtigste Kontrolle über Geschwindigkeit, Qualität und Kosten. Es wird über das Feld thinking_level gesetzt, und Google empfiehlt, beim Standard zu beginnen und nur dann zu wechseln, wenn Ihre Evals es nahelegen.
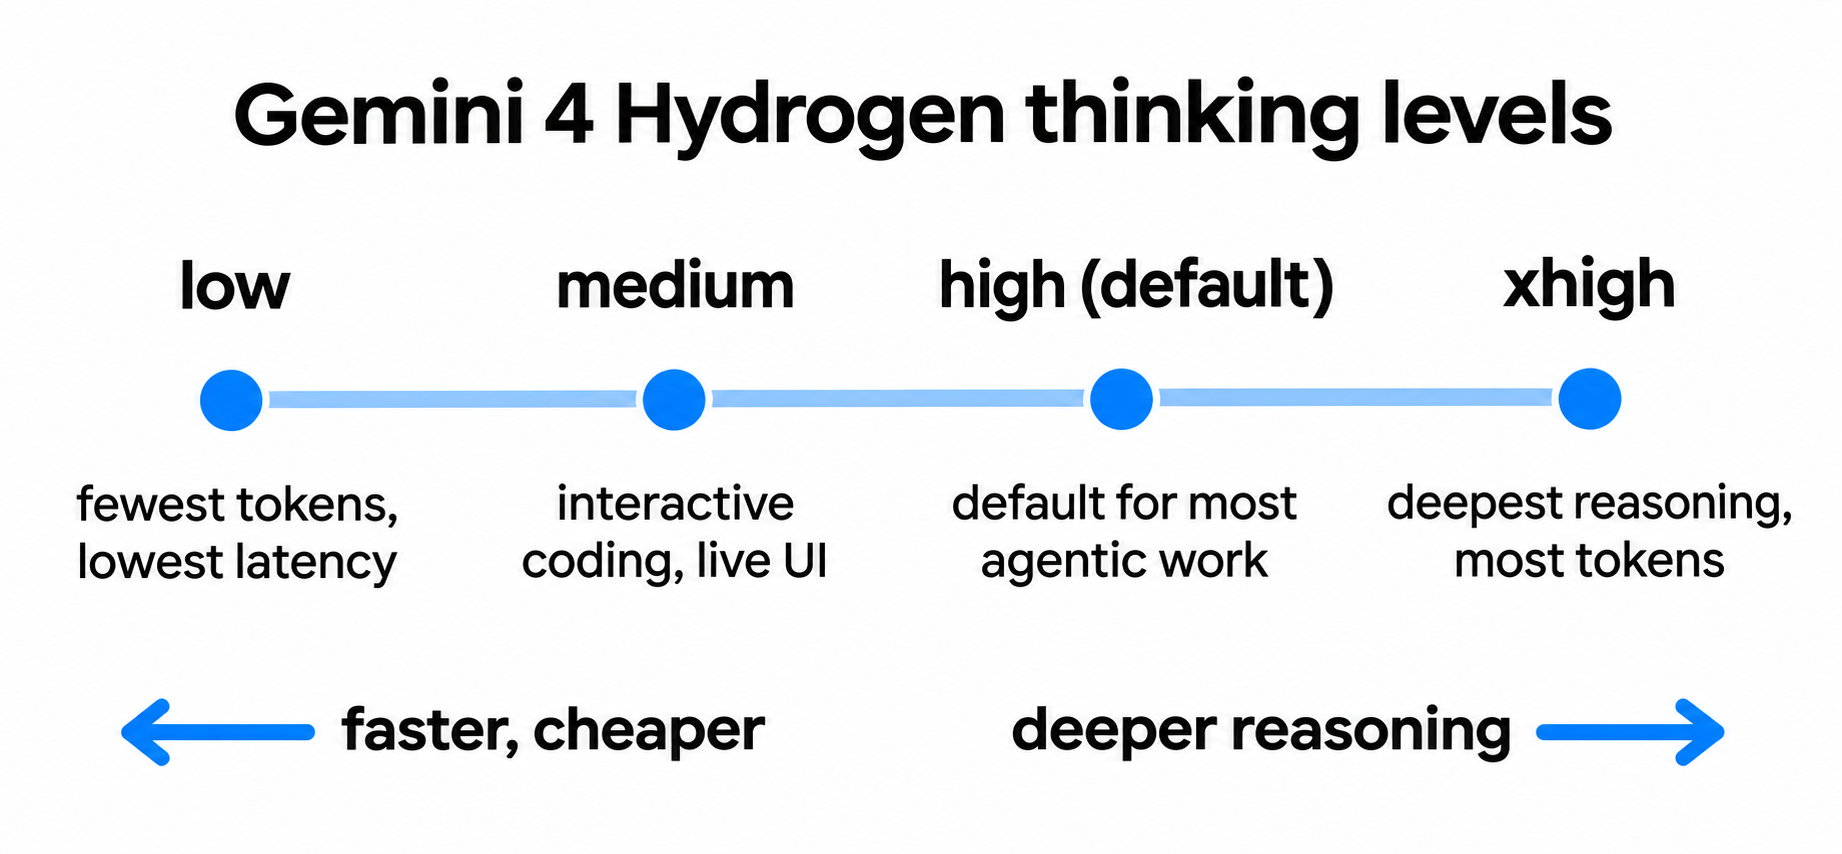
low: die wenigsten Tokens, geringste Latenz. Schnelle Chats und High-Throughput-Verarbeitung.medium: interaktives Coding, Live-UI-Prototyping und latenzempfindliche Tool-Aufrufe.high(Standard): komplexes Coding, agentische Ausführung, Tool-Aufrufe und multimodale Dokumentenarbeit.xhigh: neu bei Hydrogen. Schwere mehrstufige Probleme, bei denenhighnicht ausreicht.
Google warnt, dass xhigh bei einfachen Prompts zu viel nachdenken kann und dadurch Latenz und Tokens hinzufügt, ohne eine bessere Antwort zu liefern. Der Rat: Führen Sie Ihre Eval-Suite auf allen vier Ebenen mit großzügigem max_output_tokens aus und wählen Sie dann die niedrigste Ebene, die Ihre Qualitätsanforderung erfüllt. Wenn Sie von 3.8 Flash migrieren: Hydrogen lehnt minimal mit einem Fehler ab und verwendet standardmäßig high statt medium. Der Preis-Leitfaden für Hydrogen zeigt, was jede Ebene kostet.
Gemini 4 Hydrogen Benchmarks
Alle folgenden Zahlen stammen von Google und wurden zum Launch veröffentlicht. Unabhängige Nachprüfungen waren einen Tag nach der Veröffentlichung noch dünn – betrachten Sie sie daher als Herstellerangaben.
Gegenüber Argon und den eigenen Einstellungen
- Artificial Analysis Intelligence Index: 51 bei
high, vor Argons 50, und 54 beixhigh.
Gegenüber Gemini 3.8 Flash
- 2,5x schneller beim
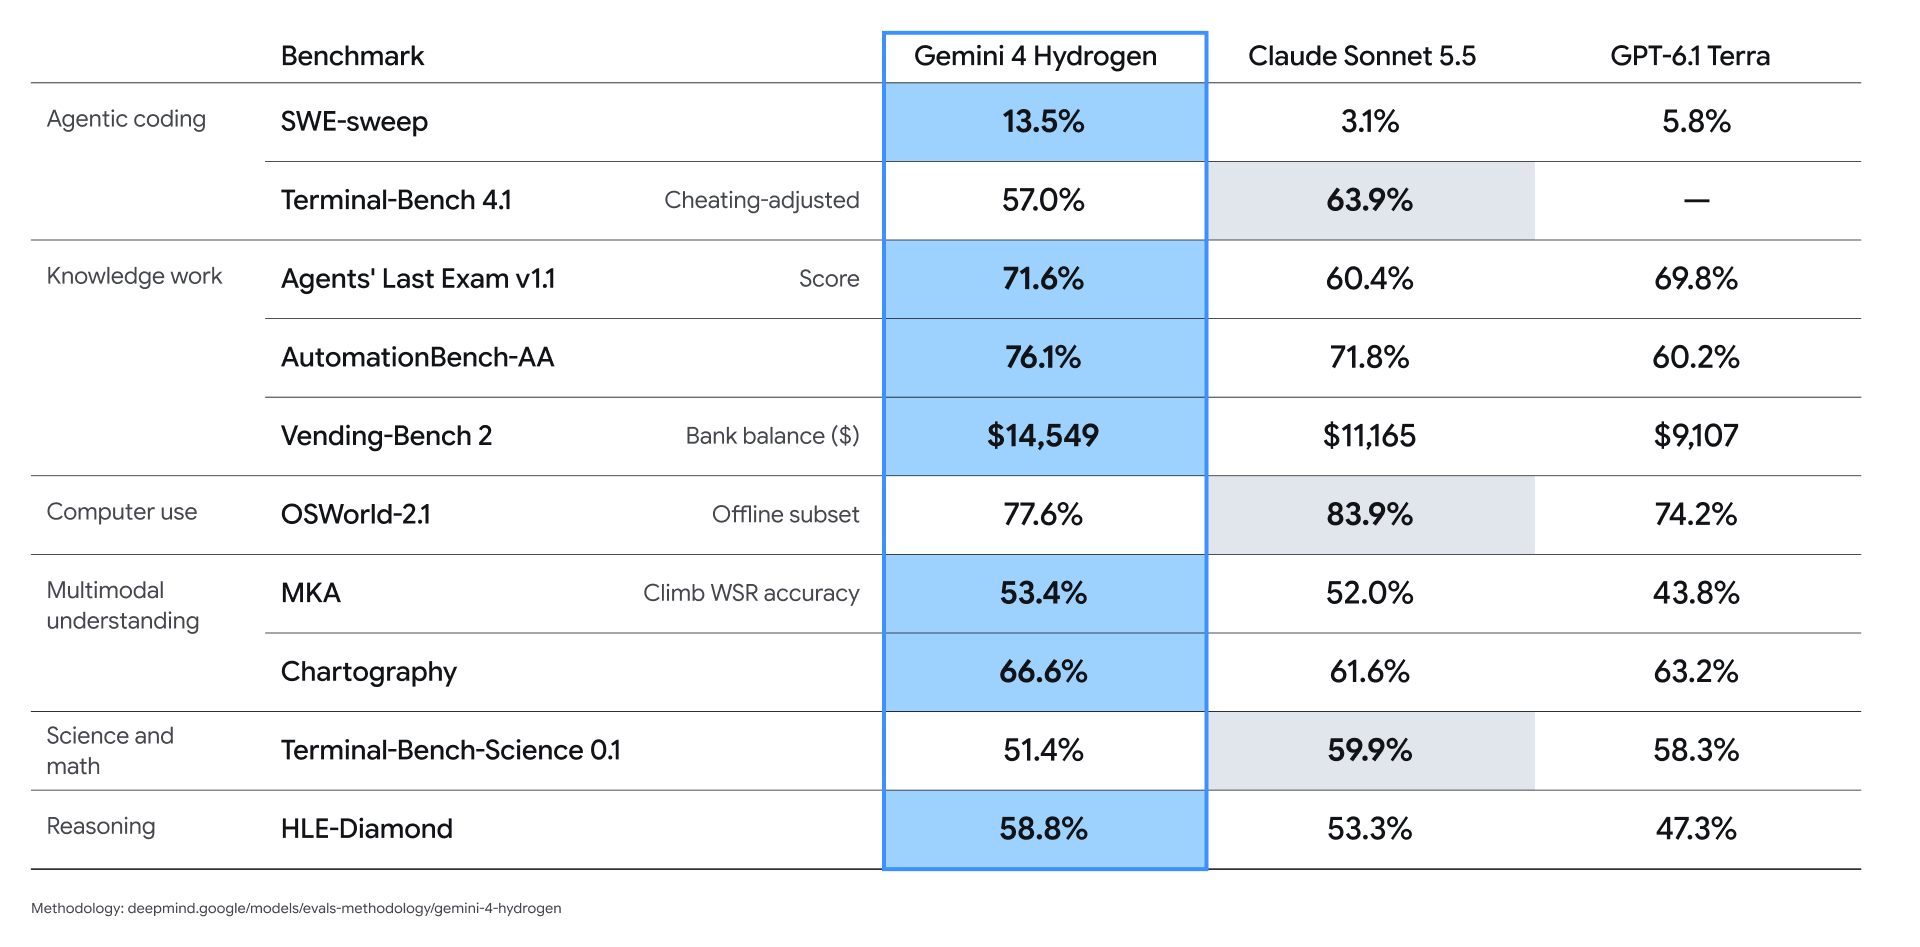
high-Standard. - Terminal-Bench 4.1: 57 % gegenüber 18,2 %.
- Mehr als 5x weniger erfundene Aussagen.
- Launch-Partner berichten von 2x bis 2,8x schnelleren Läufen und 12 % bis 23 % weniger Tokens bei Graph-, SQL- und datenlastigen Workloads.
Agentische und fachspezifische Aufgaben
- HLE-Diamond: 58,8 % – laut Google führend in seiner Klasse.
- Vals Tax Agent Bench: Platz 1 mit 52,3 %.
- Vals Legal Research Bench: Platz 1 mit 55,8 % (geteilt).
- Agent Arena (arena.ai): Platz 5.
- Multimodal Knowledge Agent (MKA): 53,4 %.
- Agents’ Last Exam v1.1: 71,6 %.
Sicherheit, laut Google
- Bis zu 81 % weniger Übergriffe und bis zu 79 % weniger Unterversorgung bei agentischen Aufgaben.
- 12x weniger fehlgeleitete Aktionen und Task-Abkürzungen in Tool-Use- und Coding-Evals.
- 96,7 % bei Googles interner Evaluation der Agenten-Ehrlichkeit.
- Mehr als 2,3x widerstandsfähiger gegen indirekte Prompt Injection im Gray-Swan-IPI-Benchmark.
Das Muster ist wichtiger als jede einzelne Zahl: Hydrogen erreicht auf allgemeiner Intelligenz etwa das Niveau von Argon und ist bei agentischem Coding ein großer Sprung gegenüber 3.8 Flash. Testen Sie es auf Ihrem eigenen Workload, bevor Sie ihm vertrauen. Die Model Card enthält Googles vollständige Evaluationshinweise.
Wo Sie Gemini 4 Hydrogen heute nutzen können
Google hat Hydrogen am Launch-Tag über Entwickler-, Business- und Consumer-Produkte hinweg ausgerollt:
- Gemini API, Google AI Studio und Android Studio: alle Tarife, kostenlos und bezahlt. Der Free Tier ist ratenlimitiert; der Hydrogen-Free-Leitfaden erklärt, was Sie ohne Kreditkarte bekommen.
- Gemini für Unternehmen: über die API, das Modell-Dropdown, Antigravity und Gemini in Google Sheets für geeignete Business-Pläne.
- Gemini App: im Modell-Dropdown. Kostenlose Nutzer erhalten Hydrogen nur über die automatische Modellauswahl, wenn Gemini entscheidet, dass es zum Prompt passt.
- Google Search: als Grundlage von Antworten für alle Nutzer.
- Google Sheets: zunächst für Google AI Pro- und Ultra-Abonnenten.
- Google Antigravity: für zahlende Google AI Pro- und Ultra-Abonnenten.
Hydrogen ist nun auch das Standardmodell hinter dem Antigravity-Agenten in Gemini Managed Agents. Jeder, der diesen Agenten über die API aufruft, nutzt also bereits Hydrogen – es sei denn, er konfiguriert ein anderes Modell.
Orchestrator: Hydrogen und Carbon in einer Sitzung
Orchestrator ist eine neue Modelloption in Google Antigravity, die innerhalb einer Aufgabe in beide Richtungen zwischen Carbon und Hydrogen wechselt. Carbon erkundet und plant, Hydrogen schreibt Änderungen, aktualisiert Pakete und führt Tests aus – und wenn Hydrogen auf Widerstand stößt, gibt es die Kontrolle an Carbon zurück, um den Plan zu reparieren. Es ersetzt den statischen Router, der die Schwierigkeit bisher einmalig anhand Ihres ersten Prompts schätzt.
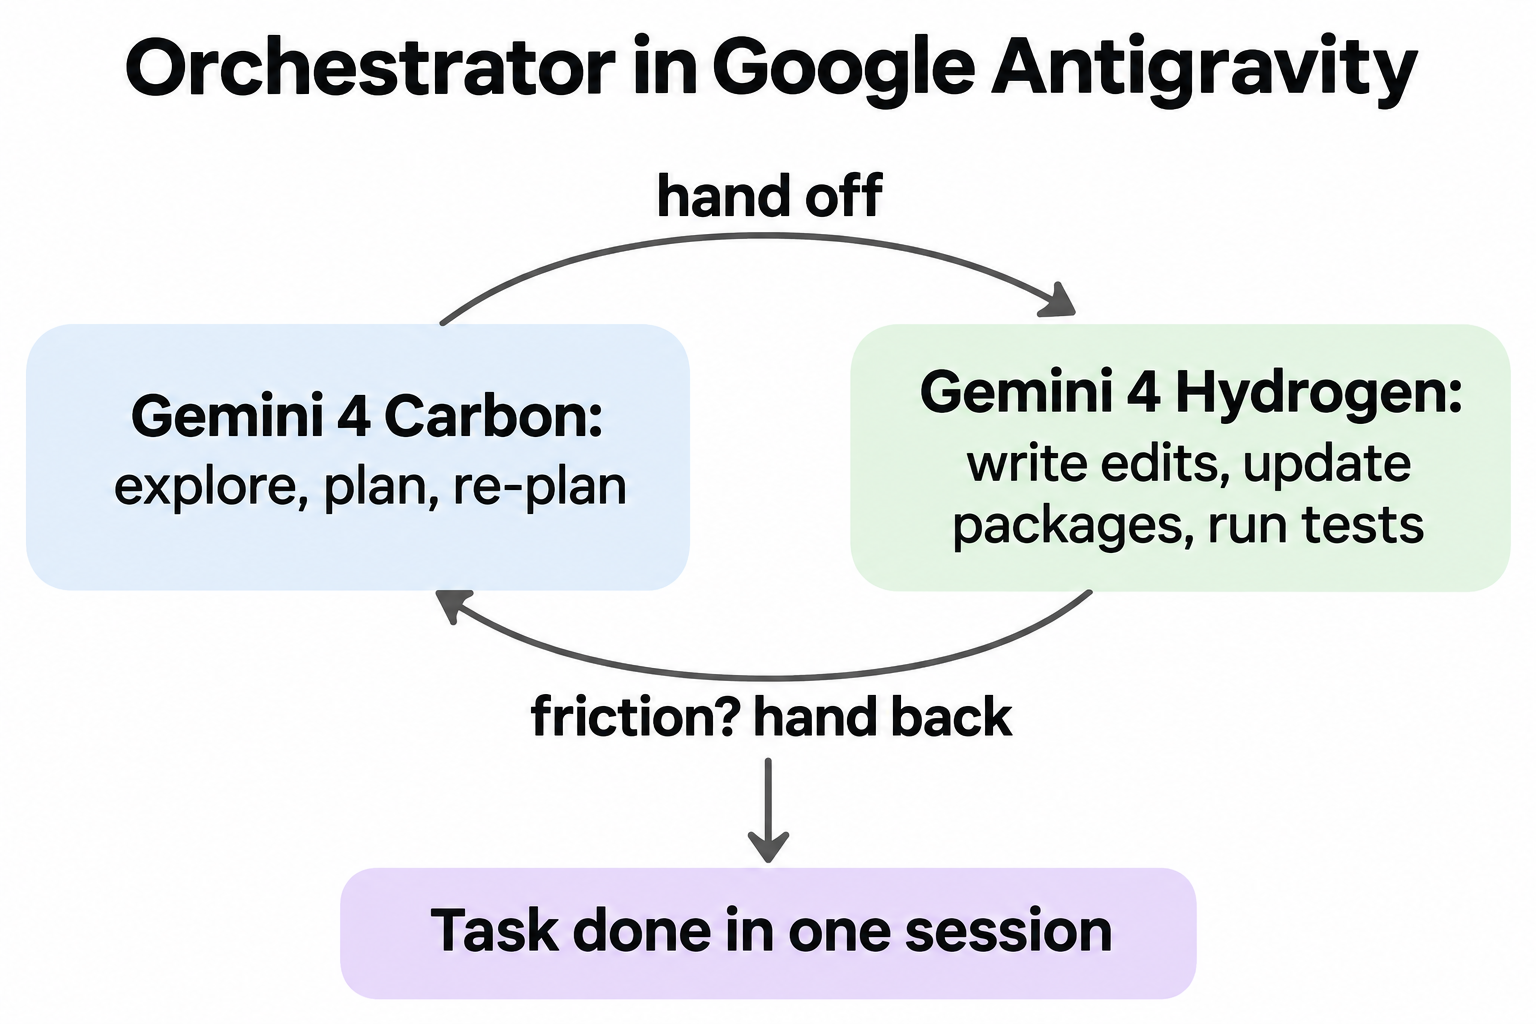
Im Terminal-Bench erreichte Orchestrator laut Google nahezu die Erfolgsquoten von Carbon, verbrauchte dabei 24 % weniger Kontingent und war im Schnitt 19 % schneller. Beachten Sie, dass Googles zwei Launch-Beiträge für dieses Ergebnis unterschiedliche Versionen des Benchmarks zitieren (4.0 im Hauptbeitrag, 4.1 im Antigravity-Beitrag).
Die Verfügbarkeit ist gestaffelt. Ultra-Abonnenten erhalten Orchestrator (Carbon) und Orchestrator (Argon); zahlende Pro-Abonnenten erhalten Orchestrator (Argon). Wenn Sie die Rollen lieber selbst verdrahten möchten, können Sie mit dem Antigravity SDK Hydrogen- und Carbon-Agenten explizit zuweisen. Der Gemini-4-Hydrogen-Orchestrator-Leitfaden geht tiefer ins Detail.
Grenzen und offene Fragen
Einen Tag nach dem Launch sollten Sie Folgendes einplanen:
- Benchmarks sind selbst berichtet. Jede Zahl oben stammt von Google oder seinen Launch-Partnern.
- Kein explizites Caching.
cachedContentsundcaches.createwerden nicht unterstützt; es gilt nur der implizite Cache für Prompts ab 4.096 Tokens. - Sampling-Parameter werden ignoriert.
temperature,top_pundtop_khaben keine Wirkung – Sie können die Zufälligkeit also nicht auf diese Weise steuern. - Free-Tier-Limits stehen auf einer separaten Seite. Google verweist auf seine Rate-Limits-Seite, statt Hydrogens Zahlen im Launch-Leitfaden aufzuführen.
- Orchestrator gibt es nur in Antigravity. Es gibt keinen API-seitigen Orchestrator; in Ihrem eigenen Code routen Sie die Modelle selbst.
Testen Sie Gemini 4 Hydrogen mit Apidog CLI und Ihrem Coding-Agenten
Um zu entscheiden, ob Hydrogen 3.8 Flash ersetzen kann, führen Sie dieselbe Anfrage gegen beide Modelle aus und vergleichen Sie. Überlassen Sie das Ihrem Coding-Agenten, damit der Wechsel zu einem Testergebnis statt zu einer Vermutung wird. Diese Anfrage folgt Googles dokumentiertem generateContent-Format; wir haben sie für diesen Beitrag nicht live ausgeführt:
MODEL="${GEMINI_MODEL:-gemini-4-hydrogen}"

curl -s "https://generativelanguage.googleapis.com/v1beta/models/${MODEL}:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"contents": [{"parts": [{"text": "List three checks a CI job should run before a release."}]}]}'
Apidog CLI bietet Claude Code, Codex, Cursor oder OpenCode einen Kommandozeilenweg, um API-Tests zu erstellen und auszuführen. Richten Sie es einmalig ein:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Geben Sie Ihrem Agenten dann einen Prompt:
In Apidog project <id>, create an environment for the Gemini API with a MODEL
variable set to gemini-4-hydrogen and a GEMINI_API_KEY variable. Add a test case
for POST /v1beta/models/{MODEL}:generateContent that asserts HTTP 200, a non-empty
candidates array, and that usageMetadata is present. Run it for gemini-4-hydrogen
and gemini-3.8-flash and compare response time and token counts.
Der Agent erstellt die Umgebung, validiert die Test-Case-Payload gegen ihr Schema und führt sie dann je Modell einmal aus:
apidog environment create gemini-api --project <id> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> --env-var "MODEL=gemini-4-hydrogen" -r cli,json
apidog run --test-case <caseId> --project <id> -e <envId> --env-var "MODEL=gemini-3.8-flash" -r cli,json
Binden Sie denselben apidog run ... -r junit-Aufruf mit dem Apidog-CLI-CI/CD-Leitfaden in Ihre CI ein, oder starten Sie mit Apidog CLI in Claude Code. Vollständige Request-Beispiele finden Sie im Gemini-4-Hydrogen-API-Leitfaden. Apidogs Free-Plan umfasst bis zu 4 Nutzer.
FAQ
Ist Gemini 4 Hydrogen kostenlos? Ja, innerhalb von Grenzen. Google listet Hydrogen im Free Tier der Gemini API und in Google AI Studio, ratenlimitiert. Die kostenpflichtige Nutzung kostet 1,50 $ pro Million Eingabe-Tokens und 7,50 $ pro Million Ausgabe-Tokens.
Wie lautet die Model-ID von Gemini 4 Hydrogen? gemini-4-hydrogen. Es funktioniert sowohl mit generateContent als auch mit der Interactions API.
Ist Gemini 4 Hydrogen besser als Gemini 4 Argon? Nach Googles Zahlen erreicht Hydrogen 51 im Artificial Analysis Intelligence Index bei high gegenüber Argons 50, und 54 bei xhigh. Argon wird weiterhin für die meisten anspruchsvollen Langzeitaufgaben empfohlen – testen Sie also beide auf Ihrem eigenen Workload.
Was ist das xhigh-Thinking-Level? Es ist ein viertes Thinking-Level, neu bei Hydrogen, über dem Standard-high. Es verbraucht die meisten Tokens für die tiefste Reasoning-Leistung. Google empfiehlt es nur für schwere mehrstufige Probleme, bei denen high nicht ausreicht.
Ersetzt Gemini 4 Hydrogen Gemini 3.8 Flash? Google bezeichnet es als das empfohlene Upgrade von 3.8 Flash. Ändern Sie die Model-ID, erhöhen Sie niedrige max_output_tokens-Limits, entfernen Sie explizites Caching und Sampling-Parameter und testen Sie Ihr Thinking-Level neu.
Kann ich Orchestrator über die Gemini API nutzen? Nein. Orchestrator ist eine Modelloption in Google Antigravity für zahlende AI-Pro- und Ultra-Abonnenten. In der API routen Sie selbst zwischen Carbon und Hydrogen, zum Beispiel mit previous_interaction_id über mehrere Durchgänge hinweg.