
Firecrawl Local ist eine einzelne Rust-Binary, die Websites auf deinem eigenen Rechner zu sauberem Markdown scrapt, crawlt und mappt. Du installierst sie mit cargo install firecrawl-local, und sie kann die Firecrawl-v2-API unter localhost:3002 bereitstellen – ohne API-Schlüssel, ohne Datenbank, ohne Queue und ohne Container. Search und einige andere Funktionen gehen weiterhin an Firecrawl Cloud, das lässt sich jedoch abschalten.
Im Folgenden: was auf deinem Laptop läuft, was an die Cloud geht, wie du die Binary installierst, welche API-Routen sie bereitstellt, ihre Grenzen und wie du deinen Coding-Agent die lokale API mit der Apidog CLI testen lässt.
Was ist Firecrawl Local?
Firecrawl Local ist die Open-Source-Edition von Firecrawl, die direkt auf dem Gerät läuft. Es ist eine einzige Binary, die Webseiten abruft, sie mit demselben HTML-Bereinigungscode aufbereitet, den auch die gehostete Firecrawl-API verwendet, und Markdown, HTML oder Links zurückgibt. Sie läuft als CLI, als MCP-Server für KI-Agenten oder als lokale Kopie der Firecrawl-v2-API.
Firecrawl kündigte sie am 18. November 2026 in einem Launch-Post auf X an; der Code liegt im Ordner apps/local des Firecrawl-Repositories. Das Paket ist auf crates.io als firecrawl-local veröffentlicht, und das Repository steht unter der Lizenz AGPL-3.0.
Firecrawl behauptet, sie sei 37-mal schneller als selbst gehostetes Firecrawl und verbrauche 230-mal weniger Speicher (11 MB im Leerlauf). Das README veröffentlicht keine Benchmark-Methodik, behandle diese Zahlen also als Angaben des Herstellers.
Wenn du die gehostete API oder die Firecrawl CLI kennst, ist das Konzept einfach: dieselben Aufrufe, nur auf deinem Rechner beantwortet.
So funktioniert Firecrawl Local: eine Binary, zehn Befehle
Jede Funktion steckt hinter einem Subcommand von firecrawl-local. Hier die vollständige Liste aus dem README:
| Befehl | Was er macht | Läuft auf |
|---|---|---|
scrape <urls...> |
Eine oder mehrere URLs scrapen | Deinem Rechner |
crawl <url> |
Links von einer Start-URL aus verfolgen | Deinem Rechner |
map <url> |
Die URLs einer Site aus Sitemaps und der Startseite auflisten | Deinem Rechner |
serve |
Die Firecrawl-v2-API auf localhost bereitstellen | Deinem Rechner |
mcp |
Den Firecrawl-MCP-Server über stdio betreiben | Deinem Rechner, einige Tools auf der Cloud |
init |
Den MCP-Server in KI-Tools auf diesem Rechner eintragen | Deinem Rechner |
search <query> |
Das Web durchsuchen | Firecrawl Cloud |
find-tools <query> |
Alexandria-Datenanbieter finden | Firecrawl Cloud, Anmeldung |
data <provider> <capability> |
Einen Alexandria-Datenanbieter ausführen | Firecrawl Cloud, Anmeldung |
login |
Im Browser bei Firecrawl anmelden | Firecrawl Cloud |
Drei Befehle decken den Großteil des Alltags ab:
# Print one page as markdown
firecrawl-local scrape https://example.com --markdown

# Crawl up to 50 pages and save one markdown file per page
firecrawl-local crawl https://docs.firecrawl.dev --limit 50 --out ./pages

# List every URL on a site
firecrawl-local map https://firecrawl.dev
Ohne --markdown gibt scrape das JSON der Firecrawl-API aus. --format akzeptiert markdown, html, rawHtml und links. Auch PDFs und Office-Dokumente werden lokal geparst.
Bei JavaScript-Seiten steuert sie das Chrome oder Chromium an, das du bereits hast. Ohne Browser funktionieren statische Seiten weiterhin, und eine Seite, die einen Browser benötigt, liefert eine Warnung. --browser auto|never|always legt fest, wann Chrome zum Einsatz kommt.
Was lokal läuft und was in der Firecrawl Cloud
Scraping, Crawling, Mapping und Dokumentenparsing laufen auf deinem Rechner und senden nichts an Firecrawl. Drei Funktionen gehen an Firecrawl Cloud, weil ein Laptop weder den Index noch das Netzwerk oder die Daten hat:
- Search. Auf deinem Rechner gibt es keinen Suchindex. Die schlüssellose Suche funktioniert, ist aber rate-limitiert.
- Seiten, die deinen Rechner ablehnen. Wenn eine Site sowohl den einfachen Abruf als auch den lokalen Browser blockiert, ruft Firecrawl Cloud sie ab. Kein Account nötig.
- Alexandria-Datenanbieter. Diese laufen auf Firecrawl Cloud und erfordern ein kostenloses Konto. Unser Firecrawl-Alexandria-Erklärartikel beschreibt, worum es sich dabei handelt.
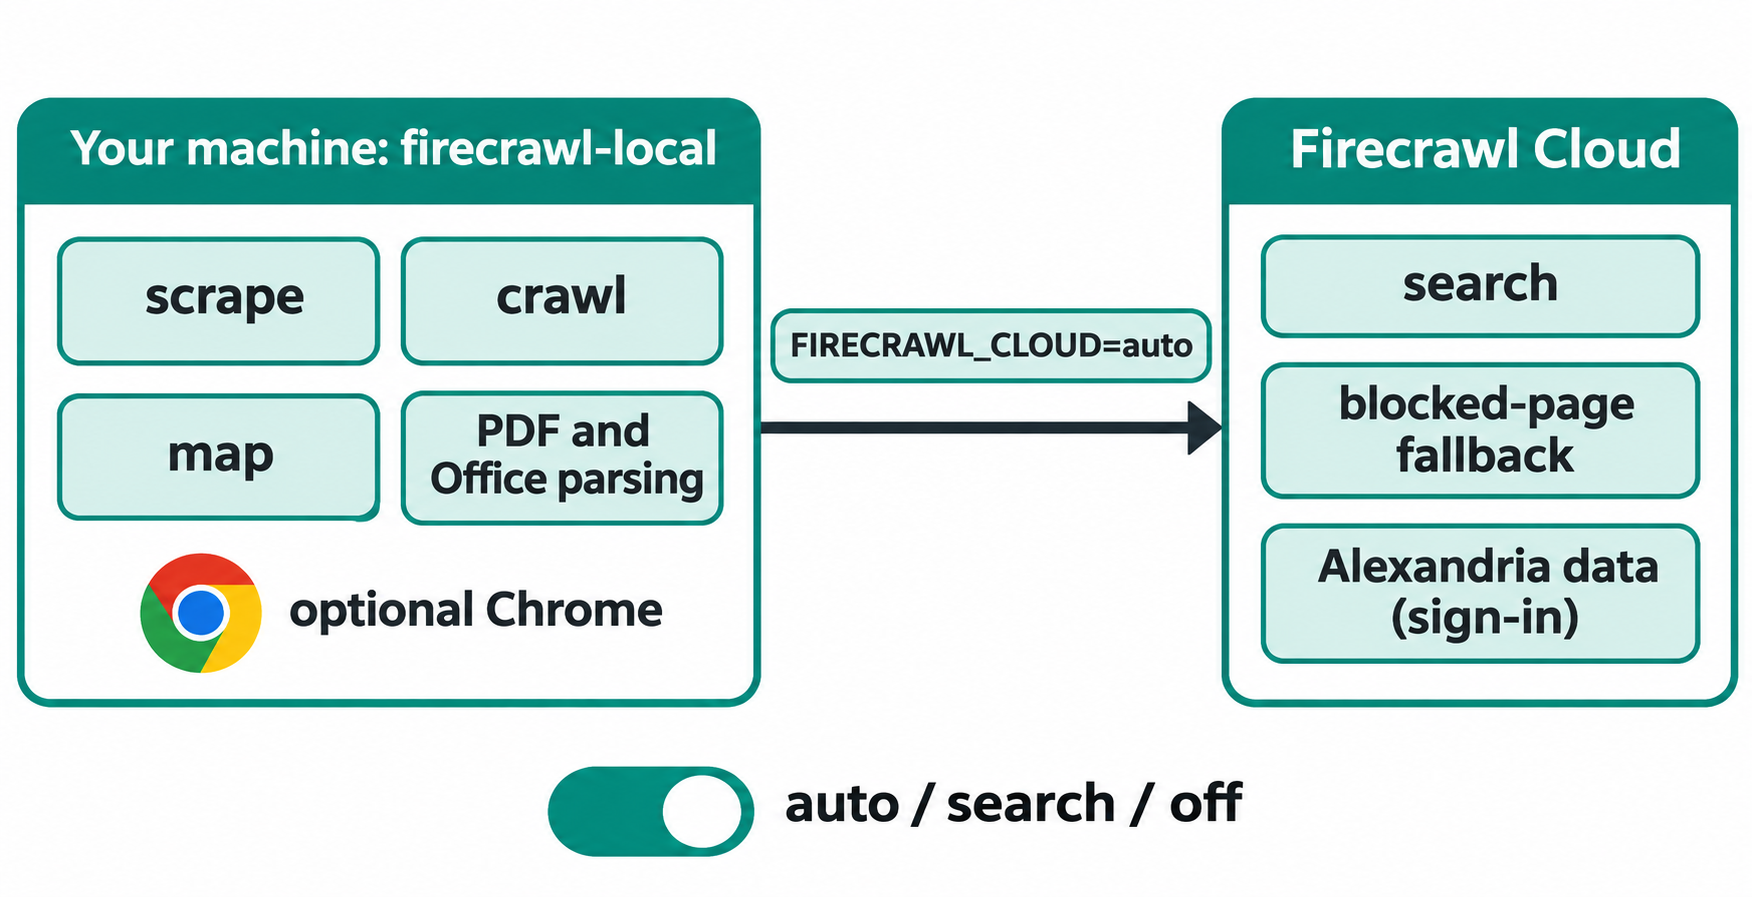
Die Umgebungsvariable FIRECRAWL_CLOUD steuert die Übergabe an die Cloud:
| Wert | Wirkung |
|---|---|
auto (Standard) |
Search, der Fallback für blockierte Seiten und Alexandria funktionieren alle |
search |
Nur Search geht an Firecrawl Cloud |
off |
Nichts geht an Firecrawl Cloud |
Ein nicht erkannter Wert wird wie off behandelt. Ergebnisse, die aus der Cloud abgerufen wurden, tragen "source": "firecrawl-cloud"; wenn auch die Cloud scheitert, erhältst du "blocked": true.
Cloud-Aufrufe enthalten eine zufällige Installations-ID und den Namen des aufrufenden Tools – so zählt Firecrawl die Installationen.
So installierst du Firecrawl Local
Du brauchst Rust und einen C-Compiler. Dann:
- Build-Tools installieren. Auf macOS führst du
xcode-select --installaus. Auf Debian oder Ubuntu installierst dubuild-essential. - Chrome oder Chromium ergänzen (optional), wenn du JavaScript-gerenderte Seiten oder Screenshots brauchst.
- Node.js 22 oder neuer ergänzen (optional), wenn du den MCP-Server willst, der das npm-Paket
firecrawl-mcpübernpxausführt. - Anmelden (optional) mit
firecrawl-local loginfür Alexandria-Anbieter.
Die Binary von crates.io installieren.
cargo install firecrawl-local
firecrawl-local --version
Um stattdessen den aktuellsten Code zu bauen, führe cargo build --release in apps/local einer Repo-Kopie aus.
Firecrawl Local API: die v2-Routen auf localhost:3002
firecrawl-local serve beantwortet die Firecrawl-v2-API auf Port 3002. Für die lokalen Routen ist kein API-Schlüssel erforderlich.
firecrawl-local serve

# in another terminal
curl -s http://localhost:3002/v2/scrape \
  -H 'content-type: application/json' \
  -d '{"url":"https://example.com","formats":["markdown"]}'
Diese Routen laufen auf deinem Rechner:
| Route | Was sie macht |
|---|---|
POST /v2/scrape |
Eine URL scrapen |
POST /v2/map |
Die URLs einer Site auflisten |
POST /v2/crawl, GET und DELETE /v2/crawl/{id} |
Einen Crawl starten, prüfen und abbrechen |
POST /v2/batch/scrape, GET und DELETE /v2/batch/scrape/{id} |
Einen Batch-Scrape starten, prüfen und abbrechen |
GET /health |
Health Check |
Jede andere /v2-Route, etwa /v2/search, wird an Firecrawl Cloud weitergeleitet, sofern FIRECRAWL_CLOUD nichts anderes vorgibt. Die v0- und v1-Routen werden nicht bereitgestellt.
Bestehender Code wechselt mit einer einzigen Einstellung: Setze die API-URL jedes Firecrawl-SDK auf http://localhost:3002. Dein Scraper oder deine RAG-Pipeline behält ihren Code, und du gibst während der Iteration keine Cloud-Credits mehr aus. Für einen breiteren Blick auf Scraping-Pipelines siehe unseren Firecrawl-Web-Scraping-Leitfaden.
Firecrawl Local als MCP-Server für KI-Agenten
firecrawl-local init registriert Firecrawl Local als Model-Context-Protocol-Server in jedem KI-Tool, das es findet. Es kennt Claude Code, Claude Desktop, Cursor, Windsurf, Gemini CLI und Codex, legt zuerst von jeder Konfigurationsdatei ein Backup an, und akzeptiert --dry-run für eine Vorschau der Änderungen oder --agent cursor, um nur ein Tool einzurichten.
Dein Agent erhält die Standard-Tools des Firecrawl MCP: Scrape, Crawl, Map und Batch Scrape laufen lokal, der Rest geht an Firecrawl Cloud.
Wenn dein Agent Sites besucht, denen du nicht vertraust, registriere ihn als firecrawl-local mcp --public-only. Eine Seite mit versteckten Anweisungen könnte den Agent sonst dazu bringen, eine interne URL in deinem Netzwerk zu öffnen.
Grenzen von Firecrawl Local
Firecrawl Local ist nicht der vollständige Firecrawl-Server. Das README listet auf, was fehlt:
- Lokal keine
json- odersummary-Formate. Lokale Scrapes überspringen sie mit einer Warnung, da sie ein Modell benötigen. - Keine Browser-
actions. Klick-, Scroll- und Tippschritte werden ignoriert. - Screenshots benötigen Chrome.
- Jobs leben im Arbeitsspeicher. Crawl- und Batch-Jobs laufen eine Stunde nach ihrem Start ab und gehen verloren, wenn
servestoppt. - Keine v0- oder v1-API-Routen.
Für Queues, Worker und sämtliche Formate gibt es weiterhin den vollständigen Server in apps/api, beschrieben im Self-Hosting-Leitfaden von Firecrawl.
Sicherheitsvoreinstellungen, die du kennen solltest
Die Voreinstellungen unterscheiden sich je nach Befehl, weil serve Anfragen von anderen Programmen entgegennimmt:
scrape,crawl,mapundmcplaufen für die Person an der Tastatur und können daherlocalhostund dein privates Netzwerk erreichen.scrape,crawlundmcpakzeptieren--public-only, um solche Adressen abzulehnen.servebindet an127.0.0.1und lehnt localhost- und private Ziele ab, sofern du nicht--allow-privateübergibst. Das Binden einer anderen Adresse mit--hosterfordert--token.- Link-Local- und Cloud-Metadata-Adressen werden immer blockiert, auch nach Redirects und DNS-Auflösung.
Chrome läuft headless und sandboxed mit einem Wegwerf-Profil. Beim Crawlen liest Firecrawl Local die robots.txt gemäß dem Robots Exclusion Protocol, wo Site-Betreiber sie als FirecrawlLocal ansprechen können.
Für wen Firecrawl Local geeignet ist
- Entwickler, die Scraper oder RAG-Pipelines bauen und kostenlos sowie schnell iterieren wollen, bevor sie für Cloud-Volumen zahlen.
- Nutzer von Coding-Agenten, die Web-Lesen direkt in Claude Code, Cursor oder Codex wollen, ohne jede Seite durch einen Drittanbieter zu schicken.
- Teams mit Datenvorgaben, die abgerufene Inhalte auf dem Rechner halten müssen, etwa mit
FIRECRAWL_CLOUD=off.
Weniger passend ist es, wenn du auf json-Extraktion, Browser-Actions oder langlebige Crawl-Jobs angewiesen bist. Wenn du nur Agent-Suche brauchst, sieh dir unsere Übersicht zu Open-Source-Websuche für Claude an.
Lass deinen Coding-Agent die lokale API mit der Apidog CLI testen
Sobald serve läuft, hast du eine echte HTTP-API unter localhost:3002. Bevor du eine Pipeline daran anschließt, prüfe, ob die Routen so antworten, wie dein Code es erwartet. Gib deinem Coding-Agent die Apidog CLI und einen einzigen Prompt, statt Anfragen manuell durchzuklicken.
Einmal einrichten:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Dann frage deinen Agent:
Start firecrawl-local serve in the background. Write an OpenAPI 3 file for its
local routes (POST /v2/scrape, POST /v2/map, GET /health) and import it into
Apidog project <id>. Create an environment pointing at http://localhost:3002,
add test cases that assert /health returns 200 and /v2/scrape returns
success: true with non-empty data.markdown for https://example.com, then run
them and summarize any failures.
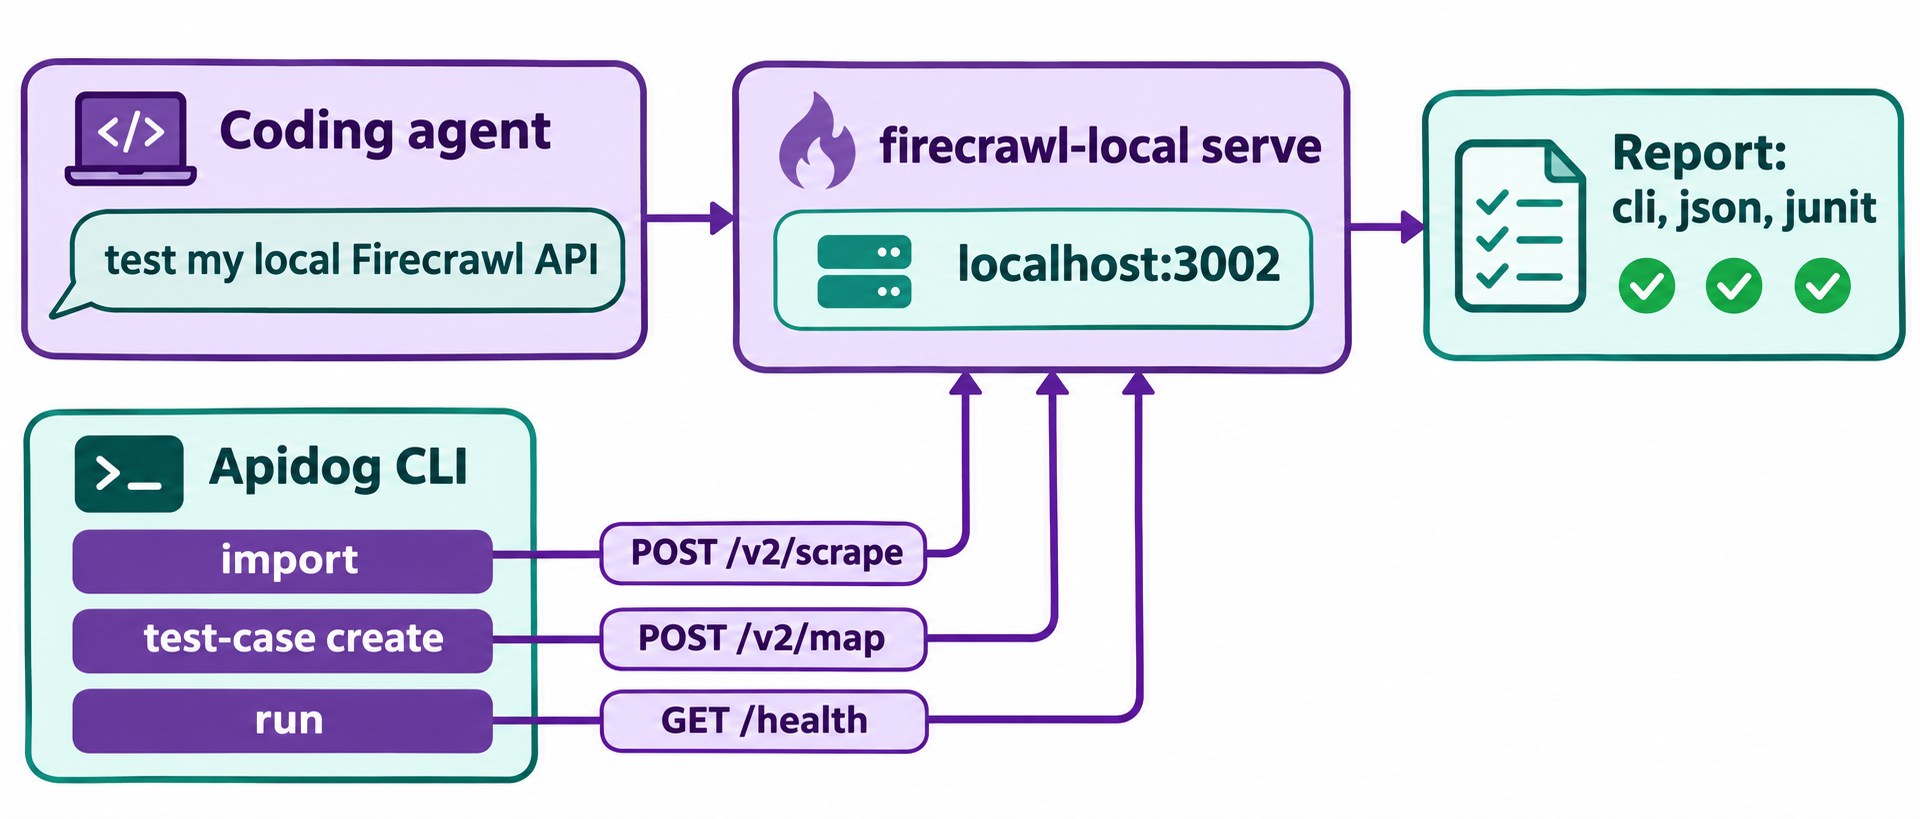
Der Agent liest das Schema, validiert sein Payload und führt Befehle wie diese aus:
firecrawl-local serve &
apidog import --project <id> --format openapi --file ./firecrawl-local-v2.yaml
apidog environment create firecrawl-local --project <id> --base-url http://localhost:3002
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file ./case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Die Apidog CLI sendet Anfragen von deinem Rechner aus, daher ist localhost:3002 erreichbar. Ersetze -r cli,json durch -r junit, dann lässt sich derselbe Lauf in die CI einbinden; unser Apidog-CLI-CI/CD-Leitfaden zeigt das Setup, und Apidog CLI in Claude Code behandelt die Agent-Seite. Der Free-Plan von Apidog umfasst Teams mit bis zu 4 Nutzern.
FAQ
Ist Firecrawl Local kostenlos? Die Binary ist Open Source unter AGPL-3.0, und lokales Scraping, Crawling und Mapping benötigen keinen API-Schlüssel. Search, der Fallback für blockierte Seiten und Alexandria gehen an Firecrawl Cloud, wobei Alexandria ein kostenloses Konto erfordert.
Kann ich meinen bestehenden Firecrawl-SDK-Code mit Firecrawl Local verwenden? Ja, für die lokalen Routen. Setze die API-URL des SDK auf http://localhost:3002. Scrape, Map, Crawl und Batch Scrape laufen lokal; v0- und v1-Routen werden nicht bereitgestellt.
Wie verhindere ich, dass Firecrawl Local die Cloud aufruft? Setze FIRECRAWL_CLOUD=off. Search und der Fallback für blockierte Seiten funktionieren dann nicht mehr, und nichts verlässt deinen Rechner außer bei einem ausdrücklichen login.
Worin unterscheidet sich Firecrawl Local von selbst gehostetem Firecrawl? Selbst gehostetes Firecrawl ist der vollständige Server in apps/api, mit Queues, Workern und jedem Format. Firecrawl Local ist eine schlankere einzelne Binary, die auf die Formate json und summary, Browser-Actions und persistente Jobs verzichtet.