
Together AI, Fireworks AI und Groq verkaufen alle dasselbe Versprechen: Richten Sie Ihren bestehenden OpenAI-Client auf eine neue Basis-URL, tauschen Sie den Schlüssel aus, und Sie bekommen Open-Weight-Modelle zu einem Bruchteil der Kosten. Dieses Versprechen stimmt. Was nicht stimmt, ist, dass der Vergleich ihrer kostenlosen Tarife so einfach wäre, wie drei Zahlen nebeneinanderzustellen, denn zwei der drei Anbieter veröffentlichen überhaupt keine feste Zahl.
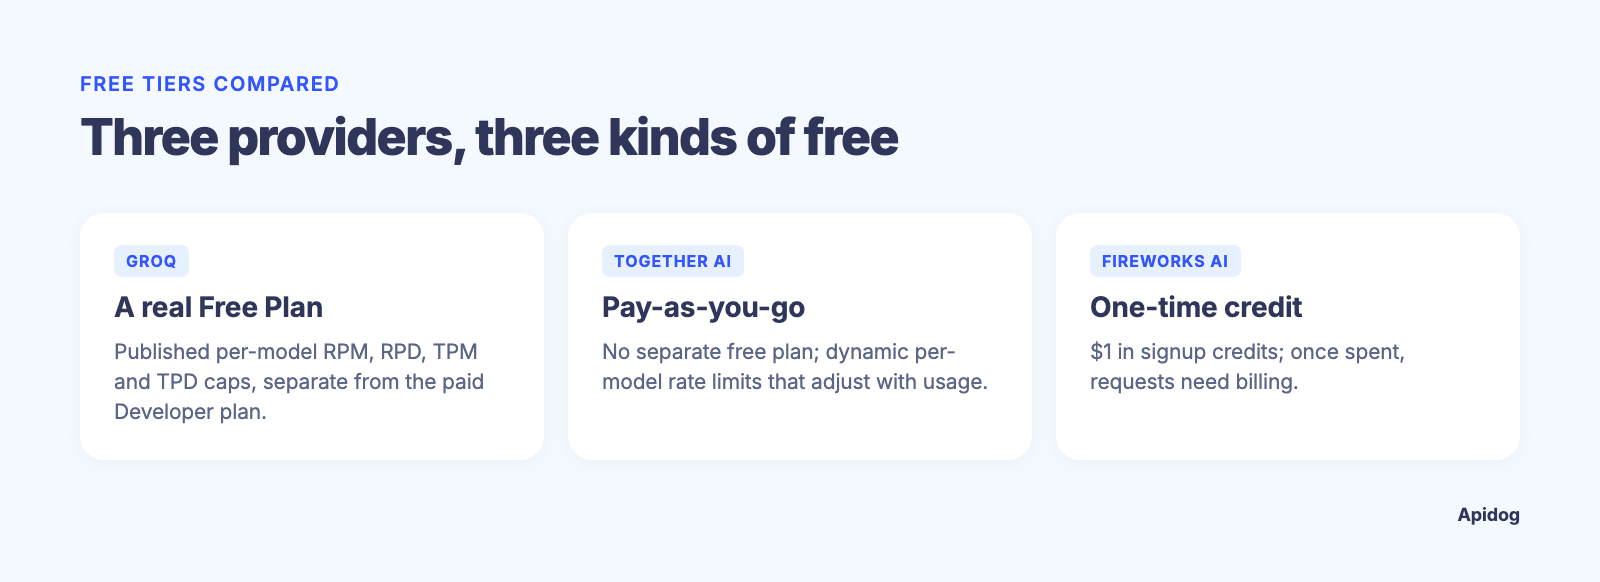
Groq ist die Ausnahme: Auf der Seite mit den Rate-Limits werden tatsächlich echte Free-Plan-Zahlen veröffentlicht, pro Modell, in einem Tab, den die meisten Leser überfliegen, auf dem Weg zum danebenliegenden Developer-Plan-Tab. Together AI hat uns in den eigenen Docs unmissverständlich mitgeteilt, dass es keine festen, pro Modell gültigen Limits gibt, die es veröffentlichen könnte; Ihre Obergrenze verschiebt sich mit Ihrer Nutzung. Fireworks AI bindet seinen kostenlosen Zugang an ein einmaliges Guthaben statt an eine Tarifstufe. Drei verschiedene Designs, und ein Artikel à la „Welcher kostenlose Tarif ist größer“ kann das trotzdem nicht auf eine einzige Zahl reduzieren.
TL;DR
Groq, Together AI und Fireworks AI stellen alle einen OpenAI-kompatiblen Endpoint bereit, sodass der Wechsel zwischen ihnen nur eine Basis-URL und ein API-Schlüssel ist, kein Rewrite. Groq unterteilt den Zugang in einen Free-Plan und einen kostenpflichtigen Developer-Plan und veröffentlicht – anders als die beiden anderen – echte Free-Plan-Zahlen pro Modell, etwa 30 RPM / 1K RPD / 8K TPM / 200K TPD bei gpt-oss-120b und gpt-oss-20b. Together AI veröffentlicht keine festen Free-Tier-Zahlen; laut den eigenen Docs bewegen sich die Limits dynamisch mit Ihrer aktuellen Kapazität und der jüngsten erfolgreichen Nutzung. Fireworks AI gibt neuen Konten ein einmaliges Guthaben (1 $, laut der Preisseite) statt eines wiederkehrenden kostenlosen Kontingents. Die Entscheidung, die mehr zählt als die Schlagzeilen-Zahl, ist, welche Modelle Sie tatsächlich brauchen und wie sich die Obergrenze jedes Anbieters verhält, sobald Sie sie erreichen. Apidog lässt Sie eine Anfrage speichern und die Basis-URL sowie den Schlüssel pro Umgebung austauschen, sodass Sie alle drei selbst messen können, statt einer Tabelle zu vertrauen.
Eine API-Form, drei Schlüssel
Alle drei Anbieter spiegeln bewusst das Schema der OpenAI Chat Completions. Deshalb lesen sich Migrationsanleitungen für diese Tools jedes Mal gleich: base_url ändern, den Authorization-Header ändern, den Rest Ihres Codes behalten. Groqs OpenAI-kompatible Basis ist https://api.groq.com/openai/v1/. Die von Together AI ist https://api.together.ai/v1, direkt in seinen Quickstart-Docs bestätigt. Die von Fireworks AI ist https://api.fireworks.ai/inference/v1, laut seinem OpenAI-Kompatibilitätsleitfaden.
Diese gemeinsame Form ist der Grund, warum ein direkter Vergleichstest sich lohnt: Einen vierten oder fünften Anbieter einzubinden kostet Minuten, kein Redesign. Die Mechanik für die Verwaltung einer solchen Multi-Provider-Konfiguration behandeln wir in so verwalten Sie Basis-URLs über Umgebungen hinweg in Apidog, und wenn Sie Routing-Optionen allgemeiner abwägen, zeigt unsere Übersicht der OpenRouter-Alternativen, wo diese drei in dieses Bild passen.
Was Sie über jeden kostenlosen Tarif tatsächlich verifizieren können
Hier ist der Vergleich, der ausschließlich auf dem basiert, was die einzelnen Anbieter mit Stand September 2026 öffentlich angeben. Wo ein Anbieter keine Zahl offenlegt, sagt die Tabelle das, statt zu raten.
| Groq | Together AI | Fireworks AI | |
|---|---|---|---|
| Modell des kostenlosen Zugangs | Free-Plan (getrennt vom kostenpflichtigen Developer-Plan) | Pay-as-you-go ab der Anmeldung; keine eigene Bezeichnung „Free Plan“ | Einmaliges Anmeldeguthaben |
| Dokumentiertes kostenloses Kontingent | Pro Modell veröffentlicht: gpt-oss-120b/gpt-oss-20b 30 RPM, 1K RPD, 8K TPM, 200K TPD; compound 30 RPM, 250 RPD, 70K TPM (laut Groq Rate Limits, gelesen am 15.09.2026) |
Nicht als feste Zahlen veröffentlicht; als dynamisch pro Organisation beschrieben | 1 $ kostenlose Credits laut Fireworks-Preisseite |
| Wie die Limits gestaltet sind | Modellspezifische RPM/RPD/TPM/TPD-Obergrenzen, durchgesetzt auf Organisationsebene | Dynamische Rate pro Modell, passt sich Ihrer aktuellen Kapazität und der jüngsten erfolgreichen Nutzung an | Ausgabenbasiert; sobald das Guthaben verbraucht ist, müssen für Anfragen die Abrechnung aktiviert sein |
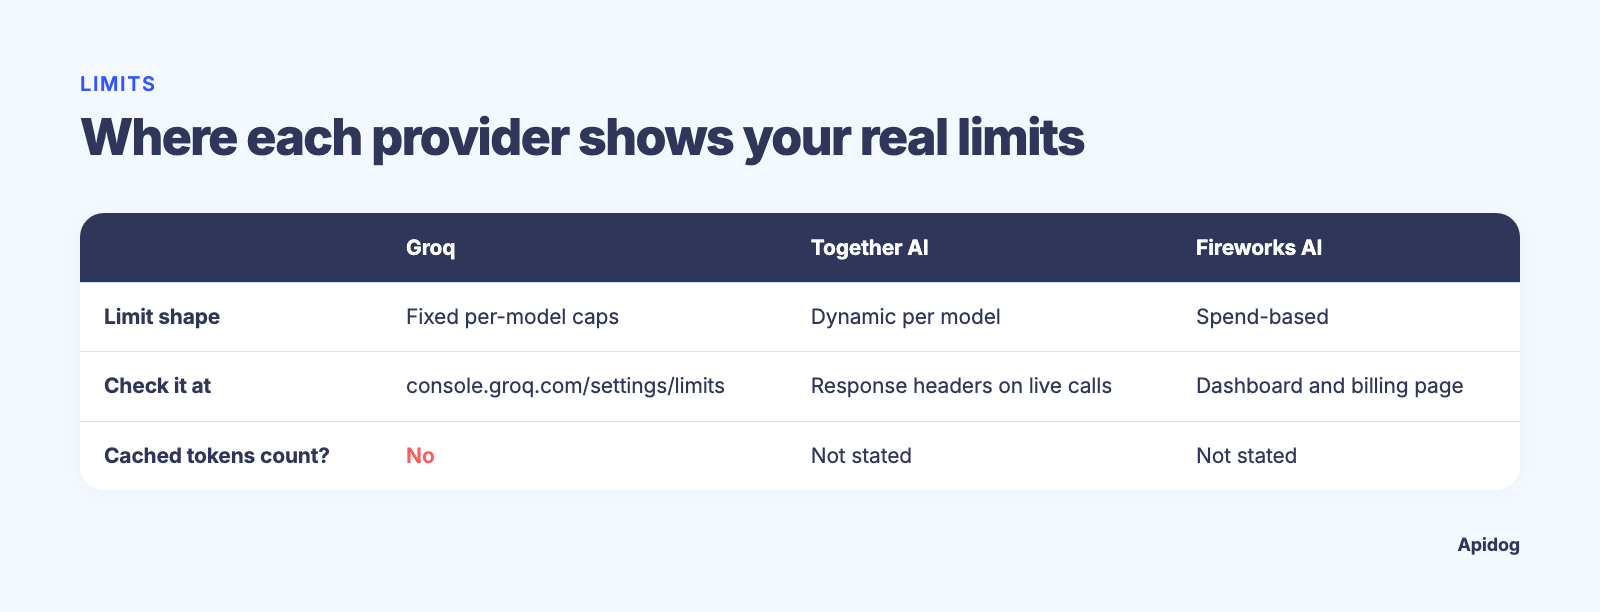
| Wo Sie Ihre eigenen Zahlen prüfen können | console.groq.com/settings/limits |
Antwort-Header bei Live-Aufrufen, z. B. x-ratelimit-reset |
Konto-Dashboard und Abrechnungsseite |
| Zählen gecachte Tokens gegen die Limits? | Nein, laut Groqs eigenen Docs | In den von uns geprüften Seiten nicht angegeben | In den von uns geprüften Seiten nicht angegeben |
Zwei Dinge fallen auf, sobald man tatsächlich die Quellseiten liest statt einer Spec-Sheet-Zusammenfassung. Erstens sind die oben genannten Free-Plan-Zahlen von Groq veröffentlichte Standardwerte; dieselbe Seite enthält auch einen Developer-Plan-Tab mit höheren Obergrenzen, und console.groq.com/settings/limits ist maßgeblich, falls Ihre abweichen. Zweitens ist das Rate Limiting von Together AI überhaupt keine Tabelle. Die eigene Rate-Limits-Seite stellt unmissverständlich fest, dass „es keine festen, pro Modell veröffentlichten Limits gibt“ und dass Ihre Obergrenze mit „anhaltendem, erfolgreichem Traffic“ steigt. Das ist ein deutlich anderes Modell als eine statische Free-Tier-Zeile, und es bedeutet, dass die ehrliche Antwort auf „Wie hoch ist Together's kostenloses RPM“ lautet: „Prüfen Sie Ihre Antwort-Header“ – und nicht eine Zahl aus einer Tabelle.
Wenn Sie die Deep Dives zu einzelnen Anbietern mit überprüfbaren Zahlen für jeweils ein Produkt möchten, sehen Sie sich unsere Begleittexte zum kostenlosen Tarif der Groq API und zum kostenlosen Tarif der Cerebras API an. Dieser Artikel ist der Hub; die beiden anderen erledigen die anbieterspezifische Recherche in voller Tiefe.
Anfragen vs. Tokens, fest vs. dynamisch
Der eigentliche Design-Unterschied zwischen diesen dreien ist nicht die Größe des kostenlosen Kontingents, sondern die Form der Obergrenze.
Das Modell von Groq ist das, das die meisten Entwickler bereits aus dem Umgang mit Rate Limits anderswo kennen: eine feste Obergrenze pro Zeitfenster, unterteilt in RPM, RPD, TPM und TPD, und sie gilt auf Organisationsebene statt pro API-Schlüssel. Das bedeutet: Wenn Sie drei Schlüssel für drei Dienste unter einem Groq-Konto anlegen, teilen sie sich einen Pool. Unser allgemeiner Leitfaden zu GPT-API-Rate-Limits behandelt dieselbe RPM/TPM-Struktur ausführlicher, falls Sie noch nicht mit tokenbasierten Obergrenzen gearbeitet haben.
Das Modell von Together AI belohnt gleichmäßigen, erfolgreichen Traffic, statt Burst-Traffic mit einer harten Wand zu bestrafen. Ein ruhiges Konto und ein stark belastetes, aber gutartiges Konto bekommen nicht dieselbe Obergrenze, denn die Obergrenze passt sich an die eigene jüngere Historie Ihres Kontos und an die aktuelle Live-Kapazität des Modells in diesem Moment an. Das ist eine gute Nachricht, wenn Ihre Workload verlässlich ist, und eine echte Unbekannte, wenn Ihr Traffic von Natur aus bursty ist.
Fireworks AI umgeht das Rate-Limit-Design für neue Nutzer fast vollständig, indem es die kostenlose Phase an ein Dollar-Guthaben statt an ein Anfrage-Ratenfenster bindet. Sie sind nicht dadurch begrenzt, wie schnell Sie die API aufrufen, sondern dadurch, wie viel Ihre Aufrufe kosten, bevor das Guthaben aufgebraucht ist. Das verschiebt die Planungsfrage von „Wie viele Anfragen pro Minute“ zu „Wie viele Tokens bekommt man für 1 $ beim Pro-Token-Preis dieses Modells“, was vollständig davon abhängt, welches Modell Sie wählen.
Es sind unterschiedliche Wetten darauf, wogegen ein „kostenloser“ Tarif schützen soll: anhaltendes Volumen, Burst-Spitzen oder Gesamtausgaben. Gegen welches Szenario Sie auch immer entwickeln, irgendwann werden Sie auf einen 429 stoßen, und wie ein Anbieter diesen Moment signalisiert, ist genauso wichtig wie die Zahl, die ihn ausgelöst hat. Unser Leitfaden zur Fehlerbehebung bei überschrittenen Rate Limits erklärt, wie Sie diese Antwort-Header lesen und eine Retry-Logik aufbauen, die das Problem nicht verschlimmert.
Beweisen Sie es selbst in fünf Minuten
Angesichts der Tatsache, wie viele dieser Daten hinter einem Login-Bildschirm oder einem Live-Antwort-Header stecken, ist der schnellste Weg zu einer echten Antwort nicht ein weiterer Spec-Sheet-Artikel, sondern ein Test, den Ihr Coding-Agent gegen alle drei laufen lässt. Mit Apidog CLI ist das ein einziger Prompt. Richten Sie es einmal ein:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Das Token finden Sie in Apidog unter Kontoeinstellungen, API Access Token. Geben Sie dem Agenten dann einen einzigen Prompt:
Use Apidog CLI on project <id>. Create Groq, Together and Fireworks environments
with the OpenAI-compatible base URLs from this article and a comparable model id
in a MODEL variable. Add POST /chat/completions with Bearer auth from {{API_KEY}}
and one test case with an identical prompt and max_tokens. Run it once per
environment with that provider's key, then compare status, latency and the
x-ratelimit headers.
Die Befehle, die er ausführt, geprüft gegen Apidog CLI 2.2.7:
apidog environment create Groq --project <id> --base-url https://api.groq.com/openai/v1
apidog environment create Together --project <id> --base-url https://api.together.ai/v1
apidog environment create Fireworks --project <id> --base-url https://api.fireworks.ai/inference/v1
apidog cli-schema validate test-case-create --file chat-case.json
apidog test-case create --project <id> --file chat-case.json
apidog run --test-case <caseId> --project <id> -e <togetherEnvId> \
  --env-var "API_KEY=$TOGETHER_API_KEY" -r cli,json
Der Anbieterwechsel ist jetzt eine Umgebungs-ID, kein Rewrite. Die Header sind der Ort, an dem die dynamische Obergrenze von Together AI in Echtzeit sichtbar wird und an dem Sie bestätigen können, dass Ihre Groq-Organisation mit der veröffentlichten Free-Plan-Tabelle übereinstimmt. Behalten Sie auch die Latenz im Vergleich: Ein Modell, das technisch kostenlos, aber langsam ist, ist nicht wirklich günstiger, sobald man die Zeit mitzählt, die man damit verbringt, es zu umgehen. Das verwandelt drei Marketingseiten in einen vergleichbaren Datensatz aus Ihrem eigenen Konto. Führen Sie den Vergleich kontinuierlich innerhalb eines größeren Agent-Builds aus? Unser Leitfaden zu API-Testing-Tools für KI-Agenten behandelt das, und Apidog CLI in Cursor zeigt das Agenten-Setup.
Welcher kostenlose Tarif zu Ihrem Anwendungsfall passt
Rein auf Basis dessen, was heute überprüfbar ist, ein paar ehrliche Empfehlungen:
- Vorhersagbare, pro Modell geltende Obergrenzen, die Sie ohne Login lesen können: Groq veröffentlicht echte Free-Plan-Zahlen (30 RPM / 1K RPD / 8K TPM / 200K TPD bei den
gpt-oss-Modellen), und sein Kontextfenster von 131.072 Tokens überllama-3.1-8b-instant,llama-3.3-70b-versatileund dieopenai/gpt-oss-Modelle deckt ein breites Spektrum an Open-Weight-Workloads über einen einzigen Endpoint ab. - Gleichmäßiger, gutartiger Traffic, kein Interesse daran, Rate Limits zu verfolgen: Das dynamische Modell von Together AI passt zu diesem Muster; anhaltende erfolgreiche Nutzung erhöht Ihre eigene Obergrenze mit der Zeit, statt Sie bei einer am ersten Tag festgelegten Zahl zu deckeln.
- Null Einrichtungsaufwand, und es ist in Ordnung, an eine Ausgabengrenze zu stoßen: Der guthabenbasierte kostenlose Zugang von Fireworks AI testet ab dem ersten Aufruf echte Pro-Token-Preise – nützlich, wenn die eigentliche Frage die Kosten im großen Maßstab sind und nicht die Anzahl der Anfragen.
Alle drei hosten unterschiedliche Teilmengen von Open-Weight-Modellen, und ein Modell, das für Ihre Aufgabe bei einem Anbieter passt, gibt es bei einem anderen möglicherweise nicht.
FAQ
Nutzen Together AI, Fireworks AI und Groq alle das OpenAI SDK? Ja. Alle drei dokumentieren OpenAI-kompatible Endpoints, sodass die Standard-Client-Bibliothek openai gegen jeden von ihnen funktioniert, sobald Sie Basis-URL und Schlüssel ändern.
Welcher Anbieter hat den größten kostenlosen Tarif? Nicht in einer Weise, die man direkt vergleichen könnte. Groq veröffentlicht echte Free-Plan-Zahlen pro Modell (30 RPM / 1K RPD / 8K TPM / 200K TPD bei gpt-oss-120b/gpt-oss-20b), Together AI legt überhaupt keine feste Zahl fest, und Fireworks AI bindet den kostenlosen Zugang an ein einmaliges Guthaben statt an ein Kontingent. Prüfen Sie console.groq.com/settings/limits, falls Ihre Werte abweichen.
Gelten Rate Limits pro API-Schlüssel oder pro Konto? Bei Groq gelten die Limits auf Organisationsebene, sodass mehrere Schlüssel unter einem Konto denselben Pool teilen, laut der eigenen Rate-Limits-Dokumentation. Together AI und Fireworks AI sagen das in den von uns geprüften Seiten nicht ausdrücklich; verifizieren Sie es in Ihrem eigenen Dashboard, bevor Sie etwas anderes annehmen.
Was passiert, wenn ich bei einem dieser Anbieter ein Rate Limit erreiche? Sie erhalten eine HTTP-429-Antwort. Die Details unterscheiden sich; lesen Sie unseren Leitfaden zu überschrittenen Rate Limits, um zu erfahren, wie Sie die Retry-Header lesen, die die meisten OpenAI-kompatiblen APIs zurückgeben, und um Backoff-Logik aufzubauen, statt zu raten.
Gibt es einen schnelleren Weg, diese zu vergleichen, als jede Doc-Seite selbst zu lesen? Lassen Sie Ihren Coding-Agenten einen einzigen Apidog-CLI-Testfall gegen drei Umgebungen ausführen, wie oben beschrieben. Zwanzig Minuten mit Apidog CLI verraten Ihnen mehr über Ihre tatsächliche Workload als jede Vergleichstabelle, diese eingeschlossen.