
Um Qwen 3.8 27B lokal auszuführen, installieren Sie Ollama und führen Sie ollama pull qwen3.8:27b und danach ollama run qwen3.8:27b aus. Der Standard-Build ist ein 18-GB-Download in 4 Bit, daher brauchen Sie eine GPU mit 24 GB VRAM oder einen Mac mit 32 GB Unified Memory. Die Gewichte stehen unter Apache-2.0, das Modell selbst kostet also nichts. Ihre einzigen Kosten sind Hardware und Strom.
Das war die Kurzfassung. Der Rest dieses Leitfadens behandelt die vier Laufzeitumgebungen, die sich lohnen (Ollama, LM Studio, llama.cpp und MLX), wie viel Speicher jedes Quant benötigt, welche Geschwindigkeit Sie auf echter Hardware erwarten können und wie Ihr Coding-Agent den lokalen Endpoint mit der Apidog CLI testen kann, sobald er läuft.
Neu in der Familie? Was Qwen 3.8 ist behandelt das 2,4-Billionen-Parameter-Max-Flaggschiff. Dieser Leitfaden dreht sich um seinen kleinen, dichten Bruder, der auf Ihren Schreibtisch passt.
Was ist Qwen 3.8 27B?
Qwen 3.8 27B ist ein dichtes Vision-Language-Modell mit 27 Milliarden Parametern von Alibabas Qwen-Team, veröffentlicht im August 2026 unter Apache-2.0. Es verarbeitet Text, Bilder und Video, denkt standardmäßig vor der Antwort und hat ein natives 262.144-Token-Kontextfenster, das sich mit YaRN-Scaling auf 1 Million Token erweitern lässt.
Die offizielle Modellkarte listet diese Specs auf:
| Spec | Qwen 3.8 27B |
|---|---|
| Parameter | 27B dicht (auf dem Hub sind 28B inklusive Vision-Encoder gelistet) |
| Ebenen | 64, eine Hybridarchitektur aus Gated-DeltaNet- und Gated-Attention-Blöcken |
| Kontext | 262.144 nativ, bis zu 1.000.000 mit YaRN |
| Eingaben | Text, Bild, Video |
| Thinking | Standardmäßig aktiviert, reasoning_effort von xhigh, medium oder low |
| Extras | Multi-Token-Prediction-(MTP)-Ebenen |
| Lizenz | Apache-2.0 |
Auf Qwens eigener Benchmark-Tabelle erreicht es 61,7 auf SWE-bench Pro, 73,0 auf Terminal Bench 2.1 und 89,2 auf GPQA Diamond. Das sind Herstellerzahlen. Unsere Qwen-3.8-Benchmark-Analyse erklärt, wie man diese Tabelle liest, einschließlich welcher Zeilen Qwen intern selbst erstellt hat.
Warum das lokal relevant ist: Ein dichtes 27B-Modell in 4 Bit passt auf eine einzelne Consumer-GPU, mit Tool Calling, Vision und Thinking in derselben Datei.
Wie viel RAM und VRAM brauchen Sie für Qwen 3.8 27B?
Planen Sie die Dateigröße Ihres Quants plus 3 bis 6 GB für den KV-Cache und die Laufzeit ein. Beim Standard-Q4_K_M bedeutet das 24 GB VRAM auf einer GPU oder einen 32-GB-Mac.
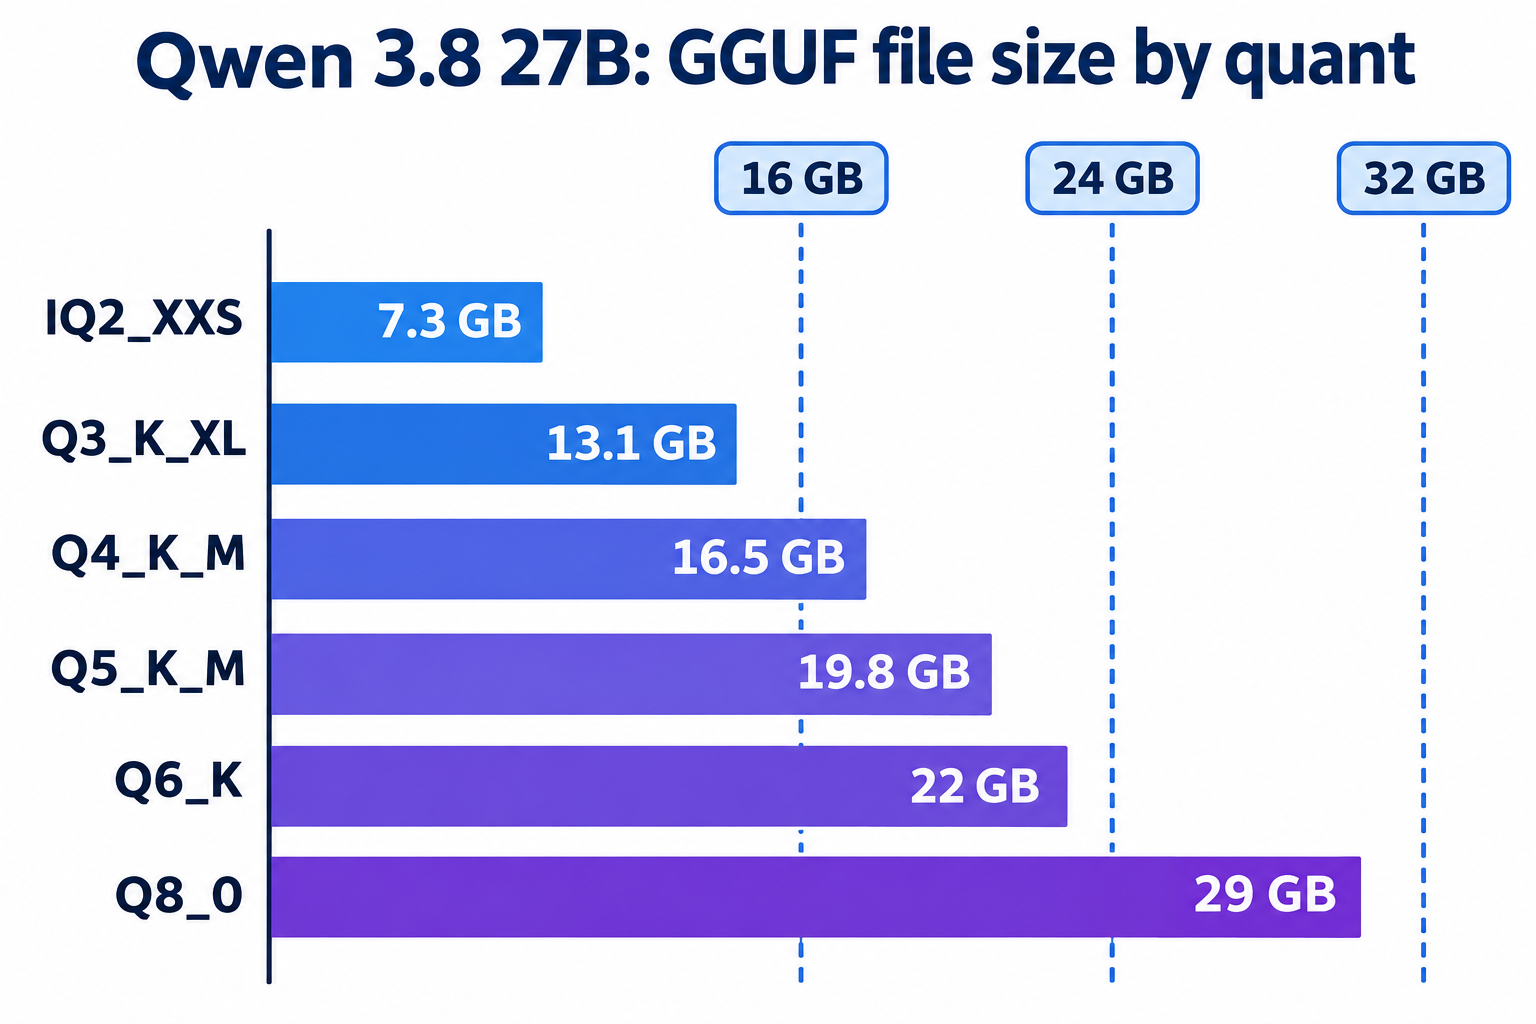
Hier sind die GGUF-Dateigrößen aus unsloths Quant-Repository, geprüft am 9. November 2026:
| Quant | Dateigröße | Realistische Hardware |
|---|---|---|
| UD-IQ2_XXS | 7,27 GB | 16-GB-Mac oder 12-GB-GPU, spürbarer Qualitätsverlust |
| UD-Q3_K_XL | 13,1 GB | 16-GB-GPU, 24-GB-Mac |
| UD-Q4_K_M | 16,5 GB | 24-GB-GPU, 32-GB-Mac (der Sweet Spot) |
| UD-Q5_K_M | 19,8 GB | 24-GB-GPU mit kurzem Kontext, 32-GB-Mac |
| UD-Q6_K | 22 GB | 32-GB-GPU, 48-GB-Mac |
| Q8_0 | 29 GB | 48-GB-GPU, 64-GB-Mac |
Der Vision-Projektor (mmproj-F16.gguf) kommt mit 928 MB hinzu, wenn Sie Bildeingaben wollen. Ollamas Standard-Tag qwen3.8:27b ist 18 GB groß, weil Vision enthalten ist.
Die Kontextlänge ist der versteckte Kostenfaktor. llm-speeds Planungsrechnung beziffert Q4_K_M auf rund 21,9 GB bei einem 32.000-Token-Kontext. Deshalb sind 24-GB-Karten das praktische Minimum für Q4 – und deshalb sollten Sie das volle 262K-Fenster nur laden, wenn Sie Speicher im Überfluss haben.
Auf Macs gilt: macOS reserviert einen Teil des Unified Memory für das System. Ein 24-GB-Mac kann Q4_K_M technisch laden, aber für Kontext oder Ihren Browser bleibt kaum Luft. Dort würden wir Q3_K_XL wählen.
Wie schnell läuft Qwen 3.8 27B lokal?
Erwarten Sie etwa 38 bis 44 Token pro Sekunde auf einer RTX 3090 oder 4090 bei Q4_K_M mit llama.cpp und 65 bis 75 auf einer RTX 5090. Ein Mac Studio mit M3 Ultra dekodiert mit rund 25 bis 27 Token pro Sekunde.
Wir haben das nicht selbst benchmarket. Es sind gemessene Läufe, veröffentlicht von llm-speed, mit der dort angegebenen Hardware und Laufzeit:
| Hardware | Quant / Laufzeit | Decode tok/s | Prefill tok/s |
|---|---|---|---|
| RTX 3090 24 GB | Q4_K_M, llama.cpp | 38,6 (kurzer Chat, 4K ctx) | 482 |
| RTX 4090 24 GB | Q4_K_M, llama.cpp | 43,4 (kurzer Chat, 4K ctx) | 448 |
| RTX 5090 32 GB | Q4_K_M, llama.cpp | 75,2 (kurzer Chat, 4K ctx) | 563 |
| L40S 45 GB | Q4_K_M, llama.cpp | 34,3 (kurzer Chat) | 569 |
| M3 Ultra 96 GB | Q4_K_M, llama.cpp | 25,2 (kurzer Chat) | 45 |
| M3 Ultra 96 GB | 4-bit, MLX 0.31.3 | 27,3 (kurzer Chat) | 12 |
Die Decode-Geschwindigkeit sinkt auf GPUs mit größerem Kontext kaum: Der 4090 schaffte nach einem 33.133-Token-Prompt noch 39,0 tok/s. Beim Prefill hinken Macs hinterher. Bei einem 11.827-Token-Prompt verarbeitete der M3 Ultra etwa 283 tok/s, gegen grob 2.000 bis 3.000 beim 4090 – ein großer Codebase bedeutet also Zehnersekunden vor dem ersten Token.
Thresholding frisst auch Ihr Zeitbudget. Als Simon Willison ein lokales Qwen 3.8 27B bat, Spiele aus rohen Modellgewichten zu identifizieren, dauerte eine Antwort 46 Minuten und 43.506 Reasoning-Tokens. Für Alltagsaufgaben senken Sie reasoning_effort auf low oder schalten Thinking ganz aus.
Qwen 3.8 27B mit Ollama ausführen
Ollama ist der schnellste Weg auf jedem Betriebssystem. Installieren Sie es von ollama.com und führen Sie dann aus:
ollama pull qwen3.8:27b
ollama run qwen3.8:27b
Auf Apple Silicon probieren Sie das Tag qwen3.8:27b-mlx, das das MLX-Backend bei denselben 18 GB nutzt.
Ollamas Standardkontext ist klein, was lange Agent-Sitzungen bricht. Erhöhen Sie ihn, bevor Sie den Server starten:
OLLAMA_CONTEXT_LENGTH=32768 ollama serve
Ollama stellt außerdem eine OpenAI-kompatible API unter http://localhost:11434/v1 bereit, sodass jedes OpenAI-SDK funktioniert, indem Sie nur die Base-URL ändern:
curl http://localhost:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "qwen3.8:27b",
       "messages": [{"role": "user", "content": "Write a Python function that validates an email address."}]}'
Soll es in einen Coding-Agent? Ollama bringt Start-Shortcuts mit: ollama launch claude --model qwen3.8 startet Claude Code gegen das lokale Modell, und ollama launch opencode --model qwen3.8 macht dasselbe für OpenCode.
Mit LM Studio ausführen
LM Studio ist die Wahl, wenn Sie eine GUI und modellbezogene Ladeeinstellungen wollen. Suchen Sie nach Qwen 3.8 27B, laden Sie den Build lmstudio-community/Qwen3.8-27B-GGUF bei Q4_K_M (16,8 GB) herunter und laden Sie ihn.
Eine Einstellung ist entscheidend: Erhöhen Sie die Kontextlänge beim Laden des Modells. Simon Willison stellte fest, dass der standardmäßige 8.192-Token-Kontext bei seinem langen Prompt mit Fehlern scheiterte, und musste ein größeres Fenster laden.
Öffnen Sie dann den Entwickler-Tab und starten Sie den lokalen Server, oder führen Sie lms server start im Terminal aus. Der OpenAI-kompatible Endpoint liegt unter http://localhost:1234/v1.
Mit llama.cpp ausführen
llama.cpp gibt Ihnen die größte Kontrolle und treibt die meisten der oben genannten Benchmark-Läufe an. Unter macOS oder Linux:
brew install llama.cpp

llama-server -hf unsloth/Qwen3.8-27B-GGUF:UD-Q4_K_M \
  --jinja -c 32768 -ngl 99 \
  --temp 1.0 --top-p 0.95 --top-k 20 \
  --port 8080
-hf lädt das Quant direkt von Hugging Face herunter, --jinja wendet die Chat-Vorlage des Modells an (nötig für Tool Calls und Thinking), -c setzt den Kontext und -ngl 99 legt alle Ebenen auf die GPU. Die Sampling-Werte sind Qwens Empfehlungen für den Thinking-Modus. Für den Nicht-Thinking-Modus empfiehlt die Modellkarte Temperature 0.7, top_p 0.8, top_k 20 und presence_penalty 1.5.
Um Thinking für eine einzelne Anfrage auszuschalten, senden Sie "chat_template_kwargs": {"enable_thinking": false} im Body.
Mit MLX auf einem Mac ausführen
MLX ist Apples eigenes Array-Framework und auf Apple Silicon beim Decode meist die schnellste Laufzeit. Installieren Sie mlx-lm und nutzen Sie die 4-Bit-Konvertierung von mlx-community:
pip install mlx-lm

mlx_lm.generate --model mlx-community/Qwen3.8-27B-4bit \
  --prompt "Explain the difference between a mutex and a semaphore." \
  --max-tokens 1024

mlx_lm.server --model mlx-community/Qwen3.8-27B-4bit --port 8080
mlx_lm.server stellt eine OpenAI-kompatible Route /v1/chat/completions bereit. Die mlx-community-Organisation veröffentlicht außerdem 8-Bit-, mxfp4- und MTP-Varianten, wenn Sie Speicher gegen Qualität oder Geschwindigkeit tauschen wollen.
Ihren Coding-Agenten den lokalen Endpoint mit der Apidog CLI testen lassen
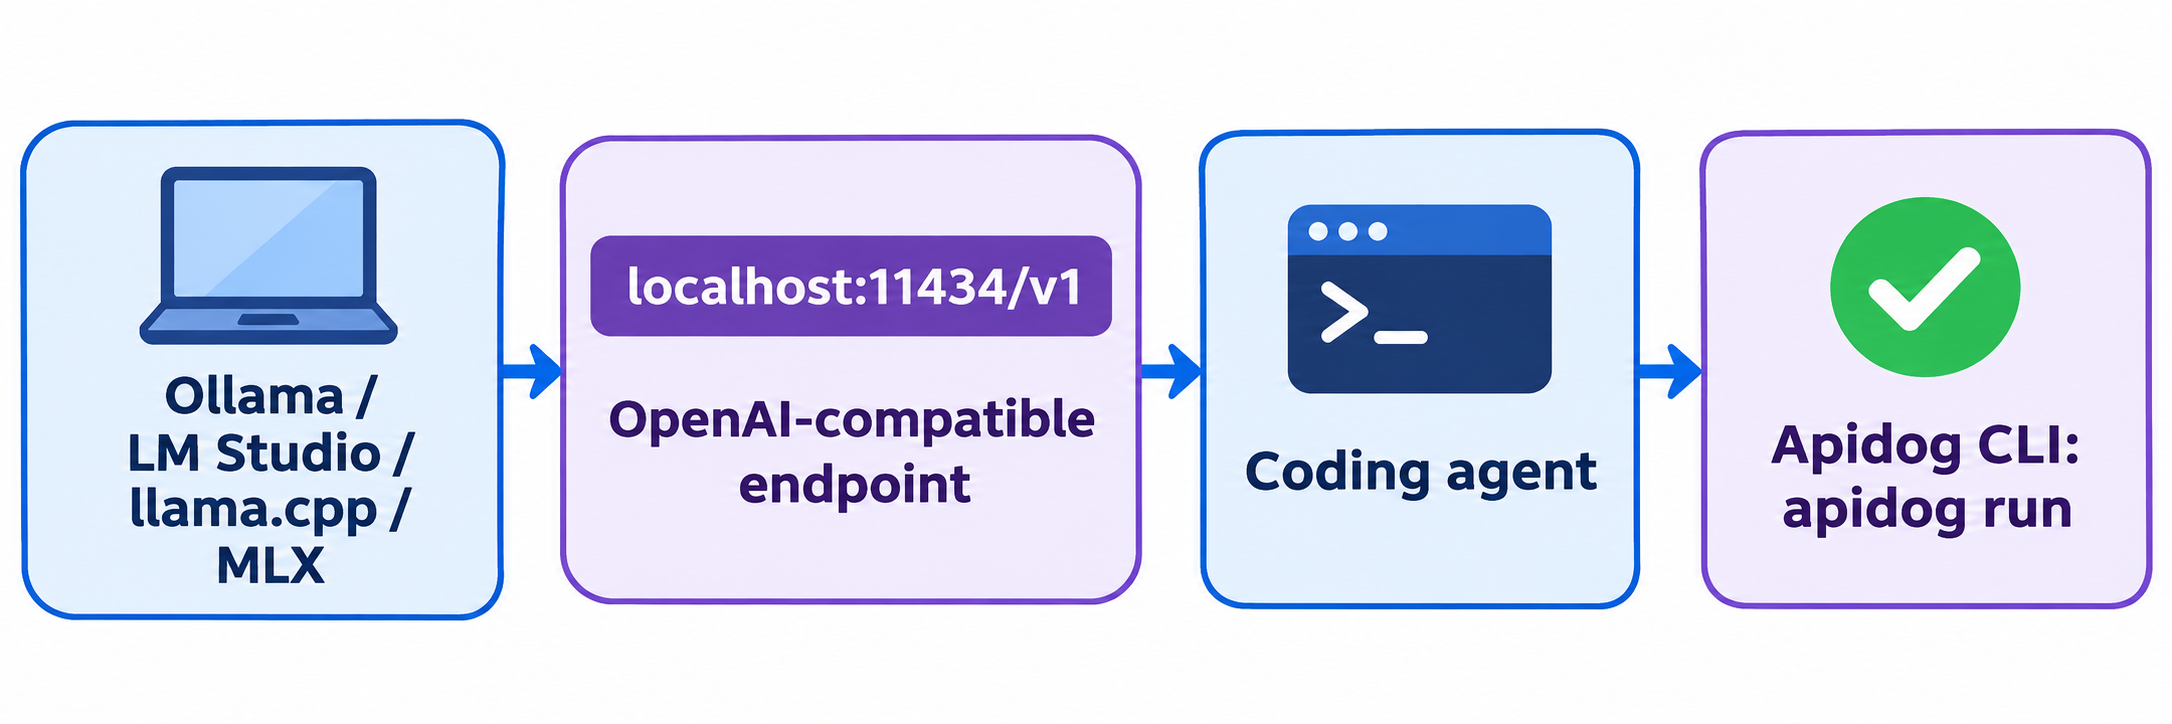
Jede Laufzeitumgebung bedient dieselbe OpenAI-kompatible Struktur, aber jede behandelt Thinking-Blöcke, Tool Calls und Timeouts anders. Bevor Sie eine App auf localhost zeigen lassen, lassen Sie Ihren Coding-Agenten einen wiederholbaren Test mit der Apidog CLI aufbauen – so zeigt sich eine kaputte Vorlage oder ein Kontextlimit in Sekunden statt mitten in der Aufgabe.
Einmalige Einrichtung:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Geben Sie dann Claude Code, Codex oder Cursor einen Prompt:
In Apidog project <projectId>, create an environment "qwen-local" with base URL
http://localhost:11434/v1. Add a POST /chat/completions endpoint for model
qwen3.8:27b, then a test case that asserts status 200, a non-empty
choices[0].message.content, usage.completion_tokens > 0, and a second request
with a tools array that returns a tool_calls entry. Run it and summarize failures.
Der Agent liest jedes Payload-Schema, validiert sein JSON, erstellt die Ressourcen und führt den Testfall aus:
apidog environment create qwen-local --project <projectId> --base-url http://localhost:11434/v1
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema get test-case-create
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json --timeout-request 300000
Das lange --timeout-request ist hier wichtig: Ein 27B-Modell im Thinking-Modus kann auf einem Mac Minuten brauchen. Ändern Sie die Base-URL auf http://localhost:1234/v1 oder :8080/v1, und derselbe Testfall prüft LM Studio, llama.cpp oder MLX. Weitere Agent-Setups finden Sie in Apidog CLI in Claude Code und in der Befehlsreferenz für apidog run. Apidogs Free-Plan umfasst bis zu 4 Nutzer.
Lokal vs. die gehostete Qwen-3.8-API
Lokales Ausführen hält Prompts auf Ihrem Rechner, funktioniert offline und kostet nichts pro Token. Der Kompromiss sind Geschwindigkeit und Skalierung: Ein gehosteter Endpoint bedient das deutlich größere Qwen 3.8-Max mit 1M Kontext und ohne Prefill-Wartezeit. Wenn Sie das Flaggschiff brauchen, lesen Sie unseren Qwen-3.8-API-Leitfaden oder die kostenlosen Zugangsmöglichkeiten. Für agentisches Codieren mit beiden Größen vergleicht Qwen 3.8 für Coding die Harness-Setups.
FAQ
Ist Qwen 3.8 27B kostenlos lokal ausführbar? Ja. Die Gewichte stehen unter Apache-2.0 auf Hugging Face, und Ollama, LM Studio, llama.cpp und MLX sind kostenlos. Sie zahlen nur für Hardware und Strom.
Kann ich Qwen 3.8 27B auf einem 16-GB-Mac ausführen? Nur mit 2-Bit-Quants wie UD-IQ2_XXS (7,27 GB) und kurzem Kontext, und die Qualität fällt spürbar ab. Ein 32-GB-Mac mit Q4_K_M ist die komfortable Lösung.
Läuft Qwen 3.8 27B auf einer RTX 3090? Ja. Q4_K_M passt in 24 GB mit Raum für 16K bis 32K Kontext, und llm-speed maß etwa 38 Token pro Sekunde mit llama.cpp.
Wie schalte ich den Thinking-Modus aus? Senden Sie "chat_template_kwargs": {"enable_thinking": false} bei llama.cpp oder vLLM, oder senken Sie reasoning_effort auf low. Qwen empfiehlt für den Nicht-Thinking-Modus Temperature 0.7 und top_p 0.8.
Unterstützt das lokale Modell Bilder? Ja. Ollamas 18-GB-Tag enthält Vision. Bei llama.cpp laden Sie zusätzlich die Datei mmproj-F16.gguf herunter.
Was ist der Unterschied zwischen Qwen 3.8 27B und Qwen 3.8-Max? Max ist ein Mixture-of-Experts-Flaggschiff mit 2,4 Billionen Parametern, ausgeliefert über Alibabas API. 27B ist ein dichtes Modell, klein genug für eine einzelne GPU oder einen 32-GB-Mac.