
Sie können NVIDIAs neues Nemotron 3.5 Transcribe auf einer GPU ausführen und stundenlange Aufnahmen in 40 Sprachen transkribieren, ohne pro Minute zu zahlen oder Audio an irgendjemanden zu senden. Es ist das beste Open-Weight-Modell im Hugging Face Open ASR Leaderboard, es wird unter der kommerziell nutzbaren OpenMDW-1.1-Lizenz veröffentlicht, und NVIDIA hat am Veröffentlichungstag, dem 28. Oktober 2026, BF16-, FP8- und NVFP4-Gewichte publiziert.
Dieser Leitfaden behandelt die benötigte Hardware, die drei Möglichkeiten, es auszuführen (vLLM, SGLang-Omni und Transformers), die exakten Befehle aus der offiziellen Modellkarte und die Einstellungen, die Leute aus dem Tritt bringen. Alle Befehle wurden am 29. Oktober 2026 aus der Modellkarte kopiert.
Neu beim Modell? Unser kostenloser Leitfaden erklärt, was es leistet und wie es abschneidet. Keine GPU? Die gehostete API kostet 0,002 $ pro Minute.
Warum lokal ausführen
- Keine Abrechnung pro Minute. Bei DeepInfras 0,002 $ pro Minute kosten 10.000 Stunden 1.200 $. Auf Ihrer eigenen GPU kostet es Strom.
- Datenschutz. Kundentelefonate, medizinische Diktate und juristische Aufnahmen verlassen niemals Ihr Netzwerk.
- Vollständiger Funktionsumfang. Der vLLM-Pfad unterstützt Wort-Zeitstempel, Sprecherdiarisierung, Übersetzung und Kontext-Prompts. Einige gehostete Endpunkte bieten nur einen Teil davon.
- Fine-Tuning. NVIDIAs Launch-Post zeigt ein medizinisches Fine-Tune, das die WER von 30,8 % auf 11,8 % senkt. Das können Sie nur mit den Gewichten machen.
Hardware: Womit es läuft
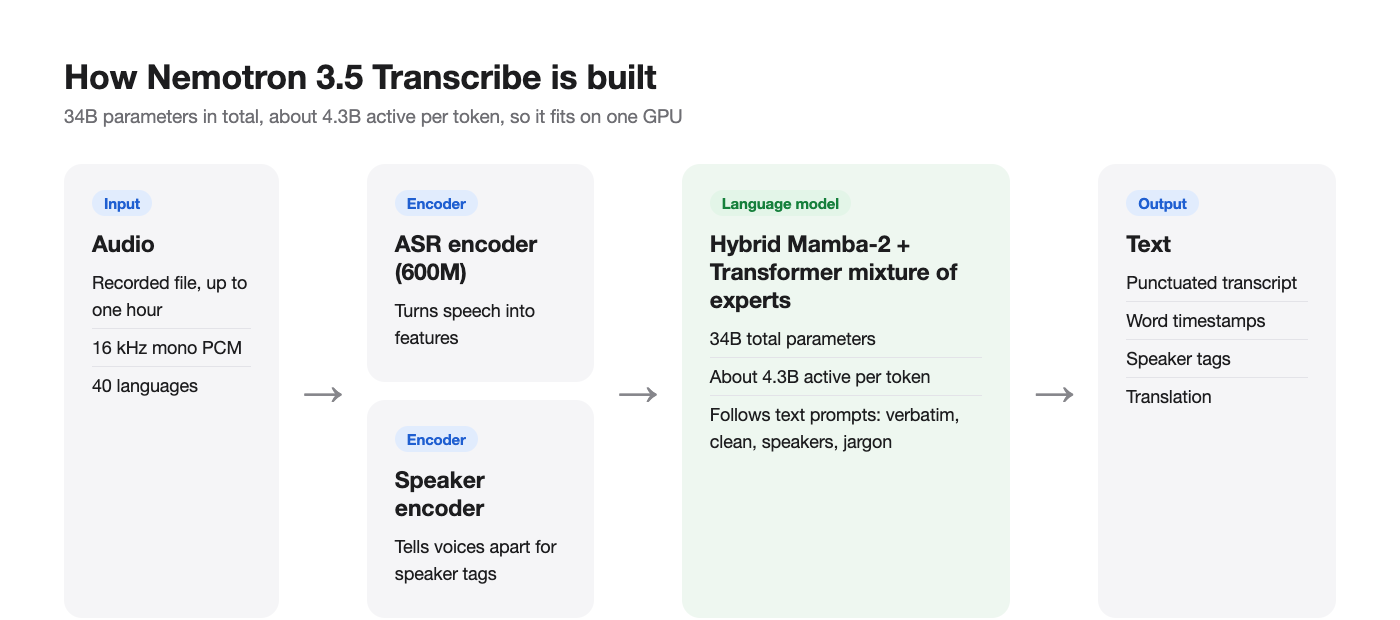
Das Modell hat insgesamt 34B Parameter und etwa 4,3B aktive, daher sind die Gewichte groß, auch wenn der Rechenaufwand pro Token klein ist. NVIDIAs Referenzziel ist eine H100 80 GB in BF16. Die Kompatibilitätstabelle auf der Modellkarte:
| GPU | Präzisionen | Laufzeitumgebungen |
|---|---|---|
| H100, H200 | BF16, FP8 | vLLM 0.32.0, Transformers, SGLang-Omni 0.2.0 (H100) |
| A100 80 GB | BF16 | vLLM 0.32.0, Transformers |
| L40S 48 GB | FP8 | vLLM 0.32.0, Transformers |
| B200, GB200, GB300 DGX Station | BF16, FP8, NVFP4 | vLLM 0.32.0, Transformers |
| DGX Spark (GB10), Jetson Thor | BF16, FP8, NVFP4 | vLLM 0.32.0, Transformers |
| RTX PRO 6000 Blackwell Server | BF16, FP8, NVFP4 | vLLM, Transformers, SGLang-Omni, GGML |
| RTX 5090 (32 GB) | NVFP4 only | vLLM 0.32.0, Transformers, GGML |
Wählen Sie den Checkpoint für Ihre Karte:
nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B(BF16)nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B-FP8nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B-NVFP4
Eine 24-GB-Karte wie die RTX 4090 steht nicht auf der Liste, und Apple Silicon wird nicht unterstützt. Betriebssysteme sind Linux oder Windows über WSL2. GGML läuft auch unter nativem Windows, aber NVIDIAs Launch-Post sagt, dass der lokale NeMo-Speech.cpp-Build noch „coming soon“ ist.
Option 1: vLLM-Server (empfohlen)
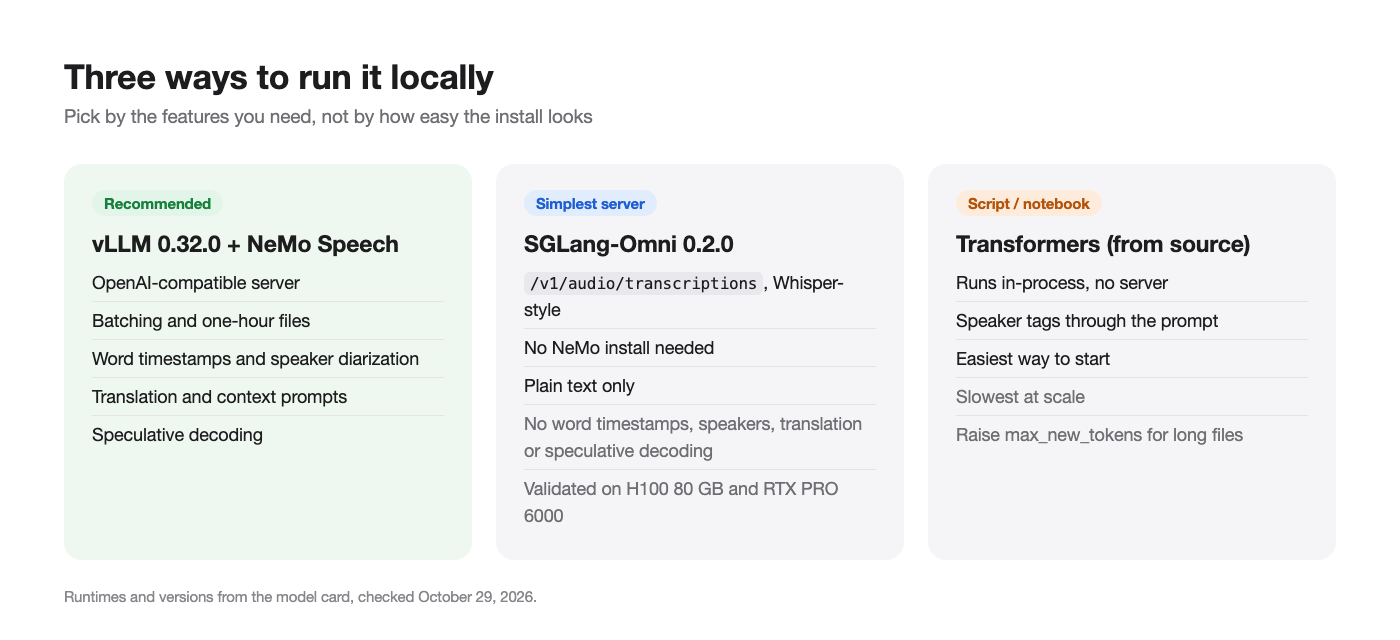
vLLM bietet Ihnen einen OpenAI-kompatiblen Endpunkt mit Batching, einstündigen Dateien, spekulativem Decoding und Wort-Zeitstempeln. Es benötigt vLLM 0.32.0 plus den neuesten NeMo Speech Main-Branch, der das vLLM-Plugin des Modells bereitstellt.
Installation
Die Modellkarte verwendet uv und Python 3.13:
git clone https://github.com/NVIDIA-NeMo/Speech.git nemo-speech
cd nemo-speech
uv venv --python 3.13 .venv
UV_PROJECT_ENVIRONMENT=$PWD/.venv uv sync --extra asr --extra vllm --locked --no-install-project
uv pip install --python .venv/bin/python --no-deps -e .
uv pip install --python .venv/bin/python --no-deps av==19.0.2
uv pip install --python .venv/bin/python --no-deps opencv-python-headless==5.0.0.93
source .venv/bin/activate
hf download nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B --local-dir ./NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
PyAV (av) ermöglicht das Dekodieren von M4A und anderen komprimierten Formaten ohne systemweites FFmpeg. OpenCV ist dabei, weil vLLM es benötigt und NeMOs Abhängigkeitseinstellungen es auslassen.
Server starten
export VLLM_PLUGINS=nemo_speechlm
export VLLM_MAX_AUDIO_DECODE_DURATION_S=3600
export VLLM_MAX_AUDIO_CLIP_FILESIZE_MB=180
export VLLM_USE_V2_MODEL_RUNNER=0
vllm serve ./NVIDIA-Nemotron-3.5-Transcribe-30B-A4B \
  --served-model-name nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B \
  --trust-remote-code --dtype bfloat16 --gpu-memory-utilization 0.94 \
  --max-model-len 65536 --max-num-batched-tokens 4096 --max-num-seqs 192 \
  --enable-chunked-prefill --no-enable-prefix-caching \
  --use-replayssm --mamba-backend flashinfer --mamba-cache-mode none \
  --mm-processor-cache-gb 0 --no-async-scheduling \
  --limit-mm-per-prompt '{"audio":{"count":6,"length":120000000}}' \
  --speculative-config '{"method":"mtp","num_speculative_tokens":8}' \
  --reasoning-parser nemotron_v3 \
  --trust-request-mm-kwargs \
  --middleware nemo.collections.speechlm2.vllm.salm.ctc_serving.ctc_timestamp_middleware
Die Flags, die man verstehen sollte:
VLLM_MAX_AUDIO_DECODE_DURATION_S=3600erhöht das Audio-Limit von vLLM von 600 Sekunden auf eine Stunde. Vergessen Sie es, und lange Dateien schlagen fehl.VLLM_USE_V2_MODEL_RUNNER=0behält den V1-Runner bei, den Wort-Zeitstempel benötigen.--speculative-configaktiviert Multi-Token-Vorhersage mit acht Draft-Tokens (MTP8). Auf einer H100 hat NVIDIA eine gebatchte englische RTFx von 270 mit MTP8 und 410 mit MTP2 gemessen, probieren Sie also"num_speculative_tokens":2, wenn Ihnen Durchsatz wichtiger ist als Latenz.--middleware ... ctc_timestamp_middlewareund--trust-request-mm-kwargsermöglichen es Anfragen, Wort-Zeitstempel anzufordern.- Die Einstellungen sind auf eine 80-GB-H100 ausgelegt. Senken Sie auf anderen Karten
--gpu-memory-utilization,--max-model-lenoder--max-num-seqs.
Der Server lauscht auf 127.0.0.1:8000. Fügen Sie --host 0.0.0.0 hinzu, um ihn von anderen Maschinen in Ihrem Netzwerk zu erreichen.
Datei senden
import base64
from openai import OpenAI

client = OpenAI(base_url="http://127.0.0.1:8000/v1", api_key="EMPTY")
audio = base64.b64encode(open("standup.wav", "rb").read()).decode()

response = client.chat.completions.create(
    model="nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B",
    messages=[{"role": "user", "content": [
        {"type": "text", "text": "Transcribe the following audio."},
        {"type": "audio_url", "audio_url": {"url": f"data:audio/wav;base64,{audio}"}},
    ]}],
    temperature=0,
    extra_body={"chat_template_kwargs": {"enable_thinking": False}, "skip_special_tokens": False},
)
print(response.choices[0].message.content)
Ersetzen Sie die Textanweisung durch einen beliebigen Task-Prompt. Für ein Meeting mit mehreren Stimmen:
Transcribe verbatim, including fillers. Write numbers as spoken, without punctuation or capitalization. Start every speaker turn with <spk:0>, <spk:1>, etc. Keep one stable tag per speaker. Output only the speaker-tagged transcript.
Anfragen mit Wort-Zeitstempeln haben Regeln: eine Aufnahme pro Anfrage, stream=false und n=1. Die Antwort enthält dann ein ctc_timestamps-Objekt mit Wörtern, Start- und Endzeiten in Sekunden sowie Sprecher-Tags.
Option 2: SGLang-Omni für reine Transkription
Wenn Sie nur Text aus ganzen Dateien benötigen, ist SGLang-Omni 0.2.0 einfacher und benötigt kein NeMo. Es ist auf einer H100 80 GB und einer RTX PRO 6000 Blackwell mit dem BF16- oder FP8-Checkpoint validiert.
sgl-omni serve \
  --model-path nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B \
  --model-name nemotron-transcribe \
  --mem-fraction-static 0.85 \
  --port 8000

curl http://localhost:8000/v1/audio/transcriptions \
  -F model=nemotron-transcribe \
  -F file=@audio.wav
Diese /v1/audio/transcriptions-Route entspricht der Form, die OpenAIs Whisper-API verwendet, sodass vorhandener Whisper-Client-Code oft nur eine neue Basis-URL benötigt. Der Kompromiss: keine Wort-Zeitstempel, Sprecherbezeichnungen, Übersetzung oder spekulatives Decoding in dieser Integration.
Option 3: Transformers in einem Skript
Für Notebooks und einmalige Jobs führen Sie es im Prozess mit aus dem Quellcode installierten Hugging Face Transformers aus:
pip install git+https://github.com/huggingface/transformers
from transformers import AutoModelForMultimodalLM, AutoProcessor

model_id = "nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForMultimodalLM.from_pretrained(model_id, device_map="auto")

prompt = ("Transcribe this audio with punctuation and capitalization. Include all spoken words "
          "and verbal fillers. Put speaker tags <spk:0> <spk:1> <spk:2> <spk:3> on the transcription.")
inputs = processor.apply_transcription_request(["podcast.mp3"], prompt=[prompt]).to(model.device)
outputs = model.generate(**inputs, max_new_tokens=4096)
print(processor.decode(outputs[:, inputs.input_ids.shape[1]:], skip_special_tokens=False))
Es ist der einfachste Einstieg und die langsamste Art, es im großen Maßstab auszuführen. Erhöhen Sie max_new_tokens für lange Dateien: Eine dichte Stunde kann etwa 20.000 Tokens erzeugen.
Wie schnell ist es auf Ihrer eigenen GPU?
NVIDIAs Schlagzeile ist 2.238 Sekunden Audio pro Sekunde auf einer RTX PRO 6000 Blackwell, mit NVFP4-Gewichten und DFlash2-spezkulativem Decoding, sowie 0,13 Sekunden, um einen 30-Sekunden-Clip zurückzugeben. Lesen Sie die Fußnote: Diese Zahlen stammen vom optimierten NIM, dessen Serving-Änderungen noch nicht Open Source sind. Die Modellkarte sagt, dass die offene vLLM-Integration voraussichtlich etwa zweimal langsamer ist.
Für gebatchte englische Transkription auf H100 in BF16 listet die Modellkarte diese RTFx-Zahlen auf (Sekunden Audio pro Sekunde Rechenzeit):
| Spekulatives Decoding | RTFx |
|---|---|
| MTP2 | 410 |
| DFlash2, K=7 | 340 |
| MTP8 | 270 |
| DFlash2, K=15 | 260 |
Selbst die langsamste Zeile schafft eine Stunde Audio in unter 15 Sekunden GPU-Zeit bei gebatchter Arbeit. Wenn Sie das DFlash2-Draft-Modell möchten, beachten Sie, dass vLLM 0.32.0 einen kleinen Patch aus der Modellkarte benötigt, DFlash2 Wort-Zeitstempel deaktiviert und Sie es nicht mit MTP kombinieren sollten.
Häufige Probleme und Lösungen
- Lange Dateien werden bei 10 Minuten abgeschnitten. Sie haben
VLLM_MAX_AUDIO_DECODE_DURATION_S=3600übersprungen. - Keine Zeitstempel in der Antwort. Prüfen Sie
VLLM_USE_V2_MODEL_RUNNER=0, das--middleware-Flag und ob die Anfragestream=falseund eine Aufnahme hat. - Speichermangel auf kleineren Karten. Wechseln Sie zum FP8- oder NVFP4-Checkpoint und senken Sie
--max-num-seqs. - Wiederholte Phrasen am Ende eines Transkripts. Die Modellkarte empfiehlt eine Guardrail gegen Generierungsschleifen bei den finalen Ausgaben. Begrenzen Sie
max_tokensund kürzen Sie Wiederholungen. - Falsche Schreibweise von Namen. Fügen Sie
Context terms: <names>zum Prompt hinzu. - Hintergrundstimmen im Transkript. Probieren Sie den experimentellen Near-Field-Prompt aus der Modellkarte, der in NVIDIAs Test die WER bei gemischtem Audio von 27,32 % auf 4,78 % senkte.
Wenn Sie neu bei vLLM selbst sind, behandelt unser vLLM-Erklärer, wie es Anfragen batcht und GPU-Speicher verwaltet.
Lassen Sie Ihren Coding-Agenten den lokalen Server mit Apidog CLI testen
Ein lokales Modell ist nur nützlich, wenn sein Endpunkt über vLLM-Upgrades, Prompt-Anpassungen und Checkpoint-Wechsel hinweg korrekt bleibt. Lassen Sie Ihren Coding-Agenten das mit Apidog CLI übernehmen, indem er Prüfungen gegen http://127.0.0.1:8000 von derselben Maschine aus ausführt.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Geben Sie Ihrem Agenten dann einen Prompt:
In Apidog project <id>, add POST {{baseUrl}}/v1/chat/completions for my local
Nemotron 3.5 Transcribe server. Create test cases that send samples/en.wav and
samples/two-speakers.wav as base64 audio_url content with temperature 0, and assert
status 200, a non-empty choices[0].message.content, and at least two distinct <spk:N>
tags for the two-speaker file. Run them against the local environment and report failures.
Der Agent liest das Schema, validiert seine Payload, schreibt die Testfälle und führt sie aus:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Führen Sie es nach jedem Server-Upgrade aus, oder verdrahten Sie apidog run ... -r junit in CI, wie in Apidog CLI in einer CI/CD-Pipeline gezeigt. Zur Agenten-Einrichtung siehe Apidog CLI in Claude Code.
FAQ
Kann ich Nemotron 3.5 Transcribe auf einer RTX 4090 ausführen? Sie steht nicht auf NVIDIAs Kompatibilitätsliste. Die kleinste aufgeführte Consumer-Karte ist die RTX 5090 mit dem NVFP4-Checkpoint.
Läuft es auf einem Mac? Stand 29. Oktober 2026 unterstützt keine offizielle Laufzeitumgebung Apple Silicon.
Ist die lokale Nutzung für kommerzielle Produkte kostenlos? Die OpenMDW-1.1-Lizenz erlaubt kommerzielle und nichtkommerzielle Nutzung. Lesen Sie den Lizenztext zu Attributionsbedingungen, bevor Sie ausliefern.
Kann es Live-Audio transkribieren? Nein. Es ist ein Offline-Modell für aufgezeichnete Dateien. NVIDIA bietet ein separates Nemotron 3.5 ASR Streaming-Modell für Live-Nutzung an.
Was ist schneller, vLLM oder SGLang-Omni? NVIDIA veröffentlicht keinen direkten Vergleich. Verwenden Sie vLLM, wenn Sie Zeitstempel, Sprecher oder Übersetzung benötigen, und SGLang-Omni für den einfachsten reinen Textserver.
Wie schneidet es im Vergleich zu anderen lokalen Modellen ab? Es führt jedes Open-Weight-Modell im Open ASR Leaderboard vom 28. Oktober an. Unsere Liste der besten Open-Source-Speech-to-Text-Modelle vergleicht es mit Qwen3-ASR, Granite Speech, Canary-Qwen, Voxtral und Whisper.
Ausführen
Laden Sie den Checkpoint herunter, der zu Ihrer GPU passt, starten Sie vLLM mit dem Ein-Stunden-Audio-Limit und der Zeitstempel-Middleware und senden Sie eine WAV-Datei über den OpenAI-Client. Lassen Sie dann Ihren Agenten Apidog-Prüfungen gegen den lokalen Endpunkt ausführen, damit jedes Upgrade beweist, dass es noch transkribiert, bevor Sie ihm echte Aufnahmen anvertrauen.