
Entwickler und KI-Enthusiasten suchen ständig nach effizienten Modellen, die gut funktionieren, ohne massive Ressourcen zu beanspruchen. Google stellt Gemma 3 270M vor, ein kompaktes Sprachmodell mit 270 Millionen Parametern. Dieses Modell ist das kleinste in der Gemma 3-Familie und für Aufgaben auf dem Gerät optimiert. Sie erhalten Funktionen für Textgenerierung, Beantwortung von Fragen, Zusammenfassung und logisches Denken, während alle Operationen lokal bleiben.
Gemma 3 270M unterstützt eine Kontextlänge von 32.000 Token, wodurch es umfangreiche Eingaben effektiv verarbeiten kann. Zusätzlich integriert es Quantisierungstechniken wie Q4_0 Quantization Aware Training (QAT), wodurch der Ressourcenbedarf ohne Qualitätseinbußen reduziert wird. Dadurch erzielen Sie eine Leistung, die der von Full-Precision-Modellen nahekommt, jedoch mit geringerem Speicher- und Rechenbedarf.
Was Gemma 3 270M jedoch besonders attraktiv macht, ist seine Zugänglichkeit. Sie können es auf Standardhardware ausführen, einschließlich Laptops oder sogar Mobilgeräten, was den Datenschutz und Anwendungen mit geringer Latenz fördert. Betrachten Sie als Nächstes, wie dieses Modell in breitere Trends der KI-Entwicklung passt, wo Effizienz Innovationen vorantreibt.
Die Architektur von Gemma 3 270M verstehen
Google baut Gemma 3 270M auf einer Transformer-basierten Architektur auf, die 170 Millionen Parameter für Embeddings mit einem Vokabular von 256.000 Token und 100 Millionen für Transformer-Blöcke umfasst. Diese Konfiguration ermöglicht mehrsprachige Unterstützung und die Bearbeitung von Nischenaufgaben. Sie profitieren von Techniken wie INT4-Quantisierung, Rotary Position Embeddings und Group Query Attention, die die Inferenzgeschwindigkeit und Leichtigkeit verbessern.
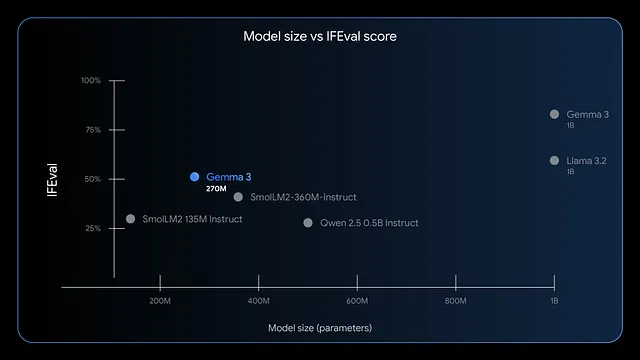
Darüber hinaus zeichnet sich das Modell durch das Befolgen von Anweisungen und die Datenextraktion aus. Benchmarks zeigen hohe F1-Scores bei IFEval, was auf eine starke Leistung bei Bewertungsaufgaben hinweist. Im Vergleich zu größeren Modellen wie GPT-4 oder Phi-3 Mini priorisiert Gemma 3 270M Effizienz und benötigt im 4-Bit-Modus auf Geräten wie Apples M4 Max weniger als 200 MB.
Folglich setzen Sie es in Szenarien ein, die schnelle Antworten erfordern, wie z.B. Echtzeit-Stimmungsanalyse oder die Extraktion von Entitäten im Gesundheitswesen. Dennoch schränkt seine geringe Größe die Kreativität nicht ein; Sie können es für kreatives Schreiben oder Finanz-Compliance-Prüfungen verwenden. Bewerten Sie im Folgenden die Vorteile, dieses Modell lokal auszuführen.
Vorteile des lokalen Betriebs von Gemma 3 270M
Sie verbessern den Datenschutz, indem Sie Daten auf Ihrem Gerät behalten und Cloud-Übertragungen vermeiden, die ein Risiko der Offenlegung darstellen. Gemma 3 270M reduziert die Latenz und liefert Antworten in Millisekunden statt in Sekunden. Darüber hinaus senkt es die Kosten, da Sie Abonnementgebühren für Cloud-basierte APIs vermeiden.
Darüber hinaus zeichnet sich die Energieeffizienz des Modells aus. Es verbraucht nur 0,75 % der Batterie eines Pixel 9 Pro für 25 Gespräche im INT4-quantisierten Modus. Diese Eigenschaft eignet sich für mobiles und Edge Computing, wo Stromverbrauch wichtig ist. Sie können das Modell auch einfach durch Feinabstimmung mit Tools wie LoRA anpassen, was minimale Daten erfordert.
Nichtsdestotrotz ermöglicht die lokale Ausführung kleinen Teams oder einzelnen Entwicklern mehr Möglichkeiten. Sie können frei experimentieren und Anwendungen wie E-Commerce-Anfrage-Routing oder die Strukturierung von Rechtstexten iterieren. Überprüfen Sie im weiteren Verlauf, ob Ihr System die Anforderungen erfüllt.
Systemanforderungen für die Gemma 3 270M Inferenz
Gemma 3 270M benötigt bescheidene Hardware, was es zugänglich macht. Für die reine CPU-Inferenz benötigen Sie mindestens 4 GB RAM und einen modernen Prozessor wie Intel Core i5 oder Äquivalent. GPU-Beschleunigung verbessert jedoch die Geschwindigkeit; eine NVIDIA-Karte mit 2 GB VRAM reicht für quantisierte Versionen aus.
Insbesondere im 4-Bit-Modus passt das Modell in 200 MB Speicher, was den Betrieb auf Geräten mit begrenzten Ressourcen ermöglicht. Nutzer von Apple Silicon profitieren von MLX-LM und erreichen über 650 Token pro Sekunde auf einem M4 Max. Für die Feinabstimmung sollten Sie 8 GB RAM und eine GPU mit 4 GB VRAM zuweisen, um kleine Datensätze effizient zu verarbeiten.
Wichtig ist, dass Betriebssysteme wie Windows, macOS oder Linux funktionieren, aber stellen Sie Python 3.10+ für die Bibliothekskompatibilität sicher. Der Speicherbedarf beträgt etwa 1 GB für die Modelldateien. Mit diesen Voraussetzungen können Sie problemlos installieren und ausführen. Erkunden Sie nun die Installationsmethoden.
Das richtige Tool zum lokalen Ausführen von Gemma 3 270M wählen
Mehrere Frameworks unterstützen Gemma 3 270M, wobei jedes einzigartige Stärken bietet. Hugging Face Transformers bietet Flexibilität für Python-Skripting und Integration. LM Studio bietet eine benutzerfreundliche Oberfläche für die Modellverwaltung.
Zusätzlich ermöglicht llama.cpp eine effiziente C++-basierte Inferenz, perfekt für Low-Level-Optimierung. Für Apple-Geräte optimiert MLX die Leistung auf M-Serien-Chips. Sie wählen basierend auf Ihrem Fachwissen; Anfänger bevorzugen LM Studio, während Entwickler eher zu Transformers tendieren.
Somit demokratisieren diese Tools den Zugang. In den folgenden Abschnitten finden Sie Schritt-für-Schritt-Anleitungen für gängige Methoden.
Schritt-für-Schritt-Anleitung: Gemma 3 270M mit Hugging Face Transformers ausführen
Sie beginnen mit der Installation der notwendigen Bibliotheken. Öffnen Sie Ihr Terminal und führen Sie aus:
pip install transformers torch
Dieser Befehl lädt Transformers und PyTorch herunter. Als Nächstes importieren Sie die Komponenten in einem Python-Skript:
from transformers import AutoTokenizer, AutoModelForCausalLM
Laden Sie das Modell und den Tokenizer:
model_name = "google/gemma-3-270m"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name, device_map="auto")
device_map="auto" platziert das Modell auf der GPU, falls verfügbar. Bereiten Sie Ihre Eingabe vor:
input_text = "Explain quantum computing in simple terms."
inputs = tokenizer(input_text, return_tensors="pt").to(model.device)
Ausgabe generieren:
outputs = model.generate(**inputs, max_new_tokens=200)
response = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(response)
Dies erzeugt eine kohärente Erklärung. Zur Optimierung fügen Sie Quantisierung hinzu:
from transformers import BitsAndBytesConfig
quant_config = BitsAndBytesConfig(load_in_4bit=True)
model = AutoModelForCausalLM.from_pretrained(model_name, quantization_config=quant_config)
Quantisierung reduziert den Speicherverbrauch. Fehler beheben Sie, indem Sie den Hugging Face-Login für gated Modelle sicherstellen:
from huggingface_hub import login
login(token="your_hf_token")
Holen Sie sich das Token von Ihrem Hugging Face-Konto. Mit dieser Einrichtung können Sie Inferenzen wiederholt ausführen. Für Nicht-Python-Benutzer sollten Sie als Nächstes LM Studio in Betracht ziehen.
Schritt-für-Schritt-Anleitung: Gemma 3 270M mit LM Studio ausführen
LM Studio bietet eine intuitive Benutzeroberfläche. Laden Sie es von lmstudio.ai herunter und installieren Sie es.
Starten Sie die App und suchen Sie dann im Modell-Hub nach "gemma-3-270m".
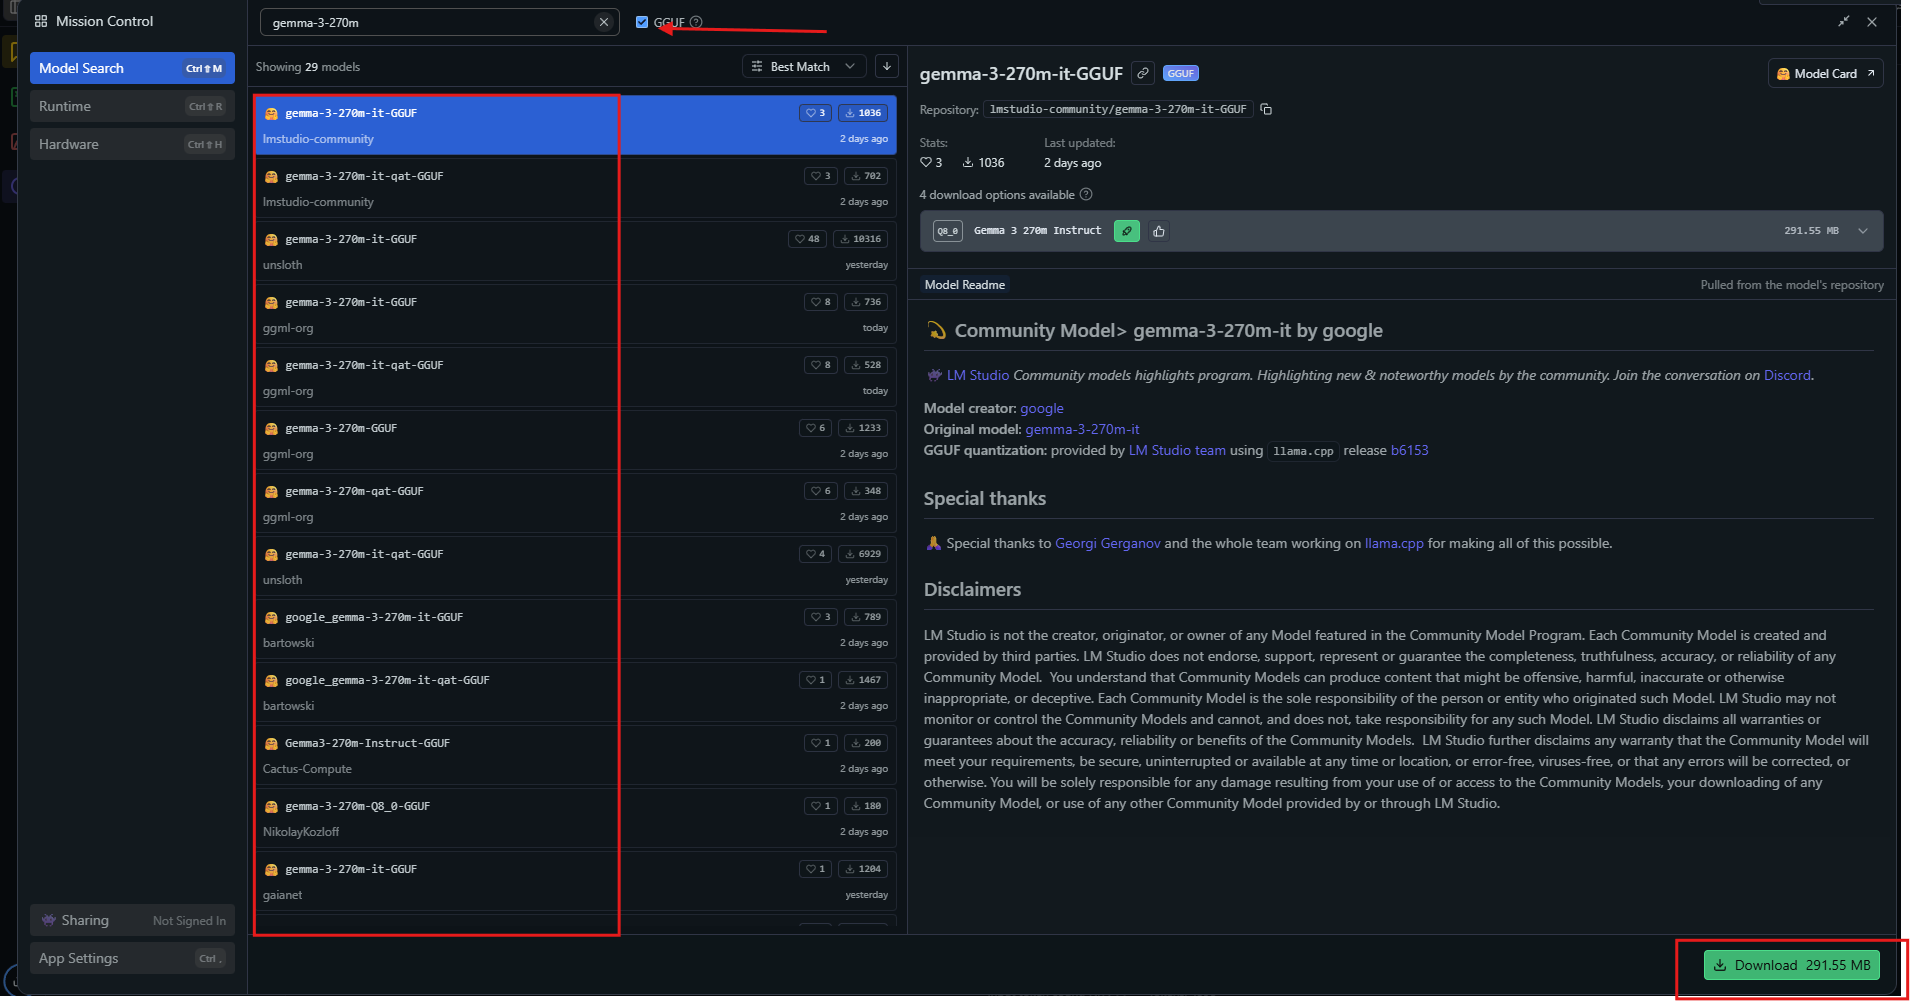
Wählen Sie eine quantisierte Variante wie Q4_0 aus und laden Sie sie herunter. Sobald es bereit ist, laden Sie das Modell aus der Seitenleiste. Passen Sie die Einstellungen an: Kontext auf 32k, Temperatur auf 1.0 setzen.
Geben Sie eine Eingabeaufforderung in das Chatfenster ein und drücken Sie auf Senden. LM Studio zeigt Antworten mit Token-Geschwindigkeiten an. Chats exportieren oder über integrierte Tools feinabstimmen.
Für fortgeschrittene Nutzung aktivieren Sie GPU-Offloading in den Einstellungen. LM Studio wählt automatisch optimale Quellen aus und gewährleistet so die Kompatibilität. Diese Methode eignet sich für visuelle Lerntypen. Erkunden Sie zusätzlich llama.cpp für Leistungsoptimierungen.
Schritt-für-Schritt-Anleitung: Gemma 3 270M mit llama.cpp ausführen
llama.cpp bietet eine hocheffiziente Inferenz. Klonen Sie das Repository:
git clone https://github.com/ggerganov/llama.cpp
Bauen Sie es:
make -j
Laden Sie GGUF-Dateien von Hugging Face herunter:
huggingface-cli download unsloth/gemma-3-270m-it-GGUF --include "*.gguf"
Inferenz ausführen:
./llama-cli -m gemma-3-270m-it-Q4_K_M.gguf -p "Build a simple AI app."
Geben Sie Parameter wie --n-gpu-layers 999 für die vollständige GPU-Nutzung an. llama.cpp unterstützt Quantisierungsstufen, die Geschwindigkeit und Genauigkeit ausgleichen. Sie kompilieren mit CUDA für NVIDIA GPUs:
make GGML_CUDA=1
Dies beschleunigt die Verarbeitung. llama.cpp ist hervorragend für eingebettete Systeme geeignet. Wenden Sie das Modell nun in praktischen Beispielen an.
Praktische Beispiele für die lokale Nutzung von Gemma 3 270M
Sie erstellen einen Stimmungsanalysator. Geben Sie Kundenbewertungen ein, und das Modell klassifiziert sie als positiv oder negativ. Skripten Sie es in Python:
prompt = "Classify: This product is amazing!"
inputs = tokenizer(prompt, return_tensors="pt")
outputs = model.generate(**inputs)
print(tokenizer.decode(outputs[0]))
Gemma 3 270M gibt "Positiv" aus. Erweitern Sie auf Zusammenfassung:
text = "Long article here..."
prompt = f"Summarize: {text}"
# Generate summary
Es verdichtet Inhalte effektiv. Für die Beantwortung von Fragen, fragen Sie:
"Was verursacht den Klimawandel?"
Das Modell erklärt Treibhausgase. Im Gesundheitswesen extrahieren Sie Entitäten aus Notizen. Diese Anwendungen zeigen Vielseitigkeit. Darüber hinaus können Sie für Spezialisierung feinabstimmen.
Gemma 3 270M lokal feinabstimmen
Feinabstimmung passt das Modell an. Verwenden Sie die PEFT-Bibliothek von Hugging Face:
pip install peft
Laden Sie mit LoRA-Konfiguration:
from peft import LoraConfig, get_peft_model
lora_config = LoraConfig(r=16, lora_alpha=32, target_modules=["q_proj", "v_proj"])
model = get_peft_model(model, lora_config)
Bereiten Sie einen Datensatz vor und trainieren Sie dann:
from transformers import Trainer, TrainingArguments
trainer = Trainer(model=model, args=TrainingArguments(output_dir="./results"))
trainer.train()
LoRA benötigt wenig Daten und ist auf bescheidener Hardware schnell fertig. Speichern und laden Sie den Adapter neu. Dies steigert die Leistung bei benutzerdefinierten Aufgaben wie der Vorhersage von Schachzügen. Überwachen Sie jedoch Überanpassung.
Tipps zur Leistungsoptimierung für Gemma 3 270M
Sie maximieren die Geschwindigkeit durch Quantisierung auf 4-Bit oder 8-Bit. Verwenden Sie Batching für mehrere Inferenzen. Stellen Sie die Temperatur auf 1.0, top_k=64, top_p=0.95 ein, wie empfohlen.
Aktivieren Sie auf GPUs Mixed Precision. Bei langen Kontexten verwalten Sie den KV-Cache sorgfältig. Überwachen Sie den VRAM mit Tools wie nvidia-smi. Aktualisieren Sie Bibliotheken regelmäßig für Optimierungen.
Folglich erzielen diese Anpassungen über 130 Token pro Sekunde auf geeigneter Hardware. Vermeiden Sie häufige Fallstricke wie doppelte BOS-Token in Prompts. Mit Übung erzielen Sie effiziente Ausführungen.
Fazit
Sie verfügen nun über das Wissen, Gemma 3 270M lokal auszuführen. Von der Einrichtung bis zur Optimierung baut jeder Schritt Fähigkeiten auf. Experimentieren Sie, stimmen Sie fein ab und stellen Sie bereit, um sein Potenzial zu realisieren. Kleine Modelle wie dieses haben große Auswirkungen auf die Zugänglichkeit von KI.