
Sie suchen ein kompaktes KI-Sprachmodell, das eine starke Leistung auf lokaler Hardware liefert? Googles Gemma 3 270M ist das kleinste Modell der Gemma-Serie und bietet 270 Millionen Parameter sowie robuste Funktionen – ohne die hohen Ressourcenanforderungen größerer Modelle. Es ist perfekt für Entwickler, die sichere KI-Funktionen mit geringer Latenz erstellen möchten. Gemma 3 270M unterstützt Textgenerierung, Q&A, Zusammenfassungen und mehr – alles auf Ihrem eigenen Gerät.
Tipp: Integrieren Sie Gemma 3 270M nahtlos in Ihre API-gesteuerten Anwendungen mit Apidog – einer einheitlichen Plattform zum Entwerfen, Testen, Simulieren und Dokumentieren der APIs, die sich mit Ihren lokalen KI-Modellen verbinden. Apidog beschleunigt die Entwicklung und stellt sicher, dass Ihre KI-Funktionen vom Prototyp bis zur Produktion zuverlässig sind.
Warum Gemma 3 270M für lokale KI-Aufgaben verwenden?
Gemma 3 270M wurde für Entwickler entwickelt, die Wert legen auf:
- Datenschutz auf dem Gerät: Daten verlassen niemals Ihre Hardware.
- Geringe Latenz: Sofortige Antworten, ideal für Echtzeit-Funktionen.
- Ressourceneffizienz: Läuft auf Laptops, Desktops oder sogar Mobilgeräten.
Mit einem Kontextfenster von bis zu 32.000 Tokens und Quantisierungsoptionen wie Q4_0 QAT balanciert Gemma 3 270M Genauigkeit mit minimalem Speicher- und Rechenaufwand. Erzielen Sie nahezu vollständige Präzisionsergebnisse bei weniger als 200 MB Speicherverbrauch im INT4-Modus – ein erheblicher Vorteil für Edge- und Mobilbereitstellungen.
Gemma 3 270M Architektur: Was macht sie effizient?
Googles Gemma 3 270M basiert auf einem Transformer-Framework mit:
- 170 Millionen Parametern für Embeddings (unterstützt ein Vokabular von 256.000 Tokens)
- 100 Millionen Parametern für Transformer-Blöcke
- Mehrsprachige Unterstützung und Anpassungsfähigkeit an Nischenaufgaben
- INT4-Quantisierung, Rotary Position Embeddings und Group Query Attention für Geschwindigkeit und Effizienz
Das Modell zeichnet sich durch das Befolgen von Anweisungen, die Datenextraktion und kreative Aufgaben wie Zusammenfassungen oder Compliance-Prüfungen aus. Benchmarks zeigen, dass Gemma 3 270M hohe F1-Scores auf IFEval erreicht, was es zu einer starken Wahl für technische und kreative Projekte macht – insbesondere dort, wo Speicher- und Batterieverbrauch wichtige Anliegen sind.
Hauptvorteile des lokalen Betriebs von Gemma 3 270M
- Datenschutz: Die gesamte Verarbeitung bleibt auf Ihrem Gerät, wodurch Expositionsrisiken reduziert werden.
- Geringe Latenz: Antwortzeiten im Millisekundenbereich, selbst bei komplexen Aufgaben.
- Keine Cloud-Gebühren: Eliminieren Sie wiederkehrende Kosten für Cloud-basierte KI-APIs.
- Energieeffizienz: Verbraucht nur 0,75 % des Akkus eines Pixel 9 Pro für 25 INT4-quantisierte Konversationen.
- Einfaches Fine-Tuning: Passen Sie das Modell mit leichtgewichtigen Methoden wie LoRA an Ihre Datensätze an.
- Gestärkte Teams: Kleine Teams und Einzelentwickler können ohne Cloud-Abhängigkeiten experimentieren und iterieren.
Systemanforderungen: Welche Hardware benötigen Sie?
Gemma 3 270M ist für die meisten Entwickler zugänglich:
- Nur CPU-Inferenz: 4 GB RAM und ein moderner Prozessor (z. B. Intel Core i5)
- GPU-Beschleunigung: 2 GB VRAM auf NVIDIA-Karten (für quantisierte Modelle)
- Apple Silicon: Hohe Leistung über MLX-LM (650+ Tokens/Sek. auf M4 Max)
- Fine-Tuning: 8 GB RAM und GPU mit 4 GB VRAM für kleine Datensätze empfohlen
- Betriebssystem: Windows, macOS oder Linux
- Software: Python 3.10+ für Bibliothekskompatibilität
- Speicher: ca. 1 GB für Modelldateien
Wahl Ihres lokalen Inferenz-Tools: Ein schneller Vergleich
Mehrere Frameworks machen den lokalen Betrieb von Gemma 3 270M unkompliziert:
- Hugging Face Transformers: Maximale Flexibilität, Python-Skripting und Integrationsoptionen.
- LM Studio: Intuitive Benutzeroberfläche für einfache Modellverwaltung – ideal für Nicht-Programmierer.
- llama.cpp: C++-basiert, optimiert für Leistung und Low-Level-Anpassung.
- MLX (Apple): Optimiert für Apple M-Serie Chips.
Am besten geeignet für:
- Anfänger: LM Studio
- Entwickler/Ingenieure: Transformers oder llama.cpp
Schritt-für-Schritt: Gemma 3 270M mit Hugging Face Transformers ausführen
1. Erforderliche Bibliotheken installieren
pip install transformers torch
2. Das Modell in Python laden
from transformers import AutoTokenizer, AutoModelForCausalLM

model_name = "google/gemma-3-270m"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name, device_map="auto")
3. Eine Inferenz ausführen
input_text = "Explain quantum computing in simple terms."
inputs = tokenizer(input_text, return_tensors="pt").to(model.device)
outputs = model.generate(**inputs, max_new_tokens=200)
response = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(response)
4. Quantisierung aktivieren (Speicherverbrauch reduzieren)
from transformers import BitsAndBytesConfig
quant_config = BitsAndBytesConfig(load_in_4bit=True)
model = AutoModelForCausalLM.from_pretrained(model_name, quantization_config=quant_config)
5. Zugriff auf das Gated Model (falls erforderlich)
from huggingface_hub import login
login(token="your_hf_token")
Holen Sie sich Ihr Token von Ihrem Hugging Face Konto.
Schritt-für-Schritt: Gemma 3 270M mit LM Studio ausführen
LM Studio bietet einen visuellen Ansatz zur Verwaltung lokaler KI-Modelle.
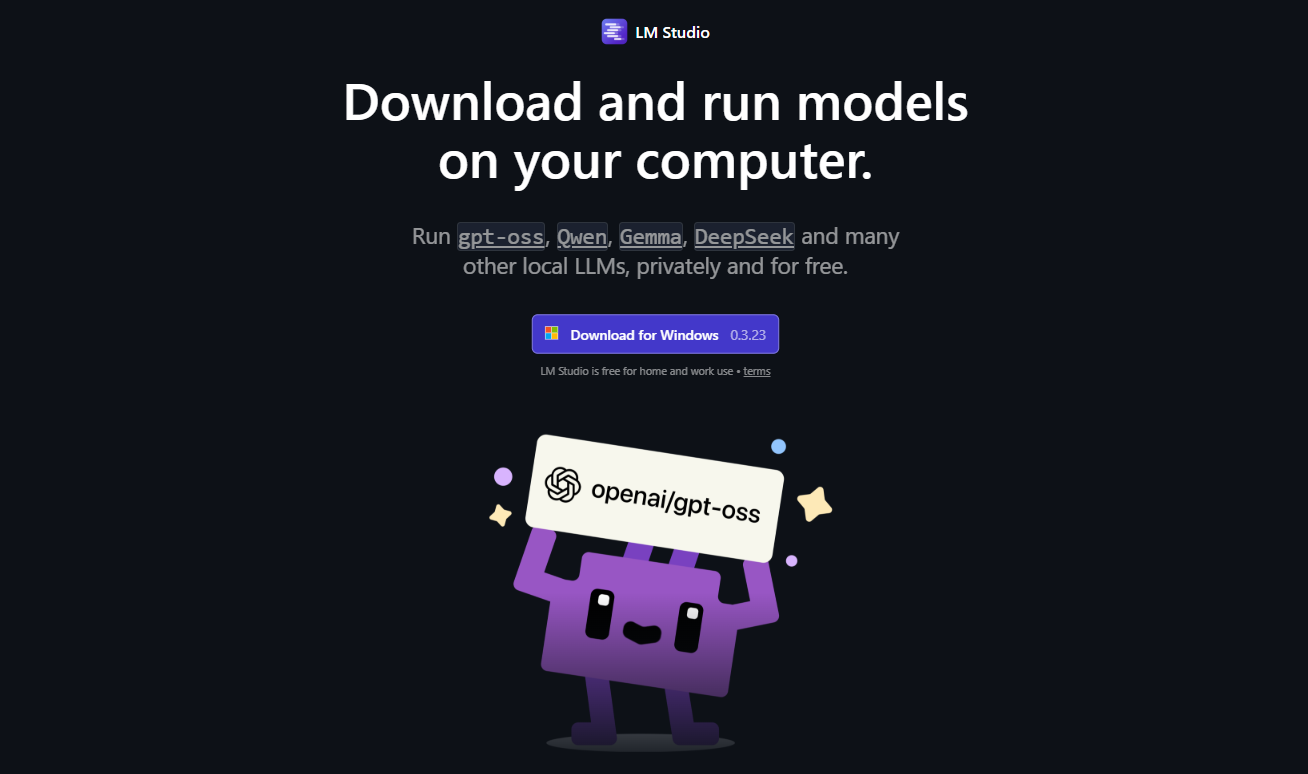
1. Laden Sie LM Studio von lmstudio.ai herunter und installieren Sie es.
2. Suchen Sie im Modell-Hub nach "gemma-3-270m".
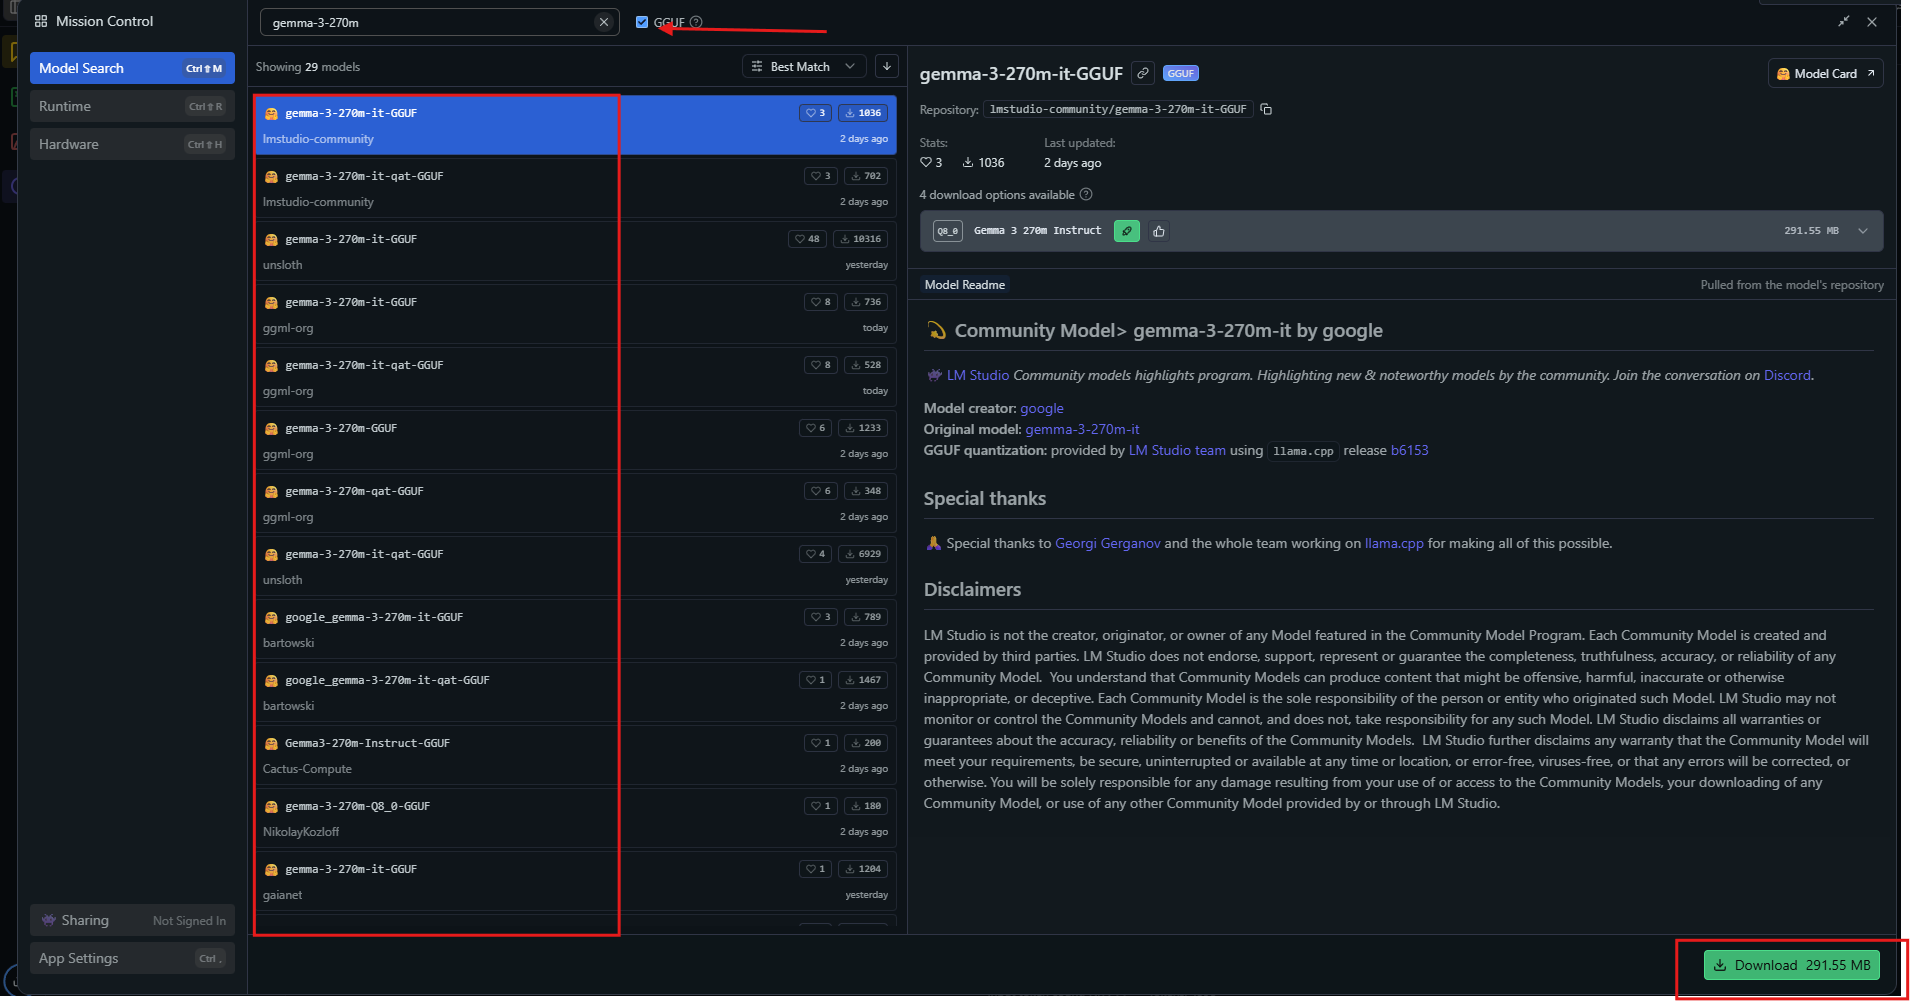
3. Laden Sie eine quantisierte Variante herunter (z. B. Q4_0).
4. Laden Sie das Modell, stellen Sie Parameter ein (Kontext: 32k, Temperatur: 1.0) und beginnen Sie zu chatten.
5. Aktivieren Sie GPU-Offloading für bessere Geschwindigkeit, falls verfügbar.
LM Studio ist ideal für schnelles Prototyping oder Teams, die eine No-Code-Oberfläche suchen.
Schritt-für-Schritt: Gemma 3 270M mit llama.cpp ausführen
Für optimale Effizienz, insbesondere auf eingebetteten oder ressourcenbeschränkten Systemen, versuchen Sie llama.cpp.
1. Klonen Sie das llama.cpp Repository:
git clone https://github.com/ggerganov/llama.cpp
cd llama.cpp
make -j
2. Laden Sie GGUF-Dateien von Hugging Face herunter:
huggingface-cli download unsloth/gemma-3-270m-it-GGUF --include "*.gguf"
3. Führen Sie das Modell aus:
./llama-cli -m gemma-3-270m-it-Q4_K_M.gguf -p "Build a simple AI app."
4. (Optional) Mit CUDA für NVIDIA GPUs kompilieren:
make GGML_CUDA=1
Setzen Sie Parameter wie --n-gpu-layers 999 für die vollständige GPU-Auslastung.
Praxisbeispiele: Gemma 3 270M in API-Workflows
Integrieren Sie Gemma 3 270M in Ihren API-Stack für:
1. Sentiment-Analyse
prompt = "Classify: This product is amazing!"
inputs = tokenizer(prompt, return_tensors="pt")
outputs = model.generate(**inputs)
print(tokenizer.decode(outputs[0]))
# Ausgabe: Positiv.
2. Zusammenfassung
text = "Long article here..."
prompt = f"Summarize: {text}"
# Verwenden Sie das Modell zur Generierung einer Zusammenfassung
3. Fragen und Antworten
Prompt:What causes climate change?
Das Modell liefert eine prägnante Erklärung, die für Chatbot- oder Wissensdatenbank-APIs geeignet ist.
4. Extraktion von Entitäten im Gesundheitswesen
Führen Sie klinische Notizen ein und extrahieren Sie wichtige Entitäten für die strukturierte Analyse – ideal für HIPAA-konforme lokale Verarbeitung.
Pro-Tipp: Verwenden Sie Apidog, um die APIs, die diese Modell-Endpunkte verbinden, zu entwerfen, zu simulieren und zu testen, um robuste, produktionsreife KI-Integrationen zu gewährleisten.
Feinabstimmung von Gemma 3 270M für kundenspezifische Aufgaben
Passen Sie Gemma 3 270M an spezialisierte Domänen durch parameter-effizientes Fine-Tuning (LoRA) an:
pip install peft
from peft import LoraConfig, get_peft_model
lora_config = LoraConfig(r=16, lora_alpha=32, target_modules=["q_proj", "v_proj"])
model = get_peft_model(model, lora_config)

from transformers import Trainer, TrainingArguments
trainer = Trainer(model=model, args=TrainingArguments(output_dir="./results"))
trainer.train()
- Trainieren Sie mit kleinen Datensätzen auf bescheidener Hardware
- Speichern und neu laden Sie Adapter für schnellen Aufgabenwechsel
- Verhindern Sie Overfitting durch Überwachung von Loss und Validierungsgenauigkeit
Tipps zur Leistungsoptimierung
- Quantisieren Sie auf 4-Bit oder 8-Bit für das beste Geschwindigkeits-/Speicher-Verhältnis
- Bündeln Sie Inferenzen, um den Durchsatz zu maximieren
- Generationsparameter einstellen: temperature=1.0, top_k=64, top_p=0.95
- Gemischte Präzision aktivieren auf kompatiblen GPUs
- VRAM-Nutzung überwachen (
nvidia-smi) - Bibliotheken regelmäßig aktualisieren für die neuesten Leistungsverbesserungen
Fehler vermeiden: Fügen Sie keine BOS-Tokens doppelt in Prompts ein; verwalten Sie Kontextfenster, um Trunkierung zu verhindern.
Fazit: Schnelle, sichere KI-Apps lokal entwickeln
Mit Gemma 3 270M erhalten Sie die Freiheit, fortschrittliche KI zu Ihren eigenen Bedingungen bereitzustellen – keine Cloud-Bindung, keine Kompromisse beim Datenschutz. Ob Sie Chatbots betreiben, Daten extrahieren oder interne Workflows beschleunigen, Gemma 3 270M liefert effizientes, zuverlässiges Sprachverständnis auf lokaler Hardware.
Entdecken Sie, wie Apidog Ihren API-Entwicklungslebenszyklus weiter optimieren kann – indem es Ihre lokalen KI-Modelle nahtlos mit Ihrem Backend, Frontend oder Drittanbieter-Integrationen verbindet.