
Um ERNIE 5.5 Flash lokal auszuführen, installieren Sie vLLM 0.32.0 zusammen mit Baidus vLLM-ERNIE-Plugin und starten Sie dann vllm serve baidu/ERNIE-5.5-Flash-Base mit Daten- und Expert-Parallelism auf einem Multi-GPU-Knoten. Sie erhalten einen OpenAI-kompatiblen Server auf Port 8000. Der Haken: Die heute offenen Gewichte sind das Base-Modell, ein Pretraining-Checkpoint, der Text fortsetzt – kein Chat-Modell.
Unten: was Sie herunterladen können, die von Baidu angegebene Hardware, die exakten Serve-Befehle und wie Sie den Endpoint testen. Jeder Befehl und jede Zahl stammt aus Baidus Hugging-Face-Modellkarte und dem vLLM-ERNIE-Repository, geprüft am 12. November 2026.
Neu beim Modell? Beginnen Sie mit was ERNIE 5.5 Flash ist. Wenn Sie das Chat-Modell ohne GPU-Cluster nutzen möchten, ist der ERNIE-5.5-Flash-API-Leitfaden der schnellere Weg.
Was können Sie heute lokal ausführen?
Sie können ERNIE 5.5 Flash Base ausführen, veröffentlicht auf Hugging Face in FP8 und BF16. Es ist ein sparses Mixture-of-Experts-Modell mit 280 Mrd. Parametern, von denen 14 Mrd. pro Token aktiv sind, trainiert auf 33,5 Billionen Tokens. Das chat-optimierte ERNIE 5.5 Flash Preview ist vorerst nur über die API verfügbar; Baidu kündigt die Gewichte „bald“ unter Apache 2.0 an.
So vergleichen sich die beiden Releases für das Self-Hosting:
| ERNIE 5.5 Flash Base | ERNIE 5.5 Flash Preview | |
|---|---|---|
| Was es ist | Checkpoint am Ende des Pretrainings | Erstes post-trainiertes Modell (Chat, Reasoning, Agent) |
| Gewichte | Hugging Face und ModelScope, FP8 und BF16 | Nicht veröffentlicht (Stand 12. November 2026) |
| Endpoint, den Sie aufrufen | /v1/completions (Textfortsetzung) |
Chat-Completions mit Reasoning und Tools |
| Lizenz | ERNIE 5.5 Flash Base Model License v1.0 | Apache 2.0 zum Release zugesagt |
| Wo Sie es jetzt nutzen können | Eigene GPUs | Qianfan API, OpenRouter |
Baidus ERNIE-5.5-Flash-Kollektion enthält derzeit nur die beiden Base-Checkpoints, und das vLLM-ERNIE-README markiert das Chat-Modell als „Coming soon“. Der Preview-Release-Beitrag nennt kein Datum.
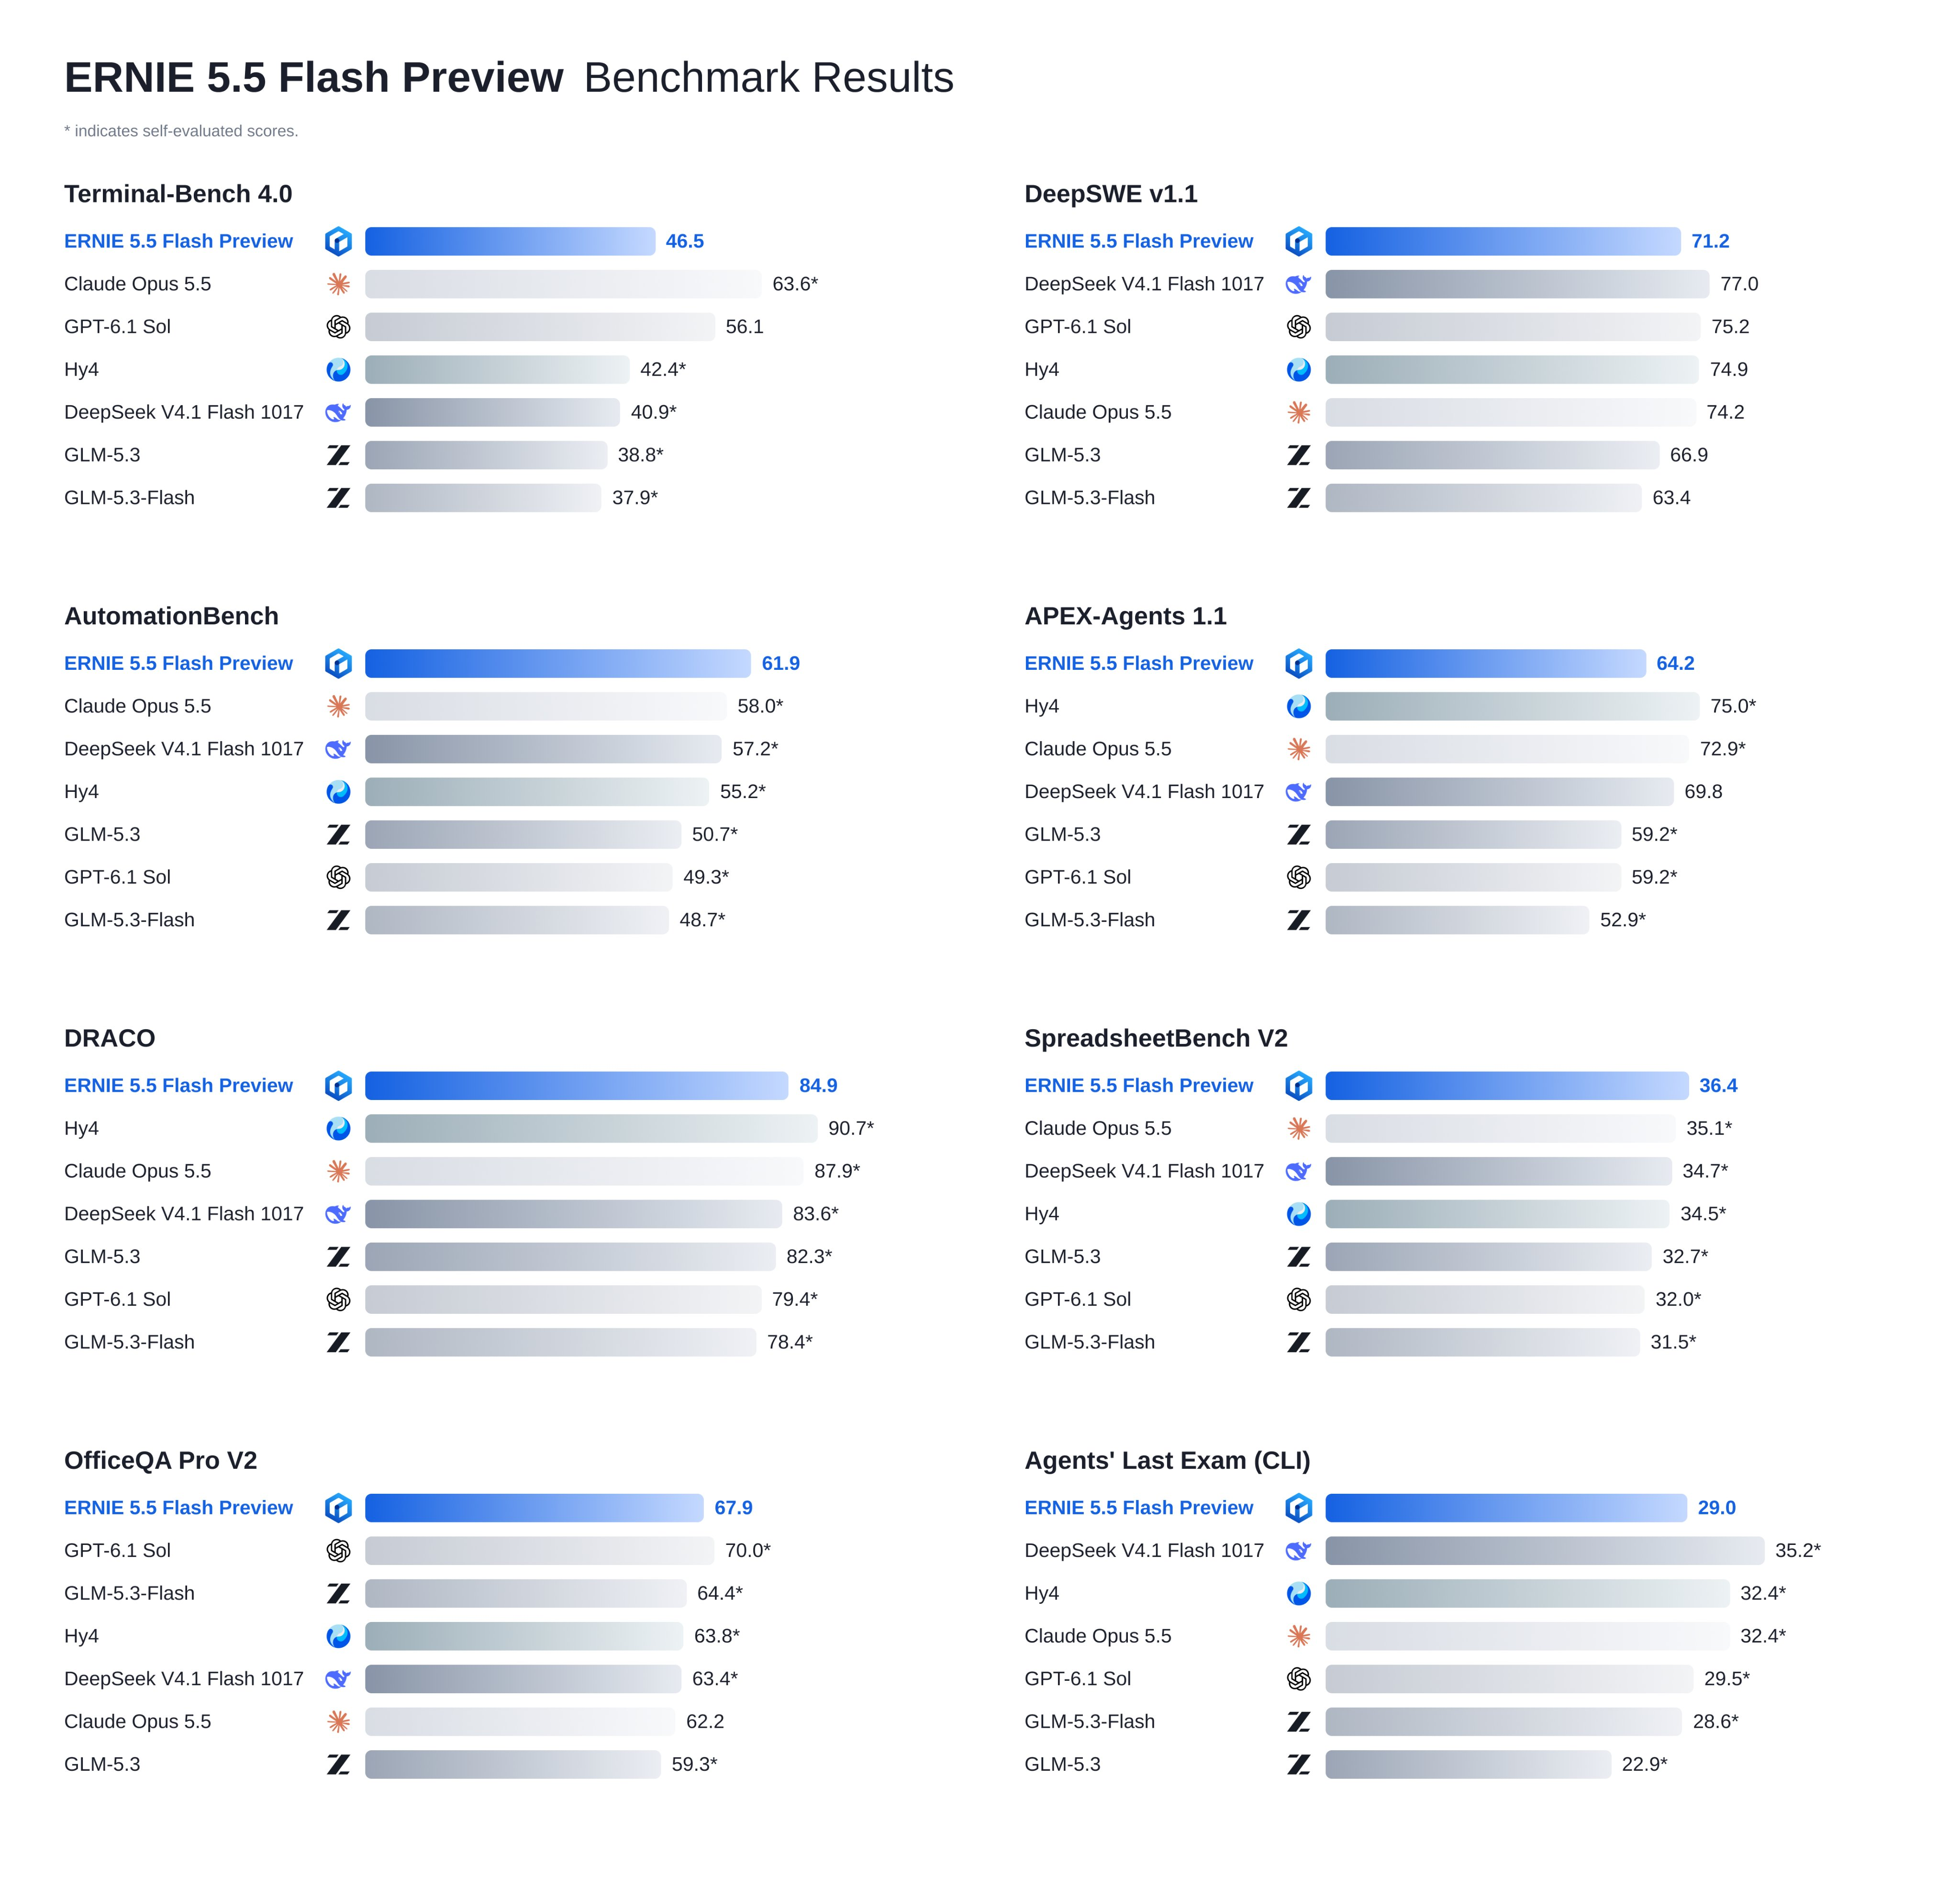
Wenn Sie heute einen Coding-Assistenten wollen, wird Sie ein lokales Base-Modell nicht liefern. Wenn Sie einen Ausgangspunkt für Fine-Tuning oder Few-Shot-Forschung suchen, ist Base genau dafür gebaut.
Hardware-Anforderungen für ERNIE 5.5 Flash
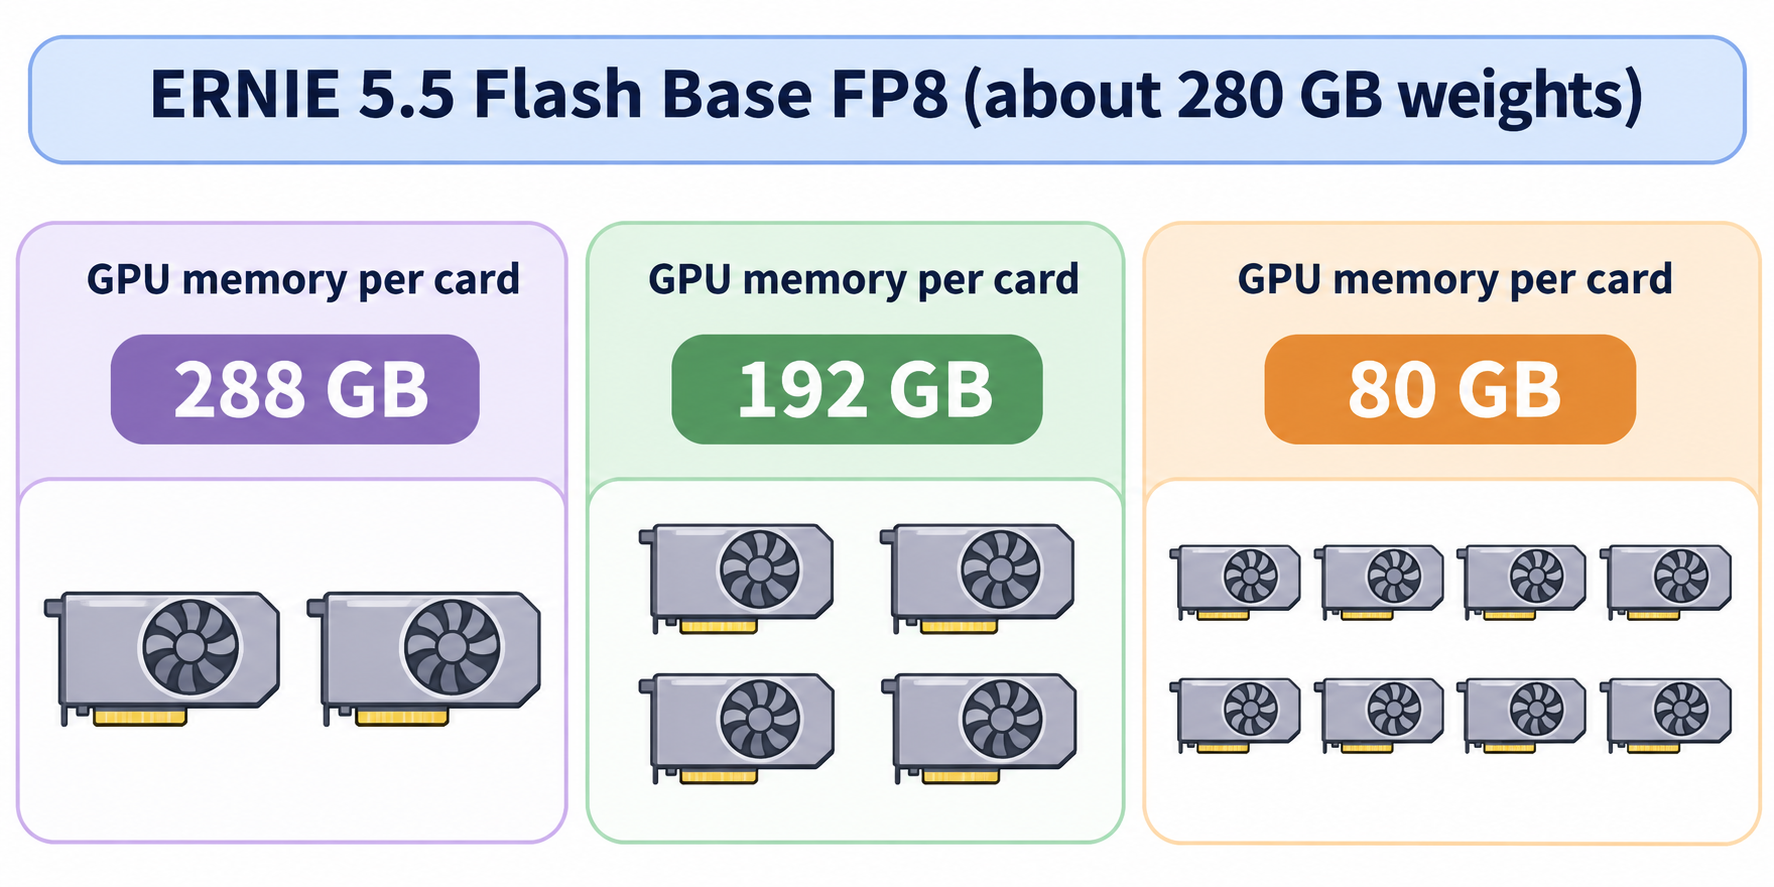
Die FP8-Gewichte benötigen etwa 280 GB GPU-Speicher, die BF16-Gewichte etwa 560 GB – das ist also eine Aufgabe für einen Multi-GPU-Server, nicht für einen Laptop. Das vLLM-ERNIE-README listet die kleinsten GPU-Anzahlen, die die Gewichte fassen, und das Plugin läuft nur auf NVIDIA-GPUs.
| GPU-Speicher pro Karte | FP8 (~280 GB Gewichte) | BF16 (~560 GB Gewichte) |
|---|---|---|
| 288 GB | 2 GPUs | 4 GPUs |
| 192 GB | 4 GPUs | 8 GPUs (oder 2 Knoten à 4 GPUs) |
| 80 GB | 8 GPUs | 2 Knoten à 8 GPUs |
Das sind die Mindestanforderungen, um die Gewichte zu laden. Der KV-Cache braucht zusätzlich Platz – deshalb hängt die Kontextlänge, die Sie ausliefern können, von Ihren Karten ab:
- 80-GB-GPUs: FP8 auf 8 GPUs ausliefern mit
--data-parallel-size 8und--gpu-memory-utilization 0.93. Bis zu 262.144 Tokens passen; 1 Million nicht. - 1-Million-Token-Kontext: Baidus Werte gelten für GPUs mit 184 GiB Speicher, mit auf 0,85 gesenkter Auslastung, weil ein 1-Million-Token-Prefill Dutzende GB temporären Speicher benötigt.
- Architektur ist entscheidend: Die FP8-Befehle übergeben
--moe-backend humming, das die SiTU-Aktivierung des Modells mit FP8-Gewichten auf Blackwell-GPUs unterstützt. Auf Hopper-GPUs lassen Sie dieses Flag weg und behalten vLLMs Standard-MoE-Kernel.
„Lokal“ bedeutet Hardware, die Sie kontrollieren: ein gemieteter 8-GPU-Knoten, ein On-Premise-Server oder ein Laborcluster.
vLLM und das ERNIE-Plugin installieren
vLLM unterstützt die ERNIE-5.5-Architektur (Ernie5_5_MoeForCausalLM) nicht standardmäßig. Baidu liefert sie als Plugin, das auf dem veröffentlichten vLLM-0.32.0-Wheel unverändert läuft. Erstellen Sie eine Python-3.12-Umgebung und installieren Sie beides:
uv venv --python 3.12
source .venv/bin/activate
uv pip install vllm==0.32.0
uv pip install git+https://github.com/baidu/vLLM-ERNIE.git
Das Plugin wird über vLLMs vllm.general_plugins-Einstiegspunkt in jedem vLLM-Prozess geladen. Wenn vllm serve später meldet Model architectures ['Ernie5_5_MoeForCausalLM'] are not supported, ist das Plugin entweder nicht in der Umgebung installiert, in der vllm läuft, oder VLLM_PLUGINS ist gesetzt, enthält aber nicht ernie.
Um die Gewichte stattdessen von ModelScope statt von Hugging Face zu laden, setzen Sie VLLM_USE_MODELSCOPE=True. Die Repository-Namen sind auf beiden Hubs identisch. Wenn Sie neu bei vLLM sind, erklärt unser vLLM-Überblick den Server und seine OpenAI-kompatible API.
Der vLLM-serve-Befehl für ERNIE 5.5 Flash
Das ist der FP8-Befehl aus dem vLLM-ERNIE-README, für einen 4-GPU-Knoten mit dem 128K-Trainingskontext und aktivem ECHO Speculative Decoding:
export VLLM_ENGINE_READY_TIMEOUT_S=3600
vllm serve baidu/ERNIE-5.5-Flash-Base \
    --host 0.0.0.0 \
    --port 8000 \
    --data-parallel-size 4 \
    --enable-expert-parallel \
    --moe-backend humming \
    --kv-cache-dtype fp8 \
    --max-model-len 131072 \
    --speculative-config '{"method":"mtp","num_speculative_tokens":2}'
Was jede Wahl bewirkt – laut Baidus Hinweisen:
- Data-Parallel-Attention plus Expert-Parallel-MoE (
--data-parallel-size 4 --enable-expert-parallel) fasst den meisten KV-Cache und liefert den höchsten Durchsatz. Tensor-Parallelismus (--tensor-parallel-size2, 4 oder 8) senkt die Latenz bei geringer Parallelität, fasst aber weniger KV-Cache. - FP8-KV-Cache (
--kv-cache-dtype fp8) speichert den Cache in FP8;autobehält ihn in BF16. - ECHO Speculative Decoding nutzt die eigene letzte Schicht des Modells als eingebauten Draft. Hier werden 2 Schritte entworfen; 1 oder 3 funktionieren ebenfalls. Lassen Sie
--speculative-configweg, um ohne Draft zu dienen.
Die Modellkarte zeigt eine kürzere Variante auf Port 30000 ohne die Speculative-Config.
Server absichern. Diese Befehle binden 0.0.0.0 ohne Authentifizierung. Baidus README empfiehlt, --api-key <key> hinzuzufügen oder 127.0.0.1 zu binden, sofern das Netzwerk nicht vertrauenswürdig ist. Tun Sie eines von beiden, bevor Sie den Port freigeben.
BF16 und 1M-Kontext
BF16 läuft über zwei 4-GPU-Knoten (DP8 plus EP8) mit --data-parallel-size 8, --data-parallel-size-local 4, --data-parallel-address ${HEAD_IP} und --data-parallel-hybrid-lb; der zweite Knoten fügt --data-parallel-start-rank 4 hinzu. Kopieren Sie den vollständigen Befehl aus dem README; er legt auch die Netzwerkschnittstelle zwischen den Knoten fest.
Für das volle 1.048.576-Token-Fenster übergeben Sie --max-model-len 1048576 und --gpu-memory-utilization 0.85 und senken --max-num-seqs, sodass der KV-Cache jedes Ranks ganze 1-Million-Token-Anfragen fasst.
Den OpenAI-kompatiblen Endpoint aufrufen
vLLM stellt OpenAI-artige Routen bereit, aber ein Base-Modell hat keine Chat-Vorlage, daher rufen Sie /v1/completions mit einem Roh-Prompt auf. Für Few-Shot-Nutzung legen Sie die Beispiele in den Prompt und stoppen am Ende einer Antwort:
curl http://127.0.0.1:8000/v1/completions \
    -H 'Content-Type: application/json' \
    -d '{
        "model": "baidu/ERNIE-5.5-Flash-Base",
        "prompt": "Question: What is 15% of 240?\nAnswer:",
        "max_tokens": 64,
        "temperature": 0,
        "stop": ["\n"]
    }'
Laut Baidus README kommt der Completion-Text als 36 zurück. Drei Details sorgen für Verwirrung:
"temperature": 0für Greedy Decoding übergeben. Diegeneration_config.jsondes Modells setztdo_sample=false,temperature=1.0undtop_p=0.95. vLLM wendet Temperature und top_p an, ignoriert aberdo_sample– Sie samplen also, sofern Sie das nicht überschreiben.<|ERNIE_MASK|>nicht selbst hinzufügen. Der Tokenizer stellt es (Token-ID 2) Completion-Prompts automatisch voran.- Modellname passend wählen. Verwenden Sie
baidu/ERNIE-5.5-Flash-Base-BF16, wenn Sie die BF16-Gewichte ausliefern.
Jedes OpenAI-SDK funktioniert, wenn Sie base_url auf http://<host>:8000/v1 zeigen lassen und Completions statt Chat-Completions aufrufen.
Base oder Preview: Was sollten Sie verwenden?
Verwenden Sie Base, wenn Sie darauf weitertrainieren möchten; verwenden Sie Preview, wenn Sie jetzt einen funktionierenden Assistenten brauchen. Base gibt Ihnen volle Kontrolle und Daten, die Ihre Server nie verlassen. Preview bietet Chat, Reasoning und Tool Calling – nur über Qianfan oder OpenRouter.
Wenn die Preview-Gewichte erscheinen, ist das Plugin bereits darauf vorbereitet. Das README dokumentiert die zusätzlichen Flags, markiert als „Coming soon“: --reasoning-parser ernie5 --tool-call-parser ernie5 --enable-auto-tool-choice, plus ein DSpark-Draft-Modell für Speculative Decoding. Thinking wird dann in reasoning_content zurückkommen und Tool-Aufrufe in message.tool_calls – derselbe Server, den Sie heute aufbauen, wird also durch einen Gewichtstausch und drei Flags zum Chat-Backend.
Die Lizenz ist der andere Unterschied. Base erscheint unter der ERNIE 5.5 Flash Base Model License Agreement v1.0, nicht unter Apache 2.0. Lesen Sie die vollständige Lizenz, bevor Sie darauf ein Produkt aufbauen. Am 12. November 2026 lautete sie:
- Nicht-kommerzielle Nutzung ist kostenlos, ohne Vorankündigung.
- Kommerzielle Nutzung, bei der das zugehörige Produkt bis zu 50 Mio. US-Dollar pro Jahr erwirtschaftet, ist lizenzgebührenfrei, aber Sie müssen „Powered by ERNIE“ anzeigen und Baidu eine einmalige Mitteilung senden.
- Über 50 Mio. US-Dollar pro Jahr hinaus benötigen Sie zunächst Baidus separate schriftliche Genehmigung.
- Das „Territory“ der Lizenz schließt die Europäische Union, das Vereinigte Königreich und Südkorea aus.
Für ein kleineres Open-Weights-Modell, das Sie mit weniger GPUs selbst hosten können, sehen Sie sich unseren Leitfaden zum Self-Hosting von GLM-5.3 an.
Lassen Sie Ihren Coding-Agenten den Endpoint mit Apidog CLI testen
Eine frische vLLM-Bereitstellung braucht einen Smoke-Test, den Sie nach jeder Flag-Änderung erneut ausführen können: Status, Antwort-Schema und Tokens pro Sekunde. Übertragen Sie das an Ihren Coding-Agenten und die Apidog CLI, statt curl immer wieder neu einzutippen.
Richten Sie die CLI einmalig ein:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Geben Sie dann Claude Code, Codex oder Cursor einen Prompt:
In Apidog project <projectId>, create an environment "ernie-local" with base URL
http://<gpu-host>:8000. Add a test case for POST /v1/completions with model
baidu/ERNIE-5.5-Flash-Base, prompt "Question: What is 15% of 240?\nAnswer:",
max_tokens 64, temperature 0. Assert status 200, that choices[0].text exists,
and that usage.completion_tokens > 0; log completion_tokens divided by the
response time in seconds as tokens/s. Run it and summarize the result.
Der Agent liest das Payload-Schema, validiert es, schreibt den Testfall und führt ihn aus:
apidog environment create ernie-local --project <projectId> --base-url http://<gpu-host>:8000
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
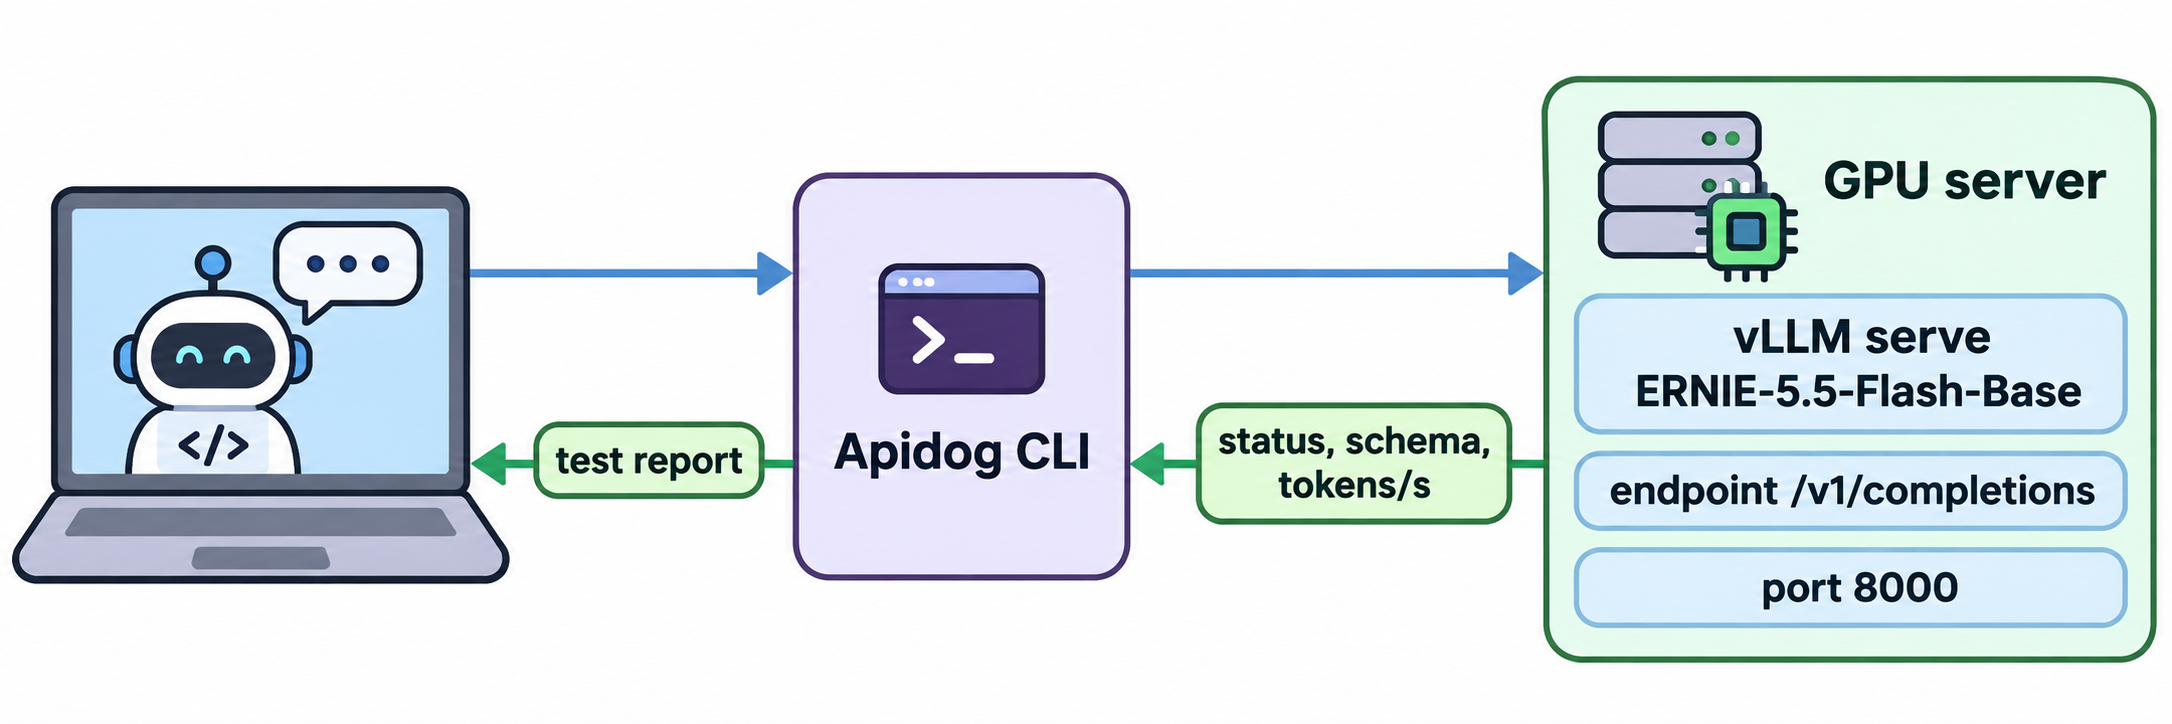
Führen Sie die CLI von einer Maschine aus, die Port 8000 erreicht. Wenn Sie auf dem Server --api-key gesetzt haben, lassen Sie den Agenten ihn als Umgebungsvariable speichern und als Bearer-Token senden. Führen Sie denselben Testfall erneut aus, nachdem Sie --tensor-parallel-size geändert, Speculative Decoding deaktiviert oder --max-model-len erhöht haben – so erhalten Sie einen direkten Vergleich. Mit -r junit geht derselbe Lauf in Ihre CI. Für die Einrichtung des Agenten Schritt für Schritt siehe Apidog CLI in Claude Code. Der Apidog-Free-Plan deckt bis zu 4 Nutzer ab.
FAQ
Kann ich ERNIE 5.5 Flash auf einer einzelnen Consumer-GPU ausführen? Nein. Die FP8-Gewichte sind etwa 280 GB groß, und Baidus kleinste angegebene Konfiguration sind 2 GPUs mit je 288 GB. Mit 80-GB-Karten brauchen Sie 8 davon. Nutzen Sie das Preview über die API, wenn Sie diese Hardware nicht haben.
Sind die ERNIE-5.5-Flash-Preview-Gewichte verfügbar? Nicht Stand 12. November 2026. Baidu kündigt an, sie bald unter Apache 2.0 zu veröffentlichen, und das vLLM-ERNIE-Plugin listet das Chat-Modell als „Coming soon“. Nur die Base-Gewichte (FP8 und BF16) sind auf Hugging Face.
Warum schlägt /v1/chat/completions beim Base-Modell fehl? Base hat kein Chat-Training und keine Chat-Vorlage. Baidu liefert es über /v1/completions mit einem Roh-Text-Prompt aus. Legen Sie Few-Shot-Beispiele in den Prompt und verwenden Sie eine Stop-Sequenz.
Unterstützt vLLM ERNIE 5.5 nativ? Nicht im vLLM-Kern. Sie brauchen Baidus vLLM-ERNIE-Plugin auf vLLM 0.32.0. Es läuft nur auf NVIDIA-GPUs. SGLang stellt das Modell ebenfalls bereit – über ein dediziertes Docker-Image, das auf der Modellkarte genannt wird.
Kann ich ERNIE 5.5 Flash Base kommerziell nutzen? Ja, unter Bedingungen. Produkte mit bis zu 50 Mio. US-Dollar Jahresumsatz können es lizenzgebührenfrei nutzen, mit „Powered by ERNIE“-Attribution und einer einmaligen Mitteilung an Baidu. Darüber hinaus benötigen Sie eine schriftliche Genehmigung, und das Lizenzgebiet schließt die EU, das Vereinigte Königreich und Südkorea aus.