
Sie können DeepSeek V4 Flash lokal ohne GPU betreiben – mit llama-modchip, einem Open-Source-Satz von llama.cpp-Patches, der das 284B-Modell auf eine 56,56-GiB-GGUF-Datei mit 1,71 Bits pro Gewicht verkleinert. Auf einem Laptop-Chip mit 16-Kern-AMD Zen 5 und 64 GB RAM liegt das Prefill bei etwa 44 Token pro Sekunde, das Decoding bei 9 bis 15 Token pro Sekunde – ohne jegliches Swapping.
Dieser Leitfaden behandelt die Hardware, die Befehle, die Qualitätskompromisse und wie Ihr Coding-Agent den lokalen Endpoint testen kann.
Was llama-modchip eigentlich macht
llama-modchip ist eine Sammlung von ggml- und llama.cpp-Kernel-Patches, Quantisierungs-Transcodern und Runtime-Tools, mit denen sich sparsame Mixture-of-Experts-Modelle vollständig im System-RAM betreiben lassen. Die Version v2.4.0 zielt auf zwei Modellgrößen: das 284B-Modell DeepSeek-V4-Flash auf Maschinen mit 64 GB und 30B-MoE-Modelle auf Maschinen mit 16 bis 32 GB.
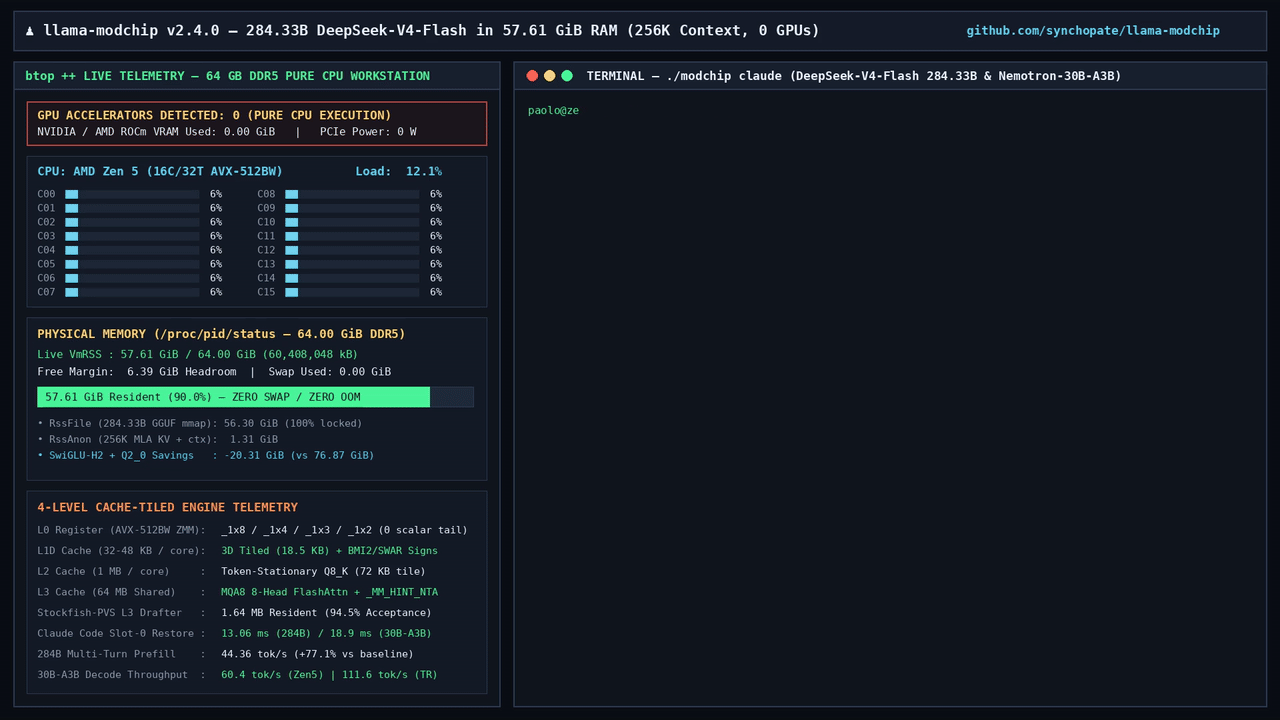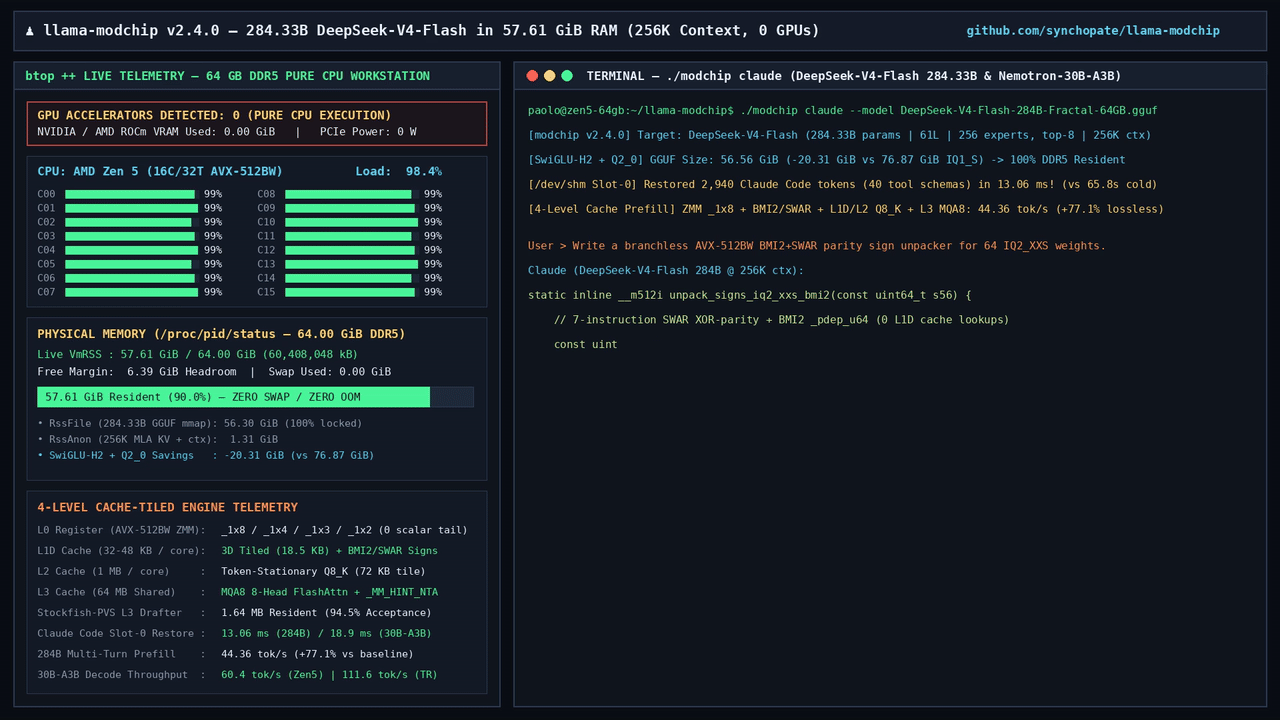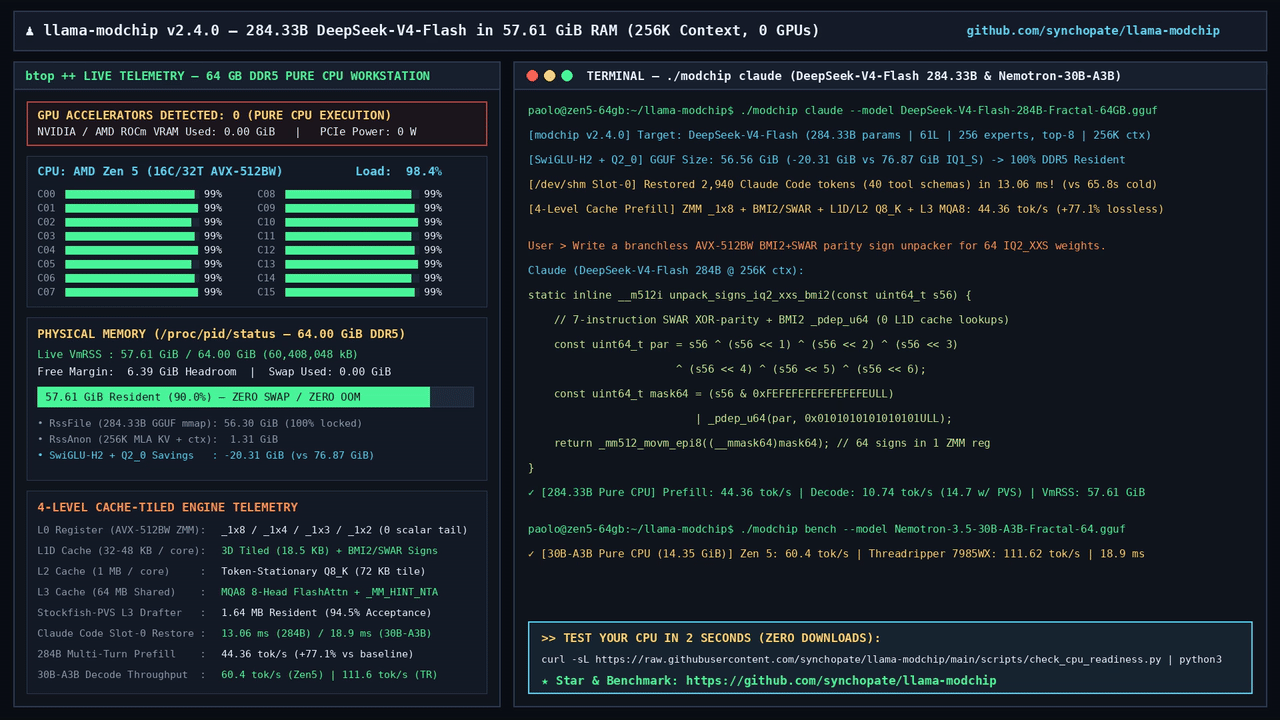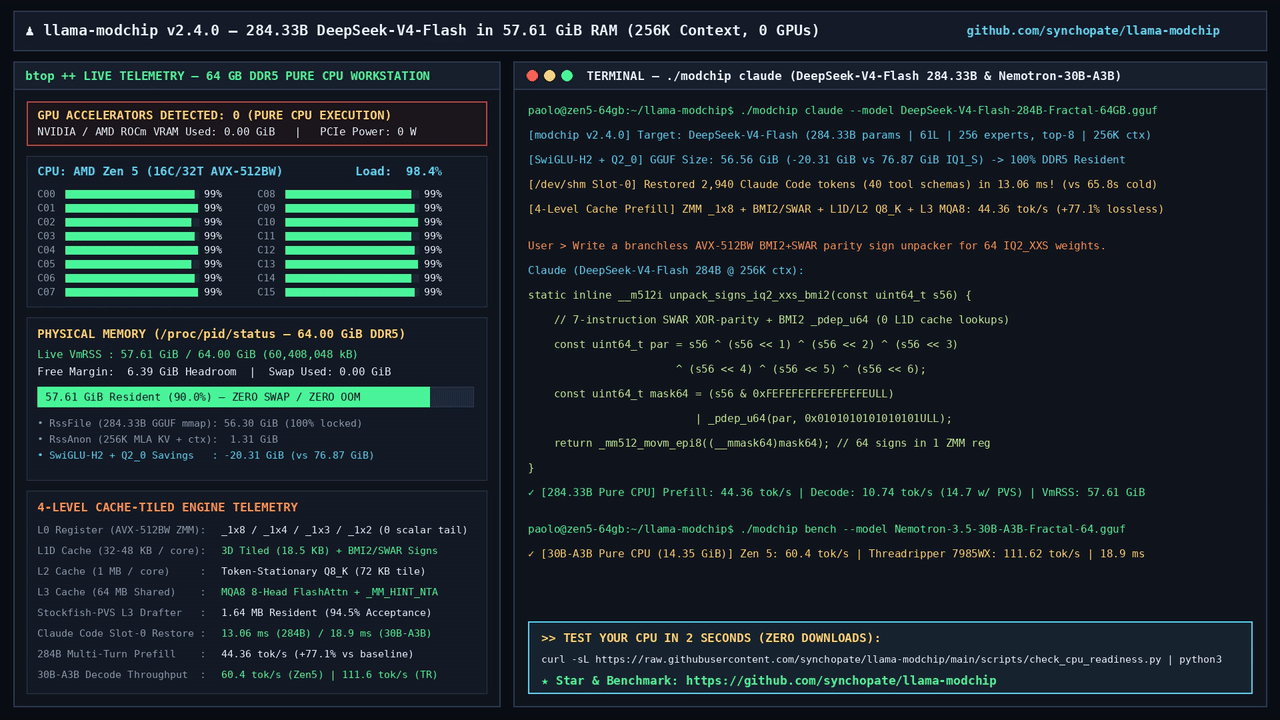
Das Projekt wurde am 8. November 2026 auf Hacker News veröffentlicht und erreichte über 370 Punkte. Das Repository steht unter der Apache-2.0-Lizenz.
Drei Dinge ermöglichen es, das 284B-Modell unterzubringen:
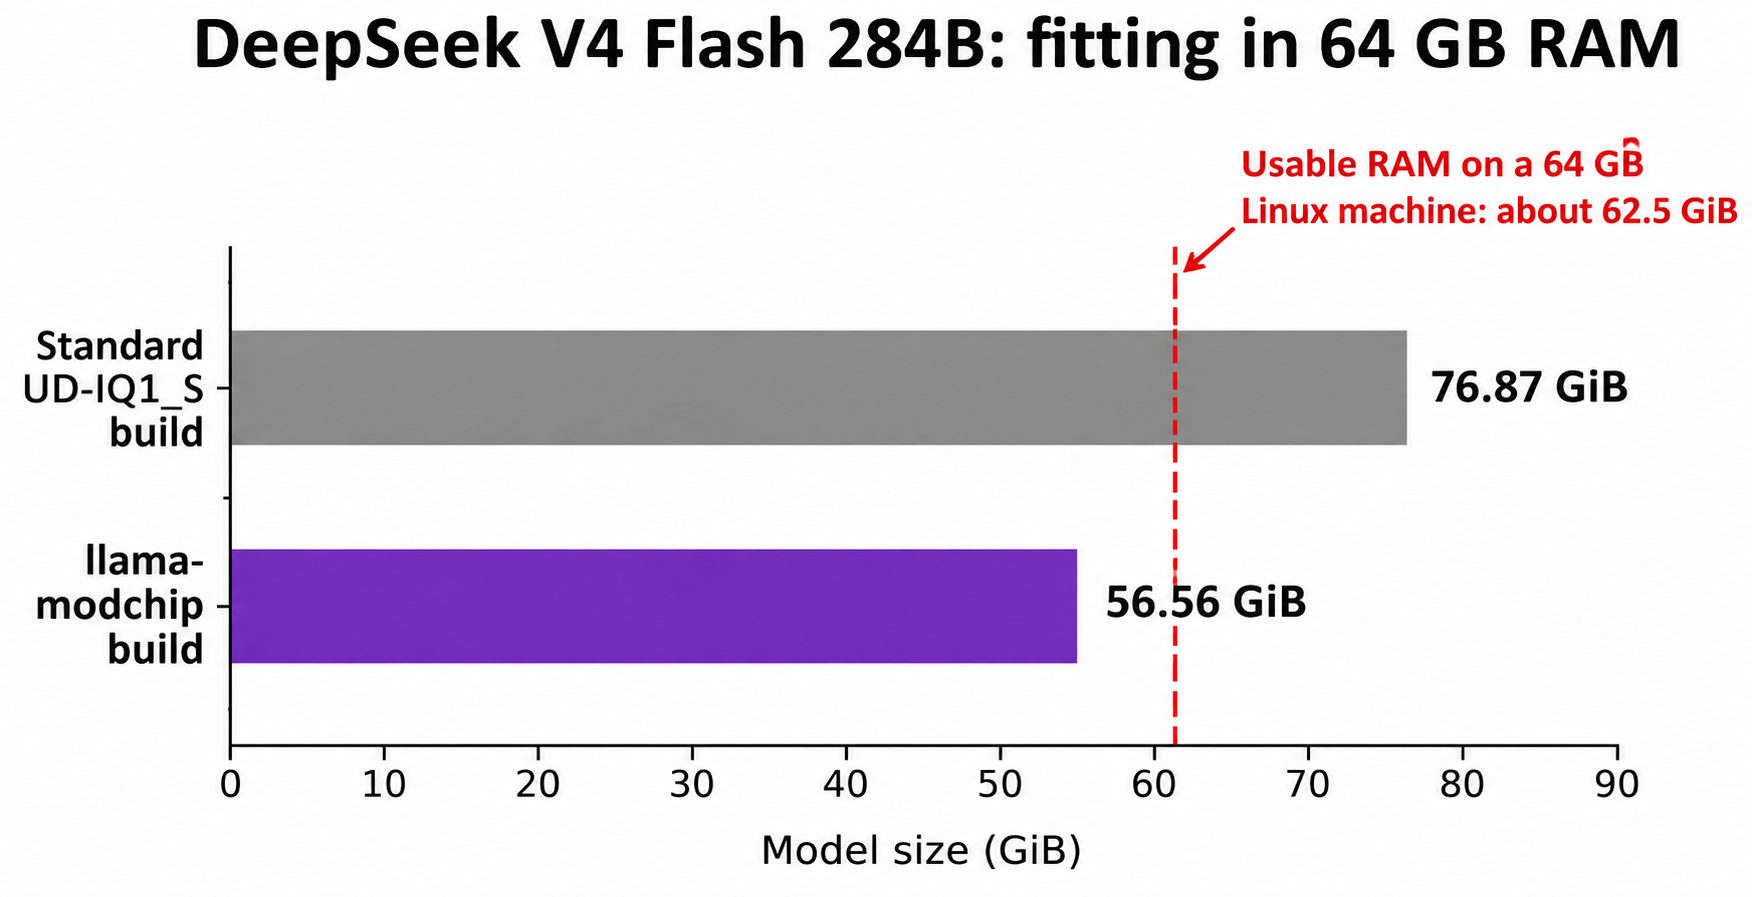
- Ein kleinerer Checkpoint. Der übliche Unsloth-Build
UD-IQ1_Sist 76,87 GiB groß – mehr als die etwa 62,5 GiB, die ein Linux-System mit 64 GB nutzen kann. llama-modchip transcodiert ihn auf 56,56 GiB. - CPU-Cache-Tiling. Die Prefill-Kernels verteilen die Arbeit auf Register und den L1- bis L3-Cache: 25,0 bis 44,36 Token pro Sekunde auf 16-Kern-Zen 5, ein Zuwachs von 77 %.
- Self-Speculative Drafting. Ein n-Gram-Drafter mit nur 1,64 MB hebt das Decoding von etwa 9 auf bis zu 14,7 Token pro Sekunde.
Standardmäßig laufen auf jeder Schicht alle 6 gerouteten Experten plus der geteilte Experte – es wird also nichts beschnitten.
Welche Hardware Sie für DeepSeek V4 Flash lokal brauchen
Sie brauchen 64 GB System-RAM und eine aktuelle x86_64-CPU, idealerweise mit AVX-512. Jede 284B-Zahl in diesem Leitfaden wurde vom Maintainer auf einer einzigen Maschine gemessen: einem AMD Ryzen 9 9955HX (16 Kerne, 32 Threads, 64 MB L3) mit 64 GB DDR5 unter Linux, ohne GPU.
| Ihre Maschine | RAM | Was das README dazu empfiehlt | Angegebene Geschwindigkeit (0 GPUs) |
|---|---|---|---|
| Laptop oder Mini-PC | 16 bis 32 GB | Nemotron-3.5-30B-A3B, 14,35 GiB | 25,0 bis 60,4 tok/s |
| Desktop oder Server | 64 GB | DeepSeek-V4-Flash 284B, 56,56 GiB | 44,4 tok/s Prefill, 9,1 bis 14,7 tok/s Decode |
| Workstation mit 8 Kanälen | 128 GB+ | DeepSeek 284B oder Nemotron 30B | 111,62 tok/s (nur 30B) |
- Der Speicherverbrauch liegt bei 256K Kontext bei 57,61 bis 58,9 GiB und bleibt damit unter der nutzbaren Grenze von 62,5 GiB. Schließen Sie vor dem Laden alles andere.
- Das vorgebaute Binary gibt es nur für Linux x86_64 (
llama-server-modchip-linux-x86_64). Das Setup-Skript./modchipunterstützt Linux und macOS. Die Apple-Silicon-Ergebnisse im README beziehen sich auf 30B-Modelle, nicht auf das 284B-Modell. [VERIFY] Läuft das 284B-Modell auf einem Mac mit 64 GB? - Die Speicherbandbreite ist der begrenzende Faktor. Laut FAQ skaliert ein Server-Board mit 8 oder 12 Kanälen das Decoding etwa um das 3- bis 4-Fache gegenüber zwei-Kanal-DDR5.
Das Repository enthält einen Bereitschaftstest, der kein Modell herunterlädt:
curl -sL https://raw.githubusercontent.com/synchopate/llama-modchip/main/scripts/check_cpu_readiness.py | python3
Lesen Sie das Skript, bevor Sie es an Python weiterleiten.
DeepSeek V4 Flash ohne GPU betreiben – Schritt für Schritt
Weg 1: Das geführte Setup
git clone https://github.com/synchopate/llama-modchip.git
cd llama-modchip
./modchip chat
./modchip chat öffnet einen Terminal-Chat mit Live-Anzeige der Token pro Sekunde. Weitere Unterkommandos:
| Befehl | Funktion |
|---|---|
./modchip web |
Web-Chat und Telemetrie unter http://127.0.0.1:8787 |
./modchip bench |
30-sekündiger Geschwindigkeitstest mit teilbarem Scorecard |
./modchip claude |
Startet Claude Code, verbunden mit der lokalen Engine |
./modchip status / stop |
Prüft die Bereitschaft oder stoppt Hintergrunddienste |
Weg 2: Der direkte Server
Dadurch werden die GGUF-Datei und der vorgebaute Server aus dem Hugging-Face-Repository geladen und auf Port 8080 gestartet:
hf download Synchopate/DeepSeek-V4-Flash-0731-Fractal-64GB-CPU-GGUF --local-dir ./dsv4
chmod +x ./dsv4/llama-server-modchip-linux-x86_64
./dsv4/llama-server-modchip-linux-x86_64 \
  -m ./dsv4/DeepSeek-V4-Flash-0731-Fractal-00001-of-00003.gguf \
  -c 32768 -t 16 -fa on --port 8080
Setzen Sie -t auf die Anzahl Ihrer physischen Kerne. Das Beispiel nutzt einen 32K-Kontext; die 256K-Werte verwenden -c 262144.
Eine Falle: Standard-llama.cpp, Ollama und LM Studio können diese Datei nicht laden. Der Checkpoint verwendet einen benutzerdefinierten Tensor-Typ (ID 40), daher scheitern ungepatchte Builds mit unknown tensor type 40. Verwenden Sie das ./modchip-Skript oder das mitgelieferte Binary.
Der Server ist ein gepatchter llama.cpp-llama-server und spricht daher die OpenAI-artige Route /v1/chat/completions:
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"messages":[{"role":"user","content":"Reply with the word ready."}],"max_tokens":8}'
Das Gateway auf Port 8787
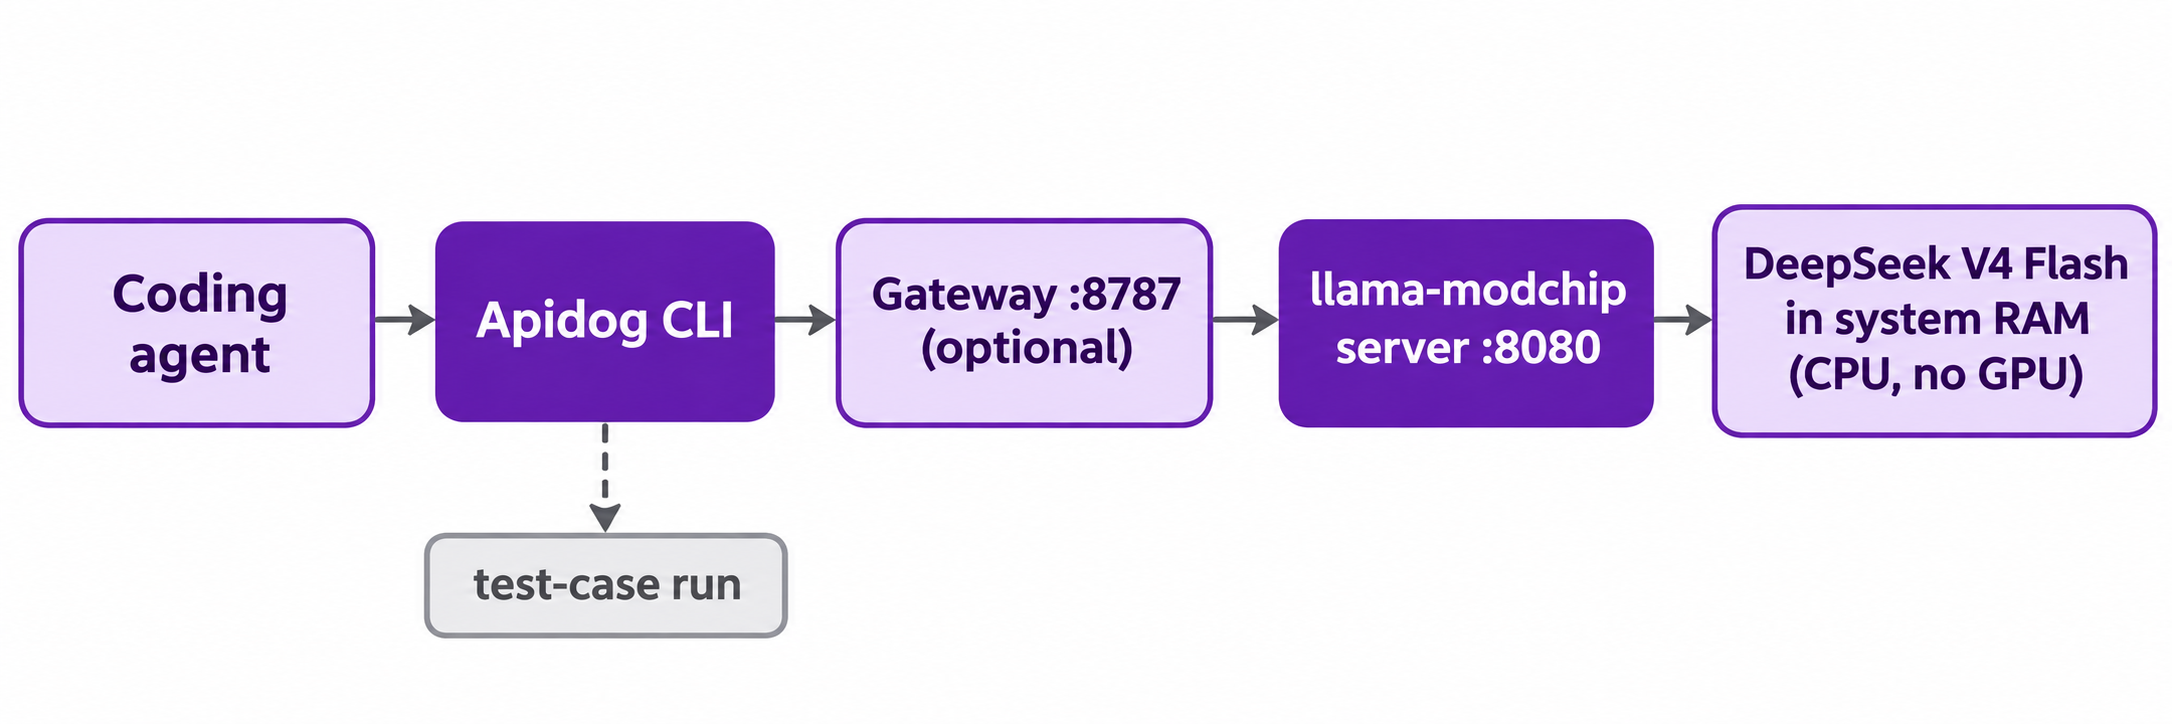
gateway/sse_gateway.py ist ein Proxy auf 127.0.0.1:8787, der an die Engine weiterleitet (Upstream über LLAMA_BACKEND_URL festlegen). Er stellt /v1/chat/completions, /v1/messages, /v1/models und /health bereit. Setzt man GATEWAY_API_KEY, verlangt er einen Bearer-Token. ./modchip claude verweist Claude Code auf dieses Gateway.
Geschwindigkeit und Qualität: Was 1,71 Bits pro Gewicht kosten
Die Geschwindigkeitswerte sind real, aber spezifisch. Hier die Tabelle des Maintainers für DeepSeek-V4-Flash bei 256K Kontext auf dem Ryzen 9 9955HX:
| Konfiguration | Prefill | Decode | Decode mit Drafter |
|---|---|---|---|
Ungepatchtes UD-IQ1_S (76,87 GiB) |
OOM oder Swapping bei 64 GB | 5,91 tok/s | N/A |
| v2.4.0 Standard (Top-6, 56,56 GiB) | 43,16 bis 44,36 tok/s | 9,06 bis 9,95 tok/s | 11,5 bis 14,7 tok/s |
| Top-5 auf späteren Schichten | 43,16 bis 44,36 tok/s | 9,68 bis 9,87 tok/s | 12,2 bis 15,1 tok/s |
| Top-4 plus Gate-first SwiGLU | 43,16 bis 44,36 tok/s | 10,12 bis 10,74 tok/s | 13,0 bis 16,0 tok/s |
Mit LLAMA_MOE_TOP_K=5 oder 4 schalten Sie auf die schnelleren Zeilen um. Laut README kostet Top-5 etwa 0,42 % Perplexität gegenüber dem eigenen Standard.
Zwei Vorbehalte tauchten auf Hacker News immer wieder auf:
- „Verlustfrei“ bedeutet verlustfrei gegenüber der 1,71-bpw-Datei, nicht gegenüber den Originalgewichten. Die Kosinusähnlichkeit von 1,00000 vergleicht gepatchte und ungepatchte Runtimes auf demselben verkleinerten Checkpoint, bei dem die meisten gerouteten Experten bei
IQ1_S(etwa 1,56 Bits) liegen. Kommentatoren wiesen darauf hin, dass die Qualität üblicherweise unter 4 Bits abfällt, und das README enthält keinen Vergleich mit Full-Precision-Ausgabe. - Prefill ist der Flaschenhals für Agenten. Bei 44 Token pro Sekunde dauert ein 10.000-Token-Prompt etwa 225 Sekunden, bevor das erste Ausgabe-Token erscheint. KV-Snapshots (13,1 bis 32,6 ms Wiederherstellung bei einem Claude-Code-Prompt mit 40 Tools) helfen bei Wiederholungszügen, nicht bei frischem Kontext.
Noch etwas: Dies ist der V4-Flash-Checkpoint 0731 aus Juli. DeepSeek hat inzwischen V4.1 Flash veröffentlicht. Wenn Ihnen die neuesten Gewichte wichtig sind, lesen Sie zuerst, wie sich DeepSeek V4.1 Flash mit V4 Pro und V4 Flash vergleichen lässt.
Betrachten Sie das lokale 284B-Modell als privates, Offline-Modell für Entwürfe, Batch-Jobs und Experimente – und testen Sie es zunächst mit Ihren eigenen Prompts.
Ihren Coding-Agenten den lokalen Endpoint mit Apidog CLI testen lassen
Ein lokales Modell bleibt eine API: Antwortet es, ist das JSON gültig, hat die letzte Änderung eines Flags etwas kaputtgemacht? Ihr Coding-Agent kann diese Prüfungen mit Apidog CLI ausführen, das auf Ihrer Maschine läuft und 127.0.0.1 direkt erreicht. Einmalig einrichten:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
apidog skill install fügt die Apidog-Skill hinzu, damit Ihr Agent die Befehle kennt. Geben Sie dem Agenten – etwa Claude Code – dann einen Prompt:
In Apidog project <projectId>, create an environment called local-dsv4 with base URL
http://127.0.0.1:8080. Add a POST /v1/chat/completions endpoint and a test case that
sends a short prompt, asserts status 200, asserts choices[0].message.content is not empty,
and asserts the response time is under 120 seconds. Run it against local-dsv4 and
summarize any failures.
Der Agent liest die Schemas, validiert seine Payloads und schreibt dann aus und führt aus:
apidog environment create local-dsv4 --project <projectId> --base-url http://127.0.0.1:8080
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog test-case run <caseId> --project <projectId> -e <envId> -r cli,json --timeout-request 180000
--timeout-request (Millisekunden) ist entscheidend: Ein CPU-gebundenes 284B-Modell ist langsam genug, um ein Standard-Timeout auszulösen.
Der Vorteil ist der Vergleich: Richten Sie eine zweite Umgebung auf DeepSeeks gehostete API, führen Sie denselben Testfall aus und sehen Sie, wo die lokale Quantisierung abweicht. Mit --upload-report können Sie die Läufe in der App betrachten. Siehe dazu Apidog CLI in Claude Code und die Installationsanleitung für Apidog CLI. Apidogs Free-Plan deckt bis zu 4 Nutzer ab.
Lokale CPU vs. GPU vs. gehostete API
| Option | Was Sie brauchen | Am besten geeignet für |
|---|---|---|
| llama-modchip auf CPU | 64 GB RAM, moderne x86_64-CPU | Private, Offline-Arbeit ohne API-Kosten – wenn Sie langsames Prefill akzeptieren |
| GPU-Serving mit vLLM oder SGLang | Viel VRAM oder eine Multi-GPU-Maschine | Schnelles, höherpräzises Self-Hosting |
| DeepSeek gehostete API | Einen API-Schlüssel | Volle Qualität in Produktionsgeschwindigkeit |
Für den GPU-Weg folgen Sie DeepSeek V4 lokal ausführen, das vLLM und SGLang behandelt. Für die Speicherrechnung des neueren Checkpoints siehe DeepSeek V4.1 Flash lokal ausführen. Zum Testen beliebiger lokaler Modelle als API siehe lokale LLMs als APIs testen.
FAQ
Kann ich DeepSeek V4 Flash wirklich ohne GPU betreiben?
Ja, mit llama-modchip und 64 GB RAM. Der Maintainer berichtet von 44,36 Token pro Sekunde Prefill und 9 bis 15 Token pro Sekunde Decode auf einem 16-Kern-Ryzen 9 9955HX – mit dem gesamten 56,56-GiB-Modell im RAM und ohne Swapping.
Funktioniert es mit Ollama oder LM Studio?
Nein. Der Checkpoint verwendet einen benutzerdefinierten Tensor-Typ, und ungepatchtes llama.cpp, Ollama und LM Studio weisen ihn mit unknown tensor type 40 zurück. Verwenden Sie das ./modchip-Skript des Repos oder das mitgelieferte Binary llama-server-modchip-linux-x86_64.
Was, wenn ich nur 16 oder 32 GB RAM habe?
Betreiben Sie stattdessen ein 30B-MoE-Modell. Das README ordnet dieser Stufe Nemotron-3.5-30B-A3B als 14,35-GiB-Datei zu und meldet 25,0 bis 60,4 Token pro Sekunde auf der CPU.
Wie gut ist die Ausgabe bei 1,71 Bits pro Gewicht?
Das Projekt vergleicht nicht mit Full-Precision-DeepSeek, und auf Hacker News zeigten sich Kommentatoren bei dieser Größe skeptisch. Testen Sie Ihre Prompts gegen die gehostete API, bevor Sie sich darauf verlassen.
Ist der lokale Server OpenAI-kompatibel?
Ja. Es ist ein gepatchter llama.cpp-llama-server, daher funktioniert /v1/chat/completions auf Port 8080. Das optionale Gateway auf Port 8787 stellt zusätzlich /v1/messages bereit – die Anthropic-artige Route, die Claude Code verwendet.
Kann mein Coding-Agent das lokale Modell automatisch testen?
Ja. Installieren Sie Apidog CLI, führen Sie apidog skill install aus und bitten Sie Ihren Agenten, eine Umgebung für http://127.0.0.1:8080 und einen Testfall für /v1/chat/completions anzulegen. Anschließend führt er apidog test-case run aus und meldet Fehler.