Wenn Sie sich jemals gewünscht haben, Fragen direkt an eine PDF-Datei oder ein technisches Handbuch stellen zu können, ist dieser Leitfaden genau das Richtige für Sie. Heute erstellen wir ein Retrieval-Augmented Generation (RAG)-System mit DeepSeek R1, einem Open-Source-Leistungszentrum für das Reasoning, und Ollama, dem Lightweight-Framework für die Ausführung lokaler KI-Modelle.
Sind Sie bereit, Ihr API-Testing zu beschleunigen? Vergessen Sie nicht, Apidog auszuprobieren! Apidog fungiert als One-Stop-Plattform zum Erstellen, Verwalten und Ausführen von Tests und Mock-Servern, mit der Sie Engpässe identifizieren und Ihre APIs zuverlässig halten können.
Anstatt mit mehreren Tools zu jonglieren oder umfangreiche Skripte zu schreiben, können Sie kritische Teile Ihres Workflows automatisieren, reibungslose CI/CD-Pipelines erreichen und mehr Zeit damit verbringen, Ihre Produktfunktionen zu verfeinern.
Wenn sich das so anhört, als ob es Ihr Leben vereinfachen könnte, probieren Sie Apidog aus!
In diesem Beitrag werden wir untersuchen, wie DeepSeek R1 – ein Modell, das in Bezug auf die Leistung mit dem von OpenAI konkurriert, aber 95 % weniger kostet – Ihre RAG-Systeme beschleunigen kann. Lassen Sie uns aufschlüsseln, warum Entwickler zu dieser Technologie strömen und wie Sie Ihre eigene RAG-Pipeline damit erstellen können.
Wie viel kostet dieses lokale RAG-System?
| Komponente | Kosten |
|---|---|
| DeepSeek R1 1.5B | Kostenlos |
| Ollama | Kostenlos |
| 16GB RAM PC | $0 |
Das 1,5B-Modell von DeepSeek R1 glänzt hier, weil:
- Gezieltes Retrieval: Nur 3 Dokument-Chunks werden in jede Antwort eingespeist
- Strenge Aufforderung: „Ich weiß es nicht“ verhindert Halluzinationen
- Lokale Ausführung: Null Latenz im Vergleich zu Cloud-APIs
Was Sie benötigen
Bevor wir programmieren, richten wir unsere Toolkits ein:
1. Ollama
Mit Ollama können Sie Modelle wie DeepSeek R1 lokal ausführen.
- Download: https://ollama.com/
- Installieren Sie es, öffnen Sie dann Ihr Terminal und führen Sie Folgendes aus:
ollama run deepseek-r1 # Für das 7B-Modell (Standard)
2. DeepSeek R1 Modellvarianten
DeepSeek R1 gibt es in Größen von 1,5B bis 671B Parametern. Für diese Demo verwenden wir das 1,5B-Modell – perfekt für leichtgewichtige RAG:
ollama run deepseek-r1:1.5b
Profi-Tipp: Größere Modelle wie 70B bieten ein besseres Reasoning, benötigen aber mehr RAM. Fangen Sie klein an und skalieren Sie dann hoch!

Erstellen der RAG-Pipeline: Code-Walkthrough
Schritt 1: Bibliotheken importieren
Wir werden Folgendes verwenden:
import streamlit as st
from langchain_community.document_loaders import PDFPlumberLoader
from langchain_experimental.text_splitter import SemanticChunker
from langchain_community.embeddings import HuggingFaceEmbeddings
from langchain_community.vectorstores import FAISS
from langchain_community.llms import Ollama
Schritt 2: PDFs hochladen und verarbeiten
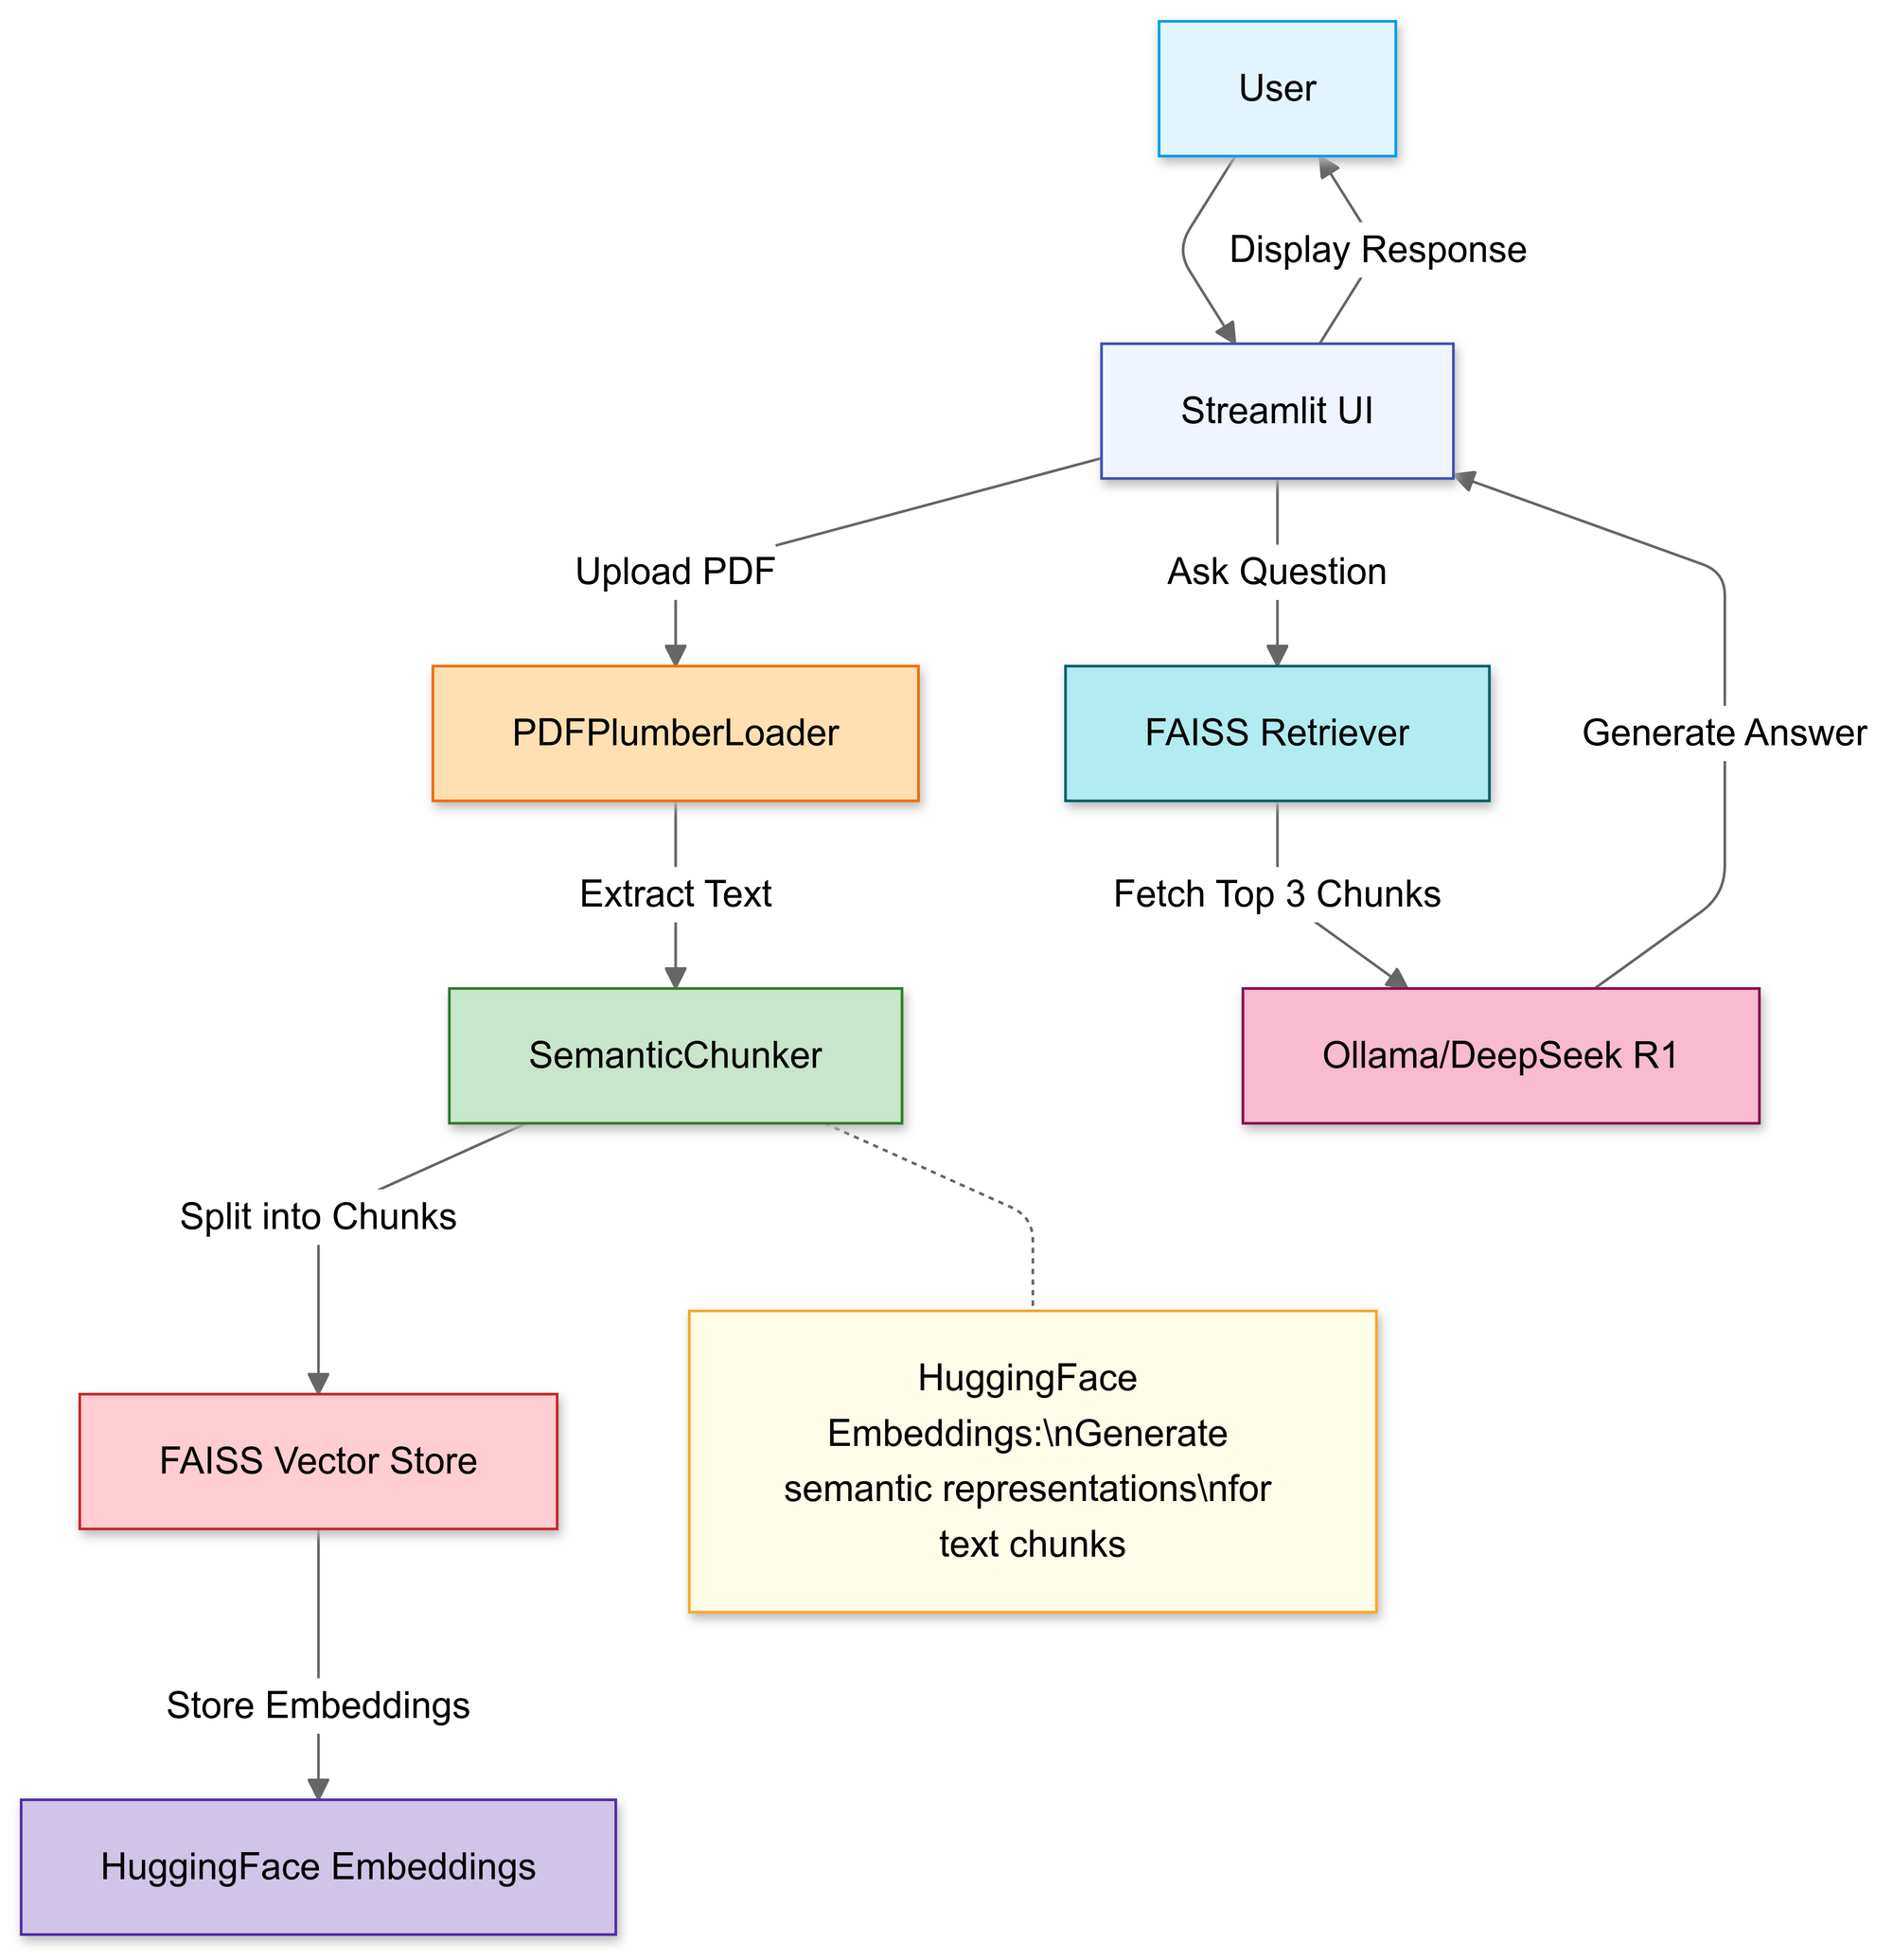
In diesem Abschnitt verwenden Sie den Datei-Uploader von Streamlit, damit Benutzer eine lokale PDF-Datei auswählen können.
# Streamlit file uploader
uploaded_file = st.file_uploader("Upload a PDF file", type="pdf")

if uploaded_file:
    # Save PDF temporarily
    with open("temp.pdf", "wb") as f:
        f.write(uploaded_file.getvalue())

    # Load PDF text
    loader = PDFPlumberLoader("temp.pdf")
    docs = loader.load()
Nach dem Hochladen extrahiert die Funktion PDFPlumberLoader Text aus der PDF-Datei und bereitet ihn für die nächste Phase der Pipeline vor. Dieser Ansatz ist praktisch, da er sich um das Lesen des Dateiinhaltes kümmert, ohne eine umfangreiche manuelle Analyse zu erfordern.
Schritt 3: Dokumente strategisch aufteilen
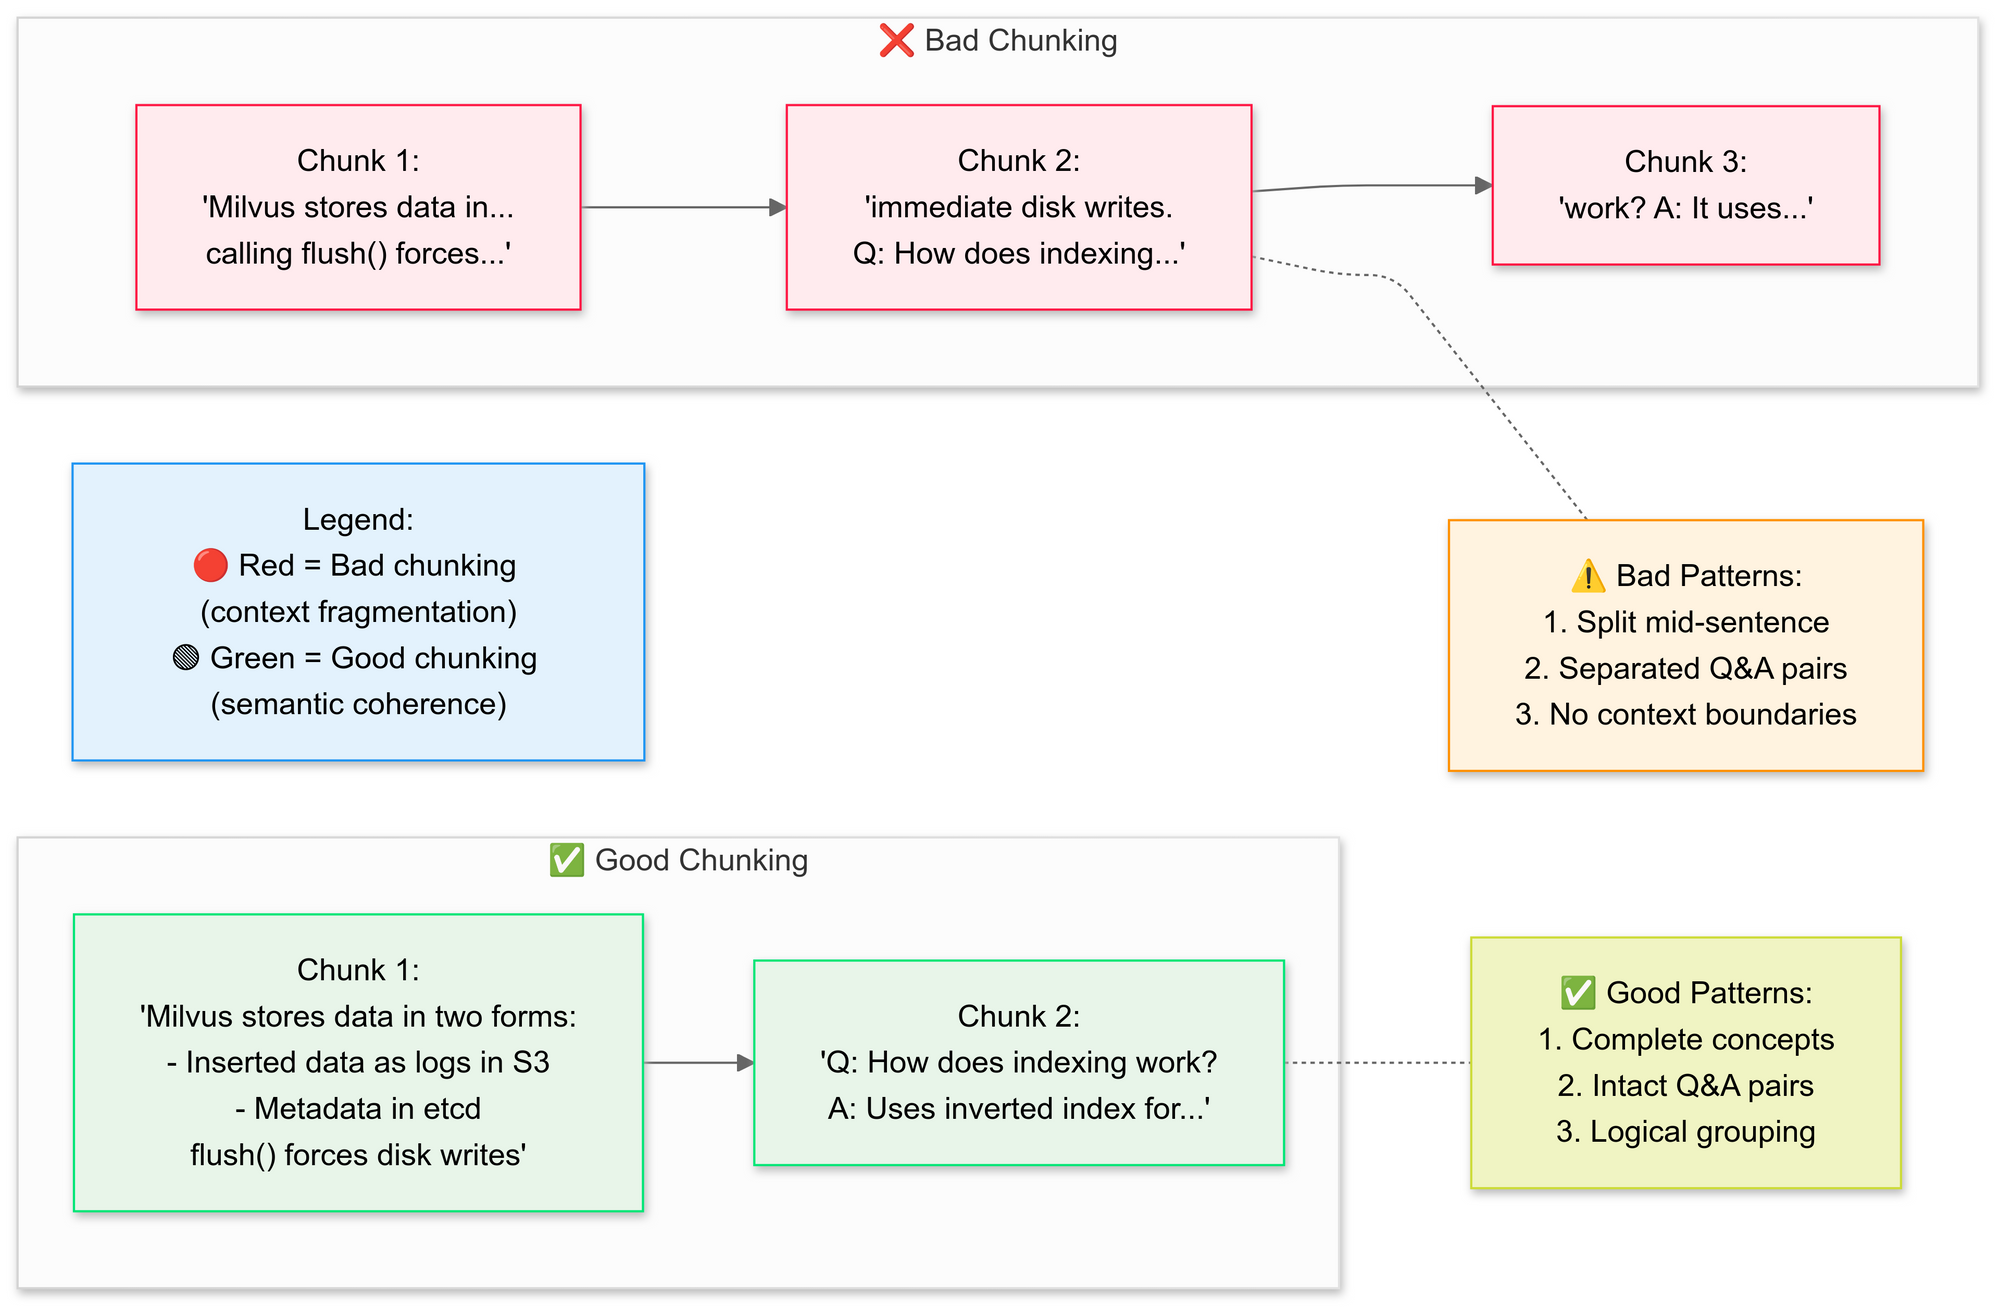
Wir möchten den RecursiveCharacterTextSplitter verwenden, der Code unterteilt den ursprünglichen PDF-Text in kleinere Segmente (Chunks). Erläutern wir hier die Konzepte von gutem Chunking vs. schlechtem Chunking:
Warum semantisches Chunking?
- Gruppiert zusammenhängende Sätze (z. B. „Wie Milvus Daten speichert“ bleibt intakt)
- Vermeidet das Aufteilen von Tabellen oder Diagrammen
# Split text into semantic chunks
text_splitter = SemanticChunker(HuggingFaceEmbeddings())
documents = text_splitter.split_documents(docs)
Dieser Schritt bewahrt den Kontext, indem sich Segmente leicht überlappen, was dem Sprachmodell hilft, Fragen genauer zu beantworten. Kleine, gut definierte Dokument-Chunks machen auch die Suche effizienter und relevanter.
Schritt 4: Erstellen einer durchsuchbaren Wissensdatenbank
Nach der Aufteilung generiert die Pipeline Vektoreinbettungen für die Segmente und speichert sie in einem FAISS-Index.
# Generate embeddings
embeddings = HuggingFaceEmbeddings()
vector_store = FAISS.from_documents(documents, embeddings)

# Connect retriever
retriever = vector_store.as_retriever(search_kwargs={"k": 3})  # Fetch top 3 chunks
Dies wandelt Text in eine numerische Darstellung um, die viel einfacher abzufragen ist. Abfragen werden später gegen diesen Index ausgeführt, um die kontextuell relevantesten Chunks zu finden.
Schritt 5: DeepSeek R1 konfigurieren
Hier instanziieren Sie eine RetrievalQA-Kette mit Deepseek R1 1.5B als lokalem LLM.
llm = Ollama(model="deepseek-r1:1.5b")  # Our 1.5B parameter model

# Craft the prompt template
prompt = """
1. Use ONLY the context below.
2. If unsure, say "I don’t know".
3. Keep answers under 4 sentences.

Context: {context}

Question: {question}

Answer:
"""
QA_CHAIN_PROMPT = PromptTemplate.from_template(prompt)
Diese Vorlage zwingt das Modell, Antworten im Inhalt Ihrer PDF-Datei zu verankern. Durch das Umschließen des Sprachmodells mit einem Retriever, der an den FAISS-Index gebunden ist, suchen alle Abfragen, die über die Kette gestellt werden, nach Kontext aus dem Inhalt der PDF-Datei, wodurch die Antworten im Quellmaterial verankert werden.
Schritt 6: Die RAG-Kette zusammenstellen
Als Nächstes können Sie die Schritte zum Hochladen, Aufteilen und Abrufen in einer zusammenhängenden Pipeline zusammenführen.
# Chain 1: Generate answers
llm_chain = LLMChain(llm=llm, prompt=QA_CHAIN_PROMPT)

# Chain 2: Combine document chunks
document_prompt = PromptTemplate(
    template="Context:\ncontent:{page_content}\nsource:{source}",
    input_variables=["page_content", "source"]
)

# Final RAG pipeline
qa = RetrievalQA(
    combine_documents_chain=StuffDocumentsChain(
        llm_chain=llm_chain,
        document_prompt=document_prompt
    ),
    retriever=retriever
)
Dies ist der Kern des RAG-Designs (Retrieval-Augmented Generation), das dem großen Sprachmodell einen verifizierten Kontext liefert, anstatt sich ausschließlich auf seine interne Schulung zu verlassen.
Schritt 7: Die Weboberfläche starten
Schließlich verwendet der Code die Texteingabe- und Schreibfunktionen von Streamlit, sodass Benutzer Fragen eingeben und Antworten sofort anzeigen können.
# Streamlit UI
user_input = st.text_input("Ask your PDF a question:")

if user_input:
    with st.spinner("Thinking..."):
        response = qa(user_input)["result"]
        st.write(response)
Sobald der Benutzer eine Abfrage eingibt, ruft die Kette die am besten passenden Chunks ab, speist sie in das Sprachmodell ein und zeigt eine Antwort an. Wenn die Langchain-Bibliothek ordnungsgemäß installiert ist, sollte der Code jetzt funktionieren, ohne den Fehler „Fehlendes Modul“ auszulösen.
Stellen Sie Fragen und reichen Sie sie ein und erhalten Sie sofort Antworten!
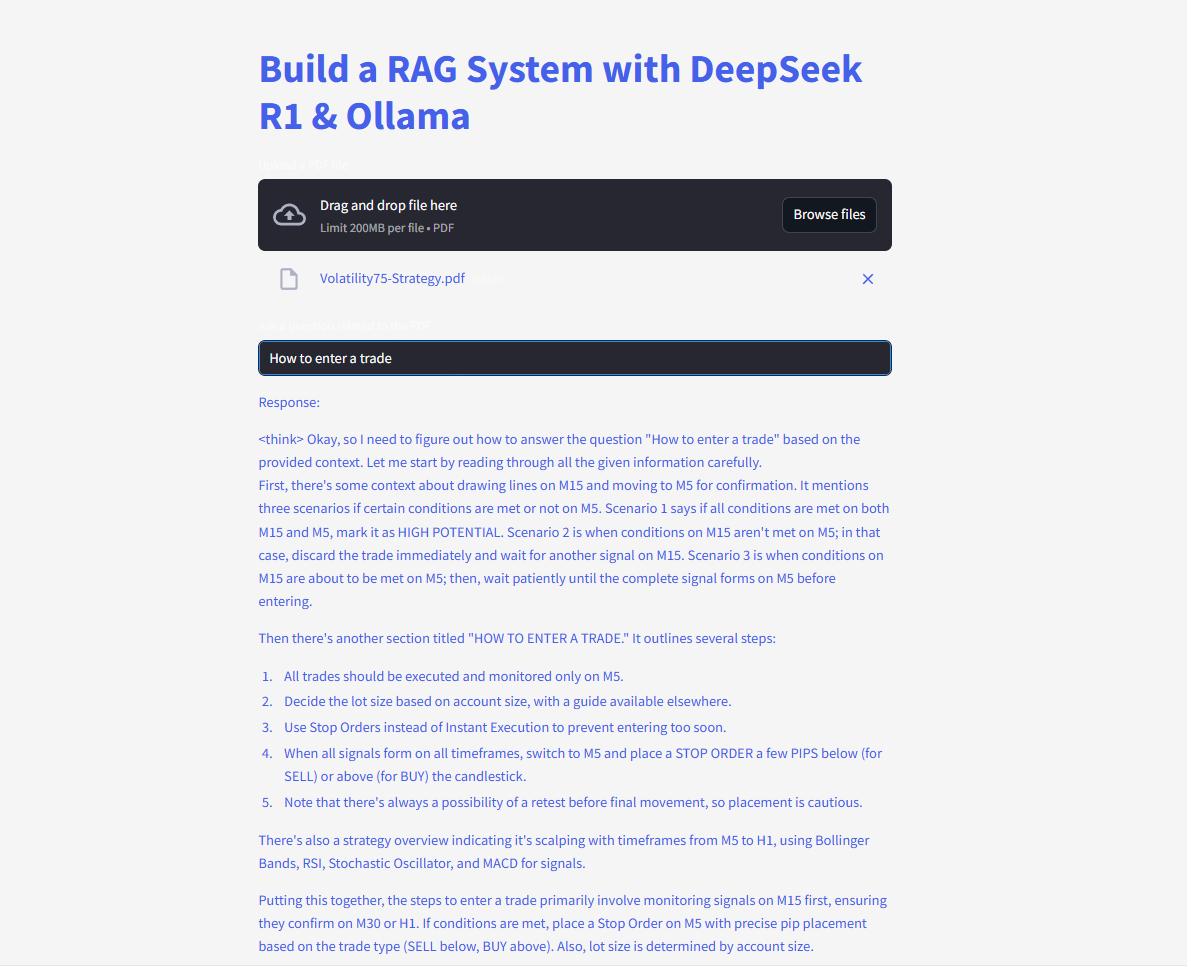
Hier ist der vollständige Code:
Die Zukunft von RAG mit DeepSeek
Mit Funktionen wie Selbstverifizierung und Multi-Hop-Reasoning in der Entwicklung ist DeepSeek R1 in der Lage, noch fortschrittlichere RAG-Anwendungen freizuschalten. Stellen Sie sich eine KI vor, die nicht nur Fragen beantwortet, sondern auch ihre eigene Logik debattiert – autonom.