Das Qwen-Team von Alibaba Cloud hat zwei leistungsstarke Ergänzungen zu seiner Produktpalette großer Sprachmodelle (LLM) veröffentlicht: Qwen3-4B-Instruct-2507 und Qwen3-4B-Thinking-2507. Diese Modelle bieten erhebliche Fortschritte in den Bereichen Argumentation, Befolgung von Anweisungen und Verständnis langer Kontexte, mit nativer Unterstützung für eine Kontextlänge von 256K Token. Entwickelt für Entwickler, Forscher und KI-Enthusiasten bieten diese Modelle robuste Fähigkeiten für Aufgaben, die vom Programmieren bis zur komplexen Problemlösung reichen. Darüber hinaus können Tools wie **Apidog**, eine kostenlose API-Management-Plattform, das Testen und die Integration dieser Modelle in Ihre Anwendungen optimieren.
Die Qwen3-4B-Modelle verstehen
Die Qwen3-Serie stellt die neueste Entwicklung in der Familie der großen Sprachmodelle von Alibaba Cloud dar und folgt auf die Qwen2.5-Serie. Insbesondere sind Qwen3-4B-Instruct-2507 und Qwen3-4B-Thinking-2507 auf unterschiedliche Anwendungsfälle zugeschnitten: Ersteres zeichnet sich durch allgemeine Dialoge und die Befolgung von Anweisungen aus, während Letzteres für komplexe Denkaufgaben optimiert ist. Beide Modelle unterstützen eine native Kontextlänge von 262.144 Token, wodurch sie umfangreiche Datensätze, lange Dokumente oder mehrstufige Konversationen problemlos verarbeiten können. Darüber hinaus macht ihre Kompatibilität mit Frameworks wie Hugging Face Transformers und Bereitstellungstools wie **Apidog** sie sowohl für lokale als auch für cloudbasierte Anwendungen zugänglich.
Qwen3-4B-Instruct-2507: Für Effizienz optimiert
Das Qwen3-4B-Instruct-2507-Modell arbeitet im Nicht-Denkmodus und konzentriert sich auf effiziente, qualitativ hochwertige Antworten für allgemeine Aufgaben. Dieses Modell wurde feinabgestimmt, um die Befolgung von Anweisungen, logisches Denken, Textverständnis und mehrsprachige Fähigkeiten zu verbessern. Insbesondere generiert es keine <think></think>-Blöcke, was es ideal für Szenarien macht, in denen schnelle, direkte Antworten gegenüber schrittweiser Argumentation bevorzugt werden.
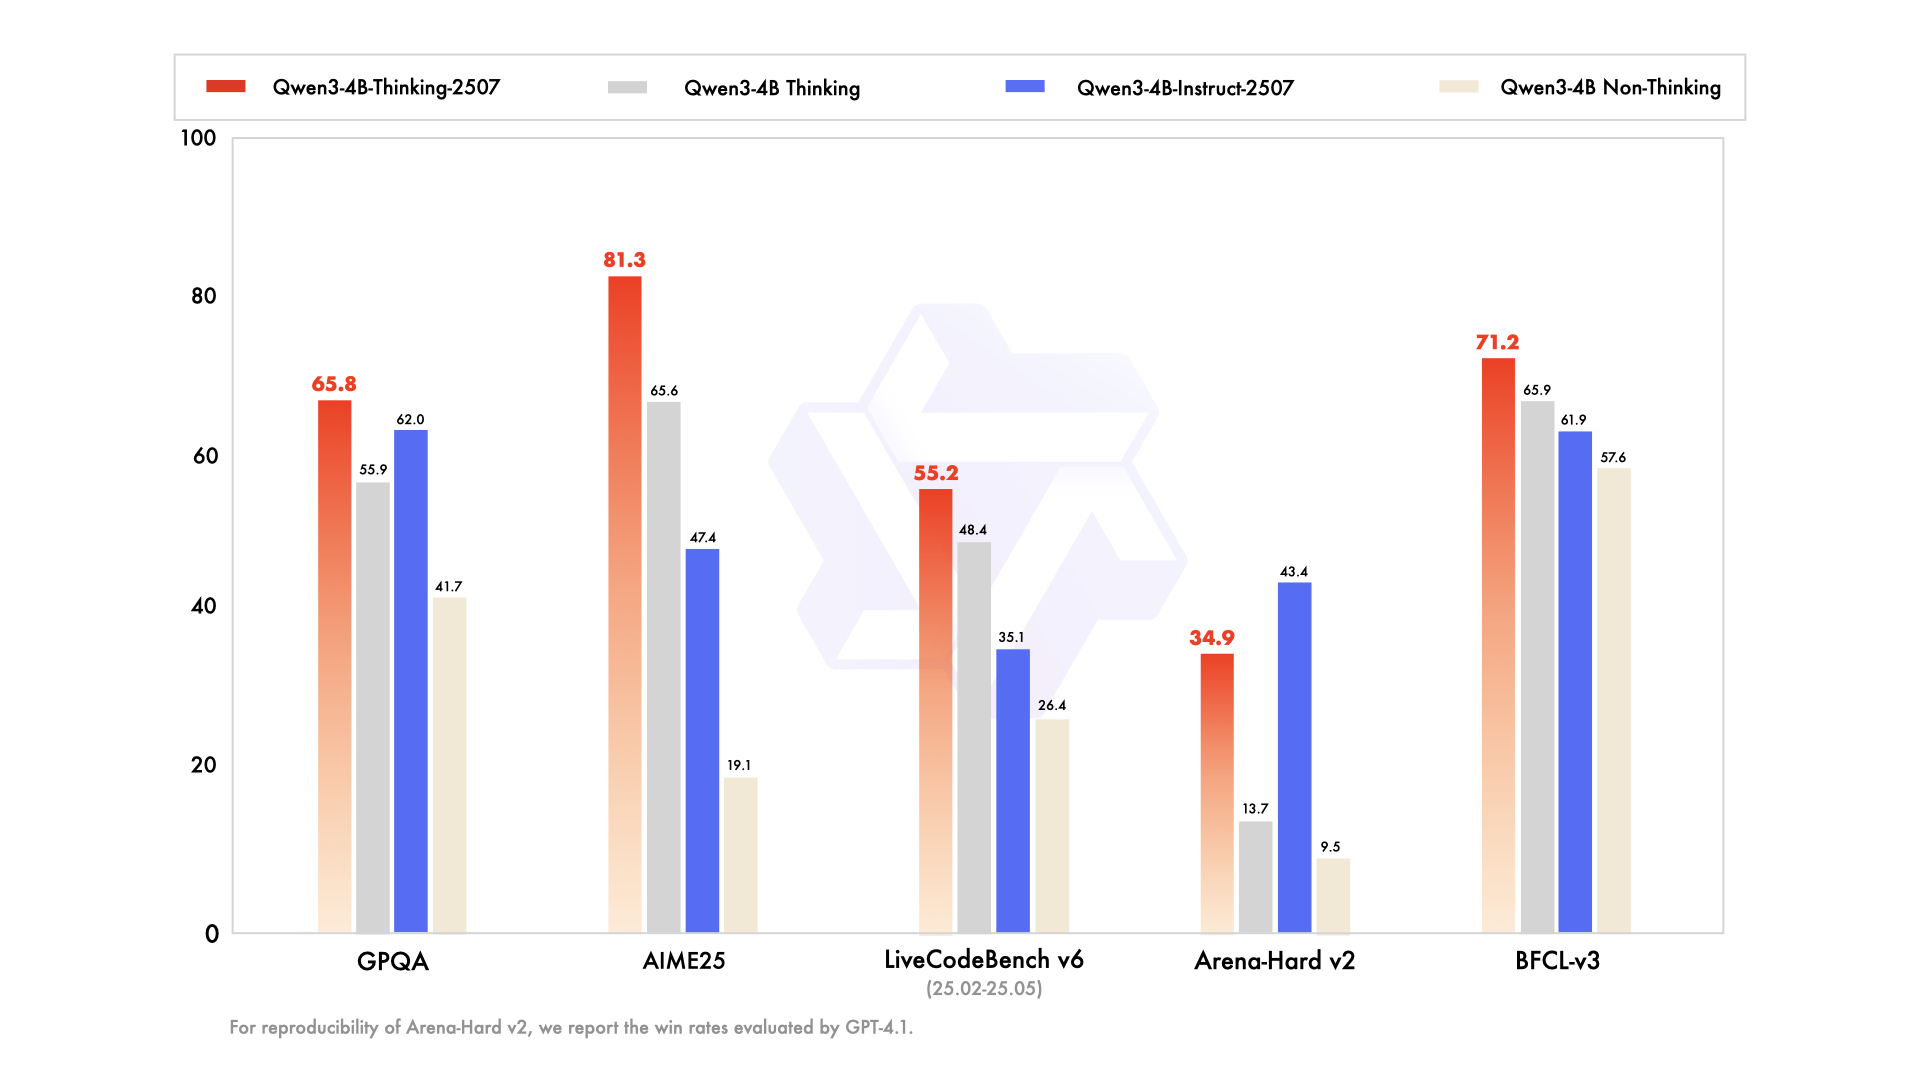
Wichtige Verbesserungen umfassen:
- Verbesserte allgemeine Fähigkeiten: Das Modell zeigt eine überlegene Leistung in Mathematik, Naturwissenschaften, Programmierung und Werkzeugnutzung, wodurch es vielseitig für technische Anwendungen einsetzbar ist.
- Mehrsprachige Unterstützung: Es deckt über 100 Sprachen und Dialekte ab und gewährleistet eine robuste Leistung in globalen Anwendungen.
- Verständnis langer Kontexte: Mit einer Kontextlänge von 256K Token verarbeitet es erweiterte Eingaben, wie z.B. juristische Dokumente oder umfangreiche Codebasen, ohne Kürzung.
- Anpassung an Benutzerpräferenzen: Das Modell liefert natürlichere und ansprechendere Antworten und zeichnet sich durch kreatives Schreiben und mehrstufige Dialoge aus.
Für Entwickler, die dieses Modell in APIs integrieren, bietet **Apidog** eine benutzerfreundliche Oberfläche zum Testen und Verwalten von API-Endpunkten, um eine nahtlose Bereitstellung zu gewährleisten. Diese Effizienz macht Qwen3-4B-Instruct-2507 zur bevorzugten Wahl für Anwendungen, die schnelle, genaue Antworten erfordern.
Qwen3-4B-Thinking-2507: Für tiefgreifendes Denken entwickelt
Im Gegensatz dazu ist Qwen3-4B-Thinking-2507 für Aufgaben konzipiert, die intensives Denken erfordern, wie z.B. logische Problemlösung, Mathematik und akademische Benchmarks. Dieses Modell arbeitet ausschließlich im Denkmodus und integriert automatisch Chain-of-Thought (CoT)-Prozesse, um komplexe Probleme aufzuschlüsseln. Seine Ausgabe kann einen schließenden </think>-Tag ohne einen öffnenden <think>-Tag enthalten, da die Standard-Chat-Vorlage Denkverhalten einbettet.
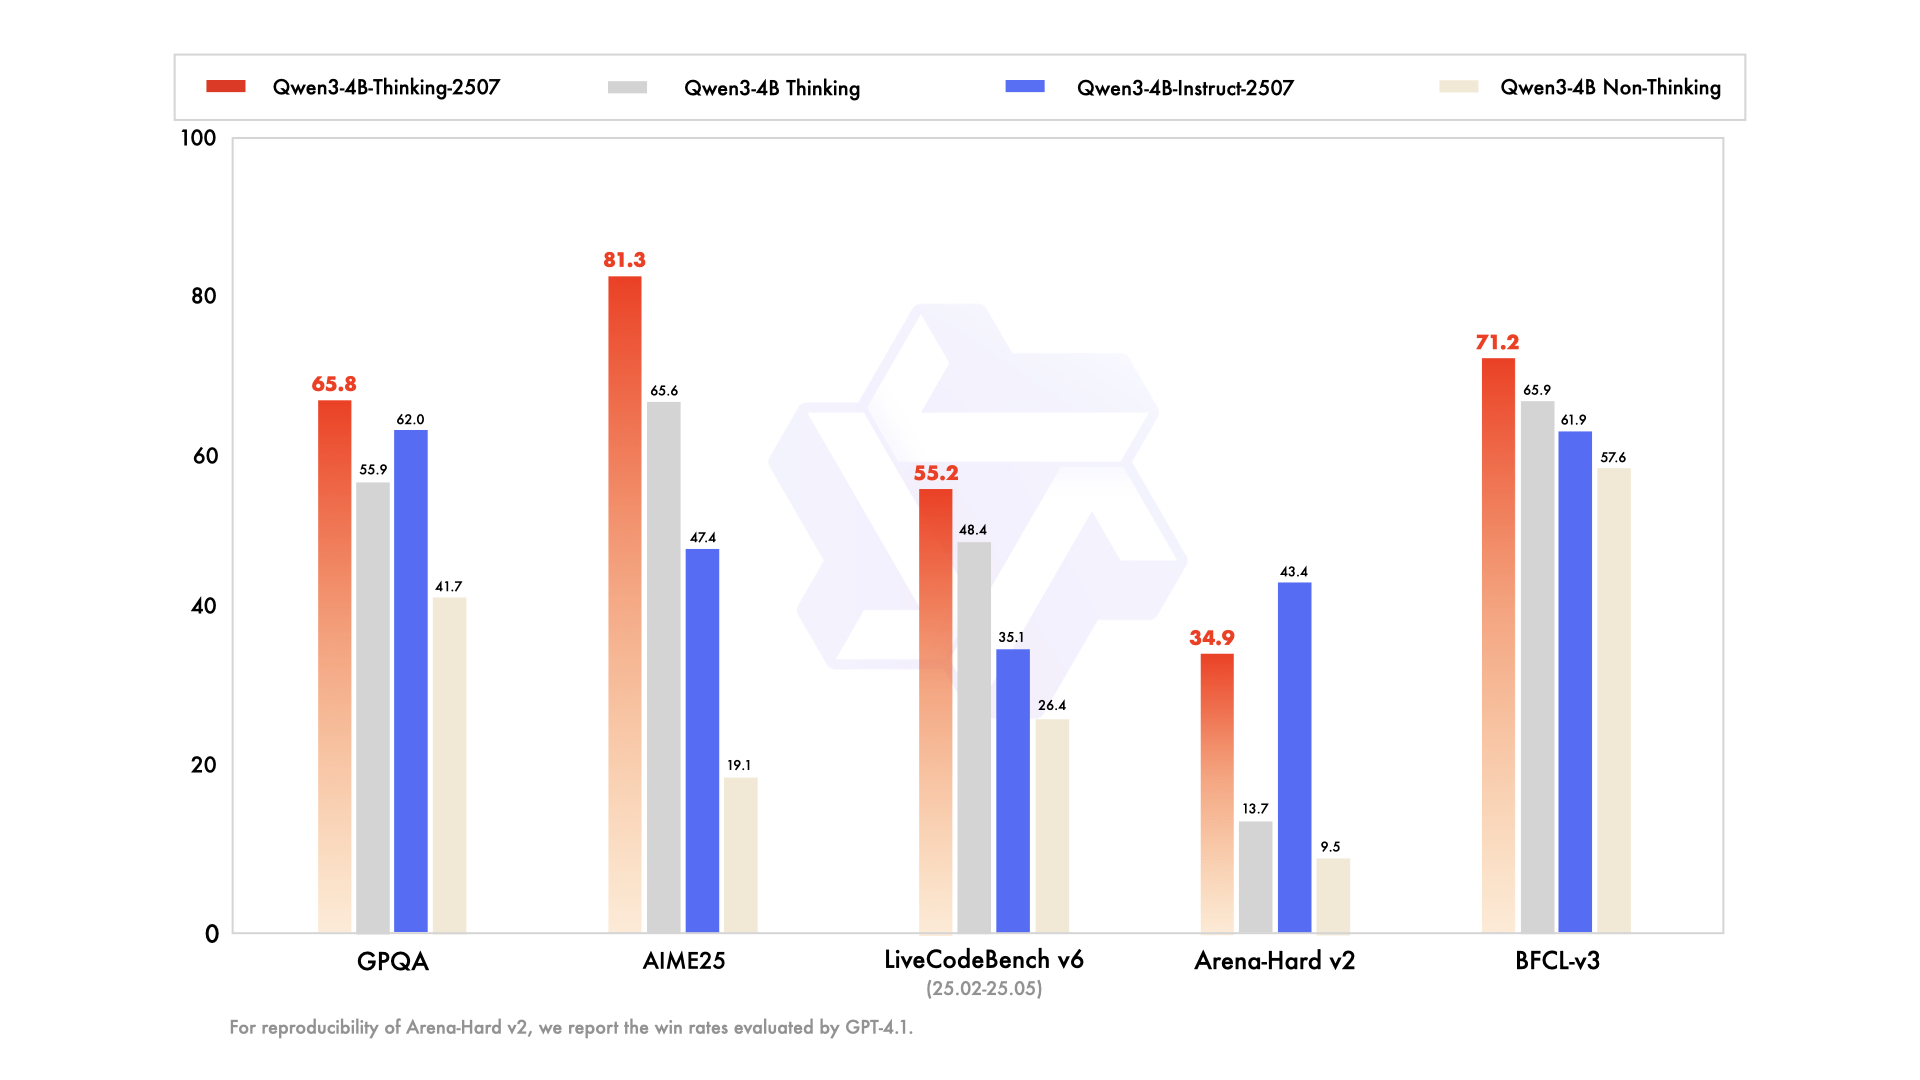
Wichtige Verbesserungen umfassen:
- Fortschrittliche Denkfähigkeiten: Das Modell erzielt unter Open-Source-Denkmodellen, insbesondere in den MINT-Fächern und der Programmierung, modernste Ergebnisse.
- Erhöhte Denktiefe: Es zeichnet sich durch Aufgaben aus, die ein Denken auf menschlichem Expertenniveau erfordern, mit einer erweiterten Denklänge für eine gründliche Analyse.
- 256K Kontextlänge: Wie sein Instruct-Gegenstück unterstützt es massive Kontextfenster, ideal für die Verarbeitung großer Datensätze oder komplexer Abfragen.
- Tool-Integration: Das Modell nutzt Tools wie Qwen-Agent für optimierte Agenten-Workflows, wodurch seine Nützlichkeit in automatisierten Systemen verbessert wird.
Für Entwickler, die mit denkintensiven Anwendungen arbeiten, kann **Apidog** API-Tests erleichtern und sicherstellen, dass die Ausgaben des Modells mit den erwarteten Ergebnissen übereinstimmen. Dieses Modell eignet sich besonders für Forschungsumgebungen und komplexe Problemlösungsszenarien.
Technische Spezifikationen und Architektur
Beide Qwen3-4B-Modelle gehören zur Qwen3-Familie, die dichte und Mixture-of-Experts (MoE)-Architekturen umfasst. Die 4B-Bezeichnung bezieht sich auf ihre 4 Milliarden Parameter, die ein Gleichgewicht zwischen Recheneffizienz und Leistung herstellen. Folglich sind diese Modelle auf Consumer-Hardware zugänglich, im Gegensatz zu größeren Modellen wie Qwen3-235B-A22B, die erhebliche Ressourcen erfordern.
Architektur-Highlights
- Dichtes Modelldesign: Im Gegensatz zu MoE-Modellen verwenden Qwen3-4B-Modelle eine dichte Architektur, die eine konsistente Leistung über alle Aufgaben hinweg gewährleistet, ohne dass eine selektive Parameteraktivierung erforderlich ist.
- YaRN zur Kontext-Erweiterung: Die Modelle nutzen YaRN, um ihre Kontextlänge von 32.768 auf 262.144 Token zu erweitern, was eine Verarbeitung langer Kontexte ohne signifikante Leistungseinbußen ermöglicht.
- Trainingspipeline: Das Qwen-Team verwendete einen vierstufigen Trainingsprozess, der einen langen Chain-of-Thought-Kaltstart, ein reasoning-basiertes Reinforcement Learning, eine Thinking-Modus-Fusion und ein allgemeines Reinforcement Learning umfasste. Dieser Ansatz verbessert sowohl die Denk- als auch die Dialogfähigkeiten.
- Quantisierungsunterstützung: Beide Modelle unterstützen die FP8-Quantisierung, wodurch der Speicherbedarf reduziert und gleichzeitig die Genauigkeit erhalten bleibt. Zum Beispiel ist Qwen3-4B-Thinking-2507-FP8 für ressourcenbeschränkte Umgebungen verfügbar.
Hardware-Anforderungen
Um diese Modelle effizient auszuführen, beachten Sie Folgendes:
- GPU-Speicher: Für FP8-quantisierte Modelle werden mindestens 8 GB VRAM empfohlen, während bfloat16-Modelle 16 GB oder mehr erfordern können.
- RAM: Für eine optimale Leistung sind 16 GB vereinheitlichter Speicher (VRAM + RAM) für die meisten Aufgaben ausreichend.
- Inferenz-Frameworks: Beide Modelle sind kompatibel mit Hugging Face Transformers (Version ≥4.51.0), vLLM (≥0.8.5) und SGLang (≥0.4.6.post1). Lokale Tools wie Ollama und LMStudio unterstützen ebenfalls Qwen3.
Für Entwickler, die diese Modelle bereitstellen, vereinfacht **Apidog** den Prozess, indem es Tools zur Überwachung und zum Testen der API-Leistung bereitstellt und so eine effiziente Integration mit Inferenz-Frameworks gewährleistet.
Integration mit Hugging Face und ModelScope
Die Qwen3-4B-Modelle sind sowohl auf Hugging Face als auch auf ModelScope verfügbar und bieten Entwicklern Flexibilität. Nachfolgend finden Sie einen Code-Snippet, der zeigt, wie Qwen3-4B-Instruct-2507 mit Hugging Face Transformers verwendet wird.

from transformers import AutoModelForCausalLM, AutoTokenizer
model_name = "Qwen/Qwen3-4B-Instruct-2507"tokenizer = AutoTokenizer.from_pretrained(model_name)model = AutoModelForCausalLM.from_pretrained(model_name, torch_dtype="auto", device_map="auto")
prompt = "Write a Python function to calculate Fibonacci numbers."messages = [{"role": "user", "content": prompt}]text = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)model_inputs = tokenizer([text], return_tensors="pt").to(model.device)
generated_ids = model.generate(**model_inputs, max_new_tokens=16384)output_ids = generated_ids[0][len(model_inputs.input_ids[0]):].tolist()content = tokenizer.decode(output_ids, skip_special_tokens=True)print("Generated Code:\n", content)
Für Qwen3-4B-Thinking-2507 ist eine zusätzliche Analyse erforderlich, um Denk-Inhalte zu verarbeiten:
from transformers import AutoModelForCausalLM, AutoTokenizer
model_name = "Qwen/Qwen3-4B-Thinking-2507"tokenizer = AutoTokenizer.from_pretrained(model_name)model = AutoModelForCausalLM.from_pretrained(model_name, torch_dtype="auto", device_map="auto")
prompt = "Solve the equation 2x^2 + 3x - 5 = 0."messages = [{"role": "user", "content": prompt}]text = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)model_inputs = tokenizer([text], return_tensors="pt").to(model.device)
generated_ids = model.generate(**model_inputs, max_new_tokens=32768)output_ids = generated_ids[0][len(model_inputs.input_ids[0]):].tolist()
try:index = len(output_ids) - output_ids[::-1].index(151668)  #  tokenexcept ValueError:index = 0thinking_content = tokenizer.decode(output_ids[:index], skip_special_tokens=True).strip("\n")content = tokenizer.decode(output_ids[index:], skip_special_tokens=True).strip("\n")print("Thinking Process:\n", thinking_content)print("Solution:\n", content)
Diese Snippets zeigen die einfache Integration von Qwen-Modellen in Python-Workflows. Für API-basierte Bereitstellungen kann **Apidog** beim Testen dieser Endpunkte helfen und so eine zuverlässige Leistung gewährleisten.
Leistungsoptimierung und Best Practices
Um die Leistung der Qwen3-4B-Modelle zu maximieren, beachten Sie die folgenden Empfehlungen:
- Sampling-Parameter: Für Qwen3-4B-Instruct-2507 verwenden Sie
temperature=0.7,top_p=0.8,top_k=20undmin_p=0. Für Qwen3-4B-Thinking-2507 verwenden Sietemperature=0.6,top_p=0.95,top_k=20undmin_p=0. Vermeiden Sie gieriges Decodieren, um eine Leistungsverschlechterung zu verhindern. - Kontextlängenverwaltung: Wenn Speicherprobleme auftreten, reduzieren Sie die Kontextlänge auf 32.768 Token. Für Denkaufgaben sollten Sie jedoch eine Kontextlänge von über 131.072 Token beibehalten.
- Presence Penalty: Setzen Sie
presence_penaltyzwischen 0 und 2, um Wiederholungen zu reduzieren, aber vermeiden Sie hohe Werte, um Sprachvermischung zu verhindern. - Inferenz-Frameworks: Verwenden Sie vLLM oder SGLang für Inferenz mit hohem Durchsatz und nutzen Sie **Apidog** zur Überwachung der API-Leistung.
Vergleich von Qwen3-4B-Instruct-2507 und Qwen3-4B-Thinking-2507
Obwohl beide Modelle die gleiche Architektur mit 4 Milliarden Parametern teilen, unterscheiden sich ihre Designphilosophien:
- Qwen3-4B-Instruct-2507: Priorisiert Geschwindigkeit und Effizienz, wodurch es sich für Chatbots, Kundensupport und allgemeine Anwendungen eignet.
- Qwen3-4B-Thinking-2507: Konzentriert sich auf tiefgreifendes Denken, ideal für akademische Forschung, komplexe Problemlösung und Aufgaben, die Chain-of-Thought-Prozesse erfordern.
Entwickler können mit den Prompts /think und /no_think zwischen den Modi wechseln, was Flexibilität je nach Aufgabenanforderungen ermöglicht. **Apidog** kann beim Testen dieser Moduswechsel in API-gesteuerten Anwendungen helfen.
Community- und Ökosystem-Unterstützung
Die Qwen3-4B-Modelle profitieren von einem robusten Ökosystem mit Unterstützung von Hugging Face, ModelScope und Tools wie Ollama, LMStudio und llama.cpp. Der Open-Source-Charakter dieser Modelle, lizenziert unter Apache 2.0, fördert Community-Beiträge und Fine-Tuning. Zum Beispiel bietet Unsloth Tools für 2x schnelleres Fine-Tuning mit 70% weniger VRAM, wodurch diese Modelle einem breiteren Publikum zugänglich gemacht werden.
Fazit
Die Modelle Qwen3-4B-Instruct-2507 und Qwen3-4B-Thinking-2507 stellen einen bedeutenden Sprung in der Qwen-Serie von Alibaba Cloud dar und bieten unübertroffene Fähigkeiten bei der Befolgung von Anweisungen, der Argumentation und der Verarbeitung langer Kontexte. Mit einer Kontextlänge von 256K Token, mehrsprachiger Unterstützung und Kompatibilität mit Tools wie **Apidog** ermöglichen diese Modelle Entwicklern den Aufbau intelligenter, skalierbarer Anwendungen. Egal, ob Sie Code generieren, Gleichungen lösen oder mehrsprachige Chatbots erstellen, diese Modelle liefern außergewöhnliche Leistung. Beginnen Sie noch heute, ihr Potenzial zu erkunden, und nutzen Sie **Apidog**, um Ihre API-Integrationen für ein nahtloses Entwicklungserlebnis zu optimieren.