
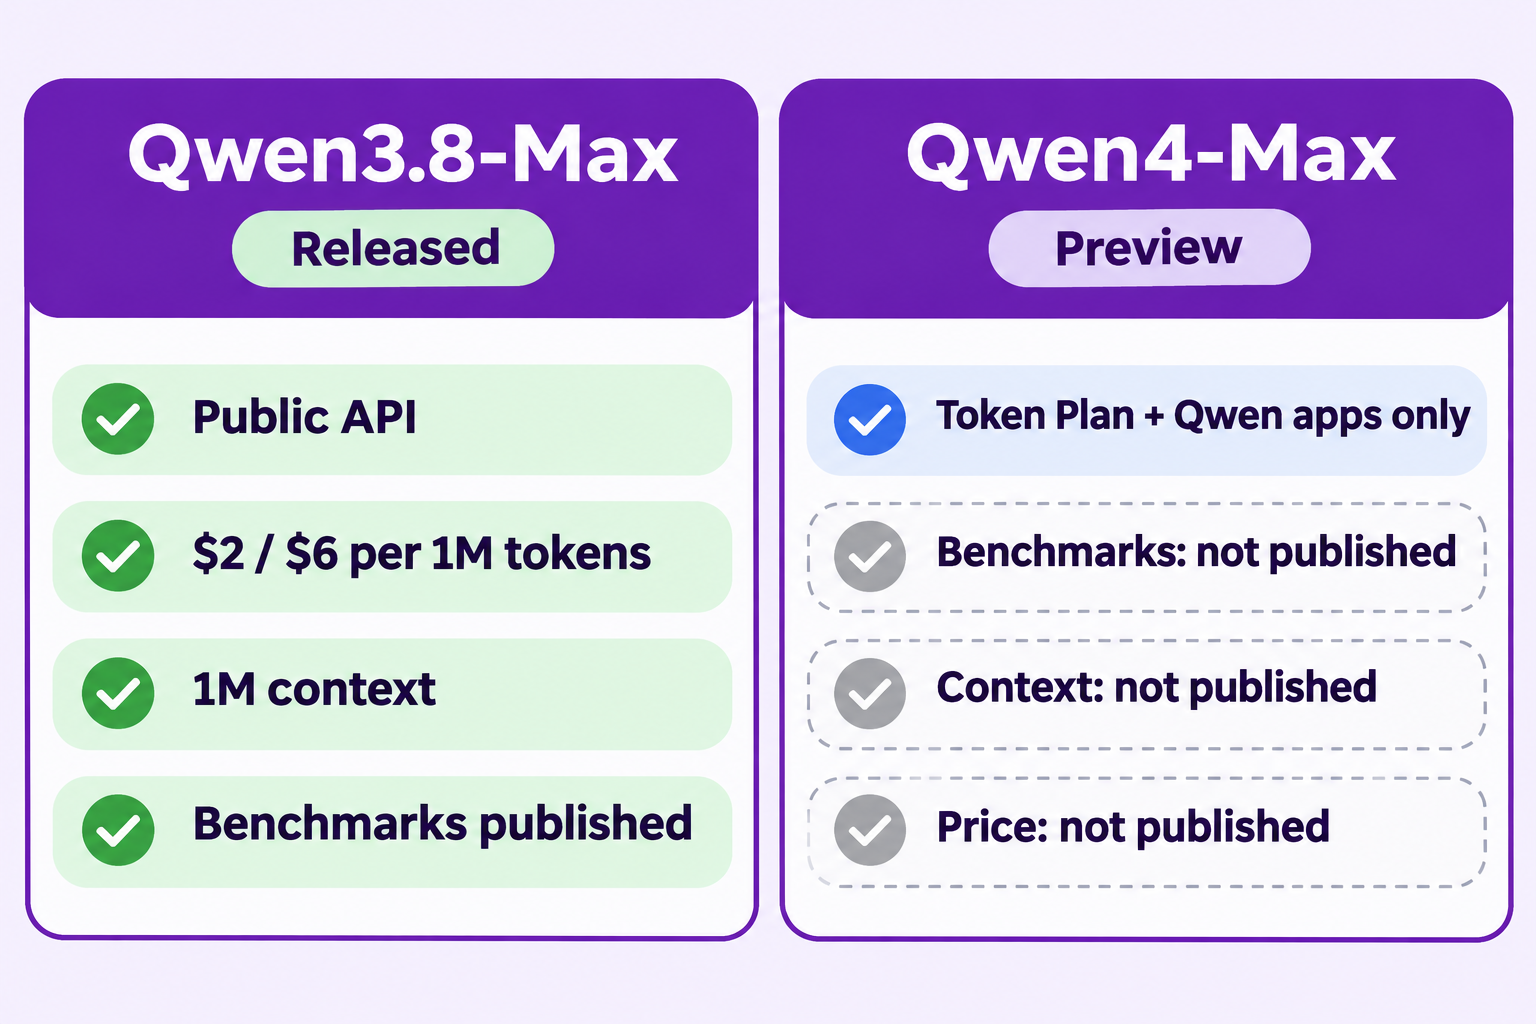
Bei Qwen4-Max vs. Qwen 3.8 läuft es im Kern so: Qwen4-Max ist eine Vorschau, die Sie nur über Alibabas Token Plan und dessen eigene Apps nutzen können – ohne veröffentlichte Benchmarks, Kontextlänge oder Token-Preise. Qwen3.8-Max ist ein veröffentlichtes Modell mit öffentlicher API zu $2/$6 pro Million Tokens, einem Kontext von 1M Tokens und einem Output-Limit von 131K. Für die Produktion nehmen Sie Qwen 3.8. Qwen4-Max testen Sie an Ihrer eigenen Arbeit.
Das ist der Stand vom 11. November 2026, dem Tag, an dem Alibabas Qwen-Team Qwen4-Max in die Vorschau gebracht hat. Im Folgenden: Was neu ist, was Sie überprüfen können, was noch nicht, und ein Praxistest. Neu bei einem der beiden Modelle? Beginnen Sie mit was Qwen4-Max ist und was Qwen 3.8 ist.
Qwen4-Max vs. Qwen 3.8 auf einen Blick
Jede Zeile stammt von Alibabas eigenen Seiten, geprüft am 11. November 2026.
| Qwen4-Max (Vorschau) | Qwen3.8-Max | |
|---|---|---|
| Status | Vorschau, angekündigt am 11. November 2026 | Veröffentlicht, allgemein verfügbar seit August 2026 |
| Modell-ID | qwen4-max-preview (Token Plan) |
qwen3.8-max |
| Pay-per-Token-API | Nicht veröffentlicht | Ja, OpenAI- und Anthropic-kompatibel |
| Preis pro Token | Nicht veröffentlicht | $2 Input / $6 Output pro 1M Tokens |
| Kontextfenster | Nicht veröffentlicht | 1M Tokens |
| Max. Output | Nicht veröffentlicht (Qwen Code Standard: 32.768) | 131K Tokens |
| Inputs | Text und Bilder (Token Plan Tags) | Text, Bilder und Video |
| Parameter | Nicht veröffentlicht | 2,4T gesamt, Mixture-of-Experts |
| Offizielle Benchmarks | Keine | Hersteller-Tabelle beim Launch veröffentlicht |
| Im Token Plan | Ja, „Limited-Time 80 % Off“ | Ja, „40 % Off Nights“ |
Quellen: die Qwen3.8-Max-Modellseite und die Token-Plan-Preisseite. Qwen4-Max hat noch keine Modellseite; die URL lieferte bei unserer Prüfung einen 404-Fehler.
Was Alibaba an Änderungen in Qwen4-Max nennt
Die Ankündigung auf X beginnt mit „Qwen4 is coming“ und listet vier Verbesserungen auf. Das sind Behauptungen des Qwen-Teams, keine gemessenen Ergebnisse:
- Tieferes Wissen. Bessere Antworten zu Fachthemen.
- Reicheres Weltwissen. Besseres Reasoning über reale Kontexte.
- Stärkere Coding- und Agenten-Fähigkeiten. Besseres Planen, Tool-Nutzen und mehrstufiges Arbeiten.
- Gebaut für reale Aufgaben. Der Beitrag nennt „komplexes Coding und Wissensarbeit“, „Frontend-Bauten“ und „professionelle Software-Workflows“.
Beachten Sie, wie nah das an Qwen 3.8s eigenem Versprechen liegt. Die Qwen3.8-Max-Modellseite beschreibt bereits „einen umfassenden Sprung in Coding und professioneller Arbeit“ und autonome Projekte „über mehr als 10 Tage“. Die Richtung hat sich nicht geändert; Qwen4-Max behauptet, denselben Weg weiter zu gehen. Der Beitrag endet mit „Put it to the test on a real problem“ – was fair ist, denn ein Datenblatt existiert noch nicht.
Was Sie heute tatsächlich vergleichen können
Fünf Unterschiede sind heute überprüfbar.
1. Release-Stadium. Qwen3.8-Max ist ein veröffentlichtes Modell mit dokumentierten Rate Limits (2.000.000 Tokens pro Minute auf der Modellseite). Qwen4-Max ist eine Vorschau. Sein Verhalten, seine Limits oder seine ID können sich vor dem allgemeinen Release noch ändern.
2. Wie Sie es aufrufen. Qwen 3.8 läuft auf Qwen Clouds Standard-Pay-as-you-go-API, sodass Sie es hinter ein Produktions-Backend stellen können. Qwen4-Max läuft nur über Token-Plan-Endpunkte und Alibabas Apps. Die Token-Plan-FAQ sagt, der Individual-Plan sei für „persönliche interaktive Entwicklung über dafür vorgesehene Tools“ und verbietet Produktionsautomatisierung, Batch-Skripte und Hintergrund-Tasks.
3. Output-Länge in der Praxis. Qwen3.8-Max listet einen max. Output von 131K. Bei Qwen4-Max ist die einzige dokumentierte Zahl ein Client-Standard: Die Qwen-Code-Einrichtungsanleitung sagt, dass qwen4-max-preview standardmäßig ein Output-Limit von 32.768 Tokens hat, das Sie mit generationConfig.samplingParams.max_tokens erhöhen können. Das ist eine Tool-Einstellung, keine Modell-Obergrenze.
4. Input-Typen. Der Token Plan taggt Qwen4-Max mit Text Generation, Reasoning Model und Visual Understanding. Die Qwen3.8-Max-Modellseite listet Text-, Bild- und Video-Input.
5. API-Features. Qwen3.8-Max dokumentiert Function Calling, strukturierte Outputs, Context Caching, Batch-Dateien und Fine-Tuning. Davon ist für Qwen4-Max noch nichts dokumentiert.
Was Sie noch nicht vergleichen können
Vier Vergleiche, die man sich wünscht, sind am 11. November 2026 nicht möglich.
- Benchmarks. Alibaba hat keine Qwen4-Max-Scores veröffentlicht. Für Qwen 3.8s Herstellerzahlen siehe unseren Qwen-3.8-Benchmarks-Durchblick.
- Kontextfenster. Manche Berichte sagen, Qwen4-Max habe einen 1M-Token-Kontext. Alibabas eigene Seiten nicht, und Kie.ais Deep Dive weist darauf hin, dass die 1M-Zahl zu Qwen3.8-Max gehört.
- Preis pro Token. Es gibt keine Pay-as-you-go-Listung, also steht nichts neben Qwen 3.8s $2/$6. Der Token Plan sagt nicht, wie viele Credits eine Qwen4-Max-Anfrage kostet.
- Größe und Architektur. Alibaba hat keine Parameterzahl für Qwen4-Max veröffentlicht. Qwen3.8-Max ist ein Mixture-of-Experts-Modell mit 2,4T Parametern.
Betrachten Sie jeden Artikel, der diese Felder füllt, als Spekulation. Details zum Zugriff siehe wie man Qwen4-Max benutzt.
Zugang und Preise: Qwen4-Max vs. Qwen 3.8
Der Token Plan ist der einzige Plan, der beide Modelle führt. Am 11. November 2026 zeigte seine Singapur-Region-Seite diese monatlichen Individual-Preise in US-Dollar:
| Plan | Event-Preis | Listenpreis | Credits pro Monat | Parallele Agenten |
|---|---|---|---|---|
| Lite | $3,00 | $8,00 | 20.000 | 1-2 |
| Essential | $5,00 | $16,00 | 45.000 | 2-3 |
| Standard | $18,00 | $25,00 | 80.000 | 3-4 |
| Pro | $43,00 | $51,00 | 200.000 | 6-8 |
Der Event-Preis gilt für Neukunden, und die Seite sagt, der endgültige Preis sei der, den der Checkout nach dem Login zeigt. Beide Modelle greifen auf denselben Credit-Pool zu. qwen4-max-preview trägt den Tag „Limited-Time 80 % Off“, qwen3.8-max „40 % Off Nights“.
Qwen 3.8 hat eine vollständige Pay-as-you-go-Preisliste: $2 Input, $6 Output, $0,25 für implizite Cache-Treffer und $1 / $3 für Batch-Dateien, jeweils pro Million Tokens. Für die komplette Qwen-3.8-Kostenrechnung lesen Sie unseren Qwen-3.8-API-Guide.
Für ein Backend, das ein Modell aufruft, ist Qwen 3.8 die einzige Option der beiden. Wenn Sie mit einem Agenten coden, lässt der Token Plan Sie beide mit einem Abo testen.
Führen Sie Ihren eigenen Qwen4-Max-vs.-Qwen-3.8-Test durch
Ohne offiziellen Benchmark ist Ihr eigener Test die beste Beweisgrundlage. API-Arbeit eignet sich gut, denn ein Endpunkt besteht seine Tests – oder eben nicht.
Die Beispiel-Konfiguration des Qwen-Code-Guides listet beide Modelle bereits auf demselben Token-Plan-Endpunkt, sodass der Wechsel nur eine Menüauswahl ist:
{
  "$version": 4,
  "env": { "QWENCLOUD_TOKEN_PLAN_API_KEY": "YOUR_API_KEY" },
  "modelProviders": {
    "openai": [
      { "id": "qwen4-max-preview", "baseUrl": "https://token-plan.maas.qwencloudapi.com/compatible-mode/v1", "envKey": "QWENCLOUD_TOKEN_PLAN_API_KEY" },
      { "id": "qwen3.8-max", "baseUrl": "https://token-plan.maas.qwencloudapi.com/compatible-mode/v1", "envKey": "QWENCLOUD_TOKEN_PLAN_API_KEY" }
    ]
  }
}
Legen Sie das in ~/.qwen/settings.json ab. Dann richten Sie den fairen Test ein:
- Schreiben Sie den Vertrag einmal. Erstellen Sie eine
openapi.jsonfür eine kleine API, z. B.POST /ordersundGET /orders/{id}mit Validierungs- und Auth-Regeln. Kein Modell schreibt die Spec, also korrigiert keines seine eigene Hausaufgabe. - Legen Sie zwei leere Ordner an,
build-qwen4undbuild-qwen38, jeweils mit einer Kopie der Spec. - Senden Sie in jedem Ordner denselben Build-Prompt, einmal mit ausgewähltem
qwen4-max-preview, einmal mitqwen3.8-max: „Implementiere die API aus openapi.json mit Express. Läufe sie auf Port 3001 (bzw. 3002). Ändere die Spec nicht.“ - Notieren Sie die Grunddaten: Zeit bis zum laufenden Server, geschriebene Dateien und ob Sie eingreifen mussten.
Dann testen Sie beide Builds gegen dieselbe Suite. Da kommt Apidog CLI ins Spiel.
Bewerten Sie beide Builds mit Apidog CLI
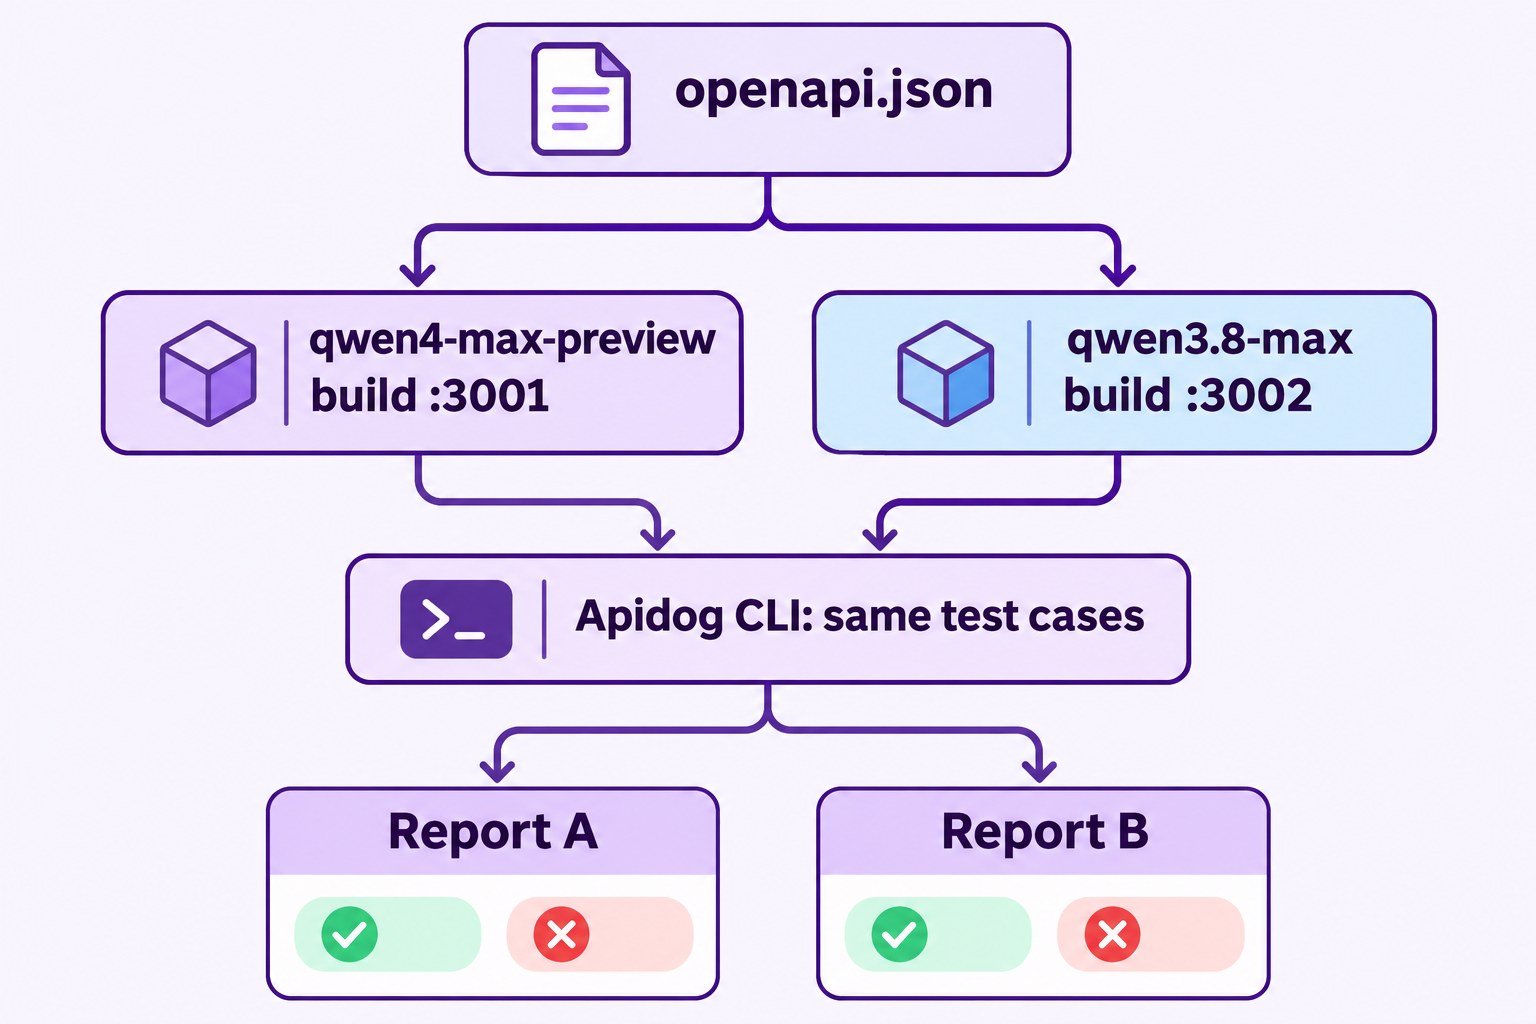
Ihr Coding-Agent steuert die Apidog CLI: Sie importiert die gemeinsame Spec, erstellt daraus einen Satz Testfälle und führt diesen Satz gegen jeden Build aus. Dieselben Tests, zwei Ziele, zwei Berichte.
Apidog CLI einmal einrichten
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
apidog skill install bringt Ihrem Agenten die CLI bei. Der Installationsguide behandelt Tokens.
Geben Sie Ihrem Agenten einen Prompt
Jeder Agent kann als Schiedsrichter dienen; es muss kein Qwen-Modell sein.
Import ./openapi.json into Apidog project <projectId>. Create two environments:
qwen4 at http://localhost:3001 and qwen38 at http://localhost:3002. From the spec,
create test cases for POST /orders: 201 on a valid order, 400 on a missing
customerId, 401 without a token, plus a GET /orders/{id} 404 case. Run every case
against both environments, save JSON reports, and give me a pass/fail table per model.
Don't modify either build.
Die apidog-Befehle, die er ausführt
Jedes Flag unten stammt aus apidog <command> --help auf Apidog CLI 2.2.12:
apidog import --project <projectId> --format openapi --file ./openapi.json
apidog environment create qwen4 --project <projectId> --base-url http://localhost:3001
apidog environment create qwen38 --project <projectId> --base-url http://localhost:3002
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case-201.json
apidog test-case create --project <projectId> --file ./case-201.json
apidog run --test-case <caseId> --project <projectId> -e <qwen4EnvId> -r cli,json --out-file qwen4-{GENERATE_TIME}
apidog run --test-case <caseId> --project <projectId> -e <qwen38EnvId> -r cli,json --out-file qwen38-{GENERATE_TIME}
cli-schema get gibt dem Agenten die exakte JSON-Struktur eines Testfalls, und cli-schema validate prüft jede Datei, bevor etwas geschrieben wird. Der Agent wiederholt test-case create und die beiden apidog run-Zeilen für jeden Fall. Der cli-Reporter druckt eine Bestehens-/Durchfallen-Zusammenfassung, und json speichert einen Bericht in apidog-reports, den der Agent für seine Tabelle liest. Fügen Sie --upload-report hinzu, um einen Lauf in der Apidog-App anzusehen.
Was Sie in den Berichten ablesen
Zählen Sie pro Modell drei Dinge: bestandene Fälle im ersten Build, nötige Fix-Runden bis alles grün ist, und Fälle, bei denen das Modell den Vertrag statt des Codes geändert hat. Führen Sie das Ganze zwei- bis dreimal aus, denn ein einzelner Lauf eines Vorschau-Modells sagt wenig aus. Für weitere agentengetriebene Muster siehe den Apidog-CLI-Agenten-Workflow und Apidog CLI in Claude Code. Apidogs Free-Plan deckt bis zu 4 Nutzer ab.
Was sollten Sie heute einsetzen?
Passen Sie das Modell an die Aufgabe an:
- Produktions-App oder Backend: Qwen 3.8. Es hat eine öffentliche API, einen veröffentlichten Preis und dokumentierte Limits. Die Token-Plan-Regeln schließen Qwen4-Max hier aus.
- Coding mit einem Agenten: Testen Sie beide im Token Plan. Führen Sie den obigen Test an einer Aufgabe aus Ihrem echten Backlog aus, nicht an einem Spielzeugbeispiel.
- Entscheidungen, die Zahlen brauchen: Warten Sie. Benchmarks, Kontextlänge und Preis für Qwen4-Max sind noch nicht da.
Behalten Sie die Modell-ID in einem Config-Wert, sodass die stabile Qwen4-Max-ID eine Ein-Zeilen-Änderung ist. Siehe auch Qwen 3.8 fürs Coding und unseren Guide zu den besten Qwen-Modellen.
FAQ
Ist Qwen4-Max besser als Qwen 3.8? Alibaba sagt, es habe tieferes Wissen und stärkere Coding- und Agenten-Fähigkeiten, aber Benchmarks wurden nicht veröffentlicht. Keine offiziellen Daten belegen das bisher – testen Sie also beide an Ihrer eigenen Aufgabe.
Kann ich Qwen4-Max über die API aufrufen wie Qwen 3.8? Nicht im Pay-as-you-go. Qwen4-Max ist über Token-Plan-Endpunkte mit der ID qwen4-max-preview verfügbar, für interaktive Nutzung in Coding-Tools. Qwen3.8-Max (qwen3.8-max) hat eine Standard-API.
Hat Qwen4-Max einen 1M-Token-Kontext wie Qwen 3.8? Alibaba hat es nicht gesagt. Qwen3.8-Max hat einen dokumentierten 1M-Kontext. Die 1M-Zahl für Qwen4-Max stammt nur aus Drittberichten.
Wie viel kostet Qwen4-Max im Vergleich zu Qwen 3.8? Qwen 3.8 kostet $2 Input und $6 Output pro Million Tokens. Qwen4-Max hat noch keinen Token-Preis. Über den Token Plan teilen sich beide einen Credit-Pool auf Plänen ab $3 (Lite-Event-Preis, Liste $8) pro Monat.
Sollte ich meine App von Qwen 3.8 auf Qwen4-Max umstellen? Noch nicht. Eine Vorschau kann sich ohne Vorankündigung ändern, und der Token Plan verbietet Produktionsautomatisierung. Behalten Sie Qwen 3.8 in der Produktion und betreiben Sie Qwen4-Max parallel in der Entwicklung.