
Die Preise für Qwen4-Max auf der QwenCloud-API mit Token-Abrechnung liegen in der Region Singapur bei 1,50 $ pro 1M Input-Tokens und 4,50 $ pro 1M Output-Tokens, mit gecachten Inputs zu 0,075 $ pro 1M. Thinking- und Non-Thinking-Modus kosten dasselbe, und es gibt keine Eingabelängen-Stufen. Wenn Sie lieber eine pauschale Monatsgebühr für Coding-Tools zahlen möchten, ist dasselbe Modell im Token Plan enthalten, ab 6 $ im Monat.
Unten: der Preisvergleich, echte Aufgabenkosten, Cache-Ersparnisse, Token Plan vs. Token-Abrechnung und die Preise der Konkurrenz. Neu beim Modell? Beginnen Sie mit „Was ist Qwen4-Max?“.
Qwen4-Max-API-Preis pro 1M Tokens
Qwen4-Max wird pro Million Tokens abgerechnet, mit getrennten Sätzen für Input, Output, Cache-Schreibvorgänge und Cache-Lesevorgänge. Der Output umfasst sowohl Reasoning- („Thinking“-)Tokens als auch die Antwort. Alibaba veröffentlicht eine Spalte für Singapur (International) und eine günstigere Spalte für Peking/Global.
| Abrechnungsposten (pro 1M Tokens) | Singapur (International) | Peking / Global |
|---|---|---|
| Input | 1,50 $ | 1,413 $ |
| Output (Thinking + Antwort) | 4,50 $ | 4,24 $ |
| Cache-Schreibvorgang, 5-Minuten-TTL | 1,875 $ | 1,767 $ |
| Cache-Schreibvorgang, 1-Stunden-TTL | 3,00 $ | 2,827 $ |
| Cache-Lesevorgang (expliziter oder impliziter Treffer) | 0,075 $ | 0,071 $ |
Quelle: die QwenCloud-Preisdokumentation und die Qwen4-Max-Modellseite, beide geprüft am 16. November 2026. Die Dokumentation listet das Global-Deployment in Frankfurt, Hongkong, Tokio und US (Virginia) auf.
Ein paar Regeln beeinflussen die Rechnung:
- Thinking-Tokens sind Output. Aktivieren Sie
enable_thinking, wird jedes Reasoning-Token mit 4,50 $ pro 1M abgerechnet. - Kein Langkontext-Aufpreis. Eine Anfrage mit 900K Tokens kostet pro Token genau so viel wie eine mit 9K.
- Cache-Lesevorgänge kosten 5 % des Input-Preises. 0,075 $ gegenüber 1,50 $ sind 95 % Rabatt auf wiederholte Präfixe.
- Limits: 1M-Token-Kontext, bis zu 991K Input (983K mit Thinking), bis zu 393K Output und 5.000.000 Tokens pro Minute.
Die Modell-ID lautet qwen4-max. Falls Sie noch keinen Aufruf gemacht haben, behandelt unser Qwen4-Max-API-Leitfaden Schlüssel, Basis-URLs und die erste Anfrage.
Was eine echte Qwen4-Max-Aufgabe kostet
Token-Preise sind schwer greifbar. Alibaba nennt eine konkrete Zahl in seinem Launch-Beitrag: Im eigenen Work360-Agent-Benchmark sanken die durchschnittlichen Kosten pro Aufgabe von 4,43 $ mit Qwen3.8-Max auf 1,67 $ mit Qwen4-Max – 62 % weniger. Alibaba berichtet außerdem, dass Qwen4-Max auf Work360 auf der Stufe Xhigh etwa 24 % weniger Tokens und auf High etwa 35 % weniger Tokens verbrauchte. Das sind Herstellerangaben, betrachten Sie sie also als Richtung, nicht als Angebot für Ihre Workload.
Sie können Ihre eigenen Kosten mit einfacher Rechnung schätzen. Hier drei durchgerechnete Beispiele zu Singapurer Listenpreisen:
- Kurzer Chat-Aufruf. 2.000 Input-Tokens und 500 Output-Tokens: 2.000 × 1,50 $/1M + 500 × 4,50 $/1M = 0,003 $ + 0,00225 $ = 0,0053 $. Das sind etwa 5,25 $ pro 1.000 Aufrufe.
- Derselbe Aufruf mit aktiviertem Thinking. Angenommen, das Modell räsoniert 6.000 Tokens lang, bevor die 500-Token-Antwort kommt. Der Output wird zu 6.500 Tokens, also kostet der Aufruf 0,003 $ + 0,02925 $ = 0,032 $, etwa sechsmal so viel.
- Frage zu einem Langdokument. 300.000 Input-Tokens und 2.000 Output-Tokens: 0,45 $ + 0,009 $ = 0,459 $ ohne Cache, oder etwa 0,032 $, wenn das 300K-Dokument ein Cache-Treffer ist.
Beispiel 2 überrascht viele: Thinking kann die Rechnung dominieren, selbst wenn die Antwort kurz ist. Für tiefere Zahlen zur Qualität pro Dollar siehe die Qwen4-Max-Benchmarks im Detail.
Wie Cache-Sätze die Qwen4-Max-Rechnung verändern
Beim Context Caching bewegt sich bei den Qwen4-Max-Preisen am meisten. QwenCloud bietet für qwen4-max auf der Token-Abrechnungs-API zwei Modi an, und auf den Chat-Completions-, DashScope- und Anthropic-kompatiblen APIs schließen sie sich pro Anfrage gegenseitig aus.
| Modus | Funktionsweise | Preis | Treffer garantiert? |
|---|---|---|---|
| Impliziter Cache | Automatisch, nicht deaktivierbar, wiederverwendet ein gemeinsames Präfix von 1.024+ Tokens | 0,075 $ pro 1M bei einem Treffer | Nein. Gültigkeit ist unbestimmt |
| Expliziter Cache | Sie markieren einen Haltepunkt mit cache_control |
1,875 $ (5 Min.) oder 3 $ (1 Std.) zum Schreiben, 0,075 $ zum Lesen | Ja, solange der Cache gültig ist |
In der Context-Cache-Dokumentation heißt es, dass ein expliziter 5-Minuten-Cache seinen Timer bei jedem Treffer zurücksetzt, sodass eine stark frequentierte Agent-Schleife ihn warm hält.
Nehmen wir nun eine Agent-Sitzung: ein 200K-Token-Systemprompt plus Tool-Definitionen und Repo-Kontext, wiederverwendet über 50 Runden, mit 2K neuem Input und 3K Output pro Runde.
- Keine Cache-Treffer: 10,1M Input-Tokens × 1,50 $ + 150K Output × 4,50 $ = 15,83 $.
- Implizite Cache-Treffer ab Runde 2: die ersten 202K zum vollen Preis (0,30 $), 9,8M gecachte Tokens zu 0,075 $ (0,74 $), 98K frische Tokens (0,15 $) und Output (0,68 $) = 1,86 $.
- Expliziter 5-Minuten-Cache: ein Schreibvorgang für 0,375 $ statt des ersten voltpreisigen Präfixes, dieselben Lesevorgänge und derselbe Output = etwa 1,94 $, mit garantiertem Treffer.
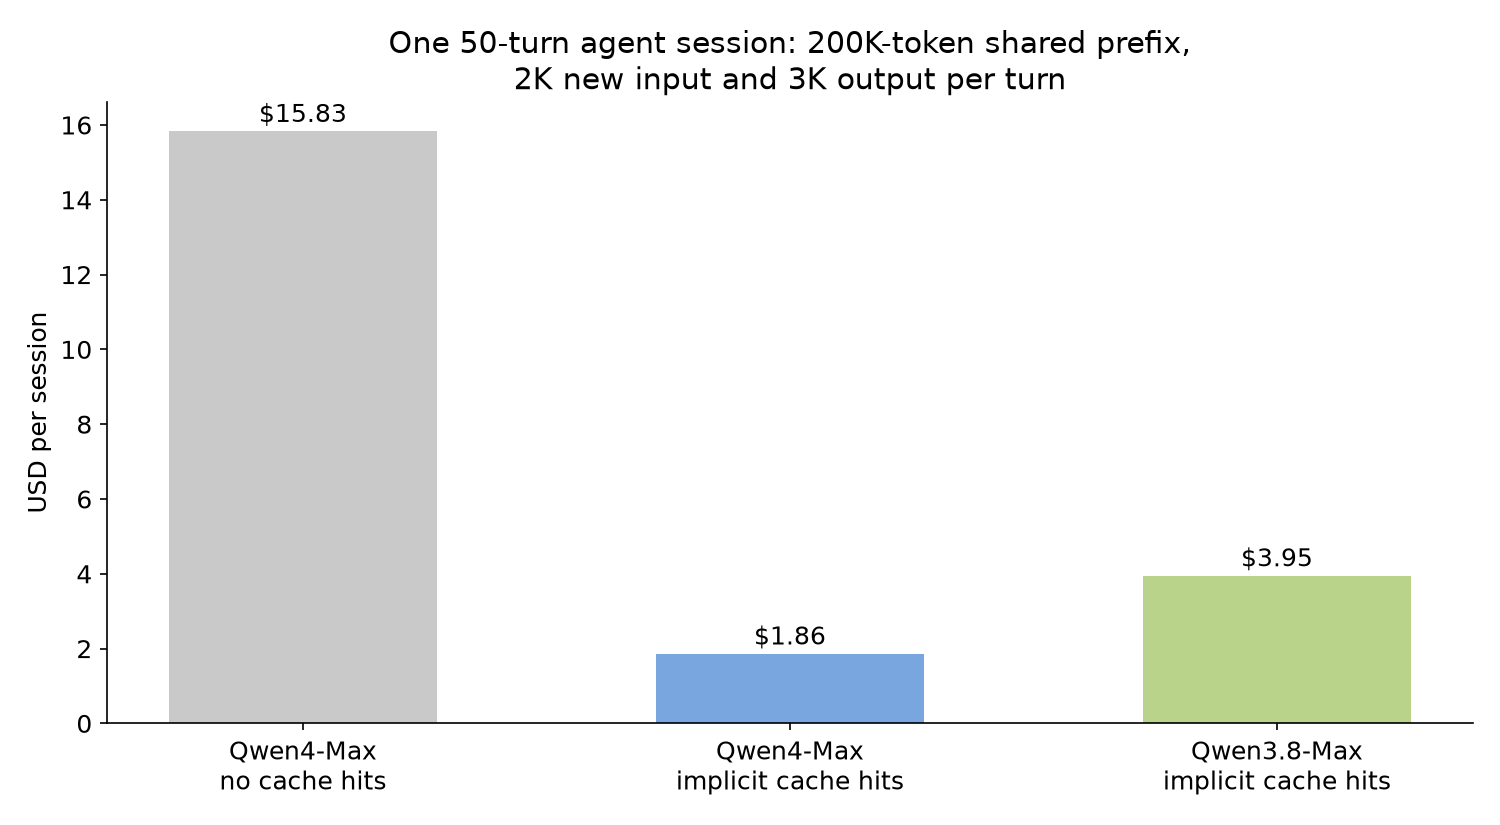
Dieselbe Sitzung auf Qwen3.8-Max, mit seinen Sätzen von 2 $ Input, 0,25 $ implizitem Cache und 6 $ Output, kostet 3,95 $. Genau da zeigt sich Alibabas Behauptung von der „größten Senkung bei gecachtem Input“: Qwen3.8-Max verlangt 0,25 $ für einen impliziten Treffer, Qwen4-Max 0,075 $.
Verwenden Sie explizites Caching, wenn Sie einen vorhersagbaren Treffer brauchen, und implizites Caching für alles andere. Prüfen Sie, was Sie erhalten haben, in usage.prompt_tokens_details.cached_tokens und cache_creation_input_tokens. Wenn Sie die Cache-Ökonomie verschiedener Anbieter abwägen, verwendet unser Beitrag zur Prompt-Caching-Rechnerei bei Claude Opus 5.5 dieselbe Methode.
Gibt es einen Qwen4-Max-Batch-Rabatt?
Ja, aber nur in einer Region. Die Batch-API von QwenCloud rechnet Input und Output normalerweise mit 50 % des Echtzeitpreises ab. Für qwen4-max führt die Batch-Dokumentation ihn nur unter China North 2 (Peking) auf, mit 0,707 $ Input und 2,12 $ Output pro 1M Tokens für Batch File. Batch Chat in Peking ist mit 1,413 $ / 4,24 $ gelistet.
Batch unterstützt kein Context Caching, lässt sich nicht mit anderen Rabatten kombinieren und ist nicht von der Gratisquote abgedeckt. Bei hohen Cache-Trefferraten kann die Echtzeit-API Batch unterbieten.
Qwen4-Max: Token-Abrechnung vs. Token Plan
Der Token Plan ist QwenClouds Monatsabo für Coding- und Agent-Tools wie Claude Code, Cursor, Qwen Code, Codex und Qoder. Abgerechnet wird in Credits, nicht in Tokens, und es werden eigene sk-sp--API-Schlüssel verwendet. qwen4-max steht auf der Liste der unterstützten Modelle. Einzelpläne laut Token-Plan-Dokumentation vom 16. November 2026:
| Plan | Preis pro Monat | Credits pro Monat | Parallele Agenten |
|---|---|---|---|
| Lite | 6 $ (3 $ befristeter Neukundenpreis) | 20.000 | 1–2 |
| Essential | 10 $ (5 $ befristeter Neukundenpreis) | 45.000 | 2–3 |
| Standard | 18 $ | 80.000 | 3–4 |
| Pro | 43 $ | 200.000 | 6–8 |
Zusätzliche Credit-Packs kosten 15 $ für 20.000 Credits (bis zu 5 gleichzeitig). Wenn die Credits aufgebraucht sind, werden Aufrufe blockiert; es gibt keinen Fallback auf Token-Abrechnung.
So entscheiden Sie:
- Token Plan wählen, wenn eine Person das Modell täglich über einen Coding-Agenten nutzt und eine feste monatliche Kosten will.
- Token-Abrechnung wählen für Produkte, Backend-Jobs, Batch, Fine-Tuning oder stoßweisen Traffic. Sie zahlen nur, was Sie nutzen, und behalten das Limit von 5.000.000 TPM.
Credits pro Qwen4-Max-Anfrage sind kein festes Token-Verhältnis, prüfen Sie also nach einem Tag realer Nutzung die Konsole. Wir behandeln den Plan ausführlich, auch wie weit die Credits reichen, in Qwen4-Max Token Plan: Was er kostet und ob er sich lohnt.
Qwen4-Max-Preise im Vergleich zu Qwen3.8-Max und rivalisierenden Flaggschiffen
Qwen4-Max ist günstiger als sein Vorgänger bei Input, Output, Cache-Lesevorgängen und dem 5-Minuten-Cache-Schreibvorgang (Qwen3.8-Max listet einen einzigen Cache-Schreibpreis von 2,50 $; der 1-Stunden-Schreibvorgang von Qwen4-Max kostet 3 $). So positioniert es sich gegenüber anderen Flaggschiffen zu Standardlistenpreisen, jeweils von der eigenen Seite des Anbieters am 16. November 2026 abgerufen.
| Modell | Input / 1M | Gecachter Input / 1M | Output / 1M |
|---|---|---|---|
| Qwen4-Max (Singapur) | 1,50 $ | 0,075 $ | 4,50 $ |
| Qwen3.8-Max | 2,00 $ | 0,25 $ (implizit), 0,17 $ (explizites Lesen) | 6,00 $ |
| DeepSeek V4 Pro (Spitze / Nebenzeiten) | 1,32 $ / 0,66 $ | 0,044 $ / 0,022 $ | 3,96 $ / 1,98 $ |
| OpenAI gpt-5.6-sol | 4,00 $ | 0,40 $ | 20,00 $ |
| Claude Opus 5.5 | 4,00 $ | 0,20 $ | 20,00 $ |
Quellen: Qwen3.8-Max-Modellseite, DeepSeek-Preise, OpenAI-API-Preise und Claude-Preise.
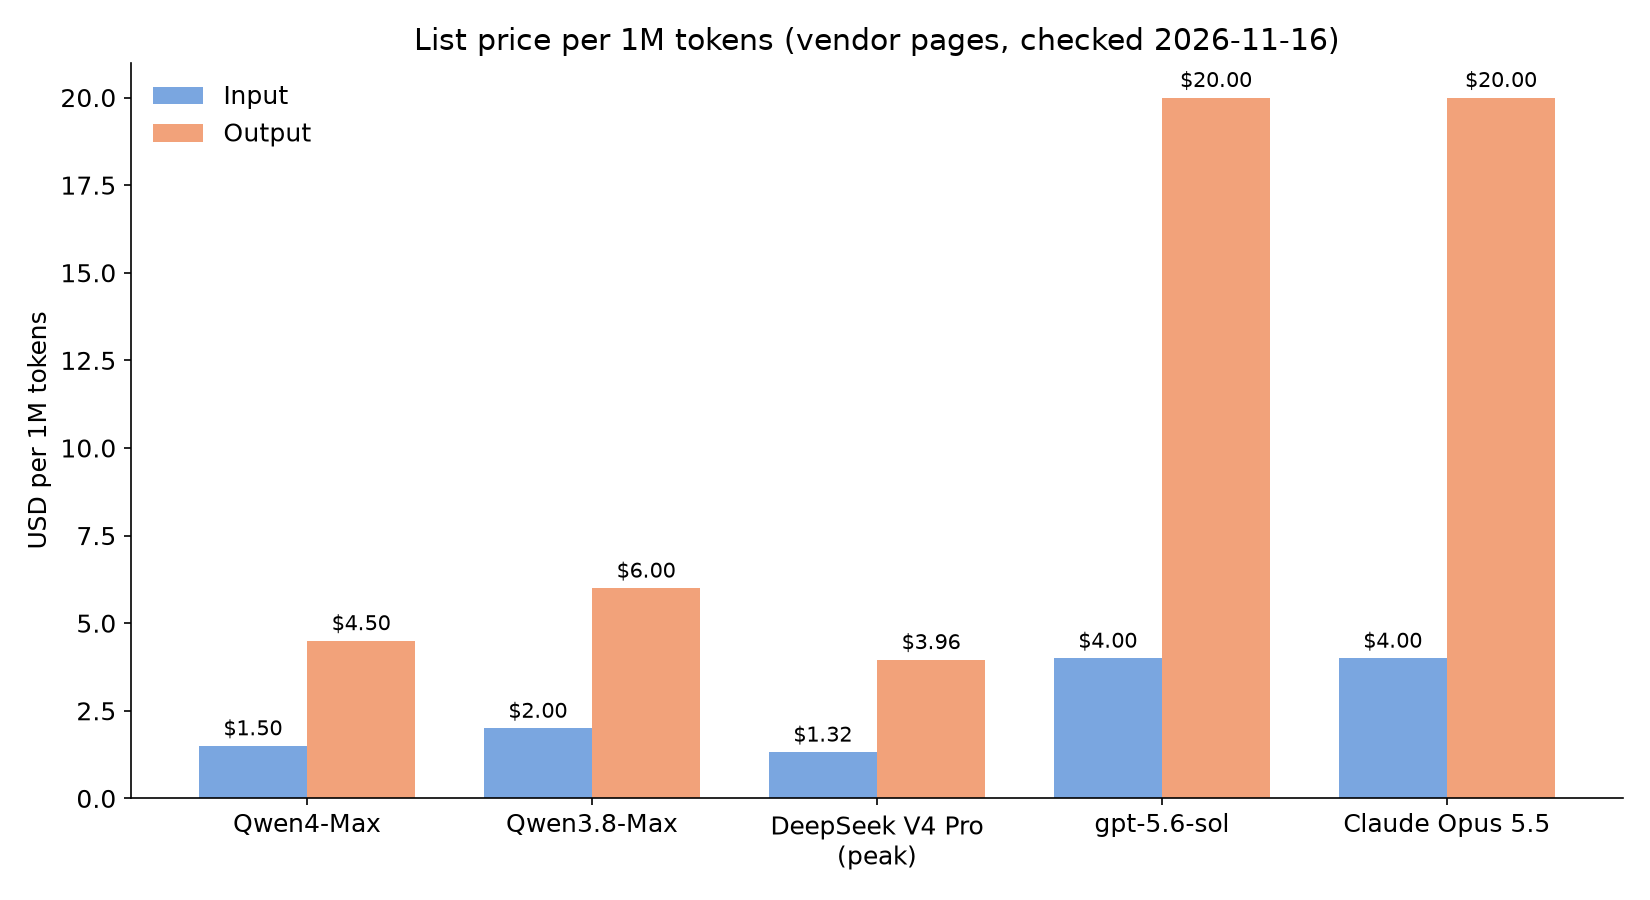
Für Agenten ist der Output oft der größte Posten, und der 4,50-$-Output von Qwen4-Max liegt deutlich unter den 20 $, die gpt-5.6-sol und Claude Opus 5.5 verlangen. DeepSeek V4 Pro ist pro Token günstiger, besonders in Nebenzeiten. Die Kosten pro abgeschlossener Aufgabe hängen davon ab, wie viele Tokens jedes Modell für Ihre Workload verbraucht. Für Details zu Qwen3.8-Max siehe unseren Qwen-3.8-Preis-Leitfaden und den Vergleich Qwen4-Max vs. Qwen 3.8.
Lassen Sie Ihren Coding-Agenten die Qwen4-Max-Kosten mit Apidog CLI messen
Die einzige verlässliche Kostenschätzung sind usage-Werte, gemessen an Ihren eigenen Prompts. Lassen Sie Ihren Coding-Agenten (Claude Code, Codex, Cursor oder Ähnliches) diese Prüfung mit dem Apidog CLI aufbauen und ausführen. Richten Sie es einmalig ein:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
Geben Sie Ihrem Agenten dann einen Prompt:
In Apidog project <projectId>, create an environment "qwencloud-sg" with base URL
https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1 and a secret
variable for my DashScope API key. Add a POST /chat/completions endpoint for model
qwen4-max and two test cases: one with enable_thinking true, one false. Assert
status 200, a non-empty choices array and a usage object. Run both and report
prompt_tokens, completion_tokens and cached_tokens side by side.
Der Agent prüft jedes Payload-Format gegen das CLI-Schema, bevor er etwas schreibt, und führt dann die Fälle aus:
apidog environment create qwencloud-sg --project <projectId> --base-url https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case-thinking.json
apidog test-case create --project <projectId> --file case-thinking.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
Vergleichen Sie die beiden completion_tokens-Zahlen und multiplizieren Sie mit 4,50 $ pro 1M: Das ist Ihr Thinking-Aufpreis, an Ihren eigenen Prompts. Fügen Sie dem apidog run-Befehl --upload-report hinzu, um den Lauf in der Apidog-App anzusehen, oder legen Sie denselben Befehl in die CI mit -r junit, wie in Apidog CLI in CI/CD ausführen gezeigt. Neu beim CLI? Der Apidog-CLI-Installationsleitfaden und Apidog CLI in Codex bringen Sie in wenigen Minuten zum Laufen. Apidogs Gratisplan umfasst bis zu 4 Nutzer.
FAQ
Was kostet Qwen4-Max pro 1M Tokens? 1,50 $ für Input und 4,50 $ für Output in der Region Singapur, mit Cache-Lesevorgängen zu 0,075 $. Die Spalte Peking/Global liegt mit 1,413 $ und 4,24 $ etwas niedriger.
Kostet der Thinking-Modus bei Qwen4-Max mehr? Der Satz ist derselbe, aber Reasoning-Tokens werden als Output mit 4,50 $ pro 1M abgerechnet, sodass langes Räsonieren die Kosten eines Aufrufs vervielfacht.
Ist Qwen4-Max günstiger als Qwen3.8-Max? Ja. Der Input sinkt von 2 $ auf 1,50 $, der Output von 6 $ auf 4,50 $, und ein impliziter Cache-Treffer von 0,25 $ auf 0,075 $ pro 1M Tokens. Alibaba berichtet außerdem, dass die Work360-Kosten pro Aufgabe von 4,43 $ auf 1,67 $ gefallen sind.
Kann ich Qwen4-Max kostenlos nutzen? QwenCloud gibt neuen Modellen in der Region Singapur nach dem Hinterlegen der Zahlungsinformationen eine Gratisquote, typischerweise 1M Tokens, gültig für 90 Tage. Prüfen Sie die Free-Tier-Seite in der Konsole für qwen4-max und sehen Sie sich unseren Leitfaden zum kostenlosen Zugang zu Qwen4-Max für alle 0-$-Wege an.
Unterstützt Qwen4-Max Batch-Preise? Nur in der Region Peking: Batch File kostet 0,707 $ Input und 2,12 $ Output pro 1M Tokens, ohne Context Caching.
Sollte ich für Qwen4-Max Token Plan oder Token-Abrechnung wählen? Der Token Plan passt zu einer Person, die täglich Coding-Tools nutzt, ab 6 $ im Monat. Die Token-Abrechnung passt zu Apps, Backend-Jobs und Batch-Arbeiten.