
Qwen4-Max-Benchmarks in einem Satz: Alibabas Tabelle platziert Qwen4-Max bei allen 15 Tests, in denen beide Modelle vorkommen, vor Qwen3.8-Max, und bei 4 von 16 Tests sogar auf dem ersten Platz – aber die meisten dieser Zahlen stammen aus Alibabas eigenen Messungen. Bei Work360 erreicht es 52,69 gegenüber 47,74, und die durchschnittlichen Kosten pro Aufgabe sinken von 4,43 $ auf 1,67 $.
Ein Benchmark ist nur so nützlich wie die Antwort auf die Frage: „Wer hat ihn ausgeführt, und wie?“ Dieser Artikel behandelt jeden Score, den Alibaba am 16. November 2026 veröffentlicht hat, ordnet sie in selbst gemeldete und Ergebnisse Dritter ein und endet mit einer Möglichkeit, Ihren eigenen Test gegen die Qwen4-Max-API zu fahren. Für die Grundlagen beginnen Sie mit Was ist Qwen4-Max und wie Sie Zugriff erhalten.
Qwen4-Max-Benchmark-Ergebnisse auf einen Blick
Alibabas Launch-Beitrag vergleicht Qwen4-Max mit Qwen3.8-Max-0902, Opus 5.5, GPT-6.1 Sol, GPT-6 Astra und Kimi K3.1 auf 16 Benchmarks.
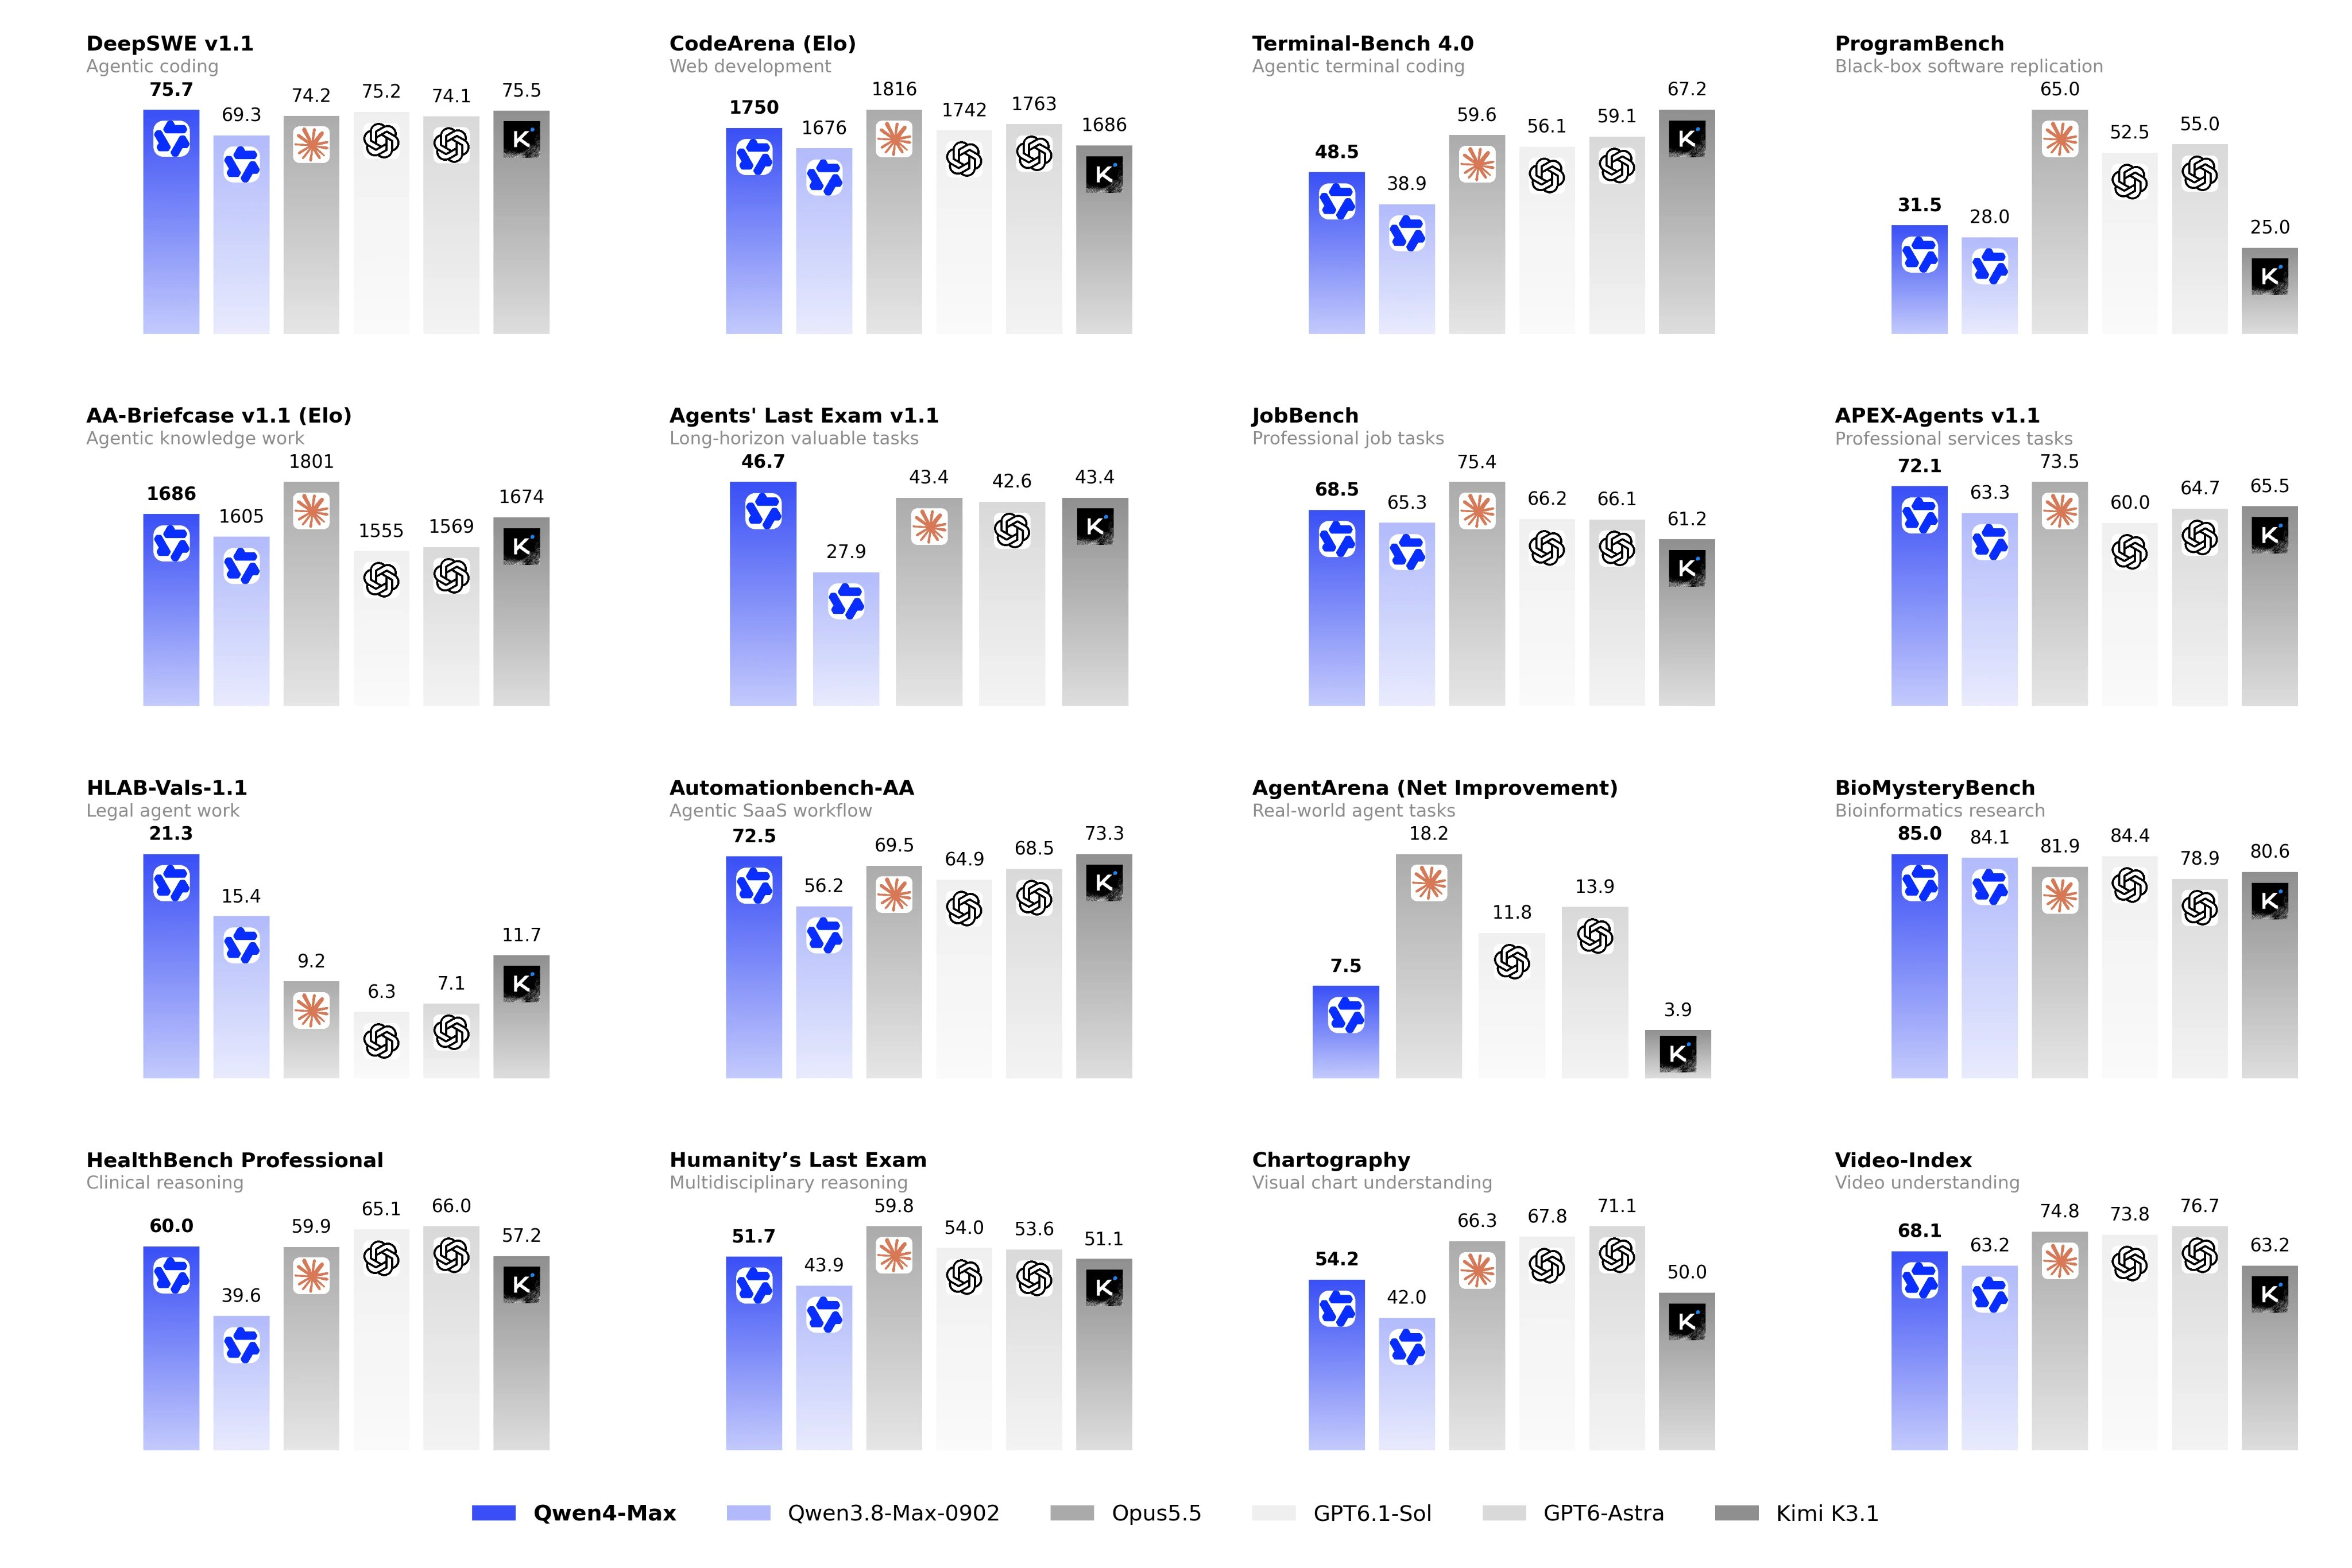
Fett markiert den besten Wert der Tabelle. „Alibaba“ bedeutet, dass die Fußnoten für diesen Test keine externe Rangliste angeben – behandeln Sie ihn daher als Alibabas eigenen Lauf (die Fußnoten zu JobBench und Chartography beschreiben nur Alibabas Setup).
Selbst gemeldet vs. Dritte: Wer hat welchen Test ausgeführt?
Zehn der 16 Ergebnisse sind selbst gemeldet. Sechs stammen von öffentlichen Ranglisten, die von anderen betrieben werden. Diese Aufteilung ist der nützlichste Filter, den Sie anwenden können.
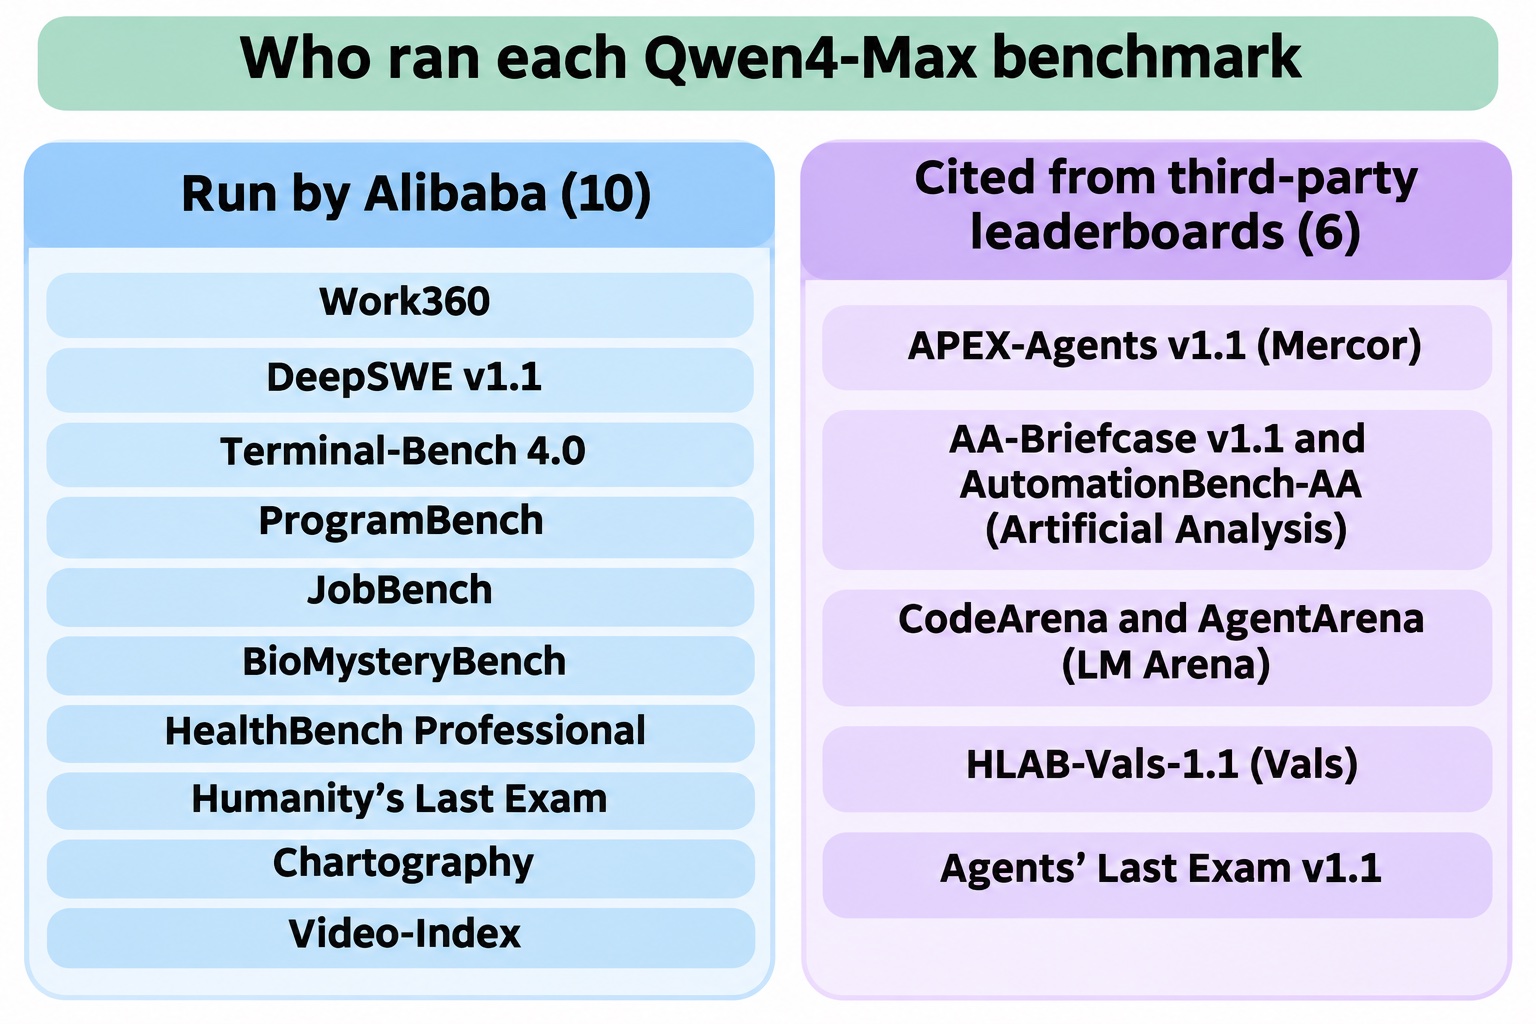
Die Gruppe der Drittanbieter, laut den Fußnoten des Launch-Beitrags:
- APEX-Agents v1.1: zitiert aus der Mercor-APEX-Agents-Rangliste
- AA-Briefcase v1.1 und AutomationBench-AA: zitiert aus Artificial Analysis
- CodeArena und AgentArena: zitiert aus LM Arena
- HLAB-Vals-1.1: zitiert aus dem Vals Index
- Agents’ Last Exam v1.1: zitiert aus seiner eigenen Rangliste
Eine unabhängige Zahl, die Sie heute prüfen können: Der Vals Index (Version 2.2, aktualisiert am 15. November 2026) listet Qwen 4 Max mit 63,20 % gesamt auf Rang 11 bei 9,33 $ pro Test. Das platziert es hinter zehn Modellen, angeführt von Claude Fable 5.2 mit 71,31 %, und knapp vor Kimi K3.1 Pro (62,52 %) und Qwen 3.8 Max 0902 (59,05 %). Das ist ein bescheideneres Bild als die große Tabelle.
Work360: Alibabas eigener Arbeits-Benchmark
Work360 ist Alibabas Benchmark für komplexe Industrieaufgaben und umfasst 26 Domänen, 182 Subdomänen und 721 Fachgebiete. Qwen4-Max erreichte 52,69, gegenüber 47,74 bei Qwen3.8-Max.
Lesen Sie das mit Vorsicht: Alibaba hat den Benchmark entworfen und die Modelle selbst ausgeführt, sein veröffentlichter Vergleich umfasst nur Qwen4-Max und Qwen3.8-Max, und eine öffentliche Rangliste gibt es noch nicht. Es ist eine Zahl von Generation zu Generation, kein Ranking gegen andere Labore.
Was Work360 Ihnen dennoch liefert, ist eine Kostenangabe: Die durchschnittlichen Kosten pro Aufgabe sanken von 4,43 $ auf 1,67 $, eine Reduktion um 62 % – durch weniger Token pro Aufgabe und niedrigere Preise zusammen. Qwen4-Max ist auf der QwenCloud-Modellseite mit 1,50 $ pro 1 Mio. Eingabe-Token und 4,50 $ pro 1 Mio. Ausgabe-Token gelistet. Die vollständige Aufschlüsselung finden Sie in unserem Qwen4-Max-Preis-Leitfaden.
Terminal-Bench 4.0 und Token-Effizienz
Terminal-Bench misst, wie Agenten echte Aufgaben im Terminal erledigen. Alibaba meldet 48,5 für Qwen4-Max auf Version 4.0, gegenüber 38,9 bei Qwen3.8-Max. In Alibabas eigener Tabelle liegen die vier Nicht-Qwen-Modelle zwischen 56,1 und 67,2 – alle darüber.
Die größere Behauptung betrifft die Effizienz. Alibaba sagt, der Token-Verbrauch sinkt bei Terminal-Bench 4.0 um etwa 48 % bei Xhigh und 49 % bei High, und bei Work360 um etwa 24 % (Xhigh) bzw. 35 % (High). Seine Score-vs-Token-Tabelle zeigt die Form davon:
- Bei Work360 übertrifft Qwen4-Max bei High bereits Qwen3.8-Max bei Xhigh, mit rund 96K Token pro Aufgabe gegenüber rund 165K (aus der Tabelle abgelesen, daher ungefähr).
- Bei Terminal-Bench 4.0 erreicht Qwen4-Max bei Xhigh 48,5 mit rund 150K Token pro Aufgabe, während Qwen3.8-Max bei Xhigh etwa 38 mit rund 290K erreicht.
Weniger Token für einen besseren Score ist die richtige Richtung, wenn Sie pro Token zahlen. Es ist aber auch selbst gemeldet.
Eine Prüfung, die Sie kennen sollten: Die öffentliche Terminal-Bench-Rangliste zeigt standardmäßig inzwischen Version 4.1, und Qwen4-Max ist dort zum 16. November nicht gelistet. Qwen3.8-Max-0902 zeigt 27,0 % auf 4.1 (ausgeführt mit Claude Code bei max. Anstrengung), gegenüber 38,9 in Alibabas 4.0-Tabelle. Andere Version und Harness – subtrahieren Sie also nicht das eine vom anderen, aber es zeigt, wie stark ein Score vom Setup abhängt.
Wo Qwen4-Max führt – und wo es zurückliegt
Gegenüber den anderen Frontier-Modellen in der Tabelle ist das Bild gemischt:
Führt (4 von 16): DeepSWE v1.1 (75,7, ein Vorsprung von 0,2 Punkten auf Kimi K3.1), Agents’ Last Exam v1.1 (46,7), HLAB-Vals-1.1 (21,3) und BioMysteryBench (85,0, weniger als ein Punkt vor GPT-6.1 Sol).
Knappe zweite Plätze: APEX-Agents v1.1 (72,1 vs. 73,5), AutomationBench-AA (72,5 vs. 73,3) und AA-Briefcase (1686 vs. 1801 Elo).
Deutlich zurück: ProgramBench (31,5 vs. 65,0), Terminal-Bench 4.0 (48,5 vs. 67,2), AgentArena (7,5 vs. 18,2), Chartography (54,2 vs. 71,1) und Humanity’s Last Exam (51,7 vs. 59,8).
Zwei der vier Führungen, Agents’ Last Exam und HLAB-Vals, stammen aus Ranglisten Dritter, was sie zu den stärksten Aussagen der Tabelle macht. Beim Programmieren geht es geteilt: knapper DeepSWE-Vorsprung, weite Abstände bei ProgramBench und Terminal-Bench. Wenn Sie langlebige Terminal-Agenten betreiben, testen Sie, bevor Sie wechseln. Was sich seit der letzten Generation geändert hat, erfahren Sie in Qwen4-Max vs. Qwen 3.8.
Secure Coding und Pre-Training-Zahlen
Secure Coding. Beim Last Secure Code Bench, in der Einstellung „Code-Rekonstruktion ohne Sicherheitshinweis“ mit geprüfter Funktionalität und Schwachstellen, stieg die Pass-Rate auf Funktionsebene von 22,0 % bei Qwen3.8-Max auf 31,8 %. Der Anteil von Code, der alle drei Ebenen bestand (Funktion, Datei und Repository), stieg von 8 % auf 14,7 %. Etwa zwei Drittel der Ausgaben auf Funktionsebene bestehen die Prüfung weiterhin nicht – die Sicherheitsüberprüfung bleibt also Ihre Aufgabe.
Pre-Training. Bei internen Evaluierungen über Wissen, Code, QA und STEM zeigt Qwen4-Max-Base etwa 5 % bis 13 % weniger Bits pro Byte als Qwen3.8-Max-Base, während es 25 % weniger Parameter aktiviert. Alibaba weist darauf hin, dass zwei Checkpoints in diesem Vergleich (GLM-5.3 und Kimi-K3.1-Pro) post-trained sind, was das Ergebnis verzerren kann.
Was noch fehlt
- Evaluierungseinstellungen für die meisten Tests. Der Launch-Beitrag sagt nicht, welche Anstrengungsstufe (High oder Xhigh) und welcher Agent-Harness jede Säule erzeugt hat.
- Varianz. Keine Fehlerbalken oder Laufzahlen. Ranglisten wie Terminal-Bench berichten Spannen von etwa 3 bis 4 Punkten – größer als manche der obigen Abstände.
- Unabhängige Terminal-Bench- und Work360-Läufe. Keiner davon ist bisher auf einer öffentlichen Rangliste.
Führen Sie Ihren eigenen Qwen4-Max-Benchmark mit Apidog CLI aus
Kein öffentlicher Benchmark nutzt Ihre Prompts oder Ihre Schemas. Die schnellste ehrliche Prüfung ist eine kleine Suite eigener Anfragen, jedes Mal gleich ausgeführt, mit aufgezeichnetem Token-Verbrauch, damit Sie Ihre eigenen Kosten pro Aufgabe berechnen können.
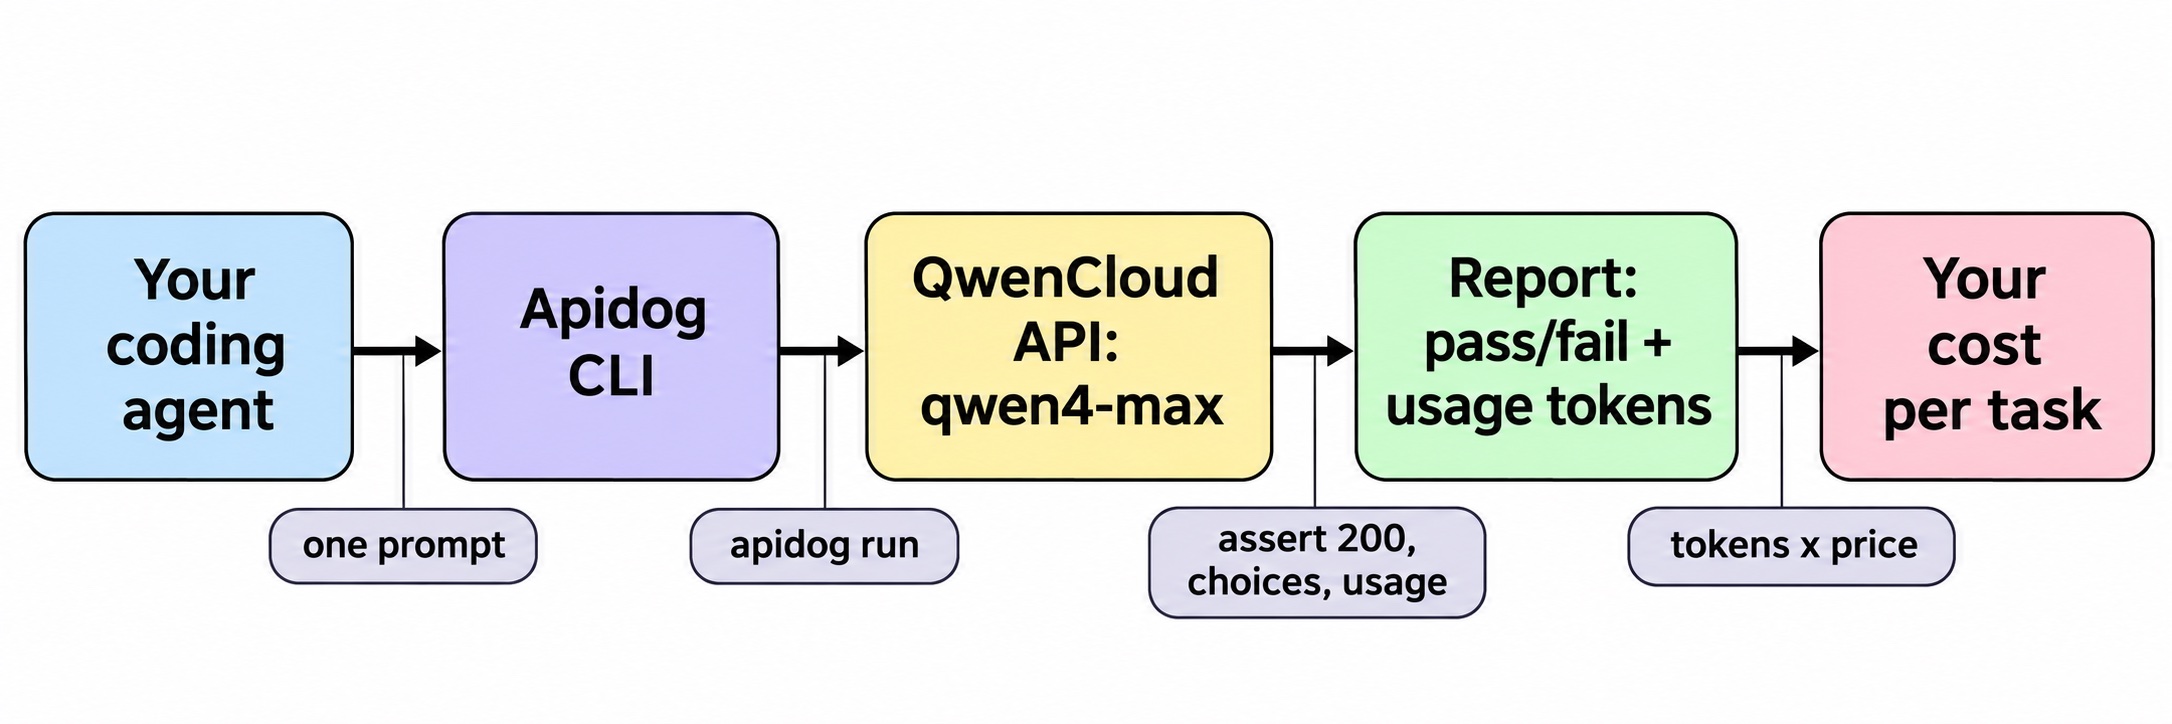
Überlassen Sie das Setup Ihrem Coding-Agent mit dem Apidog CLI. Einmalige Installation:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
apidog skill install bringt Ihrem Agenten das CLI bei; der Installations-Leitfaden behandelt Tokens. Geben Sie ihm dann einen Prompt:
In Apidog project <projectId>, add POST /chat/completions for the QwenCloud
OpenAI-compatible API (model qwen4-max, Bearer auth from {{DASHSCOPE_API_KEY}}).
Create an environment "qwencloud-sg" with base URL
https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1.
Create a test case that asserts status 200, a non-empty choices array and a
usage object. Run it once per row of ./prompts.csv, save a JSON report, and
give me pass rate plus total prompt and completion tokens.
Der Agent prüft jede Payload-Struktur, bevor er etwas schreibt. Jedes Flag unten stammt aus apidog <command> --help auf Apidog CLI 2.2.12:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file ./qwen-chat.json
apidog endpoint create --project <projectId> --file ./qwen-chat.json
apidog environment create qwencloud-sg --project <projectId> --base-url https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case.json
apidog test-case create --project <projectId> --file ./case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -d ./prompts.csv --env-var "DASHSCOPE_API_KEY=$DASHSCOPE_API_KEY" -r cli,json
-d führt eine Iteration pro Zeile Ihrer Prompt-Datei aus, und --env-var übergibt den Schlüssel zur Laufzeit, damit er nie im Projekt liegt. Der Agent liest jeden usage-Block aus dem JSON-Bericht in apidog-reports. Multiplizieren Sie Prompt-Token mit 1,50 $ und Completion-Token mit 4,50 $ pro Million, und Sie haben Ihre eigenen Kosten pro Aufgabe zum Vergleich mit Alibabas 1,67 $.
Tauschen Sie die Umgebung aus, um dieselbe Suite gegen Ihr aktuelles Modell zu fahren, und wiederholen Sie sie zwei- bis dreimal, um die Varianz zu sehen, die die Launch-Tabelle nicht zeigt. Dieselbe apidog run-Zeile lässt sich mit -r junit in CI integrieren; siehe den CI/CD-Leitfaden. Für ein Schritt-für-Schritt-Agenten-Setup siehe Apidog CLI in Claude Code. Apidogs kostenloser Plan deckt bis zu 4 Nutzer ab.
FAQ
Sind die Qwen4-Max-Benchmarks unabhängig? Meistens nicht. Zehn der 16 Ergebnisse in Alibabas Tabelle sind eigene Läufe. Sechs stammen aus Ranglisten Dritter: APEX-Agents (Mercor), AA-Briefcase und AutomationBench-AA (Artificial Analysis), CodeArena und AgentArena (LM Arena), HLAB-Vals (Vals) und Agents’ Last Exam.
Was ist Work360? Alibabas eigener Benchmark für komplexe Industrieaufgaben über 26 Domänen. Qwen4-Max erreichte 52,69 gegenüber 47,74 bei Qwen3.8-Max; nur diese beiden Modelle erscheinen in seinem veröffentlichten Vergleich.
Wie schneidet Qwen4-Max bei Terminal-Bench 4.0 ab? Alibaba meldet 48,5, gegenüber 38,9, mit etwa der Hälfte der Token. Die anderen Frontier-Modelle in der Tabelle erreichen 56,1 bis 67,2.
Ist Qwen4-Max günstiger zu betreiben als Qwen3.8-Max? Bei Alibabas Work360-Evaluierung sanken die durchschnittlichen Kosten pro Aufgabe von 4,43 $ auf 1,67 $. Die Listenpreise liegen bei 1,50 $ für Eingabe und 4,50 $ für Ausgabe pro 1 Mio. Token. Siehe den Token-Plan-Leitfaden für Abo-Optionen und Qwen4-Max kostenlos nutzen für kostenlose Wege.
Was ist Live Delivery im Qwen4-Max-Launch? Ein Agenten-Workflow, der früh eine nutzbare erste Version ausliefert und sie verbessert, während Sie steuern. Es ist kein Benchmark. Unser Leitfaden zum Qwen-Live-Delivery-Plugin behandelt das.