
Die Qwen4-Max API ist live auf QwenCloud als Pay-per-Token-Modell mit der ID qwen4-max. Erstellen Sie in Ihrer Region einen Pay-as-you-go-Schlüssel, richten Sie das OpenAI SDK auf https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1 (Singapur) und rufen Sie das Modell auf. Es kostet 1,50 $ pro Million Input-Tokens und 4,50 $ pro Million Output-Tokens, mit einem Kontext von 1M Tokens.
Dieser Leitfaden behandelt den API-Schlüssel, Base-URLs, Thinking, Vision, Tools, strukturierte Ausgaben, Caching, den Anthropic-Weg, Limits und Fehler. Alle Snippets folgen der QwenCloud-Dokumentation, Stand 16. November 2026.
Hintergrundinformationen finden Sie in unserem Artikel Was ist Qwen4-Max. Für den Zugriff per statt Pay-per-Token lesen Sie alle Möglichkeiten, Qwen4-Max zu nutzen sowie den Token-Plan-Leitfaden.
Was die Qwen4-Max API bietet
Die Qwen4-Max API ist Alibabas Flaggschiff-Modell, bereitgestellt über QwenCloud mit OpenAI-kompatiblen, Anthropic-kompatiblen und DashScope-Endpunkten. Sie nimmt Text-, Bild- und Video-Eingaben entgegen, gibt Text zurück, denkt standardmäßig vor der Antwort und unterstützt Function Calling, strukturierte Ausgaben, Kontext-Caching, Batch-Jobs, Websuche und Fine-Tuning.
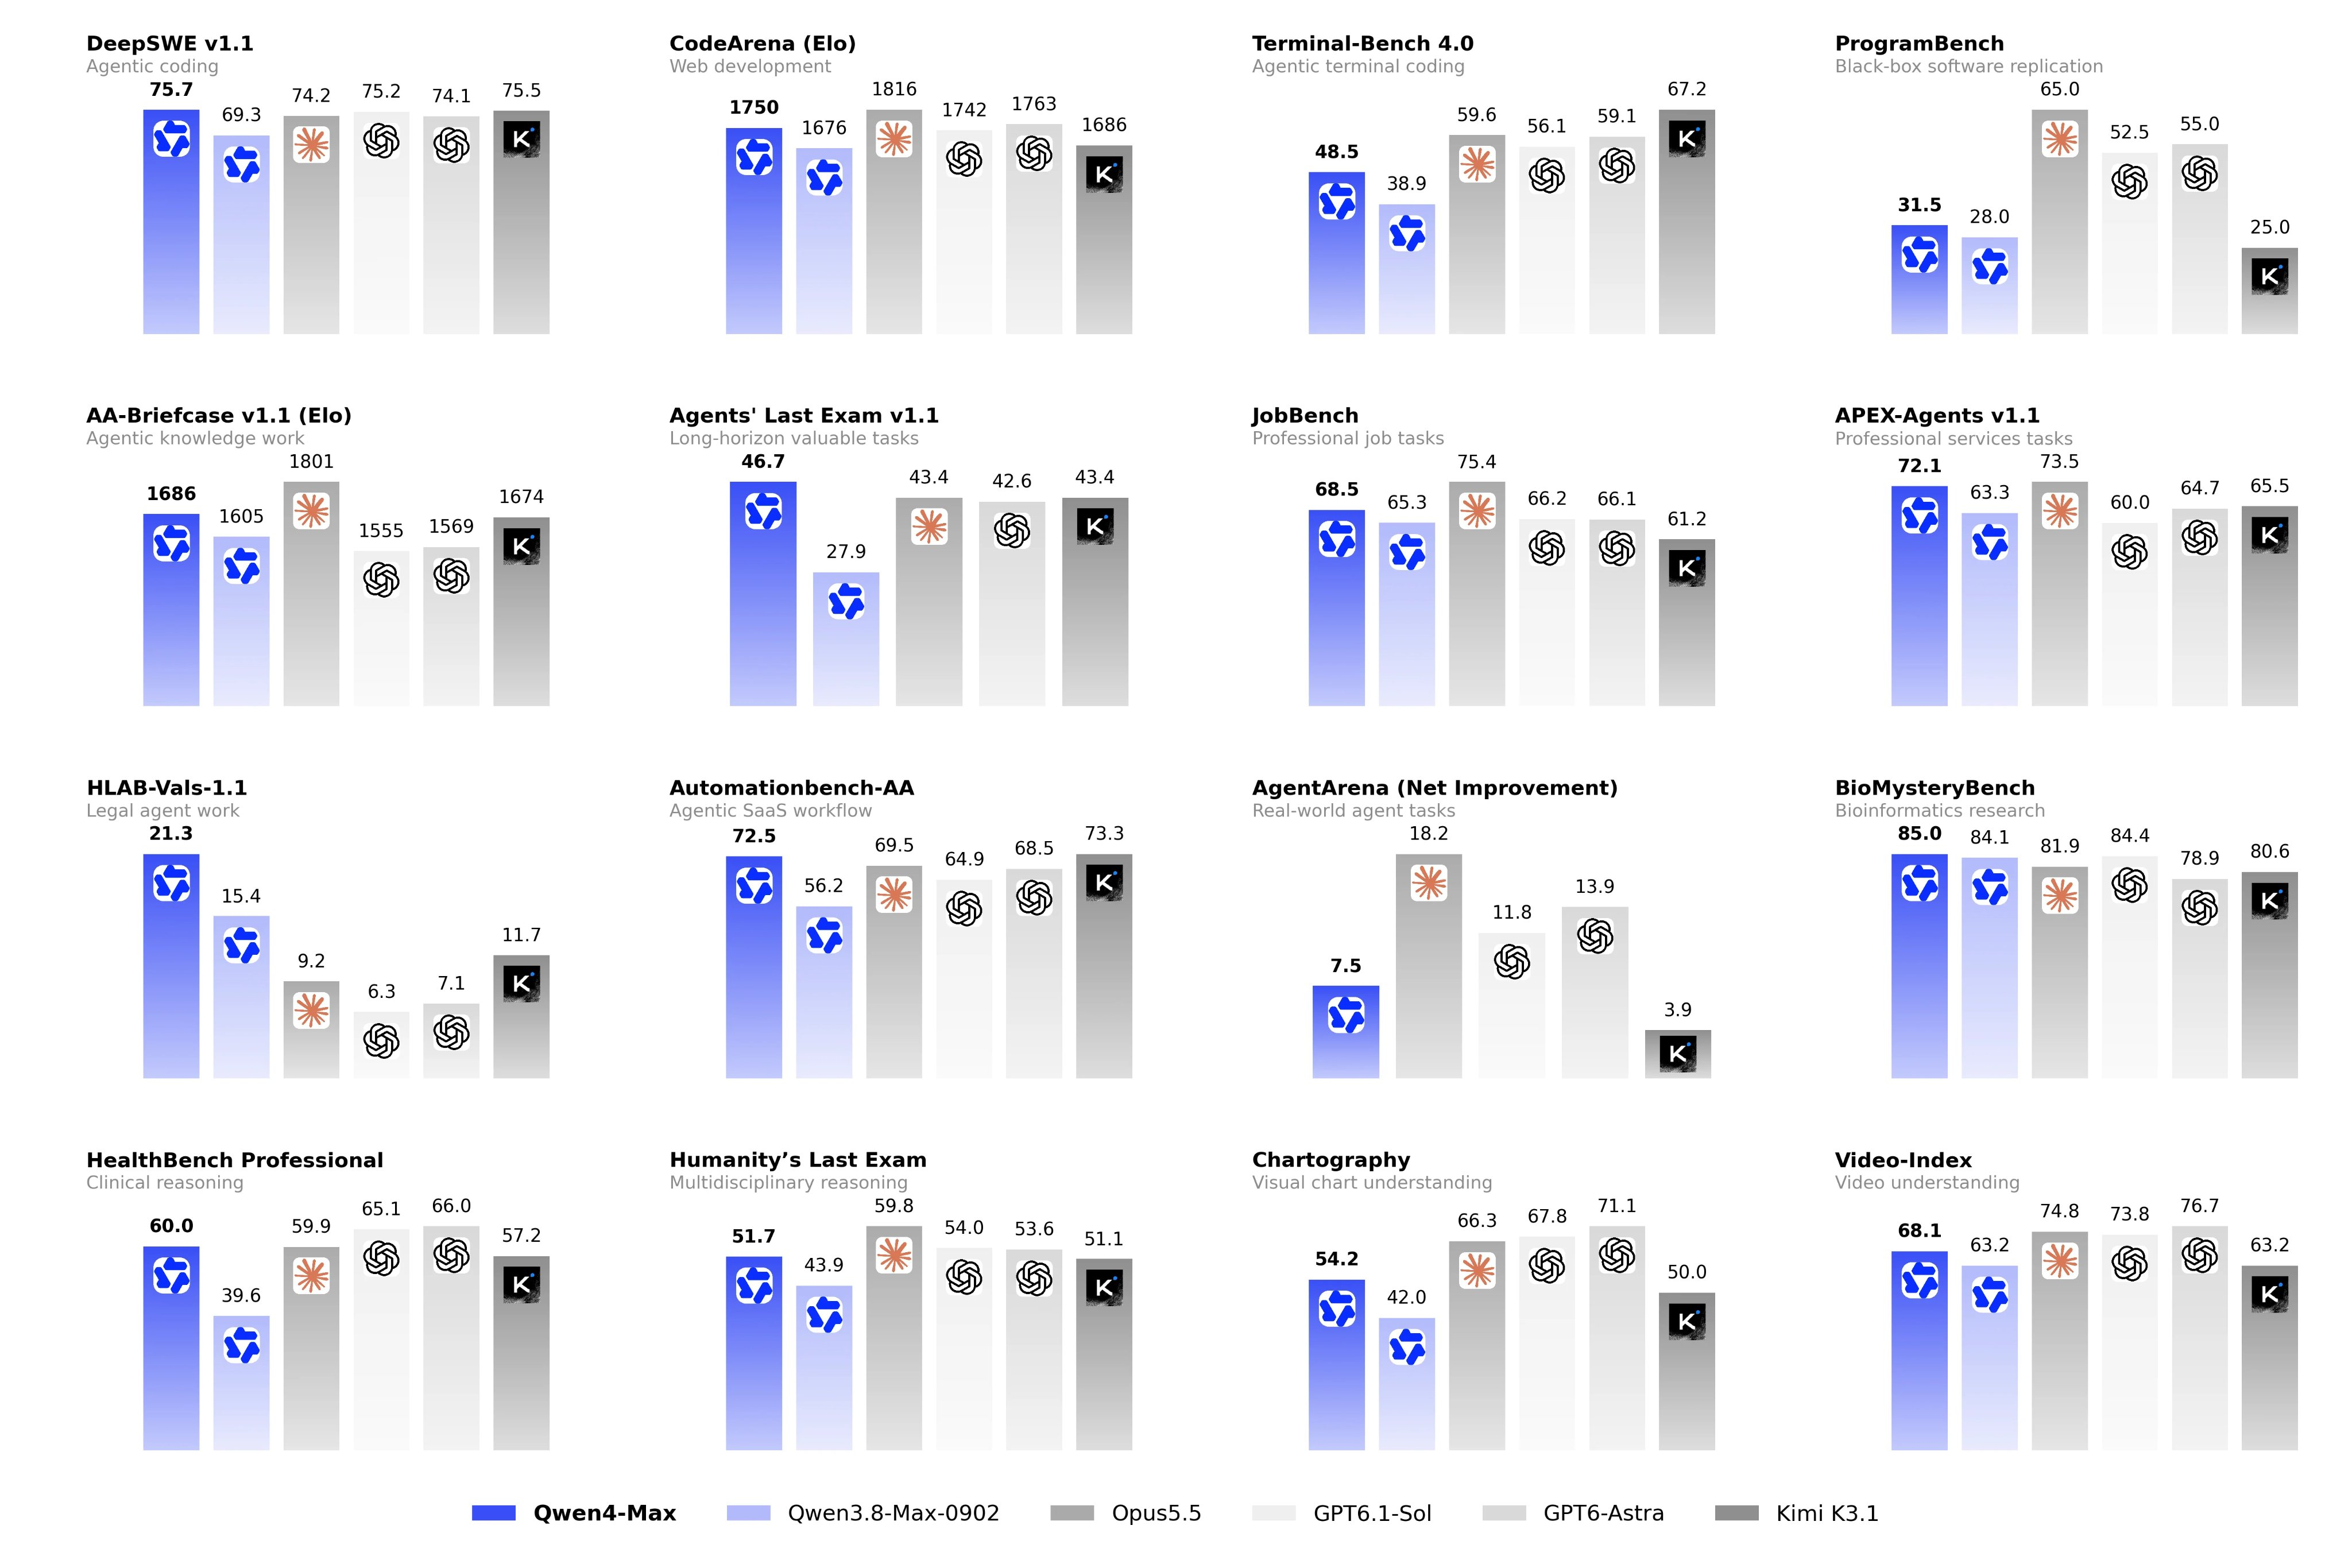
Hier sind die Zahlen von der qwen4-max-Modellseite:
| Posten | Wert |
|---|---|
| Modell-ID | qwen4-max |
| Input-Preis | 1,50 $ pro 1M Tokens |
| Output-Preis | 4,50 $ pro 1M Tokens |
| Impliziter Cache-Input / explizites Cache-Lesen | 0,075 $ pro 1M Tokens |
| Explizite Cache-Erstellung | 1,875 $ (5 Minuten) oder 3 $ (1 Stunde) pro 1M Tokens |
| Kontextfenster | 1M Tokens |
| Max. Input | 991K (983K mit Thinking) |
| Max. Output | 393K |
| Max. Reasoning | 262K |
| Durchsatz | 5.000.000 TPM |
Thinking-Tokens werden als Output-Tokens abgerechnet. Eine vollständige Kostenaufschlüsselung finden Sie im Qwen4-Max-Preis-Leitfaden.
API-Schlüssel holen und die richtige Base-URL wählen
Schlüssel sind an eine Region gebunden, und der Schlüsseltyp muss zum Endpunkt passen.
- Öffnen Sie die QwenCloud-Konsole und wählen Sie eine Region im Auswahlmenü oben rechts.
- Gehen Sie zu API Keys, klicken Sie auf Create API key, fügen Sie eine Beschreibung hinzu und klicken Sie auf Generate Key.
- Kopieren Sie den Schlüssel sofort. Er wird nur einmal angezeigt. Neue Pay-as-you-go-Schlüssel beginnen mit
sk-ws-. - Exportieren Sie ihn:
export DASHSCOPE_API_KEY="sk-ws-...".
Jede Region verwendet die Domain {region}.maas.qwencloudapi.com. Singapur ist ap-southeast-1; Frankfurt ist eu-central-1, Tokio ist ap-northeast-1 und USA (Virginia) ist us-east-1. Hängen Sie dann den Protokollpfad an:
| Protokoll | Base-URL (Singapur) |
|---|---|
| OpenAI-kompatibel (Chat Completions, Responses) | https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1 |
| Anthropic-kompatibel | https://ap-southeast-1.maas.qwencloudapi.com/apps/anthropic |
| DashScope HTTP | https://ap-southeast-1.maas.qwencloudapi.com/api/v1 |
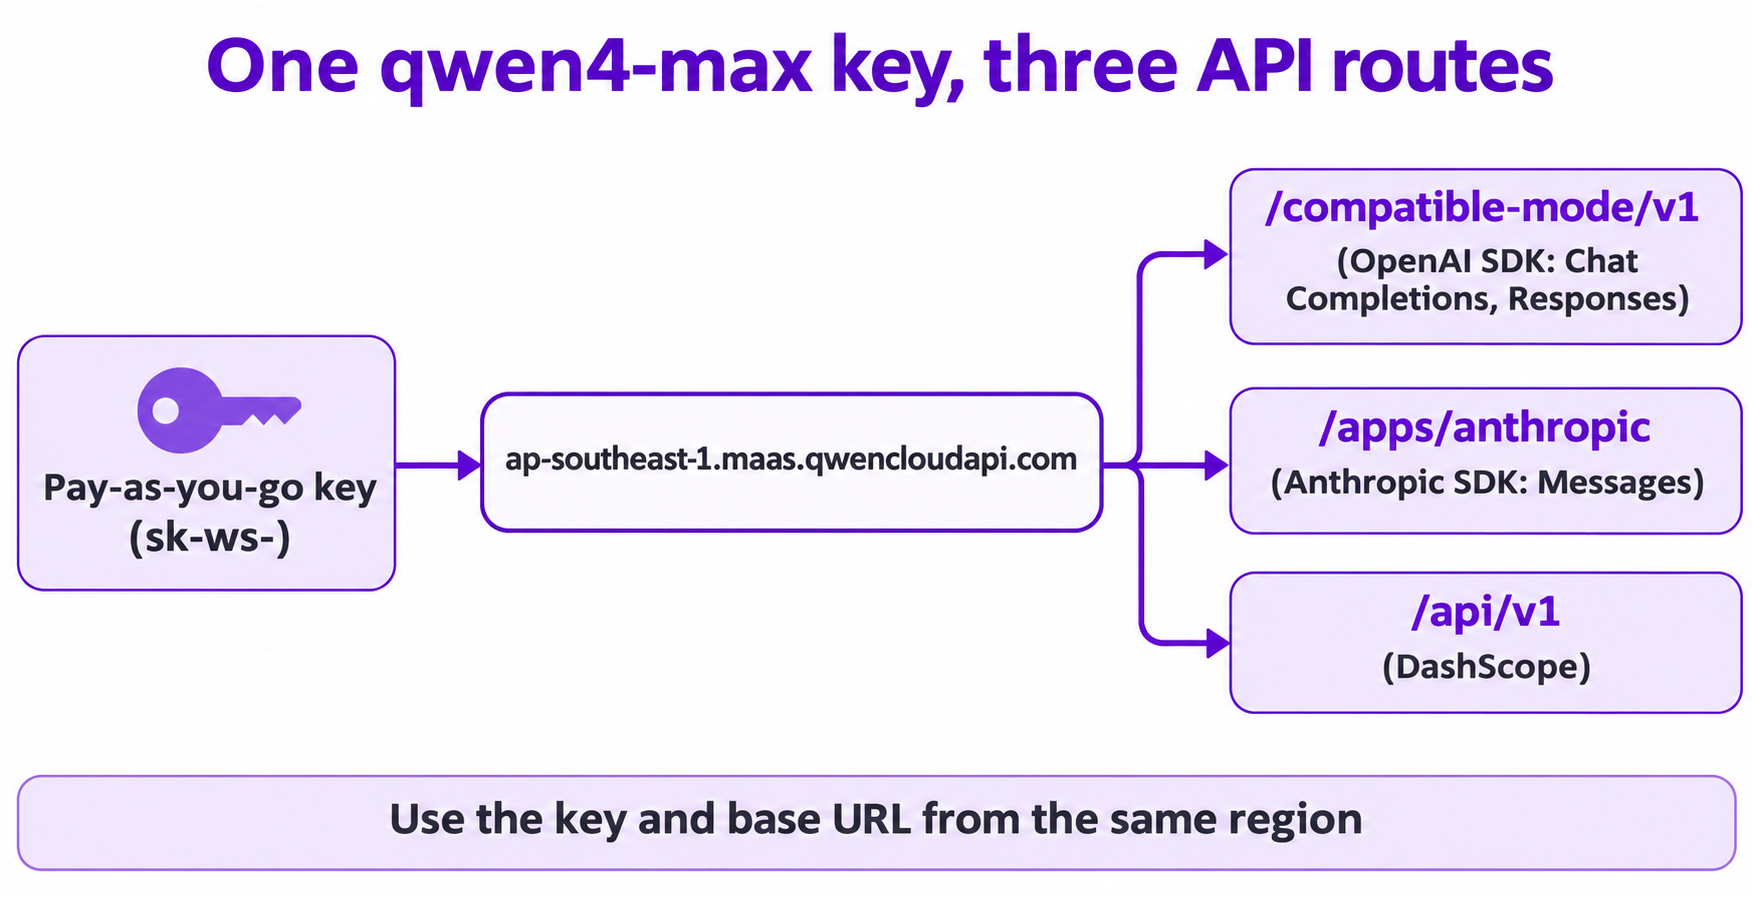
Ein Token-Plan-Schlüssel (sk-sp-) funktioniert nur auf token-plan.maas.qwencloudapi.com, und ein Pay-as-you-go-Schlüssel nur auf der Domain seiner eigenen Region. Eine Mischung führt zu einem 401-Fehler. Siehe Regionen und Endpunkte.
Ihr erster Qwen4-Max-API-Aufruf
Installieren Sie das OpenAI SDK (pip install openai) und führen Sie das Quickstart-Beispiel aus der Dokumentation aus:
import os
from openai import OpenAI

client = OpenAI(
  api_key=os.getenv("DASHSCOPE_API_KEY"),
  base_url="https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1"
)
completion = client.chat.completions.create(
  model="qwen4-max",
  messages=[{"role": "user", "content": "Summarize the benefits of solar energy in three bullet points."}]
)
print(completion.choices[0].message.content)
Thinking ist für qwen4-max standardmäßig aktiviert, daher verbraucht dieser Aufruf auch Reasoning-Tokens. Bei langen Prompts sollten Sie Streaming verwenden oder ein Client-Timeout von 180 Sekunden oder mehr setzen.
Thinking-Modus und Streaming von reasoning_content
Qwen4-Max ist ein hybrides Thinking-Modell. Die dokumentierten Standardwerte sind enable_thinking=true, reasoning_effort=high und thinking_budget=131072. Die Effort-Stufen sind low, high und xhigh; none schaltet Thinking aus.
Reasoning und Antwort als zwei Phasen streamen (angepasst vom Beispiel der Modellseite):
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1",
)
messages = [{"role": "user", "content": "Who are you"}]
completion = client.chat.completions.create(
    model="qwen4-max",
    messages=messages,
    extra_body={"enable_thinking": True},
    stream=True
)
for chunk in completion:
    if not chunk.choices:
        continue
    delta = chunk.choices[0].delta
    if getattr(delta, "reasoning_content", None):
        print(delta.reasoning_content, end="", flush=True)  # phase 1: thinking
    if delta.content:
        print(delta.content, end="", flush=True)            # phase 2: answer
Drei Regeln:
- Begrenzen Sie den Output mit
max_completion_tokens. Bei aktiviertem Thinking akzeptiertmax_tokensnur Werte von 1 bis 32.768 (sonst ein 400-Fehler).max_completion_tokensdeckt Reasoning plus Antwort ohne dieses Limit ab. - Steuern Sie die Tiefe mit
extra_body. Übergeben Sie{"enable_thinking": True, "reasoning_effort": "xhigh"}für schwierige Probleme oder"low"für einfache. - Bewahren Sie Reasoning in Mehrturn-Chatverläufen auf.
qwen4-maxhatpreserve_thinkingstandardmäßig aktiviert, senden Sie daher früheres Reasoning im Feldreasoning_contentjeder Assistant-Nachricht zurück, niemals innerhalb voncontent.
Um Thinking zu überspringen, übergeben Sie {"enable_thinking": False}.
Bild- und Video-Eingabe
Senden Sie Bilder als image_url-Teile und Videos als video_url-Teile. Dies entspricht dem Vision-Beispiel der Dokumentation mit dem Modell qwen4-max:
completion = client.chat.completions.create(
  model="qwen4-max",
  messages=[{
    "role": "user",
    "content": [
      {"type": "image_url", "image_url": {"url": "https://example.com/invoice.jpg"}},
      {"type": "text", "text": "Describe what you see in this image"},
    ],
  }],
)
Für Videos verwenden Sie {"type": "video_url", "video_url": {"url": "..."}, "fps": 2}. Lokale Dateien werden als Base64-Data-URIs übergeben.
Der Vision-Leitfaden erlaubt bis zu 2.048 URL-Bilder mit jeweils 20 MB, 250 Base64-Bilder und 64 MB pro Anfrage. Der Bilddetail-Grad ist standardmäßig „high“, was mehr Input-Tokens kostet.
Function Calling
Übergeben Sie ein tools-Array wie bei jedem OpenAI-kompatiblen Modell:
tools = [{
  "type": "function",
  "function": {
    "name": "get_current_weather",
    "description": "Useful when you want to check the weather for a specific city.",
    "parameters": {
      "type": "object",
      "properties": {"location": {"type": "string", "description": "City or county, such as Singapore or New York."}},
      "required": ["location"],
    },
  },
}]
completion = client.chat.completions.create(model="qwen4-max", messages=messages, tools=tools)
Lesen Sie message.tool_calls, führen Sie die Funktion aus, hängen Sie eine tool-Nachricht an und rufen Sie erneut auf.
Im Thinking-Modus akzeptiert tool_choice nur "auto" oder "none"; um eine Funktion zu erzwingen, deaktivieren Sie zuerst Thinking. Bei aktiviertem Thinking senden Sie reasoning_content mit den Tool-Ergebnissen zurück, sonst sinkt die Genauigkeit.
Strukturierte Ausgaben
qwen4-max unterstützt den strikten JSON-Schema-Modus:
completion = client.chat.completions.create(
  model="qwen4-max",
  messages=[{"role": "user", "content": "Extract the name and age: Ana is 31."}],
  response_format={
    "type": "json_schema",
    "json_schema": {
      "name": "user_info",
      "strict": True,
      "schema": {
        "type": "object",
        "properties": {"name": {"type": "string"}, "age": {"type": "integer"}},
        "required": ["name", "age"],
        "additionalProperties": False,
      },
    },
  },
)
Beim loseren Modus {"type": "json_object"} muss das Wort „JSON“ in einer Nachricht vorkommen, sonst weist die API die Anfrage zurück. Bild- oder Video-Eingabe fällt auf json_object zurück, daher wird das Schema bei multimodalen Aufrufen nicht erzwungen.
Kontext-Cache und Batch
Cache. Ohne Einstellungen gleicht der implizite Cache Präfixe ab, garantiert aber keine Treffer. Für deterministische Treffer verwenden Sie den Qwen4-Explicit-Cache: Markieren Sie einen Content-Block mit "prompt_cache_breakpoint": {"mode": "explicit"} (die Nachrichten-content muss ein Array sein) und setzen Sie die TTL mit extra_body={"prompt_cache_options": {"mode": "explicit", "ttl": "5m"}}. Die TTL ist 5m oder 1h, und der gecachte Präfix benötigt mindestens 1.024 Tokens. Lesezugriffe kosten 0,075 $ pro Million Tokens, 95 % weniger als frischer Input.
Batch. Der Batch-Leitfaden rechnet Input und Output mit 50 % des Echtzeitpreises ab und liefert Ergebnisse innerhalb von 24 Stunden. Für qwen4-max läuft Batch File in einer Region außerhalb Singapurs und unterstützt kein Kontext-Caching, prüfen Sie daher den Batch-Leitfaden, bevor Sie eine Pipeline darauf aufbauen.
Der Anthropic-kompatible Weg
Bereits auf dem Anthropic SDK aufgebaut? Ändern Sie einfach Base-URL und Schlüssel:
import anthropic
import os

client = anthropic.Anthropic(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://ap-southeast-1.maas.qwencloudapi.com/apps/anthropic",
)
message = client.messages.create(
    model="qwen4-max",
    max_tokens=1024,
    messages=[{"role": "user", "content": "Who are you?"}],
    thinking={"type": "disabled"},
)
print(message.content)
Dieses Beispiel schaltet Thinking aus, ebenso wie das Beispiel der Dokumentation. Beenden Sie die Base-URL bei /apps/anthropic. Ein angehängtes /v1/ erzeugt /v1/v1/... und einen 404-Fehler. Auch hier ist Thinking standardmäßig aktiviert, und bei aktiviertem Thinking muss max_tokens größer als das Thinking-Budget sein. Der Effort wird über output_config.effort gesteuert (low, high, xhigh), und die integrierten Tools web_search und web_fetch sind auf diesem Weg verfügbar.
Qwen4-Max API: Rate Limits
Aus der Rate-Limits-Seite:
| Region | RPM | TPM |
|---|---|---|
| Singapur | Dynamisch | Dynamische Stufen: 5M, 10M, 20M |
| Frankfurt, Tokio, USA (Virginia) und andere Regionen im Global-Scope | 30.000 | 5.000.000 |
Die Limits gelten pro Konto und Region sowie pro Sekunde (RPS = RPM / 60), daher kann eine Lastspitze Sie auch unterhalb des Minutenlimits drosseln.
Die Free-Quota-Seite besagt, dass das kostenlose Kontingent nur in Singapur existiert, pro Modell gilt (typischerweise 1.000.000 Tokens), 90 Tage dauert und hinterlegte Zahlungsinformationen erfordert. qwen4-max wird dort nicht namentlich genannt, prüfen Sie daher die Free-Tier-Seite in der Konsole oder lesen Sie wie Sie Qwen4-Max kostenlos nutzen.
Häufige Fehler der Qwen4-Max API
| Code | Bedeutung | Lösung |
|---|---|---|
401 InvalidApiKey |
Schlüssel und Base-URL stammen aus unterschiedlichen Regionen, oder ein Token-Plan-Schlüssel hat einen Pay-as-you-go-Endpunkt erreicht | Verwenden Sie einen Schlüssel, der in derselben Region wie die URL erstellt wurde |
400 InvalidParameter |
Häufig max_tokens außerhalb von 1 bis 32.768 bei aktiviertem Thinking |
Wechseln Sie zu max_completion_tokens |
403 AllocationQuota.FreeTierOnly |
Kostenloses Kontingent aufgebraucht, bevor Zahlungsinformationen hinterlegt wurden | Hinterlegen Sie Zahlungsinformationen auf der Free-Tier-Seite |
404 ModelNotFound |
qwen4-max wird in der aufgerufenen Region nicht angeboten |
Prüfen Sie die Modellpreise für diese Region |
429 Throttling |
RPM- oder TPM-Limit erreicht | Warten Sie und versuchen Sie es erneut, oder verteilen Sie die Last über mehrere Sekunden |
Lassen Sie Ihren Coding-Agent die Qwen4-Max API mit Apidog CLI testen
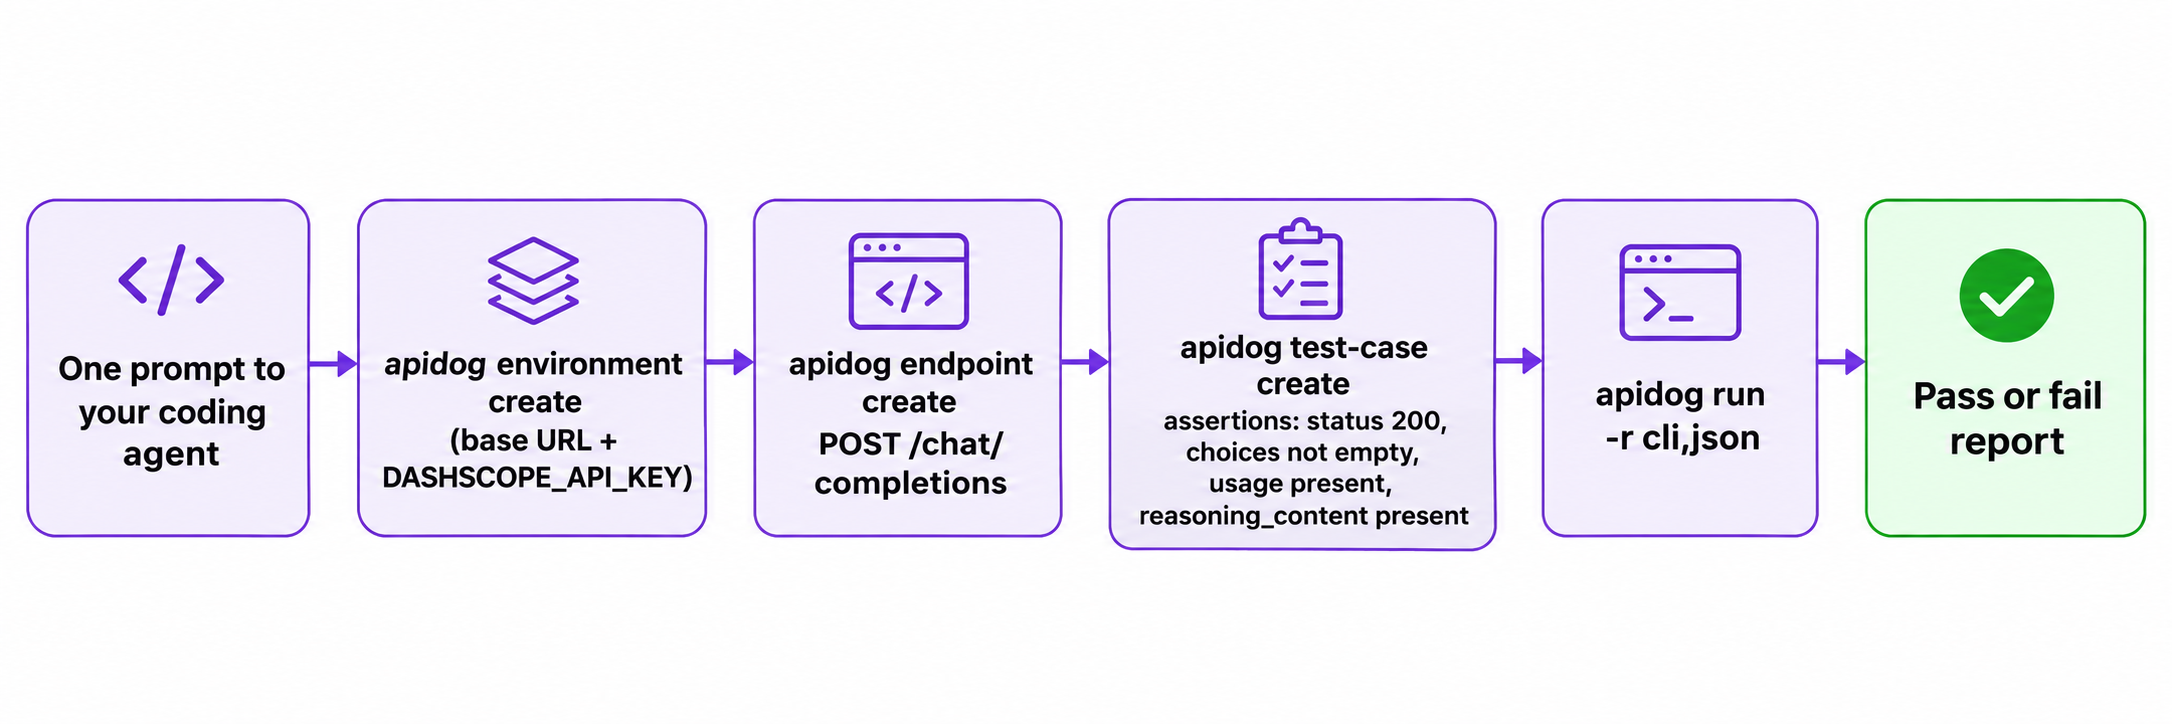
Ihr Coding-Agent schreibt die Integration, also lassen Sie ihn auch den Regressionstest schreiben. Mit der Apidog CLI kann er den Endpunkt speichern, den Schlüssel hinterlegen und Assertions ausführen.
Richten Sie es einmalig ein:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Geben Sie Ihrem Agent dann einen Prompt:
In Apidog project <projectId>, create an environment "Qwen Singapore" with base URL
https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1 and a secret
variable DASHSCOPE_API_KEY. Add POST /chat/completions with a Bearer auth header,
model qwen4-max and enable_thinking true. Create a test case asserting status 200,
a non-empty choices array, a usage object, and reasoning_content present on the
first choice's message. Run it and summarize any failures.
Der Agent liest jedes Payload-Schema, bevor er schreibt, und führt dann den Testfall aus:
apidog environment create "Qwen Singapore" --project <projectId> --base-url https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1
apidog cli-schema get environment-update
apidog environment update <envId> --project <projectId> --file env.json
apidog cli-schema get endpoint-create
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
Der cli-Reporter gibt Pass oder Fail aus; json schreibt einen Bericht, den der Agent liest. Verschieben Sie denselben apidog run ... -r junit-Befehl mit dem Apidog-CLI-CI/CD-Leitfaden in Ihre CI, und finden Sie in Apidog CLI in Claude Code weitere Prompts. Apidogs Free-Plan deckt bis zu 4 Nutzer ab.
FAQ
Wie lautet die Modell-ID der Qwen4-Max API?
Die stabile ID ist qwen4-max. Die frühere ID qwen4-max-preview galt nur für den Token Plan während der Preview, die am 11. November 2026 begann.
Ist die Qwen4-Max API OpenAI-kompatibel?
Ja. Verwenden Sie das OpenAI SDK mit der Base-URL /compatible-mode/v1 für Chat Completions und die Responses API. Ein Anthropic-kompatibler Endpunkt und die DashScope API sind ebenfalls verfügbar.
Wie deaktiviere ich Thinking in der Qwen4-Max API?
Übergeben Sie extra_body={"enable_thinking": False}. Sie verlieren reasoning_content, aber Latenz und Output-Tokens sinken. Modelle vergleichen? Lesen Sie Qwen4-Max vs. Qwen3.8.
Wie viel kostet die Qwen4-Max API?
1,50 $ pro Million Input-Tokens und 4,50 $ pro Million Output-Tokens, mit gecachten Lesezugriffen zu 0,075 $ pro Million.
Kann ich meinen Token-Plan-Schlüssel mit der Pay-per-Token-API verwenden?
Nein. Token-Plan-Schlüssel (sk-sp-) funktionieren nur auf token-plan.maas.qwencloudapi.com, und Pay-as-you-go-Schlüssel nur auf der Domain ihrer eigenen Region.