
Alibaba hat Qwen 3.8-Max Anfang August 2026 veröffentlicht, und wenn Sie bereits qwen3.7-max in der Produktion einsetzen, müssen Sie eine echte Entscheidung treffen. Das neue Modell erzielt große Gewinne bei agentischen und Forschungs-Benchmarks, fügt Bildeingabe hinzu, kommt zu einem niedrigeren Listenpreis auf den Markt und wird mit einem Versprechen geliefert, das Alibaba für seinen Vorgänger nie gemacht hat: offene Gewichte.
Aber die Entscheidung ist nicht so einfach wie „neues Modell gewinnt“. Qwen 3.7-Max läuft derzeit mit einem zeitlich begrenzten Rabatt von 50 %, der es absolut gesehen billiger macht als 3.8-Max. Einige Benchmark-Deltas sind dramatisch. Andere sind praktisch null. Dieser Artikel geht alle wichtigen Änderungen durch, damit Sie entscheiden können, ob Sie jetzt wechseln, warten oder ganz eine Stufe tiefer gehen.
Wenn Sie zuerst das vollständige Bild des neuen Modells wünschen, beginnen Sie mit unserer Qwen 3.8-Max Erklärung. Für Hintergrundinformationen zum Vorgängermodell siehe was Qwen 3.7 zu bieten hatte.
Ein Hinweis zur Methodik vor den Zahlen. Jede Benchmark-Zahl unten stammt aus Alibabas eigener Tabelle im offiziellen Qwen 3.8 Release-Post. Das ist hier tatsächlich nützlich: Beide Modelle wurden im selben Anbieter-Run evaluiert, sodass die Deltas intern konsistent sind, auch wenn eine unabhängige Verifizierung noch aussteht. Die meisten Coding-Zeilen wurden auf dem Claude Code-Harness ausgeführt, und mehrere Benchmarks sind Qwen-interne Benchmarks.
Die Kurzfassung
| Was sich geändert hat | Qwen 3.7-Max | Qwen 3.8-Max |
|---|---|---|
| Terminal Bench 2.1 | 74.5 | 86.6 |
| SWE-bench Pro | 60.6 | 67.7 |
| PaperBench | 64.8 | 93.0 |
| IFBench | 79.1 | 82.8 |
| GPQA Diamond | 92.4 | 92.6 |
| HLE | 41.4 | 43.6 |
| Listenpreis (pro 1M Tokens) | $2.5 In / $7.5 Out | $2 In / $6 Out |
| Aktueller Preis (Promo) | $1.25 In / $3.75 Out | $2 In / $6 Out |
| Bildeingabe | Nein | Ja |
| Offengelegte Architektur | Nicht offengelegt | Insgesamt 2.4T, 95B aktive MoE |
| Offene Gewichte | Nie veröffentlicht | Versprochen „nächste Woche“ (~10. August) |
| Kontextfenster | 1M Tokens | 1M Tokens |
Nun zu den Details.
Benchmark-Deltas: Wo der Sprung real ist
Die größten Verbesserungen konzentrieren sich auf agentische Arbeiten: langwierige Aufgaben, bei denen das Modell plant, ausführt und sich selbst korrigiert.
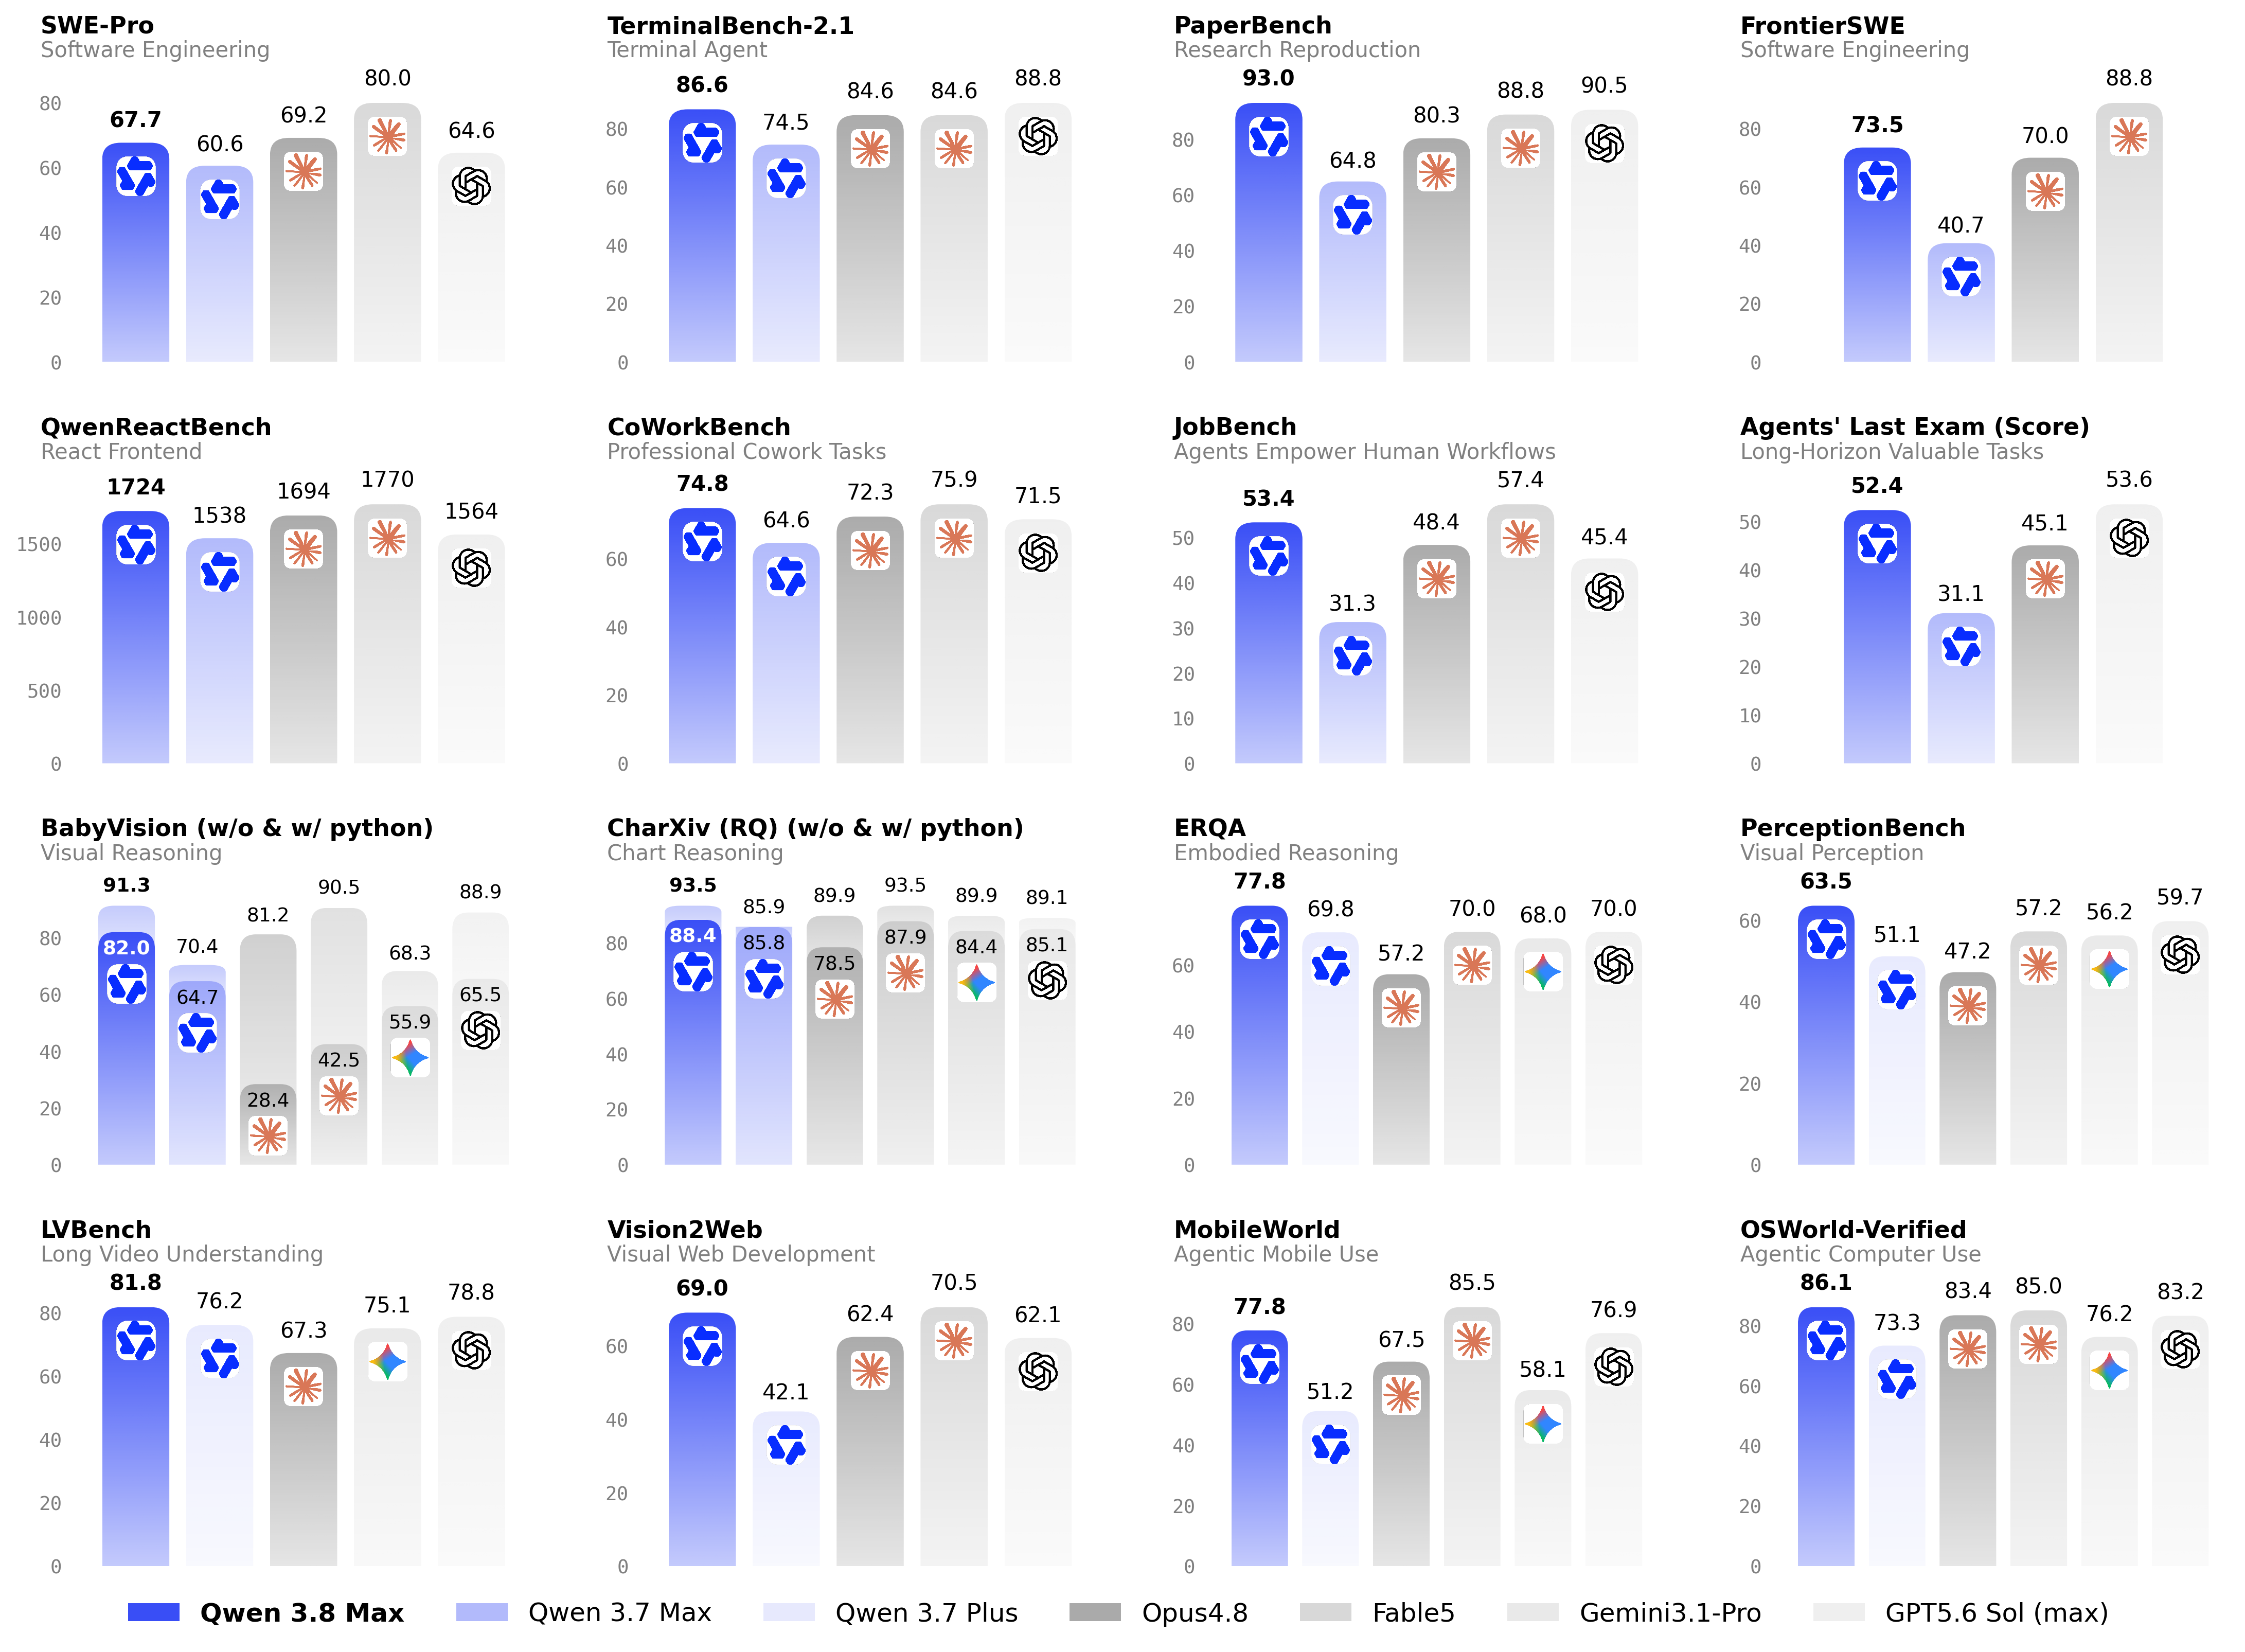
Terminal Bench 2.1: 74.5 auf 86.6. Dies ist ein Sprung von 12 Punkten bei terminalgesteuerten agentischen Aufgaben, und er bringt Qwen von deutlich zurückliegend zu wirklich wettbewerbsfähig. In derselben Tabelle erzielt Alibaba für Claude Opus 4.8 und Fable 5 jeweils 84.6 Punkte, was 3.8-Max in dieser Zeile vor beide Modelle stellt. GPT-5.6 Sol führt weiterhin mit 88.8.
SWE-bench Pro: 60.6 auf 67.7. Ein Gewinn von 7 Punkten bei realen Software-Engineering-Aufgaben. Bedeutsam, aber bleiben wir ehrlich: Fable 5 liegt in derselben Tabelle bei 80.0, es ist also ein Aufholen, kein Überholen. Wenn die SWE-bench Pro-Leistung Ihr primäres Kaufkriterium ist, liegt die Grenze immer noch woanders.
PaperBench: 64.8 auf 93.0. Das größte Einzeldelta in der Tabelle, ein Sprung von 28 Punkten bei der Reproduktion von KI-Forschungspapieren. Es ist auch die beste Flaggschiff-Zeile von 3.8-Max, vor jedem Rivalen in Alibabas Vergleich. Wenn Ihre Arbeitslast die Reproduktion von Forschungsergebnissen, lange technische Dokumente oder mehrstufige wissenschaftliche Argumentation beinhaltet, ist dies die Zahl, die Ihre Aufmerksamkeit erregen sollte.
IFBench: 79.1 auf 82.8. Die Befolgung von Anweisungen verbessert sich um fast 4 Punkte. Bemerkenswert ist, dass 3.7-Max hier bereits stark war (79.1 übertraf Opus 4.8 und Fable 5 im selben Lauf), so dass dies einen bestehenden Vorsprung ausbaut, anstatt eine Schwäche zu beheben.
GPQA Diamond: 92.4 auf 92.6. Praktisch unverändert. Wissenschaftliche QA auf Graduiertenniveau war für 3.7-Max bereits nahezu gesättigt, und das neue Modell bewegt es nicht. Wenn Ihre Arbeitslast wie GPQA aussieht, bringt Ihnen das Upgrade qualitativ nichts.
HLE: 41.4 auf 43.6. Humanity’s Last Exam verbessert sich um 2 Punkte, liegt aber immer noch hinter der Spitze: Fable 5 erreicht 53.3 und GPT-5.6 Sol 47.2 in derselben Tabelle. Qwen 3.8-Max schließt Lücken an vielen Stellen. Dies ist keine davon.
Das Muster: massive Gewinne bei agentischen und Forschungs-Benchmarks, inkrementelle Gewinne bei der Anweisungsbefolgung, keine Bewegung bei gesättigten Wissens-Benchmarks und eine anhaltende Lücke bei den schwierigsten Schlussfolgerungs-Evals. Für eine detailliertere Darstellung der vollständigen Tabelle, einschließlich des Kleingedruckten zu Harnesses und internen Benchmarks, siehe unseren Qwen 3.8 Benchmarks Breakdown.
Architektur: Alibaba zeigt endlich seine Zahlen
Qwen 3.8-Max ist ein Mixture-of-Experts-Modell mit 2.4 Billionen Parametern und 95 Milliarden aktiven Parametern pro Forward-Pass, das auf der Qwen 3.5-Architektur basiert. Das ist ungefähr ein Aktivierungsverhältnis von 4 %, was für die Bereitstellungskosten wichtig ist: Sie zahlen Rechenleistung für 95B, nicht für 2.4T.
Der Kontrast zu 3.7-Max ist die Offenlegung selbst. Alibaba hat nie vergleichbare Größenordnungsangaben für Qwen 3.7-Max veröffentlicht. Parameteranzahl, Aktivierungsverhältnisse, Expert-Konfiguration: alles nicht offengelegt. Bei 3.8-Max geben die Model Studio-Modelldokumentation und der Release-Post die Architektur an, was die Kapazitätsplanung und Kostenmodellierung wesentlich weniger zu einem Ratespiel macht.
Zum Kontext im Open-Weights-Rennen: Kimi K3 läuft mit insgesamt 2.8T und 104B aktiven. Qwen 3.8-Max ist in beiden Achsen kleiner.
Multimodal: die Funktion, die 3.7-Max nie hatte
Qwen 3.7-Max ist ein Textmodell. Qwen 3.8-Max akzeptiert Bildeingaben nativ, und Alibaba veröffentlichte eine separate multimodale Benchmark-Tabelle, in der es die meisten Reihen gegen Gemini 3.1 Pro und GPT-5.6 Sol anführt.
Die herausragenden Werte aus Alibabas multimodaler Tabelle: MathVision mit 95.2, LogicVista mit 91.9 und OSWorld-Verified mit 86.1 für Computer-Nutzungsaufgaben. Es gibt keine 3.7-Max-Spalte in dieser Tabelle zum Vergleich, weil es sie nicht geben konnte: Das ältere Modell akzeptiert keine Bilder.
Praktisch bedeutet dies, dass Arbeitslasten, die Sie zuvor an ein separates Vision-Modell weiterleiten mussten (Screenshot-Verständnis, Dokumentenbilder, UI-Automatisierung, Diagrammextraktion), jetzt mit derselben Modell-ID wie Ihr Textverkehr ausgeführt werden können. Der Release-Post demonstriert auch das Verständnis langer Dokumente und Videos, obwohl dies eher blog-demonstrierte Fähigkeiten als eigenständige API-Eingabetypen sind. Überprüfen Sie daher die API-Dokumentation für Ihren spezifischen Fall.
Preise: Das neue Modell ist günstiger, außer im Moment
Hier wird die Upgrade-Mathematik interessant.
Qwen 3.8-Max startet mit $2 Eingabe / $6 Ausgabe pro 1M Tokens, einer einzigen Pauschalstufe über den gesamten 1M Kontext. Qwen 3.7-Max kostet $2.5 / $7.5. Das neue, leistungsfähigere Modell unterbietet also den Listenpreis seines Vorgängers um 20%. Das passiert bei einem Flaggschiff-Generationswechsel fast nie.
Aber es gibt einen Haken: Alibaba bietet derzeit eine zeitlich begrenzte 50%ige Aktion für 3.7-Max an, die den effektiven Preis auf $1.25 / $3.75 senkt. Zu den heutigen Preisen kostet das ältere Modell 38% weniger als das neue. Alle Preise finden Sie auf der offiziellen Model Studio-Preisseite.
Zwei Dinge sind zu beachten:
- Die Aktion kann enden. Alibaba kennzeichnet sie als zeitlich begrenzt und hat kein Enddatum veröffentlicht. Wenn Sie mit $1.25 / $3.75 planen, hat Ihre Budgetannahme ein Ablaufdatum, das Sie nicht sehen können. Zu Listenpreisen ist 3.8-Max das günstigere Modell.
- Denkende Token blähen die tatsächlichen Rechnungen auf. Qwen 3.8-Max verwendet standardmäßig
reasoning_effort: xhigh, und denkende Token werden als Ausgabe abgerechnet. Ihre effektiven Kosten pro Anfrage können deutlich über dem liegen, was der Aufkleber suggeriert. Unser Qwen 3.8 Preisleitfaden erläutert die Cache-Ökonomie und die Kosten pro Aufgabe.
Und wenn keines der Max-Modelle Ihr Budget sprengt, bleibt qwen3.7-plus mit 0.4 $ / 1.6 $ (derzeit 20 % Rabatt) die preisgünstige Variante. Der Plus vs. Max Vergleich zeigt, wann Plus ausreicht.
Offene Gewichte: Eine Premiere für die Max-Klasse
Kein Qwen-Max-Klasse-Modell hat jemals offene Gewichte ausgeliefert. Qwen 3.7-Max tat dies nicht, und Alibaba deutete dies auch nie an. Qwen 3.8-Max durchbricht dieses Muster: Der Release-Post verspricht Gewichte auf Hugging Face und ModelScope "nächste Woche", was ungefähr auf den 10. August hindeutet.
Zum Zeitpunkt dieses Schreibens (3. August 2026) sind die Gewichte noch nicht herunterladbar. Betrachten Sie das Versprechen als Versprechen. Der Präzedenzfall ist ermutigend: Kimis K3-Gewichte kamen 11 Tage nach dem Start, und Alibaba hat eine lange Erfolgsgeschichte mit offenen Gewichten bei kleineren Qwen-Modellen. Aber ein Download von 2.4T Parametern ist selbst quantisiert ein Multi-Node-Self-Hosting-Projekt, so dass für die meisten Teams die praktischen Auswirkungen ein von Drittanbietern gehosteter Zugriff und Preisdruck sein werden, nicht ein Modell, das in Ihrem Rack läuft.
Wenn offene Gewichte für Ihre Beschaffungs- oder Compliance-Strategie wichtig sind, kann allein das die Frage 3.7 vs. 3.8 klären. Ein Modell wird sie (wahrscheinlich) haben. Das andere niemals.
Was sich nicht geändert hat
Es ist wichtig, es klar zu sagen, denn Upgrade-Posts neigen dazu, zu übertreiben:
- Kontextfenster: 1M Token bei beiden. Keine Erweiterung. Wenn Sie 3.7-Max für einen langen Kontext gewählt haben, hält 3.8-Max die Linie bei den gleichen 1M mit einem Pauschalpreis über das gesamte Fenster.
- Zugriffspfad: gleich. Beide Modelle werden über Alibaba Cloud Model Studio mit OpenAI-kompatiblen Endpunkten bereitgestellt. Der Wechsel ist eine Änderung der Modell-ID (
qwen3.7-maxzuqwen3.8-max), kein Migrationsprojekt. 3.8-Max fügt zusätzlich eine Anthropic-kompatible API-Oberfläche hinzu, die sich in einem Client wie Apidog gut nutzen lässt, wenn Ihre Tools dieses Protokoll sprechen. - Reasoning-Kontrollen: jetzt offiziell.
reasoning_effortist ein dokumentierter, unterstützter Parameter bei 3.8-Max mit drei Stufen (standardmäßig xhigh, medium, low), zusammen mitenable_thinkingundpreserve_thinking. Wenn Sie Prompts um implizites Reasoning-Verhalten bei 3.7-Max optimiert haben, erhalten Sie jetzt stattdessen einen expliziten Regler.
Sollten Sie ein Upgrade durchführen? Drei ehrliche Wege
Führen Sie ein sofortiges Upgrade durch, wenn Ihre Arbeitslast agentenbasiert oder forschungsintensiv ist. Die Deltas bei Terminal Bench (74.5 auf 86.6) und PaperBench (64.8 auf 93.0) sind die Art von Sprung, die Sie in der Produktion spüren können, und Sie erhalten Bildeingabe sowie den niedrigeren Listenpreis als Bonus. Wenn Sie Agenten erstellen, die Terminals bedienen, technische Arbeiten reproduzieren oder Screenshots verarbeiten, ist der Fall klar.
Nutzen Sie die 3.7-Max-Aktion, wenn Ihre Arbeitslast in den stabilen Bereichen liegt. Aufgaben im GPQA-Stil haben sich um 0.2 Punkte bewegt. Wenn Ihr Traffic aus Q&A, Zusammenfassungen oder allgemeinem Chat besteht und 3.7-Max bereits Ihre Qualitätsanforderungen erfüllt, ist $1.25 / $3.75 das beste Token-Angebot, das ein Max-Modell je geboten hat. Stellen Sie eine Kalendererinnerung ein, um den Aktionsstatus monatlich zu überprüfen, und wissen Sie, dass Ihr Fallback-Preis 3.8-Max mit $2 / $6 ist, nicht 3.7-Max zum Listenpreis.
Wechseln Sie zu qwen3.7-plus, wenn Sie preissensibel sind und Ihre Aufgaben routinemäßig sind. Mit $0.4 / $1.6 ist es 5x billiger als 3.8-Max bei der Eingabe, und für Klassifizierung, Extraktion und Vorlagengenerierung ist die Max-Klasse-Fähigkeit oft unnötiger Aufwand.
Testen Sie den Wechsel, bevor Sie sich verpflichten
Anbieter-Benchmarks, selbst intern konsistente, sagen nicht voraus, wie ein Modell auf Ihre Prompts reagiert. Der einfache Weg, dies zu klären, ist ein Side-by-Side-Vergleich mit Ihrer tatsächlichen Arbeitslast.
In Apidog können Sie dies in wenigen Minuten einrichten: Verweisen Sie eine Sammlung auf den OpenAI-kompatiblen Endpunkt von Model Studio und erstellen Sie dann zwei Umgebungen, die sich nur in der Modell-ID-Variable unterscheiden, eine auf qwen3.7-max und eine auf qwen3.8-max eingestellt. Führen Sie dieselbe Anfrage-Set für beide aus, wechseln Sie mit einem Klick die Umgebungen und vergleichen Sie Ausgaben, Latenz und Token-Nutzung im Antwort-Viewer. Da beide Modelle dieselbe API-Oberfläche nutzen, deckt eine einzige Sammlung beide ab, und Sie können repräsentative Produktions-Prompts als Testszenarien speichern und sie immer wieder ausführen, wenn Alibaba ein Update herausbringt oder die Aktionspreise sich ändern.
Das verwandelt "sollen wir upgraden?" von einer Benchmark-Debatte in einen Nachmittag voller Beweise. Laden Sie Apidog kostenlos herunter und führen Sie den Vergleich mit Ihrem eigenen Traffic durch, bevor Sie eine Produktionskonfiguration ändern.
FAQ
Ist Qwen 3.8-Max günstiger als Qwen 3.7-Max?
Zum Listenpreis ja: 2 $ / 6 $ gegenüber 2.5 $ / 7.5 $ pro 1M Tokens. Zu den tatsächlichen Preisen heute nein: Die zeitlich begrenzte 50%-Aktion für 3.7-Max bringt es auf 1.25 $ / 3.75 $, was 3.8-Max um 38% unterbietet. Die Aktion hat kein veröffentlichtes Enddatum. Eine vollständige Kostenaufschlüsselung finden Sie in unserem Qwen 3.8 Preisleitfaden.
Muss ich meinen Code ändern, um von qwen3.7-max auf qwen3.8-max zu wechseln?
Für die grundlegende Nutzung nicht. Beide Modelle werden über dieselben OpenAI-kompatiblen Model Studio-Endpunkte bereitgestellt, sodass der Wechsel ein Austausch der Modell-ID ist. Möglicherweise möchten Sie reasoning_effort explizit festlegen, da 3.8-Max standardmäßig auf "xhigh" eingestellt ist und "thinking tokens" als Ausgabe abgerechnet werden. Wenn Sie Bilder senden, ist dies eine reine 3.8-Max-Funktion und erfordert das Standard-Nachrichtenformat für Bildeingaben.
Hat Qwen 3.7-Max offene Gewichte?
Nein, und das wird es basierend auf Alibabas Geschichte mit dieser Reihe auch nie. Qwen 3.8-Max ist das erste Modell der Max-Klasse mit versprochenen offenen Gewichten, die voraussichtlich um den 10. August 2026 auf Hugging Face und ModelScope erscheinen werden. Am 3. August sind sie noch nicht herunterladbar.
Ist Qwen 3.8-Max jetzt besser als Claude oder GPT?
Das hängt von der Zeile ab, und denken Sie daran, dass dies Alibabas eigene Zahlen sind. In ihrer Tabelle schlägt 3.8-Max Opus 4.8 und Fable 5 bei Terminal Bench 2.1 und führt alle bei PaperBench und IFBench an. Es liegt bei SWE-bench Pro (67.7 gegenüber 80.0) weit hinter Fable 5 und bei HLE hinter allen an der Spitze. Es liegen noch keine unabhängigen Benchmark-Zahlen vor, daher sollte das endgültige Urteil bis zum Eintreffen von Drittanbieter-Evals abgewartet werden.