
Jev ist das System One Modell von TypeSafe AI: Sie senden ihm den Programmzustand plus typisierte Fragen, und es liefert Entscheidungen mit kalibrierten Wahrscheinlichkeiten anstelle von Prosa. (Dies ist Jev das Modell, nicht FaZe Jev der Streamer oder der JEV-Impfstoff.) Es sind geschlossene Gewichte, nur API, bereitgestellt unter POST https://api.typesafe.ai/v1/systemone als jev-latest. „Jev lokal ausführen“ kann also nicht Jev bedeuten. Es bedeutet einen Cluster von tagealten Community-Projekten, angeführt von OpenJev, die die Idee mit offenen Modellen reproduzieren. Wenn Sie neu in diesem Modell sind, lesen Sie zuerst was Jev ist; dieser Artikel behandelt die Nachahmungen.
Es ist eine Zusammenfassung und ein Realitätscheck: was jede README behauptet, wie originalgetreu es ist, welche Hardware es benötigt und wie man jedes davon über einen lokalen HTTP-Endpunkt in Apidog testet, so wie Sie die TypeSafe API testen würden. Keines davon wurde von einem Drittanbieter bewertet, und keines stammt von TypeSafe.
Was „Jev lokal ausführen“ bedeuten kann
Der Launch-Post von TypeSafe beschreibt ein Modell, das mit Reinforcement Learning for Calibrated Decisions (RLCD) trainiert wurde, drei Primitive (Noul, Choice, Score), eine Antwortzeit von 70 ms bis 500 ms und 0,042 $ pro Million Eingabetokens mit kostenloser Ausgabe. Das sind Herstellerangaben; das Trainingsrezept ist unveröffentlicht. Ein Community-Thread besagt, dass Jev zu 100 % mit synthetischen Daten trainiert wurde. Behandeln Sie dies als unbestätigtes Gerücht.
Da das Rezept geheim ist, nimmt jedes „Open Jev“ eine von drei Abkürzungen:
- Logits von einem eingefrorenen Chat-Modell ablesen. Stellen Sie einem kleinen Qwen eine Multiple-Choice-Frage, überspringen Sie die Generierung und wandeln Sie die Logits des nächsten Tokens pro Option in eine Wahrscheinlichkeit um. OpenJev und mini-jev machen das.
- Einen kleinen Scorer von Grund auf trainieren. Ein Modell, dessen einzige Aufgabe es ist, N Optionen in einem Durchlauf anhand eines Kontexts zu bewerten. Das ist jevlike.
- Die Decodierungs-Engine ändern. Das Basismodell beibehalten, jedes Feld parallel über eingeschränkte Kandidaten evaluieren. Das ist die Apple Silicon Engine auf Hugging Face und der vLLM Pull Request.
Keines von ihnen reproduziert RLCD. Das ist die ehrliche Schlagzeile.
OpenJev: Logits von einem eingefrorenen Qwen auf einer 3090
OpenJev fragt: „Können wir so etwas wie Jev auf einer 3090 zu Hause ausführen?“ und antwortet mit einem MIT-lizenzierten Python-Paket. Die README ist vorsichtig: Sie „reproduziert dieses Schnittstellenmuster mit offenen Modellen; sie reproduziert nicht Jevs unveröffentlichtes Modell oder Training.“
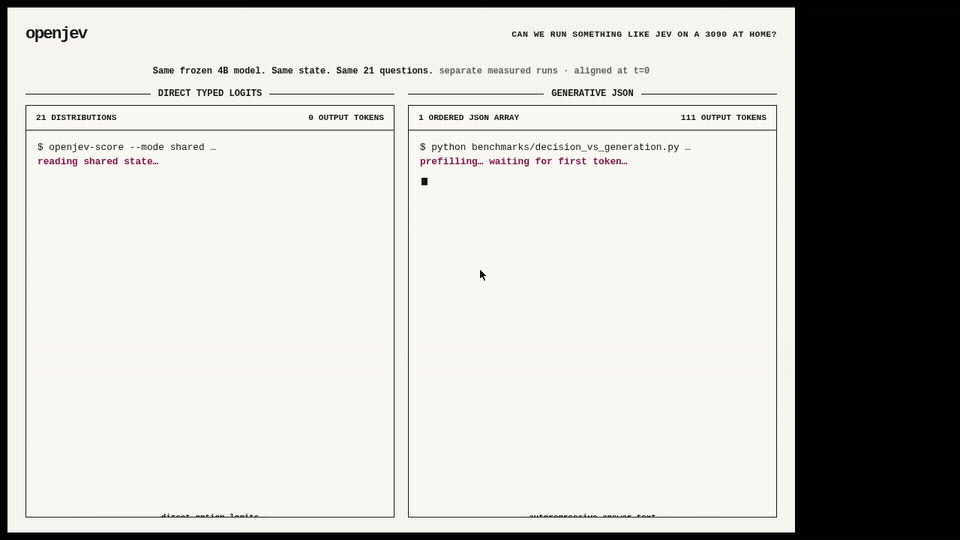
Der Mechanismus ist ein einziger Vorwärtsdurchlauf, der deklarierte Options-Logits liest, ohne dass ein Antwort-Token gesampelt wird. Kriterien und Optionen kommen mit jeder Anfrage an, sodass nichts pro Aufgabe feinabgestimmt wird. Das primäre Modell ist Qwen3.5-4B.
Zahlen, die die README für eine RTX 3090 mit Qwen3.5-4B angibt:
- Direkt eingegebene Logits: 1,023 s für 21 Wahrscheinlichkeitspaare, gegenüber 5,332 s für ein autoregressives JSON-Array, oder 5,21x langsamer.
- Auf einem 102-Zeilen-TypeSafe-Teilsatz, modale Übereinstimmung von 0,845, gegenüber 0,883 für veröffentlichtes Jev.
Eingabe ist JSONL mit id, state, question und einem options-Array von {id, description}; Ausgabe ist eine Wahrscheinlichkeit pro Option. Es gibt keinen HTTP-Server im Repository: Sie führen openjev-score --mode direct --model Qwen/Qwen3.5-4B --input examples/decisions.jsonl aus, oder probieren die WebGPU-Demo unter openjev.com. Hardware: CUDA und eine GPU, die ein 4B-Modell in BF16 enthält.
Was es auslässt: kein Noul- oder Score-Primitiv, und die Wahrscheinlichkeiten sind ein Softmax über Options-Logits, nicht RLCD-kalibrierte Konfidenz.
mini-jev: eine vorregistrierte Studie mit einem lokalen Server
mini-jev ist eher ein Experiment als ein Produkt. Ihr Slogan: „Wie eine Jev-ähnliche Schnittstelle auf einem eingefrorenen Qwen3-4B aussieht, liest die Logits des Optionsbuchstabens, anstatt JSON zu generieren.“ Es führt Qwen3-4B-Instruct-2507 für die CLINC150-Intentsklassifikation aus und vergleicht die grammatikbeschränkte JSON-Generierung mit dem Ablesen des Logits eines Optionsbuchstabens.
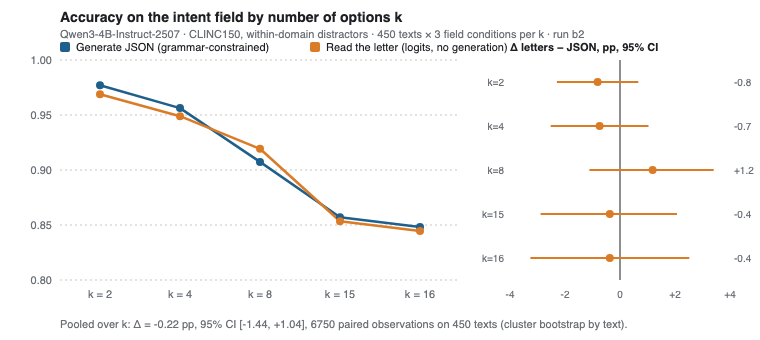
Das Ergebnis aus 6.750 gepaarten Beobachtungen: JSON 0,909 Genauigkeit, Buchstaben 0,907, ein Unterschied von -0,22 Punkten innerhalb eines 95%-Konfidenzintervalls von [-1,44, +1,04]. Das Lesen von Buchstaben war etwa 4x schneller bei 32-Token-Texten.
Die README ordnet ihre Begriffe denen von TypeSafe zu: Choice und Noul sind „was diese Studie an einem eingefrorenen Modell misst, als der gelesene Buchstabe und der Boolesche Wert; Score (eine geordnete Skala) wurde nicht gemessen.“ Es nennt dies „eine Entsprechung von Begriffen, nicht eine Reproduktion ihres Modells“, und fügt den Vorbehalt hinzu, den jedes Projekt hier übernehmen sollte: „Die Buchstabenanteile sind ein Ranking mit einem Konfidenz-Gap, keine kalibrierten Wahrscheinlichkeiten.“
Es liefert eine HTTP-Demo mit. MINIJEV_DEVICE=mps uv run python demo/server.py stellt 127.0.0.1:8765 mit POST /run bereit, das schema und text entgegennimmt und pro Feld letter, p, gap und answer zurückgibt. Es benötigt etwa 8,5 GB Arbeitsspeicher auf Apple Silicon oder einer NVIDIA GPU. MIT-Lizenz, 11 Sterne zum Zeitpunkt des Schreibens.
jevlike: ein von Grund auf neu entwickelter Options-Scorer
jevlike wird als „reverse-engineered Jev-ähnliches Modell“ geteilt. Die README besagt etwas anderes: „TypeSafe hat sein Design nicht veröffentlicht. Dieses Repository ist ein unabhängiges Startmodell mit derselben Eingabe- und Ausgabeform.“ Die Autoren fügen hinzu, dass sie „keine gleiche Qualität wie Jev gezeigt oder TypeSafes private Trainingsmethode reproduziert haben.“
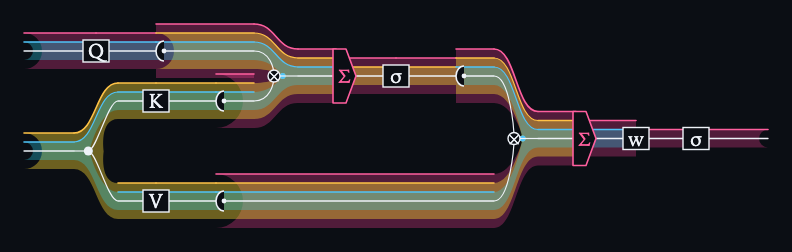
Das Design ist klein. Jede Option erhält einen Abfragevektor, der über die Kontext-Tokens aufmerksam wird; ein gemeinsames Punktprodukt bewertet jedes Paar; Softmax wandelt Scores in Wahrscheinlichkeiten um. Der Standard-Encoder sind Byte-Embeddings, die von Grund auf gelernt wurden, mit einem optionalen eingefrorenen Hugging Face Encoder.
Gemeldete Zahlen: etwa 98 % bei synthetischen Menüs, 26 % bei Wikispeedia mit einem eingefrorenen Qwen2.5-0.5B Encoder gegenüber einer 8 % zufällig gemischten Kontrolle, und ein Durchlauf „etwa 100-mal schneller als ein kleiner Decoder, der gezwungen ist, 400 Tokens zu schreiben.“ Es läuft auf CPU, MPS oder CUDA. MIT-Lizenz, 764 Sterne.
Die Treue ist die geringste in dieser Gruppe. Sie trainieren es mit Ihren eigenen Labels, es ist also ein Klassifikator, den Sie gebaut haben, kein Entscheidungsmodell, dem Sie beliebige Kriterien übergeben können. Kein Noul oder Score, keine Kalibrierungsbehauptung, kein HTTP-Server.
Parallel eingeschränkte Dekodierung: die Apple Silicon Engine
Der Hugging Face Space parallel-constrained-decoding wird als „Typesafe.ai Jev Open-Source-Alternative“ verbreitet, aber seine README erwähnt niemals Jev, TypeSafe oder RLCD. Sein Titel lautet „Parallel Constrained Decoding for Apple Silicon“: eine MLX-Inferenz-Engine für strukturierte Extraktion über `mlx-community/Qwen2.5-1.5B-Instruct-4bit`, wobei jeder `mlx-lm`-Decoder austauschbar ist.
Die Methode: den Kontext einmal in einen KV-Cache vorfüllen, über jedes Schemafeld verbreiten, nur die gültigen Kandidaten-Token-IDs pro Feld evaluieren, Softmax über diese Menge anwenden und das JSON im Code zusammensetzen. Die README berichtet auf einem M4 Max: 4-Feld-Betrugs-Triage 420 ms autoregressiv versus 75 ms parallel (5.6x), und eine 28-Feld-Support-Triage 1.900 ms versus 270 ms (7.0x). Es beansprucht 100% Schema-Gültigkeit, was daraus folgt, dass niemals freier Text gesampelt wird.
Es stellt HTTP auf Port 8000 über Uvicorn bereit, wobei `parsed_json` plus `field_telemetry` mit feldbezogener Konfidenz zurückgegeben wird. Anforderungen: ein M1 oder neuerer Mac, macOS 14+. Apache 2.0-Lizenz. Keine Genauigkeitszahlen, nur Latenz, und „kalibriert“ bedeutet hier ein exakter Softmax über Kandidaten, keine trainierte Kalibrierung.
vLLM PR 57250: ein Jev-ähnlicher Modus für DiffusionGemma
vLLM Pull Request #57250, am 16. September geöffnet und noch immer offen, verwandelt DiffusionGemma in das, was der Autor eine „kalibrierte Multiple-Choice-Maschine“ nennt: eine mit Seed versehene Leinwand mit Ein-Token-Antwortslots, gelesen an einer Schrittbegrenzung, mit Konfidenz aus Logprobs und Entropie. Neue `vllm_xargs`-Felder umfassen `diffusion_seed_canvas`, `diffusion_max_steps` und `diffusion_read_only`, und ein Beispiel `structured_server.py` übersetzt ein Schema in eine Leinwand.
Der PR meldet 8,7 Anfragen pro Sekunde bei einzelnen Canvas-Lesevorgängen, 54 bei 32-facher Parallelität und eine Genauigkeit von etwa 90 % bei einem Sprachklassifikationskorpus. Ein Prüfer bemängelte einen fehlenden Race-Condition-Test und unbegrenzte Thread-Erzeugung als blockierend. Bis zur Zusammenführung ist es ein Design zum Lesen, nicht zum Bereitstellen.
Wie originalgetreu ist jedes davon?
| Projekt | Basis | Primitive | Kalibrierung | HTTP-Server | Hardware |
|---|---|---|---|---|---|
| OpenJev | Qwen3.5-4B, eingefroren | Auswahl | Softmax über Options-Logits | Nein (CLI + Browser-Demo) | RTX 3090-Klasse, CUDA |
| mini-jev | Qwen3-4B-Instruct, eingefroren | Auswahl, Noul | Ranking mit Lücke | Ja, Port 8765 | 8.5 GB Arbeitsspeicher, MPS oder CUDA |
| jevlike | Encoder, den Sie trainieren | Auswahl | keine beansprucht | Nein | CPU, MPS oder CUDA |
| MLX Engine | Qwen2.5-1.5B-Instruct-4bit | Schemafelder | Softmax über Kandidaten | Ja, Port 8000 | Apple Silicon, macOS 14+ |
| vLLM PR | DiffusionGemma | Ja/Nein, Auswahl, Skala | Logprobs plus Entropie | Ja, OpenAI-kompatibel | vLLM-Klasse GPU, nicht zusammengeführt |
Jede Zeile ist ein eingefrorenes oder selbsttrainiertes Modell, das Logits liest. Das gibt Ihnen Jevs Form: getypte Antworten, eine Wahrscheinlichkeit pro Option, ein einziger Vorwärtsdurchlauf. Es gibt Ihnen jedoch nicht Jevs zentrale Behauptung, dass RLCD diese Wahrscheinlichkeiten ehrlich macht. OpenJevs 0,845 gegenüber 0,883 ist der einzige Vergleich mit dem echten Modell, und es ist die eigene Bewertung des Autors. Das Setup entspricht unserer Anleitung zum lokalen Ausführen von Kimi K3: Gewichte, eine GPU oder ein Mac der M-Serie, ein lokaler Port.
Testen Sie jedes davon in Apidog wie die echte Jev API
Der Sinn einer lokalen Reproduktion ist es, sie gegen die echte API auszutauschen, ohne Ihre Integration neu zu schreiben, sodass Ihre Tests denselben Body an beide senden sollten. Keines dieser Projekte spricht Jevs {model, state, questions}-Schema nativ. Setzen Sie einen dünnen Adapter vor das, was Sie ausführen: eine 40-Zeilen-FastAPI-App, die den Jev-Body akzeptiert, das Tool aufruft und {"answers": {...}} mit den Schlüsseln choice, probabilities und confidence zurückgibt. Jetzt sieht Apidog einen Vertrag.
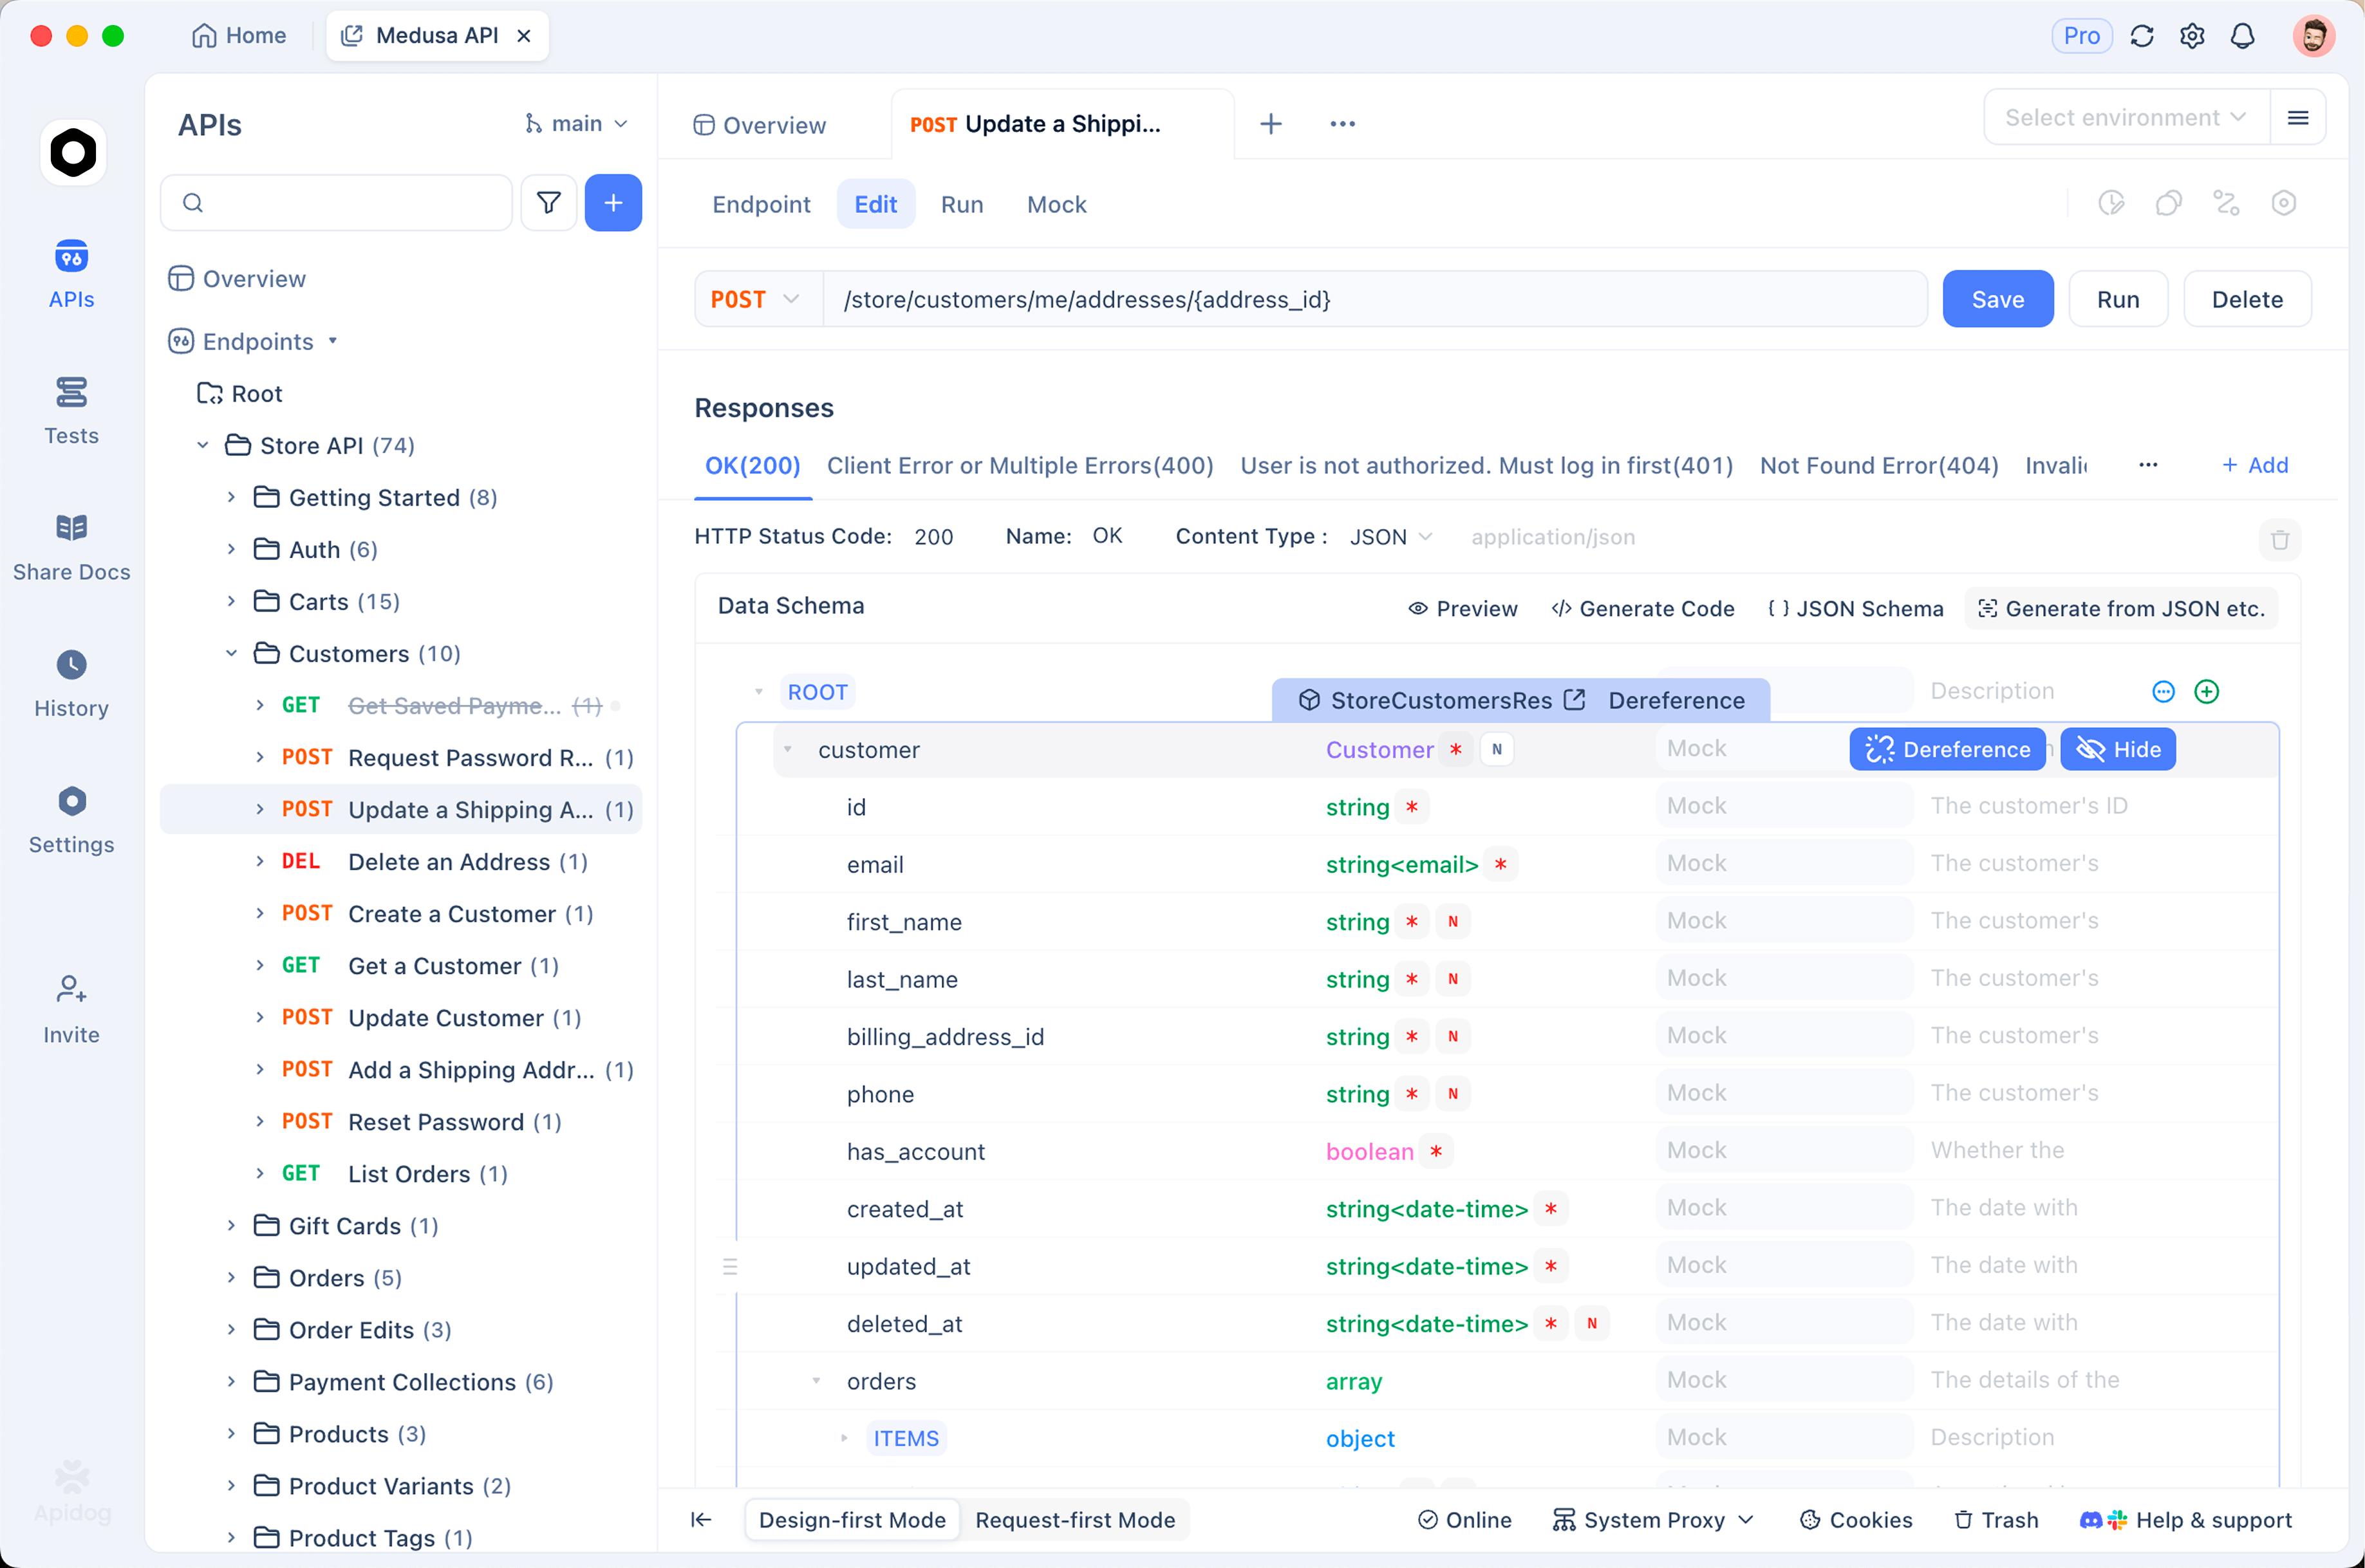
Zwei Umgebungen, ein Satz von Anfragen. Erstellen Sie Local reproduction mit BASE_URL = http://localhost:8765 und ohne Schlüssel, und TypeSafe API mit BASE_URL = https://api.typesafe.ai plus TYPESAFE_API_KEY im lokalen Feld, damit es nie mit Teamkollegen synchronisiert wird (Regeln für den Geltungsbereich hier). Jede Anfrage verwendet {{BASE_URL}}/v1/systemone und Bearer {{TYPESAFE_API_KEY}}; der lokale Server ignoriert den Header.
Den Jev-Body senden. Senden Sie POST an {{BASE_URL}}/v1/systemone mit dem Zustand und den Fragen, die Sie an jev-latest senden würden:
{
  "model": "jev-latest",
  "state": "My card was charged twice for one order and I need this fixed today.",
  "questions": {
    "department": { "type": "choice", "instructions": "Which team handles this?",
      "criteria": { "billing": "charges and refunds", "shipping": "delivery", "technical": "bugs" } },
    "wants_refund": { "type": "noul", "instructions": "Is the customer asking for money back?" }
  }
}
Die Wahrscheinlichkeitsfelder überprüfen. Fügen Sie Post-Processor-Assertions hinzu: answers.department.choice ist gleich billing; answers.department.probabilities.billing ist größer als 0.7; answers.wants_refund.noul ist größer als 0.8. Klappen Sie das Umgebungs-Dropdown auf und führen Sie dasselbe Szenario gegen TypeSafe aus. Der Unterschied zwischen den beiden Ausführungen ist Ihre Treue-Zahl, die mehr wert ist als jede README-Tabelle.
Speichern Sie den lokalen Lauf als Mock, damit das Frontend mit einem stabilen answers-Objekt ohne GPU-Zeit erstellt wird. Laden Sie Apidog herunter, um es einzurichten; der kostenlose Plan deckt vier Benutzer ab. Dasselbe Muster für Chat-Modelle finden Sie unter Testen lokaler LLMs als APIs.
Häufig gestellte Fragen (FAQ)
Ist OpenJev dasselbe wie Jev?
Nein. OpenJev liest Options-Logits von einem eingefrorenen Qwen3.5-4B und gibt dies in seiner README an. Jev ist ein geschlossenes Modell von TypeSafe, das mit RLCD trainiert wurde. OpenJev berichtet eine modale Übereinstimmung von 0,845 mit Jev auf einem 102-Zeilen-Teilsatz, laut eigener Bewertung des Autors.
Welches sollte ich zuerst ausprobieren?
mini-jev, wenn Sie einen Mac haben und heute einen HTTP-Endpunkt wünschen; OpenJev, wenn Sie eine NVIDIA-GPU haben und den engsten veröffentlichten Vergleich zu Jev wünschen. Wählen Sie jevlike nur, wenn Sie über beschriftete Daten zum Trainieren verfügen.
Kann ich kalibrierte Wahrscheinlichkeiten von einem eingefrorenen Modell erhalten?
Nicht allein durch das Lesen von Logits. Ein Softmax über Options-Tokens ist ein Ranking mit einer Lücke, wie es in der README von mini-jev heißt. Kalibrierung erfordert Training oder einen Post-hoc-Schritt wie die Temperaturskalierung an Ihrem beschrifteten Datensatz, was keines dieser Projekte mitliefert.
Ist es günstiger, eines davon zu betreiben, als TypeSafe zu bezahlen?
Mit 0,042 US-Dollar pro Million Eingabetokens bei kostenloser Ausgabe liegt Jev bereits am unteren Ende der günstigsten LLM-API-Anbieter. Lokal gewinnt man bei Datenschutz und Offline-Nutzung, nicht bei den Kosten, sobald man die GPU-Zeit berücksichtigt.
Wo Sie das lässt
OpenJev, mini-jev, jevlike, die MLX-Engine und der vLLM PR beweisen alle eine Idee: Eine Entscheidung benötigt keinen generierten Text, und das Lesen von Logits in einem Durchlauf ist schneller. Keines beweist, dass es kalibriert ist, und keines ist Jev. Führen Sie eines hinter einem Jev-förmigen Adapter aus, halten Sie eine zweite Umgebung auf TypeSafe gerichtet und lassen Sie Ihre Behauptungen entscheiden, wie weit sie auseinander liegen.