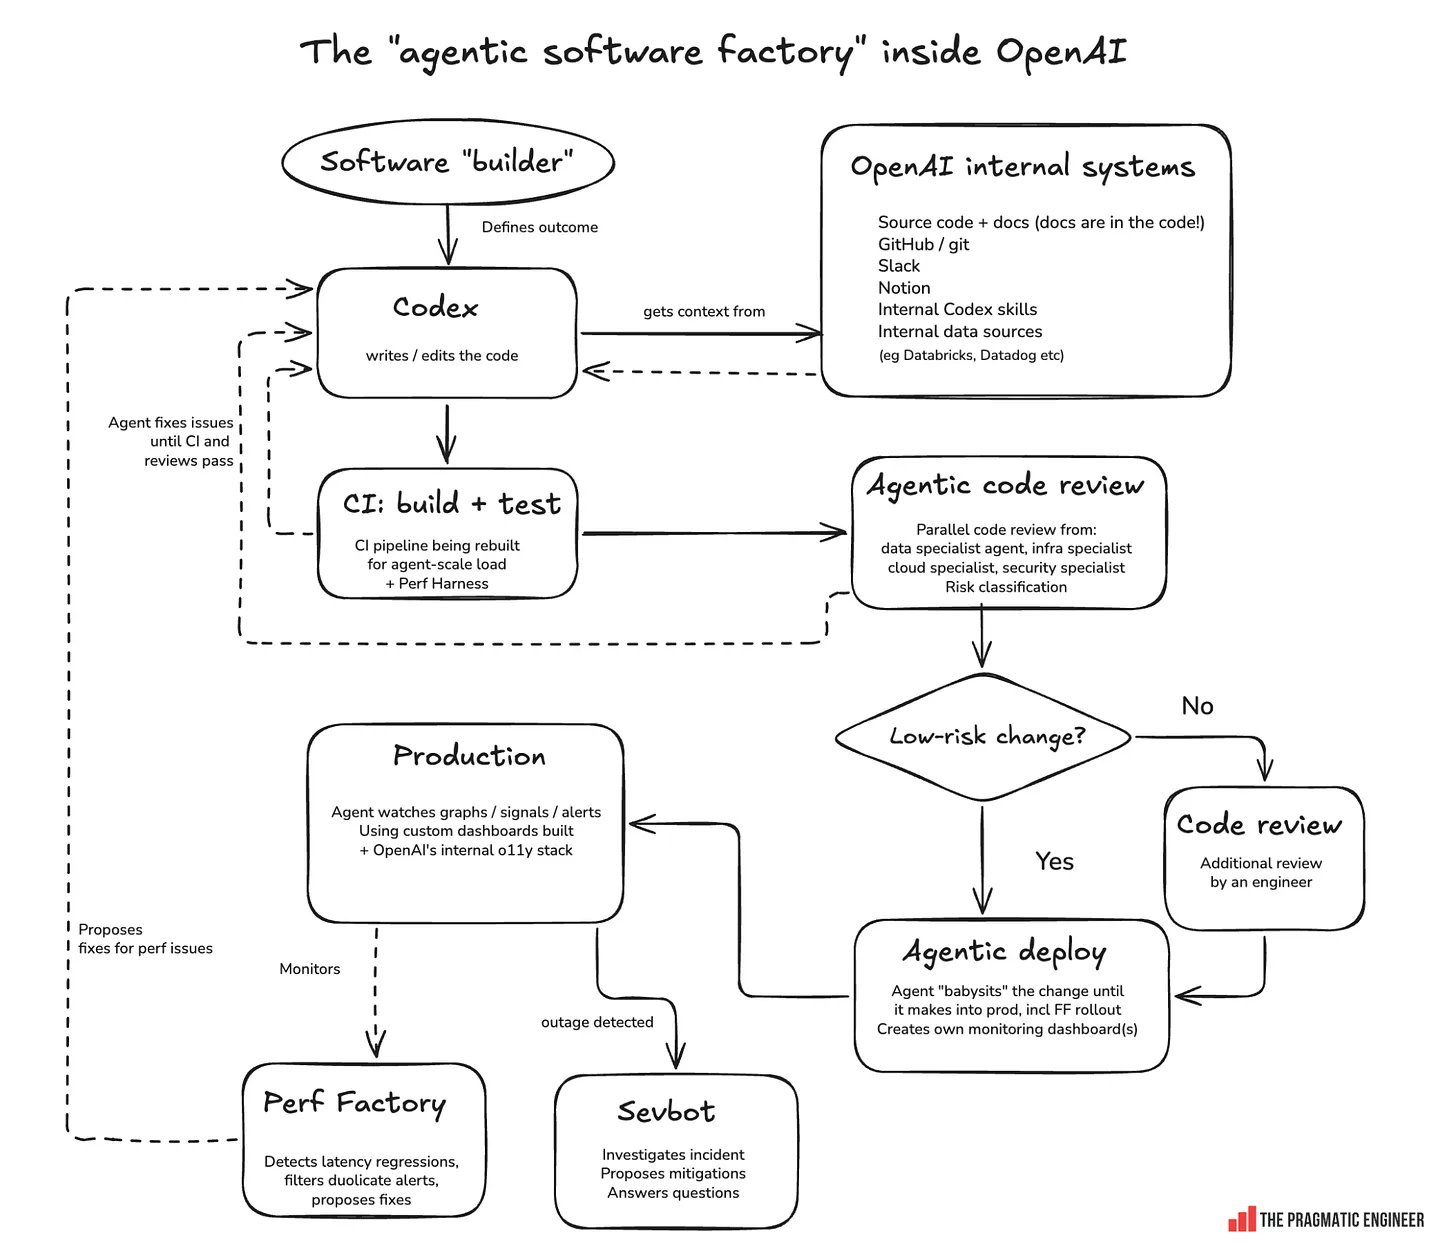
Ein Diagramm der internen Engineering-Pipeline von OpenAI ging diese Woche auf X semi-viral. Es zeigte zehn Kästchen, von „Softwareentwickler definiert Ergebnis“ bis hin zu einem Agenten, der Produktionsdiagramme überwacht und eigene Vorfallberichte einreicht. Die Quelle ist Gergely Orosz' Newsletter The Pragmatic Engineer, in einem Artikel mit dem Titel „OpenAI’s agentic software factory“, und das Diagramm selbst verbreitete sich schnell auf X.
Die meisten Reaktionen übersprangen ein wichtiges Detail: Mehrere dieser zehn Kästchen beschreiben OpenAIs internes Engineering-Setup, nicht das Codex-Produkt, das Sie heute installieren können. Die Verwechslung dieser beiden ist der häufigste Fehler im Diskurs um dieses Diagramm. Dieser Artikel geht Kästchen für Kästchen durch und bleibt bei der einen Stufe stehen, die externe Teams tatsächlich kopieren können: CI.
Die zehn Stufen, der Reihe nach
Das Diagramm liest sich von links nach rechts als Schleife: Ein Mensch setzt ein Ziel, ein Agent schreibt Code, automatisierte Gates prüfen ihn, und der Agent iteriert weiter, bis diese Gates passieren. Hier ist die vollständige Sequenz mit der Markierung „nur intern“ oder „in Codex enthalten“ für jede Stufe.
| # | Stufe | Was passiert | Nur intern oder in Codex enthalten |
|---|---|---|---|
| 1 | Softwareentwickler | Ein Ingenieur oder PM definiert das Ergebnis | Menschlicher Schritt, keine Software |
| 2 | Codex schreibt/bearbeitet Code | Zieht Kontext aus Quelle, Dokumenten, GitHub, Slack, Notion, internen Fähigkeiten und Datensystemen wie Databricks und Datadog | Versendetes Codex schreibt Code; der interne Kontextgraph (Slack, Notion, interne Daten) ist nur intern |
| 3 | CI: Build + Test | Eine Pipeline, die für Agenten-Skalierung neu aufgebaut wird, plus ein „Perf Harness“ | Versendet (Ihr eigenes CI); OpenAIs spezifische Skalierungsarbeit ist intern |
| 4 | Agentengesteuertes Code-Review | Paralleles Review durch Daten-, Infrastruktur-, Cloud- und Sicherheits-Spezialagenten, plus Risikoklassifizierung | Nur intern |
| 5 | Entscheidung bei geringem Risiko | Änderungen mit geringem Risiko werden fortgesetzt; Änderungen mit höherem Risiko erhalten eine zusätzliche menschliche Ingenieurprüfung | Nur intern |
| 6 | Agentengesteuertes Deployment | Ein Agent „betreut“ die Änderung in der Produktion, einschließlich Feature-Flag-Rollout, und erstellt eigene Dashboards | Nur intern |
| 7 | Produktionsüberwachung | Der Agent überwacht Graphen, Signale und Warnungen auf OpenAIs internem Observability-Stack | Nur intern |
| 8 | Ausfall erkannt -> Sevbot | Untersucht den Vorfall, schlägt Abhilfemaßnahmen vor, beantwortet Fragen | Nur intern |
| 9 | Perf Factory | Filtert doppelte Warnungen, findet Latenzregressionen, schlägt Korrekturen vor | Nur intern |
| 10 | Rückkopplungsschleife | Der Agent behebt Probleme, bis CI und Reviews bestanden sind, dann erhält der Entwickler vorgeschlagene Korrekturen | Beschreibt die interne Schleife |
Genau eine Stufe, der CI-Schritt, plus ein Teil von Stufe 2, ist etwas, auf das ein externes Team zeigen und sagen kann: „Das haben wir auch.“ Alles vom agentengesteuerten Review bis zum Sevbot ist OpenAIs interne Entwicklung.
Diese „nur intern“-Spalte ist auch ein Beschaffungsproblem. Die Teile, die OpenAI hinter seiner Firewall hält – die Orchestrierung, das Review-Gate, die menschliche Freigabe – sind genau die Schicht, für die die meisten Teams nichts haben. Sharkly ist ein anbieterneutraler Ort, um dies zu entwickeln: Ein Entwickler definiert das Ergebnis als Task, weist es einem Agenten zu, und der Agent läuft auf einem Computer mit der Runtime, die Sie bereits haben, Claude Code oder Codex. „Bereit zur Veröffentlichung“ ist der Status, den ein Mensch ändern muss, bevor etwas als „Erledigt“ gilt, sodass die Freigabe die Aufgabe einer Person bleibt, nicht die der Pipeline. Sharkly ersetzt Codex nicht oder schreibt selbst Code; es führt die Runtime aus, für die Sie bereits bezahlen, und bietet der umgebenden Schleife einen Platz.
Stufe 1-2: Ein Mensch setzt immer noch das Ziel, Codex schreibt immer noch den Code
Ein Softwareentwickler, d.h. ein Ingenieur oder Produktmanager, definiert, welches Ergebnis er wünscht. Codex nimmt dann eine Reihe von Codeänderungen vor, bis dieses Ziel erreicht ist und das Ergebnis funktioniert. Diese Verifizierungsschleife ist der Teil von Codex, der heute ausgeliefert wird: die Desktop-App (Mac im Februar 2026, Windows im März), die ChatGPT Work-Integration ab Juli 2026, rollenbasierte Plugins und Skills sowie der ` /goal`-Befehl für Aufgaben, die über einen längeren Zeitraum laufen. Wenn Sie die Mechanik dieses Befehls wissen möchten, haben wir `/goal` für autonome Agentenläufe separat behandelt.
Was nicht ausgeliefert wird, ist der Kontextgraph, der Codex intern speist: so ziemlich jedes OpenAI-System, von Slack-Threads bis zu Databricks-Dashboards. Orosz' Artikel bringt es direkt auf den Punkt: OpenAIs internes Codex „ist viel fortschrittlicher als sein externes Gegenstück, weil es an so ziemlich jedes OpenAI-System angeschlossen ist.“ Diese Lücke zwischen internem und externem Codex ist die eigentliche These des Artikels.
Stufe 3: CI ist der Ort, an dem die Schleife tatsächlich durchgesetzt wird
Dies ist die Stufe, an der man langsamer werden sollte, denn sie ist die einzige Box in der gesamten Pipeline, die jedes Team, nicht nur OpenAI, bereits besitzt. Der Artikel stellt fest, dass CI bei OpenAI für eine etwa 10-fache Steigerung der Last über etwa sechs Monate neu aufgebaut wird, da Agenten jetzt weitaus mehr Änderungen durch die Pipeline schieben, als es Menschen allein je getan haben. Ein „Perf Harness“ läuft parallel dazu, um Performance-Regressionen abzufangen, bevor sie zur Überprüfung gelangen.
Hier ist der Punkt, der oft übersehen wird: Ein Agent, der „Probleme behebt, bis CI und Reviews bestanden sind“, ist nur so vertrauenswürdig, wie das, was CI tatsächlich prüft. Wenn Ihre Testsuite die Unit-Logik abdeckt, aber nicht den API-Vertrag, kann ein Agent eine Schleife zu einem grünen Build durchlaufen, der dennoch eine bahnbrechende Änderung ausliefert. Statuscodes, Schemaform, Authentifizierungsverhalten und Antwortzeit-Budgets unter Last sind genau die Art von Checks, in die die meisten Teams im Vergleich zu Unit-Tests zu wenig investieren. Dies ist die Box, in die Apidog passt: Das Ausführen von Apidogs Testfällen über die Apidog CLI innerhalb Ihres CI-Schritts gibt einem Agenten ein härteres Gate zu erfüllen als „der Code wurde kompiliert.“ Wir haben darüber geschrieben, wie man das in Apidog CLI in Codex einbindet. Das ist die einzige Rolle, die Apidog in dieser Pipeline spielt. Es ist nicht der Agent, und es berührt Deployment, Review oder Vorfallmanagement nicht.
Stufe 4-5: Spezialisierte Review-Agenten und die Risikobewertung
Nachdem CI bestanden wurde, leitet OpenAIs internes Setup die Änderung durch eine parallele Überprüfung durch spezialisierte Agenten für Daten, Infrastruktur, Cloud und Sicherheit. Orosz beschreibt es als „das Äquivalent dazu, einen menschlichen Domänenexperten aus jedem relevanten Infrastrukturteam jede Änderung überprüfen zu lassen“, was eine strengere Überprüfung darstellt, als die meisten menschlichen Teams für jede Pull-Anfrage bereitstellen können. Das ausgelieferte Code-Review-Feature von Codex ist etwas anderes, leichteres als diese internen spezialisierten Agenten; wenn Sie entscheiden, was ein allgemeiner agentenbasierter Prüfer für Ihren eigenen Stack tun kann, ist unsere Zusammenfassung der AI-Code-Review-Tools ein guter Ausgangspunkt, und unser Begleitartikel zu OpenAIs agentenbasierter Überprüfung und dem Risikogate-Design geht tiefer auf diese eine Box ein (Schwester, vor dem Verlinken auf Live prüfen).
Die Risikoklassifizierung entscheidet dann, was als Nächstes passiert. Bereiche des Codes mit geringem Risiko können einem Agenten erlauben, seine eigenen PRs automatisch zu genehmigen, wodurch für diese Art von Änderung die menschliche Freigabe vollständig aus der Schleife genommen wird. Änderungen mit höherem Risiko erhalten mehr AI-Review-Durchläufe, eine obligatorische menschliche Überprüfung oder beides. OpenAI hat die genaue Regel, was als geringes Risiko gilt, nicht veröffentlicht, und wir werden hier nicht darüber spekulieren. Eine Idee, die über OpenAIs spezifisches Setup hinausgeht: Eine bahnbrechende Änderung eines öffentlichen API-Vertrags sollte niemals als geringes Risiko eingestuft werden, egal wie klein der Unterschied aussieht. Spec-first-Tools, die Ihre OpenAPI-Definition und Ihre Tests am selben Ort halten, erleichtern die automatische Durchsetzung dieser Unterscheidung, da ein Schema-Diff ein viel saubereres Risikosignal ist als ein Zeilenanzahl-Diff.
Stufe 6-8: Bereitstellen, Überwachen und Reagieren, ohne dass zuerst ein Mensch benachrichtigt wird
Wenn eine Änderung die Überprüfung besteht, „betreut“ ein interner Agent sie in die Produktion, einschließlich Feature-Flag-Rollout, und erstellt eigene Überwachungs-Dashboards für diese spezifische Änderung. Sobald sie live ist, überwacht derselbe Agent (oder ein verwandter) Graphen und Warnungen auf OpenAIs internem Observability-Stack. Wenn etwas kaputtgeht, übernimmt Sevbot: Es untersucht den Vorfall, schlägt Abhilfemaßnahmen vor und beantwortet Entwicklerfragen in Slack. Es lohnt sich, genau zu sein, was Sevbot nicht tut. Es schlägt vor; es führt nicht aus. Ein Mensch autorisiert immer noch die Abhilfemaßnahme und ist weiterhin im Bereitschaftsdienst. Wie der Artikel klar feststellt: „Bereitschaftsdienst gehört nicht der Vergangenheit an.“ Keine der Stufen 6 bis 8 existiert im Codex-Produkt, das Sie kaufen können.
Stufe 9-10: Performance-Regressionen und die Rückkopplungsschleife
Die Perf Factory läuft parallel zum Vorfallpfad. Sie durchsucht Warnungen und Dashboards, filtert doppelte Signale heraus, spürt echte Latenzregressionen auf und schlägt Korrekturen vor, die dann an den ursprünglichen Entwickler zurückfließen. Zusammen mit Sevbot ist dies OpenAIs Antwort auf die Alarmmüdigkeit: Anstatt dass ein Bereitschaftsingenieur jeden Ping triagiert, filtert und diagnostiziert ein Agent zuerst vor. Die Schleife schließt sich mit Stufe 10: Der Agent überarbeitet weiter, bis CI und jede Review-Ebene bestanden sind.
Warum die interne/externe Trennlinie für Ihr Team wichtig ist
Wenn Sie bewerten, ob „OpenAI-ähnliches“ agentengesteuertes Engineering Ihr Team in diesem Quartal übernehmen kann, lautet die ehrliche Antwort: Sie können die Stufen 1 bis 3 heute übernehmen, und die Stufen 4 bis 9 beschreiben eine Richtung, kein kaufbares Feature. Das ist keine Kritik an OpenAI; interne Tools dieser Größenordnung brauchen Jahre. Ein Open-Source-Projekt, orchflows, ist ein öffentlicher Versuch, diese Schleife mit einem `/software-factory`-Befehl für Claude Code und Codex zu approximieren; seine README ist offen bezüglich des Ziels und argumentiert, dass Sie nur zwei Fähigkeiten anstelle einer ganzen Bibliothek benötigen. Es ist ein frühes, unabhängiges Projekt, keine OpenAI-Veröffentlichung, also behandeln Sie es eher als Referenzimplementierung denn als fertige Fabrik.
Die Einführung innerhalb von OpenAI selbst erfolgte schnell in den Teilen, die keine kundenspezifische interne Infrastruktur benötigen: Die Nutzung von Codex in Nicht-Engineering-Teams stieg in vier Monaten, von Februar bis Mai 2026, von etwa 0 % auf 90 %. Das ist ein schärferes Signal als das Pipeline-Diagramm allein, denn es besagt, dass der einfache Teil (ein Agent, der Code gemäß einem angegebenen Ziel schreibt) bei OpenAI bereits normal ist, während der schwierige Teil (agentengesteuerte Bereitstellung, Überprüfung und Vorfallreaktion, die in jedes interne System integriert sind) immer noch maßgeschneidert ist.
Was menschlich bleibt
Der Artikel ist vorsichtig, was sich nicht ändert. Entwickler definieren immer noch Ergebnisse. Menschen genehmigen immer noch risikoreiche Änderungen und autorisieren Maßnahmen zur Vorfallsbehebung. Jemand überprüft immer noch im Nachhinein, was Sevbot getan hat, und Bereitschaftsdienste existieren immer noch. Die Zeile, mit der der Artikel schließt, erfasst die Verschiebung besser als jede Statistik: „Urteilsvermögen, Priorisierung und Geschmack werden immer wichtiger.“ Zwei Einschränkungen halten dies ebenfalls auf dem Boden: Die Überprüfung im App Store für mobile Apps ist immer noch ein manueller Engpass, den kein Agent umgehen kann, und die Skalierung der Infrastruktur ist ein monatlicher Kampf, kein gelöstes Problem.
Wenn Sie Ihre eigene Version der Stufen 1 bis 3 aufbauen, anstatt darauf zu warten, dass ein Anbieter die Stufen 4 bis 9 ausliefert, beginnen Sie mit dem Gate, das bereits in Ihrer Pipeline existiert: CI. Unser Begleitartikel zum Aufbau einer leichteren Software-Fabrik um Codex führt Sie durch diesen Aufbau (Schwester, vor dem Verlinken auf Live prüfen), und das Sevbot/Perf Factory-Design wird in unserem Artikel über OpenAIs Perf Factory und Sevbot separat behandelt (Schwester, vor dem Verlinken auf Live prüfen). Ein Agent, der in einer Schleife arbeitet, bis die Tests bestanden sind, ist nur dann eine gute Idee, wenn die Tests, gegen die er arbeitet, tatsächlich etwas behaupten. Apidog hält API-Vertragstests neben der Spezifikation, sodass dieses Gate ehrlich bleibt, wenn Agenten, nicht nur Menschen, Änderungen durch es schieben.