
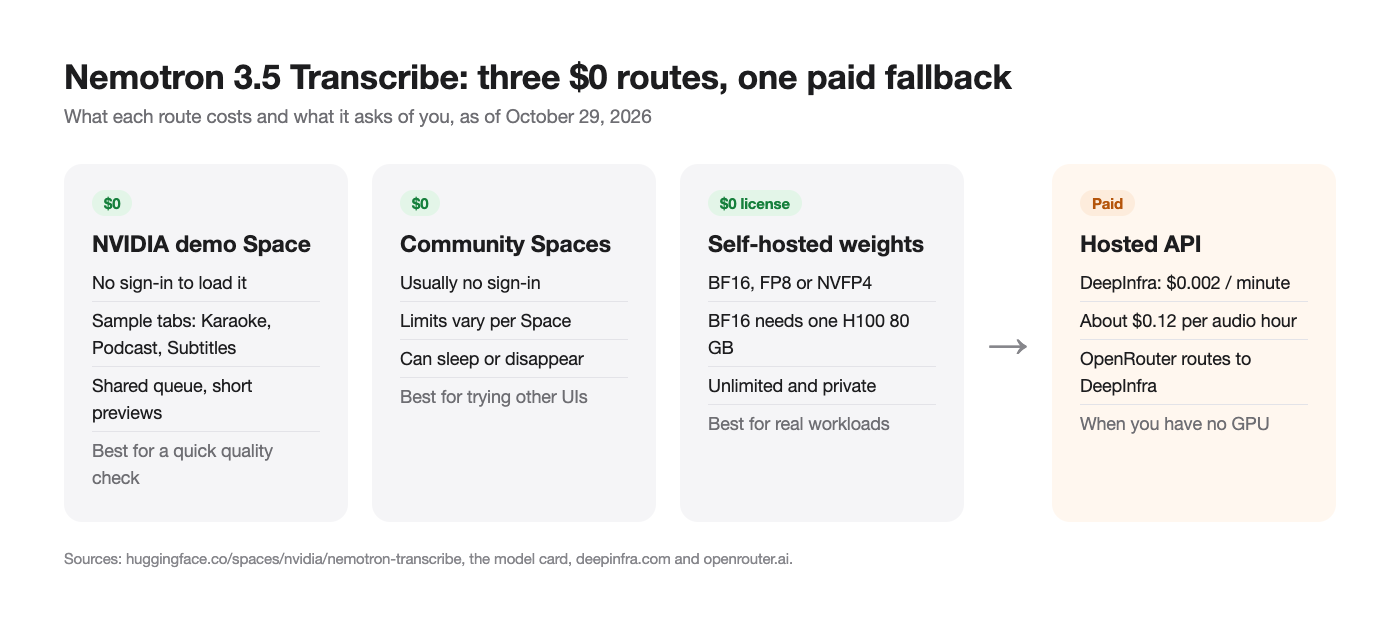
NVIDIA hat das genaueste offene Speech-to-Text-Modell auf dem Hugging Face Open ASR Leaderboard veröffentlicht, und du kannst es heute kostenlos nutzen. Nemotron 3.5 Transcribe (vollständiger Name NVIDIA-Nemotron-3.5-Transcribe-30B-A4B) erschien am 28. Oktober 2026 unter der OpenMDW-1.1-Lizenz, die kommerzielle Nutzung erlaubt. Das bedeutet drei 0-$-Wege: den eigenen Demo-Space von NVIDIA, die kostenlosen Gewichte auf deiner eigenen GPU und Community-Spaces, die denselben Checkpoint nutzen.
Dieser Leitfaden behandelt jeden kostenlosen Weg, was er kann und was nicht, sowie die günstigste kostenpflichtige Alternative, wenn kostenlos nicht mehr ausreicht. Jede Angabe stammt aus der offiziellen Modellkarte, dem NVIDIA-Launchbeitrag auf Hugging Face und dem Open ASR Leaderboard, alle gelesen am 29. Oktober 2026.
Wenn du nur die gehostete API brauchst, springe zu unserem Nemotron 3.5 Transcribe API-Leitfaden.
Ist Nemotron 3.5 Transcribe kostenlos?
Ja, auf zwei Arten. Die Gewichte sind kostenlos herunterladbar, und die Lizenz erlaubt kommerzielle und nicht-kommerzielle Nutzung, sodass dich das Selbst-Hosting nur Hardware kostet. NVIDIA betreibt außerdem einen kostenlosen Demo-Space auf Hugging Face, in dem du es im Browser ausprobieren kannst.
Was nicht kostenlos ist: die gehosteten APIs. DeepInfra verlangt 0,002 $ pro Minute Audio, und OpenRouter listet es mit 0,000033 $ pro Sekunde. Keiner von beiden zeigt eine kostenlose Variante. Und zum Stand vom 29. Oktober 2026 erscheint das Modell nicht auf build.nvidia.com, wo viele NVIDIA-Modelle eine kostenlose Test-API erhalten. Eine Suche dort nach „transcribe“ lieferte ein unzusammenhängendes spanisches ASR-Modell.
Warum es begehrt ist: die Zahlen
Nemotron 3.5 Transcribe ist ein sprach-erweitertes Sprachmodell. Ein 600M-Parameter-ASR-Encoder und ein Sprecher-Encoder speisen ein hybrides Mixture-of-Experts-Sprachmodell aus Mamba-2 und Transformer. Es hat insgesamt 34B Parameter, aber nur etwa 4,3B sind pro Token aktiv, weshalb es auf einer einzigen GPU läuft.
Was es in einem einzigen Checkpoint leistet:
- Transkription in 40 Sprachen, wobei 13 als „führend“ eingestuft sind (Englisch, Spanisch, Französisch, Deutsch, Hindi, Koreanisch, Portugiesisch und andere)
- Aufnahmen bis zu einer Stunde in einer einzigen Anfrage (65.536-Token-Kontext)
- Sprecherzuordnung mit bis zu acht gekennzeichneten Sprechern
- Wortgenaue Zeitstempel über einen CTC-Alignment-Kopf
- Sprachübersetzung nach und aus dem Englischen über 31 Sprachen
- Kontext-Prompting: Namen und Fachjargon übergeben, damit sie richtig geschrieben werden
- Audio-Fragebeantwortung (nur Englisch)
Auf dem Open ASR Leaderboard, aktualisiert am 28. Oktober 2026, erreicht es einen durchschnittlichen WER von 5,33 %. Das platziert es auf Platz 9 von 61 Modellen. Die acht darüber (Otter, Zoom Scribe v2 Pro, ElevenLabs Scribe v2, Azure Speech und andere) sind alle geschlossene, kostenpflichtige APIs. Unter den Modellen, die man herunterladen kann, rangiert nichts höher. OpenAIs whisper-large-v3 liegt mit 7,16 % auf Platz 41.
NVIDIAs eigene Modellkarte meldet 4,71 % mittleren WER auf den neun öffentlichen Sets. Die 5,33 % des Leaderboards fügen zwei private Sets hinzu, also sind beide Zahlen ehrlich; sie messen unterschiedliche Mischungen.
Ein Limit, das man vorher kennen sollte: Es ist ein Offline-Modell. Es transkribiert aufgezeichnete Dateien, nicht einen Live-Mikrofonstream.
Jeder kostenlose und kostenpflichtige Weg im Vergleich
| Weg | Kosten | Anmeldung | Limits | Am besten für |
|---|---|---|---|---|
NVIDIA-Demo-Space (nvidia/nemotron-transcribe) |
0 $ | Nein | 60-Sekunden-Vorschau auf den Beispiel-Tabs; geteilte Warteschlange | Ein schneller Qualitätscheck |
| Community-Spaces | 0 $ | Meist nein | Variiert je nach Space; kann einschlafen oder verschwinden | Andere UIs ausprobieren |
| Selbst gehostete Gewichte (BF16, FP8, NVFP4) | 0 $ Lizenz, deine GPU | Hugging-Face-Konto zum Herunterladen | Eine H100 80 GB für BF16; kleinere Karten brauchen FP8 oder NVFP4 | Unbegrenzte private Transkription |
| DeepInfra API | 0,002 $ pro Minute | Konto und API-Schlüssel | Kostenpflichtige Nutzung | Produktion ohne GPUs |
| OpenRouter | 0,000033 $ pro Sekunde | Konto und Guthaben | Nur an DeepInfra weitergeleitet | Ein Schlüssel für viele Modelle |
| build.nvidia.com | Noch nicht gelistet | k. A. | k. A. | Diese Seite im Auge behalten |
Nur die ersten drei Zeilen kosten nichts.
Kostenloser Weg 1: NVIDIAs Demo-Space
Der schnellste Weg zu hören, was das Modell kann, ist NVIDIAs offizieller Space unter huggingface.co/spaces/nvidia/nemotron-transcribe.
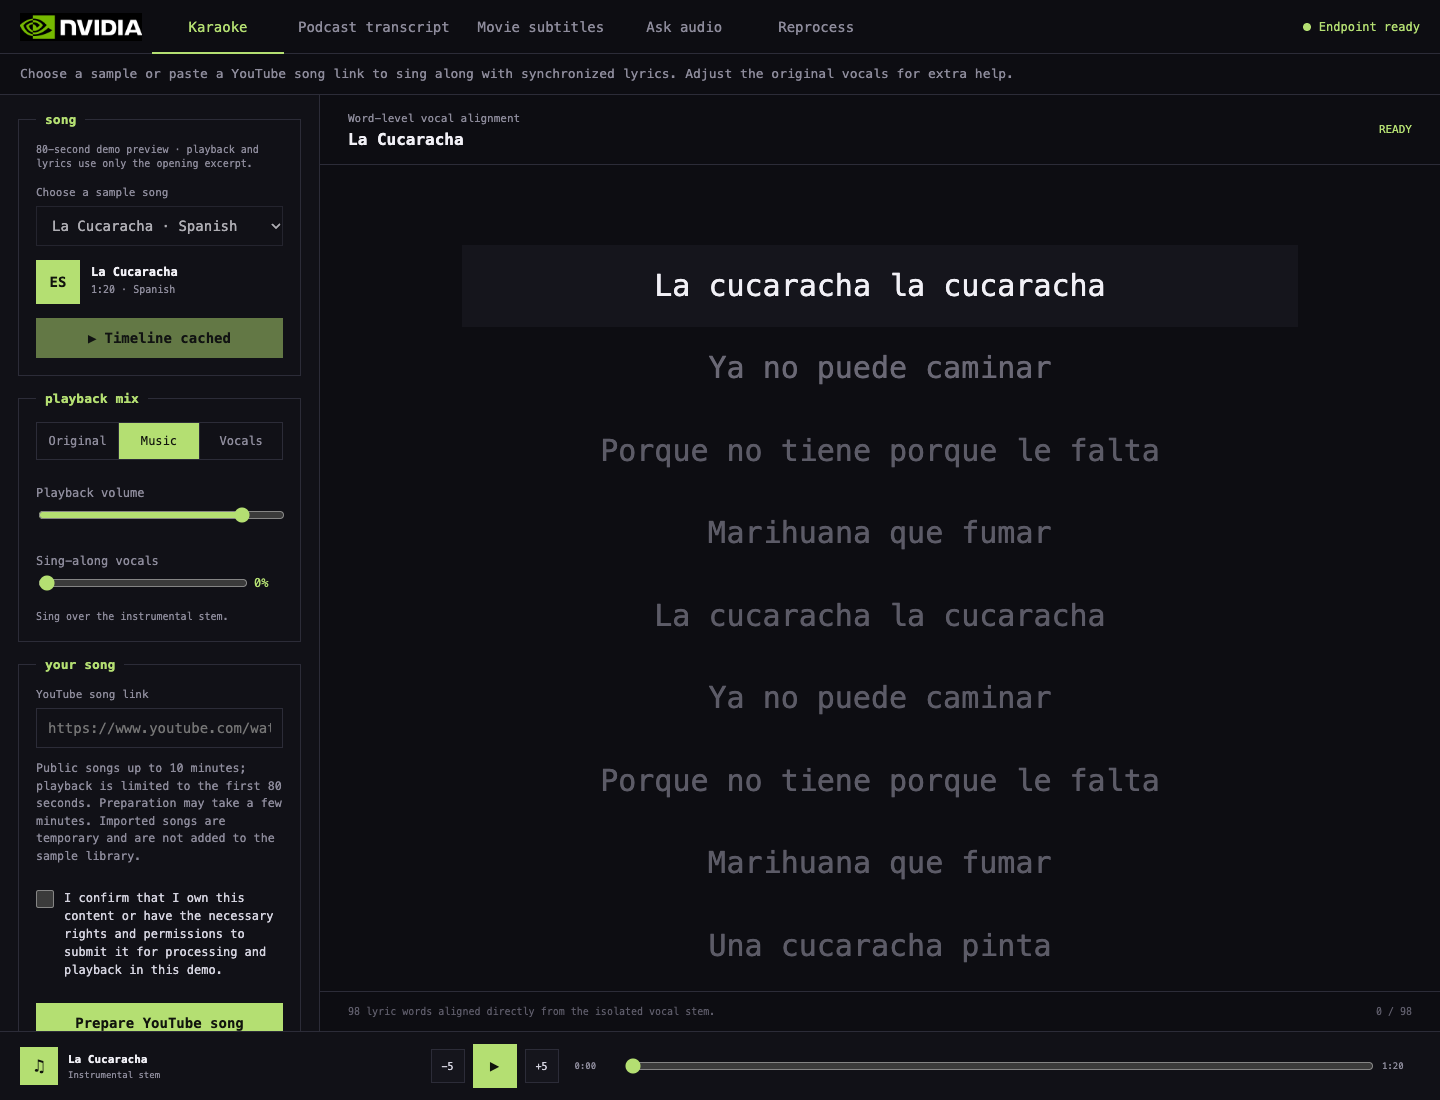
- Öffne den Space in deinem Browser. Zum Laden ist kein Konto nötig.
- Wähle einen Tab. Am 29. Oktober 2026 hatte der Space drei: Karaoke (wortgenau getimte Liedtexte), Podcast-Transkript (sprecherzugeordneter Text) und Film-Untertitel (getimte Untertitel).
- Wähle ein Beispiel oder füge einen Link ein, je nachdem, was der Tab zulässt. Der Karaoke-Tab weist darauf hin, dass seine Vorschau die ersten 60 Sekunden abdeckt.
- Führe es aus und lies die Ausgabe. Die Karaoke-Ansicht hebt jedes Wort hervor, während es gesungen wird, was die Wort-Zeitstempel zur Geltung bringt.
Behandle den Space als Demo, nicht als kostenlose API. Öffentliche Spaces teilen GPUs, reihen Anfragen in Warteschlangen ein und können sich ohne Vorankündigung ändern. Baue kein Produkt darauf auf.
Kostenloser Weg 2: die offenen Gewichte selbst betreiben
Das ist die eigentliche kostenlose Stufe: unbegrenzte Transkription auf Hardware, die du bereits hast, wobei nichts deinen Rechner verlässt. Die Lizenz (OpenMDW-1.1) erlaubt kommerzielle Nutzung, sodass du es in einem Produkt ausliefern kannst.
Der Haken ist die Hardware. NVIDIAs Referenz-Setup ist eine H100 80 GB in BF16. Die Kompatibilitätstabelle auf der Modellkarte listet:
- BF16: H100, H200, A100 80 GB, B200, GB200, DGX Spark
- FP8: H100, H200, L40S 48 GB
- Nur NVFP4: RTX 5090 (32 GB) und RTX PRO 6000 Blackwell
Eine Consumer-RTX 5090 funktioniert also, mit dem NVFP4-Checkpoint. Ältere 24-GB-Karten wie die RTX 4090 stehen nicht auf der Liste.
Der schnellste Test benötigt nur aus dem Quellcode installierte Transformers:
pip install git+https://github.com/huggingface/transformers
from transformers import AutoModelForMultimodalLM, AutoProcessor

model_id = "nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForMultimodalLM.from_pretrained(model_id, device_map="auto")

inputs = processor.apply_transcription_request("meeting.wav").to(model.device)
outputs = model.generate(**inputs, max_new_tokens=1024)
print(processor.decode(outputs[:, inputs.input_ids.shape[1]:], skip_special_tokens=True))
Das ist in Ordnung für eine Handvoll Dateien. Für Batches, lange Aufnahmen und einen OpenAI-kompatiblen Endpunkt serve es mit vLLM 0.32.0 und dem NeMo Speech Plugin. Unser Schritt-für-Schritt-Leitfaden zum lokalen Betreiben von Nemotron 3.5 Transcribe enthält die genaue Installation und den vllm serve-Befehl aus der Modellkarte.
Keine lokale GPU? Eine stundenweise anzumieten ist der günstigste „fast kostenlose“ Weg für große Rückstände. NVIDIA sagt, dass eine RTX PRO 6000 Blackwell mit dem NVFP4-Build 100 Stunden Audio in unter drei Minuten verarbeiten kann, wobei diese Zahl jedoch Serving-Optimierungen nutzt, die noch nicht Open Source sind.
Kostenloser Weg 3: Community-Spaces
Die Modellseite listet mehrere Community-Spaces, die auf demselben Checkpoint aufbauen, darunter hugging-apps/nemotron-3-5-transcribe und mrfakename/nemotron-3.5-transcribe. Sie sind nützlich, wenn die Warteschlange des NVIDIA-Space lang ist oder du ein schlichtes Upload-Feld möchtest. Sie werden von Einzelpersonen betrieben, also rechne mit Ruhephasen, Quoten und gelegentlich toten Links.
Prompts, die bessere kostenlose Ergebnisse liefern
Nemotron 3.5 Transcribe nimmt Anweisungen in natürlicher Sprache entgegen. Diese stammen aus der Modellkarte und dem DeepInfra-Eintrag. Halte den System-Prompt für die Transkription leer und verwende Temperatur 0.
Sauberer, lesbarer Text:
Audio transcription. Language: as spoken. Wording: omit fillers and accidental repetitions; keep the remaining spoken wording unchanged. Formatting: punctuation and capitalization. Output: transcript only.
Wer was gesagt hat:
Transcribe verbatim, including fillers. Write numbers as spoken, without punctuation or capitalization. Start every speaker turn with <spk:0>, <spk:1>, etc. Keep one stable tag per speaker. Output only the speaker-tagged transcript.
Produktnamen und Fachjargon:
Transcribe with punctuation and capitalization. Context terms: Apidog, OpenAPI, Kubernetes, gRPC.
Übersetzung:
Please translate the given speech to English.
Kontextbegriffe sind wichtiger, als du erwarten würdest. Auf NVIDIAs ContextASR-Benchmark sinkt der WER von 3,33 % ohne Kontext auf 1,71 % mit feinkörnigem Kontext.
Wenn kostenlos nicht ausreicht: der günstigste kostenpflichtige Weg
Wenn du keine unterstützte GPU besitzt und mehr als eine Demo brauchst, ist die gehostete API günstig. Bei DeepInfras 0,002 $ pro Minute kostet eine einstündige Aufnahme 0,12 $, und 1.000 Stunden kosten 120 $. OpenRouters 0,000033 $ pro Sekunde ergeben etwa 0,119 $ pro Stunde, weitergeleitet an denselben Anbieter.
Eine minimale DeepInfra-Anfrage, entnommen von ihrer API-Seite:
curl -X POST \
  -H "Authorization: bearer $DEEPINFRA_API_KEY" \
  -F audio=@meeting.mp3 \
  'https://api.deepinfra.com/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B'
Die Antwort enthält text, segments mit Start- und Endzeiten, words und die erkannte language. Unser API-Leitfaden behandelt Schlüssel, Antwortfelder und Kosten im Detail.
Lass deinen Coding-Agent den Endpunkt mit der Apidog CLI testen
Ob du selbst hostest oder DeepInfra nutzt, du willst eine Prüfung, die laut fehlschlägt, wenn eine Transkription leer oder in der falschen Sprache zurückkommt. Übertrage diese Aufgabe deinem Coding-Agent und der Apidog CLI, statt JSON mit bloßem Auge zu prüfen.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick Claude Code, Codex, Cursor or OpenCode
Gib deinem Agent dann einen Prompt:
In Apidog project <id>, create a test case for POST {{baseUrl}}/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
that uploads samples/hello.mp3 as the "audio" form field, asserts status 200, a non-empty "text",
"language" equal to "en", and at least one item in "words", then run it against the
deepinfra environment and summarize any failures.
Der Agent liest das Schema, validiert seine Payload, schreibt den Testfall und führt ihn aus:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Wechsle die Umgebung so, dass sie auf deinen lokalen Server zeigt, wenn du von der API zum Selbst-Hosting wechselst. Dasselbe apidog run mit -r junit fügt sich in CI ein; siehe Apidog CLI in einer CI/CD-Pipeline ausführen und Apidog CLI in Claude Code für die Einrichtung.
Limits, die du kennen solltest, bevor du dich darauf verlässt
- Nur offline. Es streamt nicht. NVIDIA verweist für Live-Audio auf ein separates Nemotron 3.5 ASR Streaming-Modell.
- Audio-Q&A ist nur auf Englisch. Die Transkription deckt 40 Sprachen ab, aber Audiоverständnis und gesprochene Anweisungen wurden nur auf Englisch evaluiert.
- Sprecherbezeichnungen sind keine Identitäten.
<spk:0>bedeutet „die erste Stimme“, keine namentlich bekannte Person. - Lange Ausgaben brauchen Platz. Ein dichtes einstündiges Gespräch kann etwa 20.000 Ausgabe-Token erzeugen, also setze
max_new_tokensentsprechend. - Es kann halluzinieren. Die Karte warnt, dass es bei unklarem Audio „ein plausibles Transkript erzeugen“ kann. Prüfe alles Rechtliche oder Medizinische.
FAQ
Ist Nemotron 3.5 Transcribe kostenlos für kommerzielle Nutzung? Ja. Die OpenMDW-1.1-Lizenz erlaubt kommerzielle und nicht-kommerzielle Nutzung der Gewichte. Gehostete APIs berechnen Rechenleistung.
Gibt es einen kostenlosen Nemotron 3.5 Transcribe API-Schlüssel? Nicht, was wir am 29. Oktober 2026 gefunden haben. DeepInfra und OpenRouter sind kostenpflichtig, und es ist noch nicht auf build.nvidia.com. Vergleiche das mit NVIDIAs kostenloser API für Nemotron Nano 12B v2 VL, die einen kostenlosen Test-Endpunkt erhalten hat.
Kann ich es auf einem Mac ausführen? Nicht laut der offiziellen Liste. Unterstützte Laufzeitumgebungen zielen auf NVIDIA-GPUs unter Linux oder Windows (WSL2). GGML-Unterstützung ist nur für RTX 5090 und RTX PRO 6000 gelistet.
Wie schlägt es sich im Vergleich zu Whisper? Auf dem Leaderboard vom 28. Oktober erreicht es im Durchschnitt 5,33 % WER gegenüber 7,16 % für whisper-large-v3. Siehe unseren Whisper-API-Leitfaden für OpenAIs gehostete Option und unsere Rangliste der besten Open-Source-Speech-to-Text-Modelle für das gesamte Feld.
Unterstützt es MP3? Ja. Es akzeptiert WAV, FLAC, MP3, OGG oder alles, was zu 16 kHz Mono-PCM dekodiert. Verwende FFmpeg, um andere Formate zu konvertieren.
Das Fazit
Nemotron 3.5 Transcribe ist kostenlos, wo es zählt: die Gewichte, die Lizenz und NVIDIAs Demo. Probiere den Space für einen Qualitätscheck aus, hoste selbst auf einer H100, L40S oder RTX 5090 für unbegrenzte private Nutzung und greife auf DeepInfra zu 0,12 $ pro Stunde zurück, wenn du die Hardware nicht hast. Welchen Weg du auch wählst, lass deinen Agent Apidog-Prüfungen auf dem Endpunkt ausführen, damit ein schlechtes Transkript nie die Produktion erreicht.