Die Transkription einer einstündigen Aufnahme mit NVIDIAs neuer Nemotron 3.5 Transcribe API kostet 12 Cent. Das ist DeepInfras Preis von 0,002 $ pro Minute für das beste Open-Weight-Modell im Hugging Face Open ASR Leaderboard – ein Modell, das im selben Aufruf außerdem Wort-Zeitstempel, Sprecher-Labels und die erkannte Sprache zurückgibt.
Diese Anleitung zeigt, wie Sie einen API-Schlüssel erhalten, Ihre erste Anfrage senden, die Antwort lesen, Prompts für Sprecher-Labels und Fachjargon schreiben und die Kosten planbar halten. Alles unten wurde am 29. Oktober 2026 gegen die DeepInfra-Modellseite, den OpenRouter-Eintrag und die offizielle Modellkarte geprüft.
Sie suchen stattdessen einen Weg für 0 $? Lesen Sie wie Sie Nemotron 3.5 Transcribe kostenlos verwenden.
Was die Nemotron 3.5 Transcribe API bietet
NVIDIA hat Nemotron 3.5 Transcribe (NVIDIA-Nemotron-3.5-Transcribe-30B-A4B) am 28. Oktober 2026 veröffentlicht. Es ist ein Open-Weight-Sprachmodell mit insgesamt 34B Parametern und etwa 4,3B aktiven Parametern, das auf einem hybriden Mamba-2- und Transformer-Mixture-of-Experts-Sprachmodell mit einem aufgesetzten ASR-Encoder und einem Sprecher-Encoder basiert.
Über einen einzigen Endpunkt erhalten Sie:
- Transkription in 40 Sprachen
- Dateien bis zu einer Stunde Länge
- Wort-Zeitstempel und Segment-Zeitstempel
- Sprecherzugeordnete Transkripte mit bis zu acht Sprechern
- Sprachübersetzung über 31 Sprachen nach und aus dem Englischen
- Kontext-Prompting für Namen, Produkte und Fachjargon
- Sprachidentifikation
Im Open ASR Leaderboard (aktualisiert am 28. Oktober 2026) erreicht es durchschnittlich 5,33 % WER, Platz 9 von 61 Modellen und Platz 1 unter Modellen mit öffentlichen Gewichten. Die acht Modelle darüber sind geschlossene kommerzielle APIs.
Es ist ein Offline-Modell. Senden Sie aufgezeichnete Dateien, keinen Live-Stream.
Wo man es aufruft und was es kostet
Bei diesen Preisen kosten 1.000 Stunden Audio etwa 120 $. Zum Vergleich: Die OpenAI Whisper API hat historisch 0,006 $ pro Minute berechnet, das Dreifache von DeepInfras Preis, und whisper-large-v3 liegt im selben Leaderboard mit 7,16 % WER auf Platz 41.
Schritt 1: DeepInfra-API-Schlüssel erhalten
- Erstellen Sie ein Konto auf deepinfra.com.
- Öffnen Sie das Dashboard und erstellen Sie einen API-Schlüssel.
- Fügen Sie eine Zahlungsmethode oder Guthaben hinzu. Die Modellseite erfordert selbst für die Browser-Demo eine Anmeldung.
- Exportieren Sie den Schlüssel in Ihrer Shell:
export DEEPINFRA_API_KEY="your_key_here"
Halten Sie den Schlüssel aus der Quellcodeverwaltung heraus. Wenn Sie über einen Coding-Agenten arbeiten, legen Sie ihn in der Umgebung des Agenten ab, nicht in einem Prompt.
Schritt 2: erste Datei transkribieren
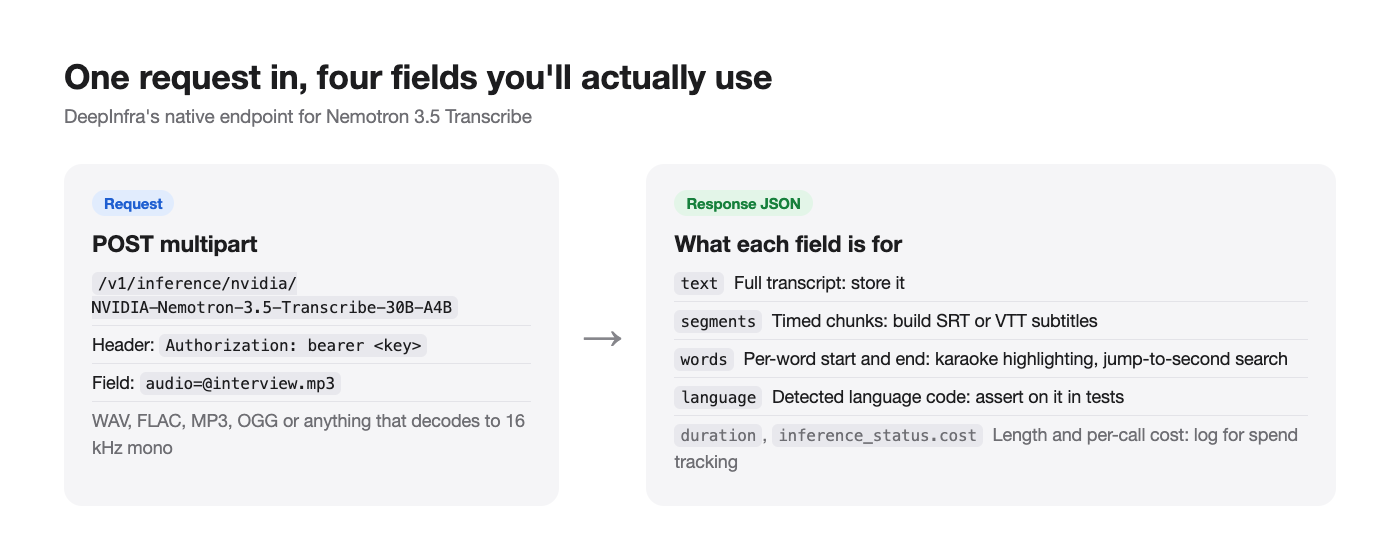
DeepInfras nativer Inference-Endpunkt nimmt einen Multipart-Upload mit einem audio-Feld entgegen. Dies ist die exakte Anfrageform von der API-Seite:
curl -X POST \
  -H "Authorization: bearer $DEEPINFRA_API_KEY" \
  -F audio=@interview.mp3 \
  'https://api.deepinfra.com/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B'
Das Modell akzeptiert WAV, FLAC, MP3, OGG oder jedes Format, das zu 16 kHz Mono-PCM dekodiert. Wenn Sie M4A- oder Videodateien haben, konvertieren Sie sie zuerst mit FFmpeg:
ffmpeg -i call.m4a -ar 16000 -ac 1 call.wav
Schritt 3: die Antwort lesen
DeepInfra dokumentiert diese Antwortstruktur (die folgenden Werte sind beispielhaft):
{
  "text": "Hello World",
  "segments": [
    { "id": 0, "start": 0.0, "end": 1.0, "text": "Hello" },
    { "id": 1, "start": 4.0, "end": 5.0, "text": "World" }
  ],
  "language": "en",
  "words": [
    { "start": 0.0, "end": 1.0, "text": "Hello" },
    { "start": 4.0, "end": 5.0, "text": "World" }
  ],
  "duration": 5.0,
  "inference_status": { "status": "succeeded", "runtime_ms": 0, "cost": 0.0 }
}
Wofür die einzelnen Felder stehen:
textist das vollständige Transkript. Speichern Sie dies.segmentsliefert zeitlich markierte Abschnitte. Verwenden Sie sie für Untertitel (SRT oder VTT).wordsliefert das Timing pro Wort. Verwenden Sie es für karaokeartige Hervorhebungen oder eine Suche, die zur exakten Sekunde springt.languageist der erkannte Sprachcode. Prüfen Sie ihn in Tests; eine falsche Sprache ist ein häufiger Fehler bei kurzen Clips.inference_status.costgibt an, was der Aufruf gekostet hat. Protokollieren Sie ihn, um die Ausgaben pro Datei zu verfolgen.
Schritt 4: aus Python aufrufen
import os
import requests

URL = "https://api.deepinfra.com/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B"

def transcribe(path: str) -> dict:
    with open(path, "rb") as f:
        r = requests.post(
            URL,
            headers={"Authorization": f"bearer {os.environ['DEEPINFRA_API_KEY']}"},
            files={"audio": f},
            timeout=600,
        )
    r.raise_for_status()
    return r.json()

result = transcribe("interview.mp3")
print(result["language"], len(result["words"]), "words")
print(result["text"][:500])
Setzen Sie ein langes Timeout. Eine volle Stunde dichter Sprache kann etwa 20.000 Ausgabe-Tokens erzeugen, und die Modellkarte warnt, dass lange Jobs Zeit brauchen.
DeepInfra listet für das Modell außerdem einen Tab „OpenAI Speech-to-Text“, sodass OpenAI-SDK-Code, der audio.transcriptions aufruft, wahrscheinlich auf DeepInfras OpenAI-kompatible Basis-URL zeigen kann. Prüfen Sie diesen Tab auf die exakte Basis-URL, bevor Sie Produktionscode umstellen.
Prompts: wörtlich, bereinigt, Sprecher, Fachjargon
Was Nemotron 3.5 Transcribe von älteren ASR-APIs unterscheidet, ist, dass es Anweisungen entgegennimmt. NVIDIAs empfohlene Prompts, wie auf der DeepInfra-Seite aufgeführt:
| Was Sie möchten | Anweisung |
|---|---|
| Wörtliche Wiedergabe | Audio transcription. Language: as spoken. Wording: verbatim, including fillers and repetitions. Formatting: punctuation and capitalization. Output: transcript only. |
| Lesbarer Text | Audio transcription. Language: as spoken. Wording: omit fillers and accidental repetitions; keep the remaining spoken wording unchanged. Formatting: punctuation and capitalization. Output: transcript only. |
| Domänenvokabular | Transcribe with punctuation and capitalization. Context terms: <names and terms>. |
| Wer was gesagt hat | Transcribe verbatim, including fillers. ... Start every speaker turn with <spk:0>, <spk:1>, etc. Keep one stable tag per speaker. |
| Übersetzung | Please translate the given speech to <target language>. |
Verwenden Sie Temperatur 0 mit deaktiviertem Reasoning für Transkription, Übersetzung und Sprach-ID und halten Sie den System-Prompt leer.
Kontextbegriffe zahlen sich aus. NVIDIA berichtet, dass der ContextASR-Bench-WER von 3,33 % ohne Kontext auf 1,71 % mit feingranularem Kontext fällt und contextual Earnings22 von 12,54 % auf 9,58 %. Übergeben Sie bei einem Earnings Call die Firmennamen, Ticker und Namen der Führungskräfte.
Prüfen Sie den Tab für das Eingabeschema von DeepInfra auf das Feld, das die Anweisung am nativen Endpunkt transportiert. Auf einem selbst gehosteten Server geht die Anweisung in die Chat-Nachricht neben dem Audio, wie in unserer Anleitung für lokales Setup gezeigt.
OpenRouter stattdessen verwenden
Wenn Sie OpenRouter bereits für LLMs verwenden, können Sie einen Schlüssel und eine Rechnung behalten. Die Modell-ID ist nvidia/nemotron-3.5-transcribe, bepreist mit 0,000033 $ pro Sekunde, wobei DeepInfra am 29. Oktober 2026 der einzige gelistete Anbieter war (100 % Uptime, zu diesem Zeitpunkt etwa eine Sekunde Latenz). Kopieren Sie das Anfrageformat aus dem API-Tab des Modells auf OpenRouter, da Audio-Endpunkte sich von Chat Completions unterscheiden.
Der Kompromiss: OpenRouter fügt einen Netzwerk-Hop hinzu, und heute gibt es kein Anbieter-Failover, weil nur ein Anbieter das Modell bedient.
Kosten planbar halten
- Zuerst Stille entfernen. Sie zahlen pro Minute Audio, nicht pro Minute Sprache. Tote Luft aus Aufnahmen zu schneiden, senkt die Rechnung.
- Downmixen und neu abtasten. 16 kHz Mono verwendet das Modell ohnehin; Stereo mit 48 kHz zu senden, erhöht nur die Upload-Zeit.
- Nach Datei bündeln, nicht nach Chunk. Das Modell verarbeitet eine Stunde in einer Anfrage. Eine Datei in 30-Sekunden-Stücke aufzuteilen, zerstört Sprecher-Labels und Kontext.
inference_status.costprotokollieren. Summieren Sie ihn pro Kunde oder pro Job.- Oberhalb stetigen Volumens selbst hosten. NVIDIAs optimiertes NIM verarbeitet bis zu 2.238 Sekunden Audio pro Sekunde auf einer RTX PRO 6000 Blackwell. Wenn Sie Tausende Stunden pro Monat transkribieren, schlägt eine gemietete GPU die Preisgestaltung pro Minute. Beachten Sie, dass der Open-Source-vLLM-Pfad voraussichtlich etwa doppelt so langsam ist wie dieser NIM-Wert.
Lassen Sie Ihren Coding-Agenten es mit Apidog CLI testen
Transkriptions-APIs schlagen leise fehl: ein 200 mit leerem text, ein spanischer Clip, der als Portugiesisch erkannt wird, oder fehlende words nach einem Anbieter-Update. Statt JSON von Hand zu prüfen, lassen Sie Ihren Coding-Agenten die Checks mit Apidog CLI schreiben und ausführen.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Geben Sie Ihrem Agenten dann einen Prompt:
In Apidog project <id>, add the DeepInfra endpoint POST
https://api.deepinfra.com/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
with a multipart "audio" field and a bearer token from {{DEEPINFRA_API_KEY}}.
Create a test case per file in samples/ (en.mp3, es.mp3, two-speakers.wav) asserting
status 200, non-empty "text", the expected "language", and "words" length > 0.
Run them against the prod environment and report failures with the response body.
Der Agent liest das Schema, validiert seine Payload, schreibt die Testfälle und führt sie aus:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Fügen Sie -r junit hinzu, und derselbe Befehl wird zu einem CI-Gate. Siehe Apidog CLI in einer CI/CD-Pipeline und Apidog CLI in Claude Code für das vollständige Setup.
FAQ
Wie hoch ist der Preis für die Nemotron 3.5 Transcribe API? 0,002 $ pro Minute auf DeepInfra und 0,000033 $ pro Sekunde auf OpenRouter, Stand 29. Oktober 2026. Das sind etwa 0,12 $ pro Stunde Audio bei beiden.
Gibt es einen kostenlosen API-Schlüssel? Wir haben keinen gefunden. Das Modell ist noch nicht auf build.nvidia.com. Die kostenlosen Wege sind NVIDIAs Demo-Space und Selbst-Hosting; siehe die kostenlose Anleitung.
Wie lang darf eine Datei maximal sein? Eine Stunde pro Anfrage, mit einem Kontext von 65.536 Tokens.
Streamt die API Ergebnisse? Nein. Es ist ein Offline-Modell, das das Transkript zurückgibt, wenn die Datei fertig ist.
Welche Sprachen werden unterstützt? 40, bewertet in drei Stufen. Zu den 13 „führenden“ Sprachen gehören Englisch, Spanisch, Französisch, Deutsch, Italienisch, Portugiesisch, Hindi, Koreanisch, Russisch und Polnisch. Japanisch, Türkisch und Ukrainisch sind „produktionsreif“. Mandarin-Chinesisch und Arabisch werden „unterstützt“.
Wie schlägt es sich im Vergleich zu anderen Sprach-APIs? Siehe unsere Rangliste der besten Open-Source-Speech-to-Text-Modelle und die ältere Zusammenstellung der Top-Text-to-Speech- und Speech-to-Text-APIs.
Mit der Transkription beginnen
Holen Sie sich einen DeepInfra-Schlüssel, senden Sie ein curl mit einer MP3, und Sie erhalten zeitlich markierten, sprachlich gekennzeichneten Text für 0,002 $ pro Minute zurück. Fügen Sie Kontextbegriffe für Ihre Domäne hinzu, verwenden Sie den Sprecher-Prompt für Meetings und lassen Sie Ihren Agenten bei jedem Release Apidog-Checks ausführen, damit niemals eine stille Regression ausgeliefert wird.