
Mistral war eine Weile im Top-Segment eher ruhig. Mistral Large 3 wurde im Dezember 2025 veröffentlicht, und seitdem drehte sich die Diskussion im Bereich der Open-Weight-Modelle um Kimi, DeepSeek, GLM und Qwen. Am 6. Oktober 2026 antwortete Mistral mit Mistral Large 4, einem Modell mit 1 Billion Parametern, das das Team „Le Chonk“ nennt.
Die Schlagzeile ist ein Cyber-Benchmark, bei dem Large 4 82 % erreicht, während Claude Opus 5.5 und GPT-6 Astra nahezu null Punkte erzielen. Das stimmt, es steht auf Mistrals Startseite, und es bedarf eines einzigen Satzes Kontext, bevor Sie es teilen. Dieser Artikel liefert Ihnen diesen Kontext, die Spezifikationen, den tatsächlichen Preis und wo Large 4 immer noch verliert.
TL;DR
- Was es ist: ein Mixture-of-Experts-Modell mit 1,05 Billionen Parametern, davon 49 Milliarden aktiv, einem 1,6 Milliarden Vision-Encoder, Text- und Bildeingabe und einem Kontextfenster von 1 Million Token.
- Wo man es bekommt: öffentliche Vorschau auf der Mistral API heute als
mistral-large-4. Gewichte „bis Ende des Monats“, also um den 27. Oktober herum. - Preis: 1,36 $ Eingabe / 4,18 $ Ausgabe pro Million Token zum Listenpreis, derzeit während der Vorschau bei 0,68 $ / 2,09 $ angegeben. Der Preis für gecachte Eingaben beträgt 0,07 $.
- Der Cyber-Sieg: 82 % im AA Cyber Index Reproduktionstest für Schwachstellen. Opus 5.5 und Astra erzielen nahezu null Punkte, weil sie die Aufgabe verweigern, nicht weil sie sie nicht bestehen.
- Der tatsächliche Verlust: Bei der von Menschen bewerteten Codierung erreichte Claude Opus 5 4,22 Punkte und Large 4 3,74 Punkte.
Warum „Mistral ist zurück“ berechtigt ist
Den größten Teil des Jahres 2026 kamen die stärksten Open-Weight-Modelle aus China. Mistral lieferte weiterhin Modelle wie Medium 3.5, Devstral 2 und Small 4 aus, aber nichts, was mit den führenden geschlossenen Modellen auf deren eigenem Terrain konkurrieren konnte.
Large 4 ändert die Situation. Mistral behauptet, es „übertrifft jedes in den USA oder Europa entwickelte Open-Weight-Modell signifikant“, und untermauert dies mit einer Trainingsgeschichte, die auf das Publikum abzielt, das Wert auf EU-Souveränität legt. Das Modell wurde von Grund auf auf 3.800 NVIDIA Grace Blackwell GPUs in Mistrals eigenen europäischen Rechenzentren trainiert, deckt mehr als 160 Sprachen ab, einschließlich jeder offiziellen EU-Sprache, und erscheint Wochen nach einer Series-D-Finanzierungsrunde über 3 Milliarden Euro, die Mistral als die größte Eigenkapitalrunde bezeichnet, die jemals von einem europäischen Technologieunternehmen aufgenommen wurde.
Auch das Timing ist entscheidend. Large 4 kam direkt nachdem Reflection sein Open-Weight-Modell Beam vorgestellt hatte, sodass das Rennen der Open-Modelle zwischen den USA und China nun einen dritten ernsthaften Teilnehmer hat.
Die Cyber-Schlagzeile und der Haken
Hier ist das Ergebnis, das jeder als Screenshot festhält. Der Artificial Analysis Cyber Index enthält einen Test, der ein Modell auffordert, eine echte Schwachstelle in Open-Source-Software zu reproduzieren und sie dann zu patchen. Mistral sagt, dass Large 4 82 % erreicht, der höchste Wert aller Modelle.
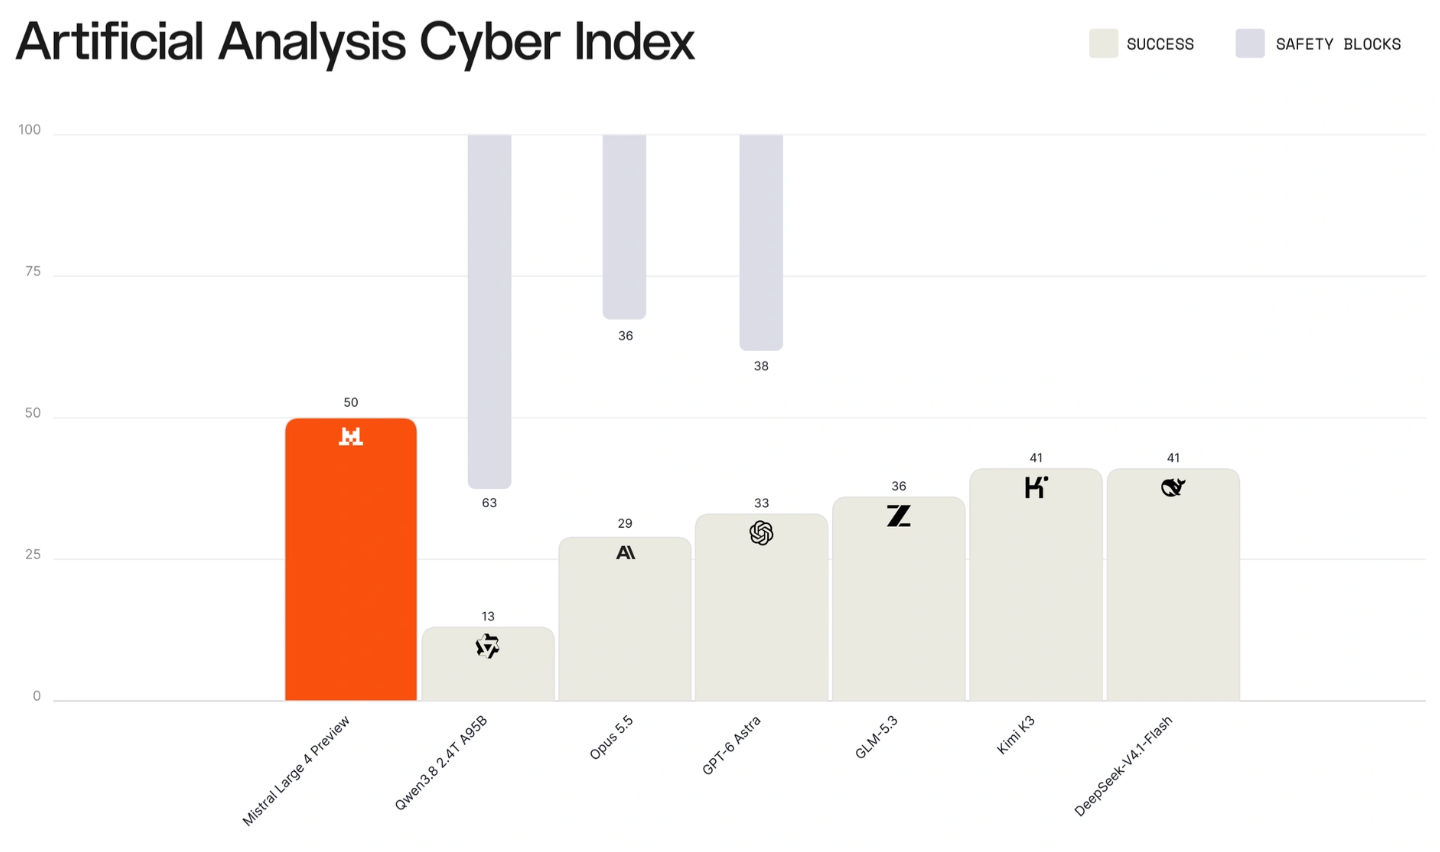
Dann der Haken, in Mistrals eigenen Worten: „Mehrere führende geschlossene Modelle, darunter Claude Opus 5.5 und GPT-6 Astra, erzielen bei demselben Test nahezu null Punkte, weil sie die Durchführung der Aufgabe verweigern.“
Lesen Sie es also so:
| Behauptung | Was es tatsächlich bedeutet |
|---|---|
| „Large 4 schlägt Astra und Opus 5.5 im Cyber-Bereich“ | Bei diesem einen Test lehnen die geschlossenen Modelle eine Antwort ab. Large 4 antwortet und ist in der Regel erfolgreich. |
| „Large 4 ist das beste Hacking-Modell“ | Nicht nachgewiesen. Eine Verweigerung ist eine politische Entscheidung, keine Leistungsgrenze. |
| „Large 4 ist unsicher“ | Ebenfalls nicht nachgewiesen. Mistral berichtet, dass seine durchschnittliche Ablehnungsrate bei Cyber-Prompts von JailbreakBench, StrongREJECT und AgentHarm höher ist als bei jedem anderen Open-Weight-Modell. |
Hinter der Schlagzeile steckt echte Leistungsfähigkeit. Large 4 löst auch 93 % von Cybench, einer Reihe von 40 Capture-the-Flag-Übungen, was Mistral als eines der höchsten gemeldeten Ergebnisse für ein Open-Weight-Modell bezeichnet. Beim B3 Agent Security Benchmark widersteht es 93,3 % der Angriffe.
Für Sicherheitsteams ist diese Kombination die eigentliche Geschichte: ein Modell, das Sie selbst hosten können, das bei der Reproduktion und Behebung einer CVE in Ihrem eigenen Code hilft, während es die meisten eindeutig schädlichen Anfragen weiterhin ablehnt. Für API-Teams ist dies ein nützliches Werkzeug, das auf der eigenen Hardware läuft, anstatt hinter dem Policy-Filter eines anderen zu stecken.
Wo Large 4 GPT-6 Astra außerhalb des Cyber-Bereichs schlägt
Das Cyber-Ergebnis ist das lauteste. Zwei weitere Siege gegen Astra sind leiser und bedeutsamer, da beide Modelle die Aufgabe tatsächlich versucht haben:
| Benchmark | Mistral Large 4 | GPT-6 Astra | Anmerkungen |
|---|---|---|---|
| Dense 200 (visuelle Verankerung) | 42% | 41% | Ein Ein-Punkt-Vorsprung. Real, aber gering. |
| Finance Agent v2 (vals.ai) | Vorn | Hinten | Mistral meldet die Rangliste, nicht die Punktzahlen. |
| Harvey Legal Agent Benchmark | Bestes Open-Modell | Aufgeführt | Keine direkten Zahlen veröffentlicht. |
Gegenüber anderen Open-Modellen ist der Vorsprung größer:
| Benchmark | Mistral Large 4 | Wen es schlägt |
|---|---|---|
| AutomationBench (657 Workflows) | 59.9% | Kimi K3, DeepSeek V4 Pro |
| AA-Briefcase (Wissensarbeit) | 1.393 Elo | DeepSeek V4 Pro |
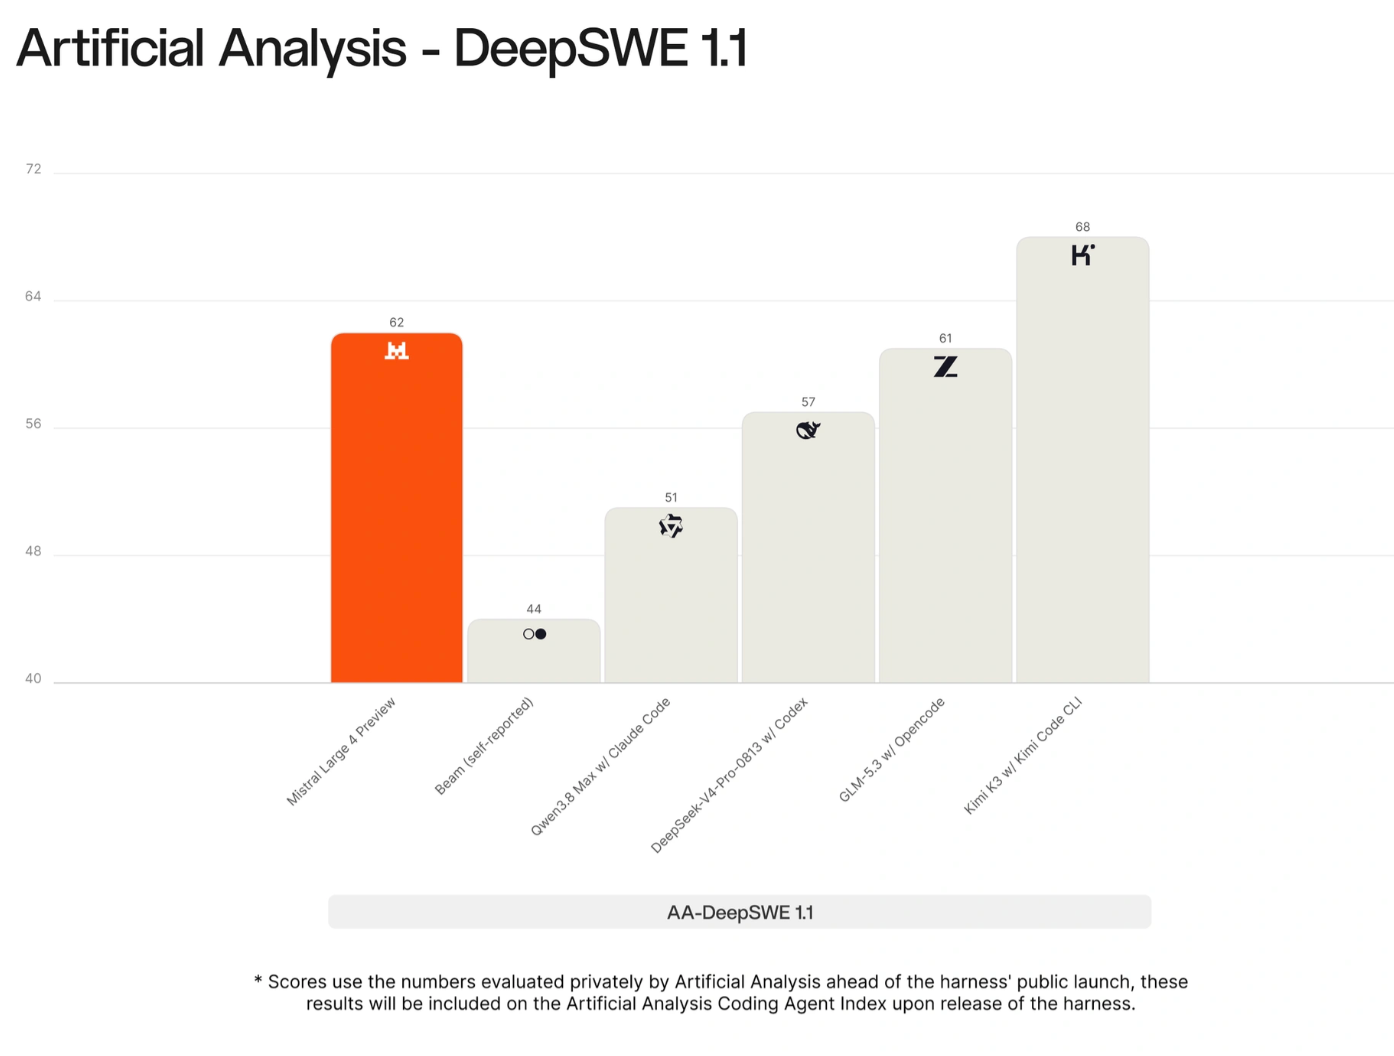
| DeepSWE v1.1 (Codierung) | 61.7% | Führt Open-Weight-Modelle an |
| SWE-Atlas-QnA | 59.4% | |
| Terminal-Bench 4.0 | 28.3% |
All dies sind von Mistral gemeldete Zahlen des Vorschau-Modells. Noch kein unabhängiges Labor hat sie erneut ausgeführt, und Euronews berichtet, dass das Reinforcement Learning zum Zeitpunkt des Starts noch nicht abgeschlossen war. Betrachten Sie sie als ein starkes Signal, nicht als ein Urteil.
Wo es immer noch verliert
Mistral veröffentlichte ein Ergebnis, bei dem ein geschlossenes Modell eindeutig gewinnt. Bei einer menschlichen Bewertung der Codequalität, die von Surge AI über fünf Modelle durchgeführt wurde, belegte Large 4 Preview den zweiten Platz:
| Modell | Menschliche Codebewertung (von 5) |
|---|---|
| Claude Opus 5 | 4.22 |
| Mistral Large 4 Preview | 3.74 |
| GLM-5.3 | 3.60 |
| Kimi K3 | 3.59 |
| GLM-5.2 | 3.40 |
Das ist ein klarer Sieg über die besten chinesischen Open-Modelle und ein Halbpunkt-Rückstand gegenüber Claude. Mistrals eigene Formulierung besagt, dass Large 4 „die Lücke zu den führenden Modellen“ in der Codierung schließt, was eine ehrliche Einschätzung ist.
Ebenfalls fehlend: Es gibt nirgendwo in den Startmaterialien einen Vergleich mit Claude Fable 5.1 oder GPT-6 Sol. Wenn Ihnen jemand sagt, Large 4 schlägt Fable, fragen Sie nach dem Benchmark.
Spezifikationen auf einen Blick
| Spezifikation | Mistral Large 4 |
|---|---|
| API-Modell-ID | mistral-large-4 (Alias mistral-large-4-0) |
| Version | 26.10, öffentliche Vorschau |
| Architektur | Mixture-of-Experts, hybride Instruktion + Reasoning |
| Parameter | Insgesamt 1,05 T, 49 B aktiv, 1,6 B Vision-Encoder |
| Kontextfenster | 1 M Token |
| Eingabe | Text, Bilder |
| Reasoning (Denkprozess) | reasoning_effort Parameter ("high" oder "none") |
| Tools | Funktionsaufruf, strukturierte Ausgaben, integrierte Agenten-Tools |
| Endpunkte | /v1/chat/completions, /v1/conversations, /v1/agents, /v1/batch |
| Gewichte | Offen, bis Ende Oktober 2026; Lizenz noch nicht veröffentlicht |
Preis: Das günstigste Frontier-Klasse-Modell, das Sie heute aufrufen können
Dieser Teil sollte API-Teams aufhorchen lassen. Mistrals Preisseite listet Large 4 während der Vorschau zum halben Listenpreis:
| Modell | Eingabe / 1 Mio. | Ausgabe / 1 Mio. | Open Weights |
|---|---|---|---|
| Mistral Large 4 (Vorschaupreis) | 0,68 $ | 2,09 $ | Ja, Ende Oktober |
| Mistral Large 4 (Listenpreis) | 1,36 $ | 4,18 $ | Ja, Ende Oktober |
| Claude Opus 5.5 | 4,00 $ | 20,00 $ | Nein |
| GPT-6 Astra | 10,00 $ | 50,00 $ | Nein |
Zum Vorschaupreis kosten die Large 4-Ausgaben etwa ein Vierundzwanzigstel derer von Astra. Selbst zum Listenpreis ist es bei der Ausgabe etwa 12-mal günstiger. Gecachte Eingaben sinken auf 0,07 $ pro Million, was für Agenten wichtig ist, die bei jeder Runde denselben System-Prompt und dieselben Tool-Definitionen erneut senden.
Mistral hat nicht mitgeteilt, wann der Vorschau-Rabatt endet, planen Sie also mit dem Listenpreis.
Sollten Sie wechseln?
- Sie agentische Workflows oder die Automatisierung von Wissensarbeit betreiben und Frontier-Preise zahlen. AutomationBench und AA-Briefcase deuten darauf hin, dass Large 4 hier zu einem Bruchteil der Kosten wettbewerbsfähig ist.
- Sie mehrsprachige Ausgaben über EU-Sprachen hinweg oder EU-gehostete Inferenz für die Compliance benötigen.
- Sie defensive Sicherheitsarbeit leisten und immer wieder auf Ablehnungen bei der Reproduktion legitimer Schwachstellen stoßen.
- Sie ein Modell der Frontier-Klasse wünschen, das Sie in wenigen Wochen selbst hosten können.
- Codequalität Ihre Hauptmetrik ist. Claude ist bei der von Menschen bewerteten Codierung immer noch führend.
- Sie Zahlen benötigen, die Sie in einer Überprüfung verteidigen können. Warten Sie auf unabhängige Benchmarks, nachdem die Gewichte veröffentlicht wurden.
- Sie Large 3 in der Produktion einsetzen. Die Vorschau kann sich noch ändern, und Mistral hat noch keine stabile versionierte ID veröffentlicht.
Wie Sie Large 4 in Apidog gegen Ihre eigenen APIs testen
Benchmarks sagen Ihnen, wie ein Modell bei Aufgaben anderer abschneidet. Der schnellere Weg zur Entscheidung ist, Large 4 mit Ihren eigenen Prompts auszuführen und es mit dem Modell zu vergleichen, für das Sie heute bezahlen. Apidog erledigt dies ohne eine Zeile zusätzlichen Code:
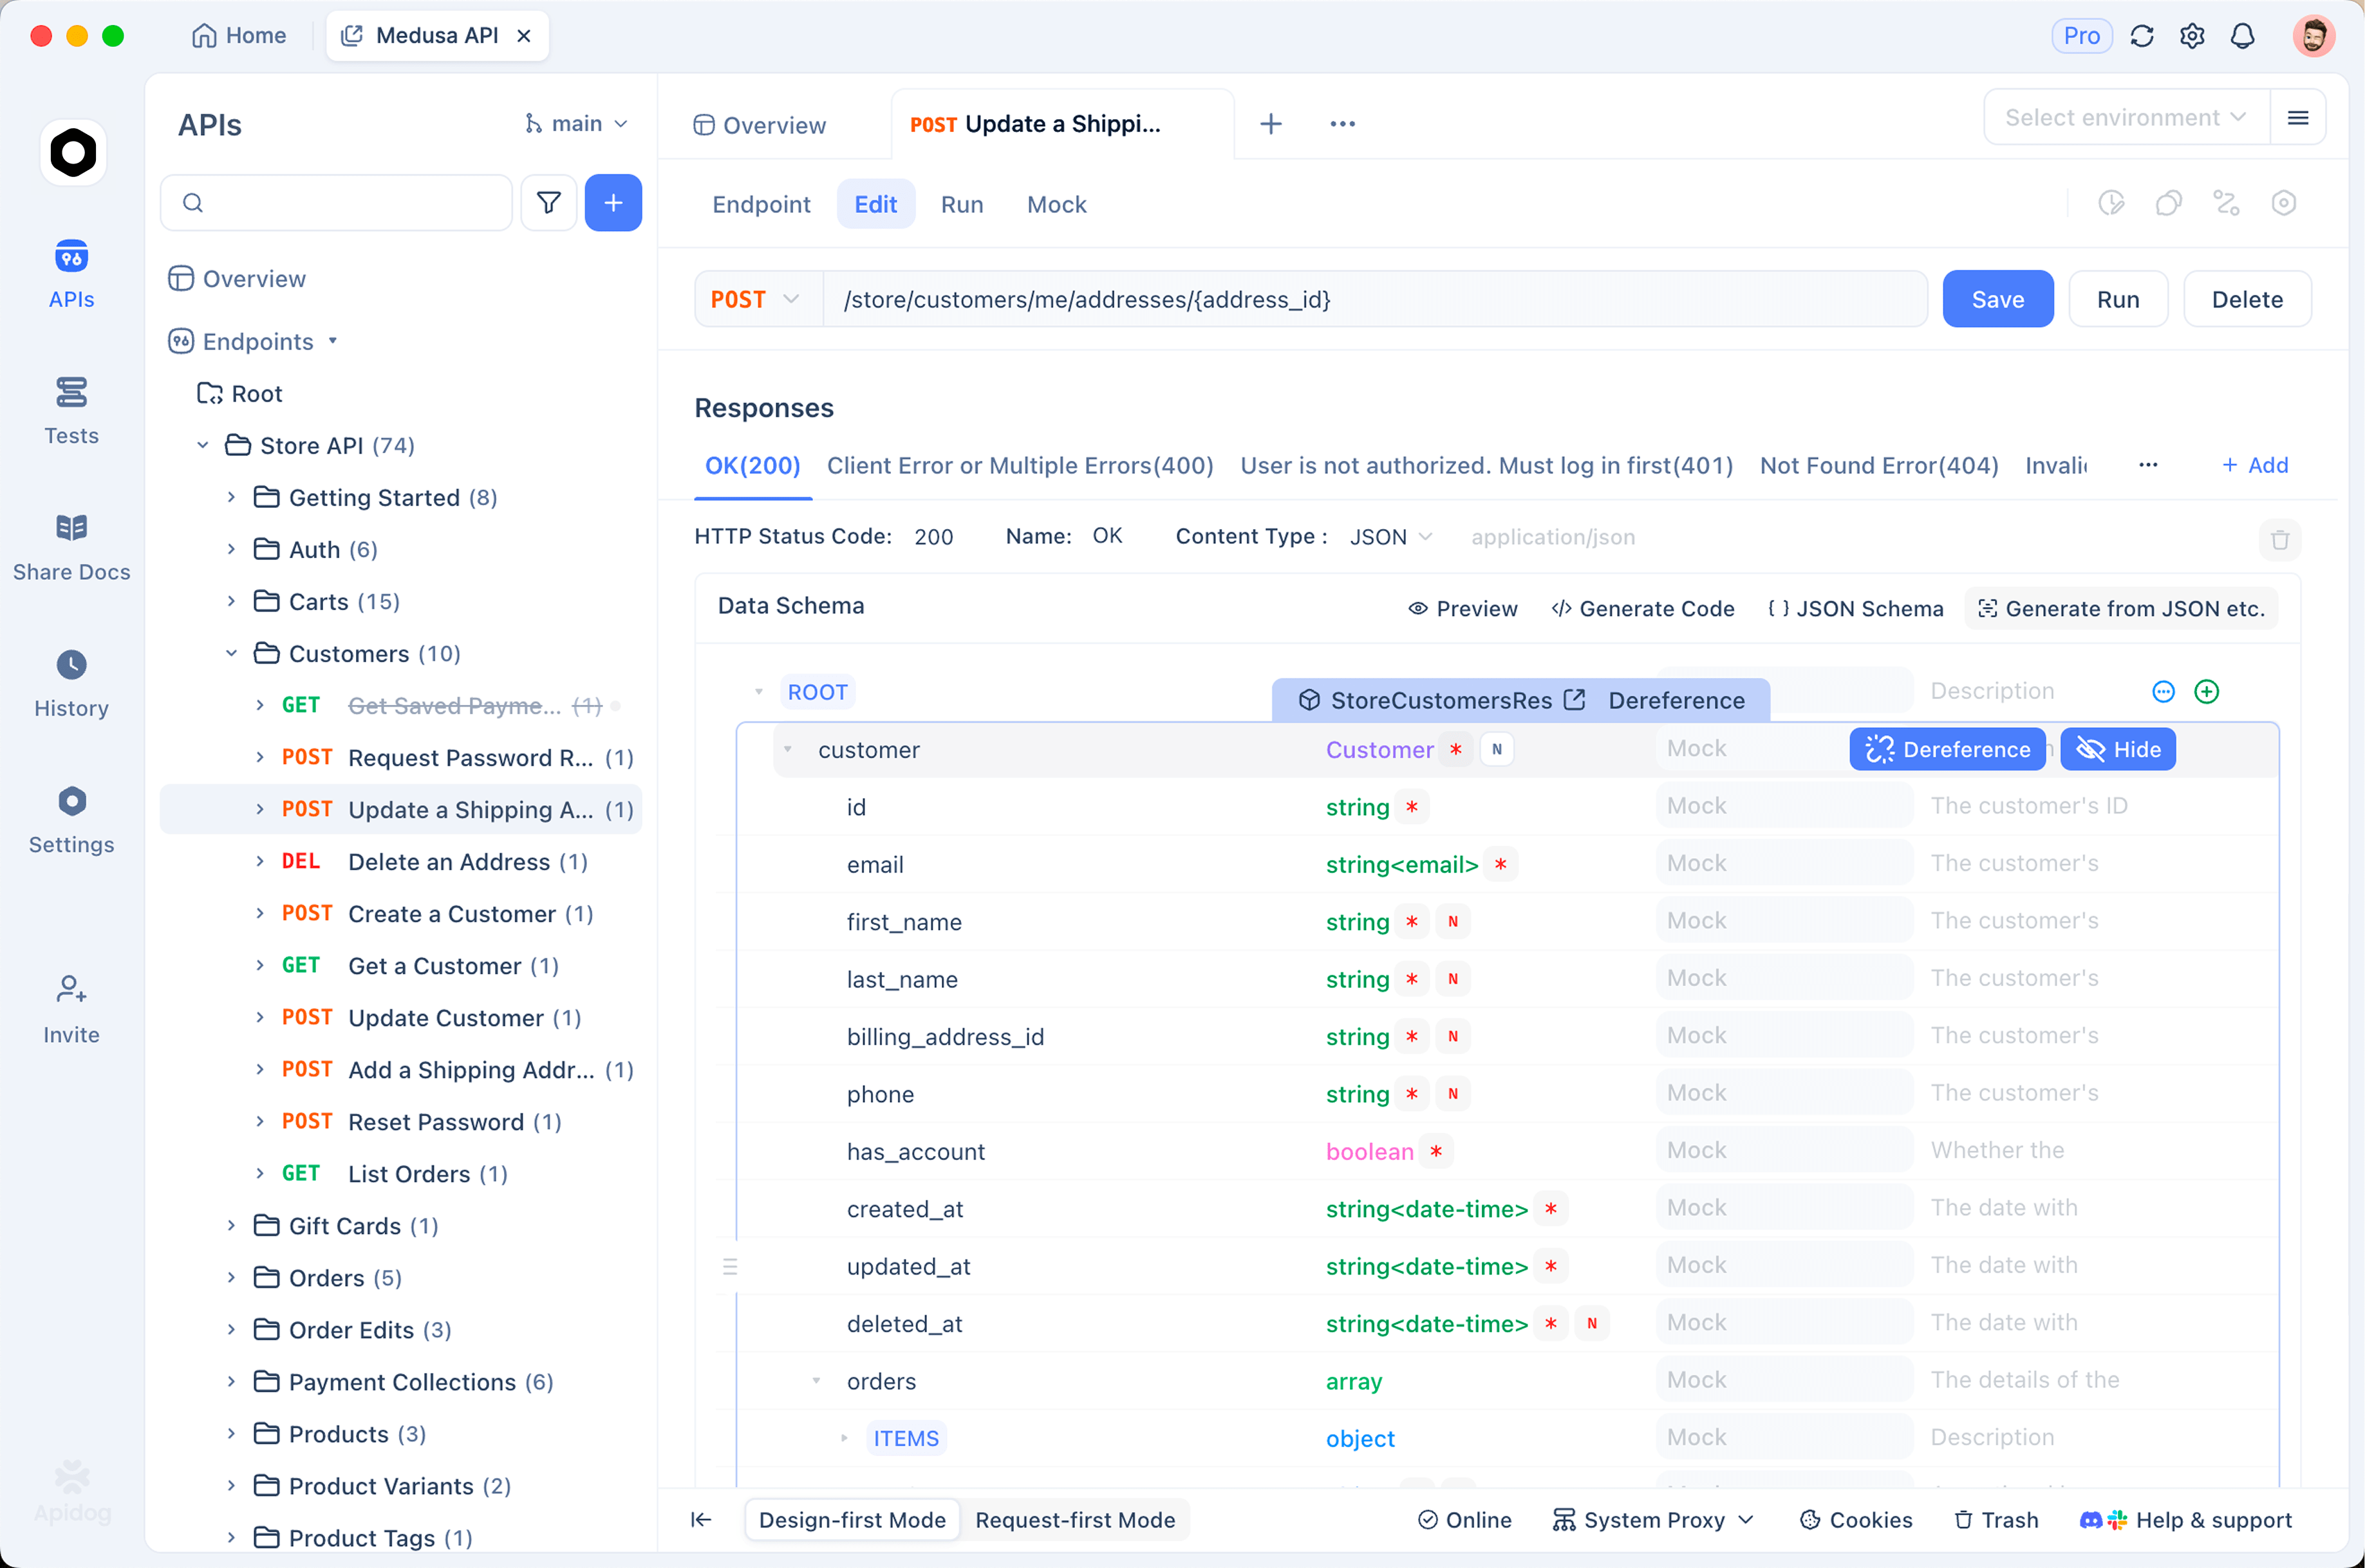
- Speichern Sie die Anfrage einmal. Erstellen Sie
POST https://api.mistral.ai/v1/chat/completions, speichern Sie Ihren Schlüssel als Umgebungsvariable und setzen SieAuthorization: Bearer {{MISTRAL_API_KEY}}. - Klonen Sie sie pro Modell. Duplizieren Sie die Anfrage, ändern Sie nur das
model-Feld (mistral-large-4vs. Ihr aktuelles Modell) und senden Sie beide. Apidog zeigt die Antwort, den Status, die Latenz und die Größe nebeneinander an, und derusage-Block gibt Ihnen die Token-Anzahl für einen Kostenvergleich. - Fügen Sie Behauptungen hinzu. Prüfen Sie auf einen
200-Status, eine nicht-leere Antwort und eine JSON-Schema-Übereinstimmung, wenn Sie eine strukturierte Ausgabe anfordern. Dies verwandelt ein einmaliges Experiment in einen Regressionstest. - Führen Sie es bei jedem Modell-Update erneut aus. Gruppieren Sie die Anfragen in ein Testszenario und führen Sie es erneut aus, wenn Mistral die Vorschau aktualisiert oder die Gewichte veröffentlicht. Sie werden sehen, ob die Qualität abgewichen ist, bevor Ihre Benutzer es tun.
Zwei Stärken von Large 4 passen natürlich zur API-Arbeit. Seine Sicherheitsergebnisse machen es zu einem guten zweiten Prüfer für API-Sicherheitstests, zum Beispiel wenn Sie einen Auth-Bypass in Ihrer eigenen Staging-API reproduzieren. Seine Funktion zum Aufrufen von Funktionen und die strukturierten Ausgaben ermöglichen es Ihnen, eine in Apidog entworfene OpenAPI-Spezifikation in Tool-Definitionen umzuwandeln, die ein Agent aufrufen kann.
Für eine vollständige Code-Anleitung, einschließlich Schlüssel, Reasoning-Chunks, Bildern, Funktionsaufrufen und Kostenberechnung, siehe unseren Mistral Large 4 API-Leitfaden. Kommen Sie von einem älteren Mistral-Modell? Die Mistral AI API-Grundlagen und der Mistral Medium 3.5 API-Leitfaden gelten weiterhin: gleiche Basis-URL, gleiche Authentifizierung, neue Modell-ID.
FAQ
Ist Mistral Large 4 Open Source? Es ist Open-Weight. Mistral sagt, dass die Gewichte bis Ende Oktober 2026 veröffentlicht werden. Die Lizenz wurde noch nicht veröffentlicht, gehen Sie also nicht davon aus, dass sie mit der Apache 2.0-Lizenz von Large 3 übereinstimmt.
Schlägt Mistral Large 4 wirklich GPT-6 Astra? Bei der visuellen Verankerung (42 % vs. 41 %) und Finance Agent v2, ja, laut Mistrals Zahlen. Beim Cyber-Schwachstellentest erzielt Astra nahezu null Punkte, weil es sich weigert, daher ist das kein direkter Sieg.
Schlägt es Claude? Nicht bei der Codierung. Claude Opus 5 führt die menschliche Codebewertung mit 4,22 zu 3,74 an. Claude Opus 5.5 verweigert auch die Cyber-Reproduktionsaufgabe, weshalb es dort nahezu null Punkte erzielt.
Was bedeutet „Le Chonk“? Es ist Mistrals inoffizieller Spitzname für das Modell, ein Witz über seine Größe. Der offizielle Name ist Mistral Large 4, oder ML4.
Kann ich es kostenlos nutzen? Mistrals kostenloser Plan beinhaltet 10 $ API-Guthaben pro Monat und Zugriff auf die neuesten Modelle in Le Chat und Vibe. Zum Vorschaupreis ergeben 10 $ etwa 4,8 Millionen Output-Token auf Large 4.
Fazit
Mistral ist zurück in der Frontier-Diskussion. Large 4 ist nach Mistrals Zahlen das stärkste Open-Weight-Modell außerhalb Chinas, kostet einen Bruchteil von Astra oder Opus 5.5 und wird innerhalb weniger Wochen auf Ihrer eigenen Hardware laufen. Die Aussage „schlägt Astra und Claude im Cyber-Bereich“ ist real, resultiert aber aus Verweigerungen, und das ehrliche Urteil zur Codierung lautet „Zweiter nach Claude“. Testen Sie es jetzt in Apidog mit Ihren eigenen APIs, solange der Vorschaupreis gilt, und warten Sie mit Ihrer Produktionsentscheidung, bis nach dem 27. Oktober unabhängige Benchmarks vorliegen.