
Die offenen Gewichte von Mistral Large 4 wurden am 29. Oktober 2026 auf Hugging Face veröffentlicht. Du bekommst dasselbe Modell mit 1,05 Bio. Parametern, das Mistral über seine API bereitstellt, unter einer modifizierten MIT-Lizenz, in FP8- und NVFP4-Checkpoints sowie Community-GGUF-Quantisierungen. Du kannst es ohne Genehmigungsschritt herunterladen, es auf 8 Data-Center-GPUs mit vLLM oder SGLang betreiben oder die Hardware überspringen und mistral-large-4 über die Mistral-API für 0,70 $ pro Million Input-Token aufrufen.
Im Folgenden: was sich seit der Vorschau vom 6. Oktober geändert hat, Download-Größen, Hardware pro Route und die Lizenz. Für die Modellübersicht lies unsere Mistral Large 4 Launch-Aufschlüsselung; für Anfrageformate und SDK-Code siehe den Mistral Large 4 API-Leitfaden.
Was sind die offenen Gewichte von Mistral Large 4?
Die offenen Gewichte von Mistral Large 4 sind die herunterladbaren Checkpoints von Mistrals Flaggschiffmodell, das den Spitznamen „Le Chonk“ trägt. Es ist ein multimodales Mixture-of-Experts-Modell mit etwa 1,05 Bio. Gesamtparametern, etwa 49 Mrd. aktiven Parametern pro Token (52 Mrd. inklusive Embeddings und Ausgabeschichten), einem 1,6-Mrd.-Vision-Encoder und einem Kontextfenster von 1 Mio. Token, veröffentlicht unter der Mistral Ecosystem Open-Weight License.
Die offizielle Model Card listet 72 Textschichten und 128 geroutete Experten auf, wobei pro Token 4 ausgewählt werden plus 1 geteilter Experte.
Die Veröffentlichung ist keine eingefrorene Kopie der Vorschau. Mistrals Open-Weight-Ankündigung besagt, dass das Modell vor der Veröffentlichung der Gewichte drei weitere Wochen Reinforcement Learning mit Fokus auf Coding und Cybersicherheit erhalten hat.
Was sich seit der Vorschau vom 6. Oktober geändert hat
Wenn du Large 4 während der Vorschau getestet hast, sind jetzt vier Dinge anders.
| Bereich | Vorschau vom 6. Oktober | Offene Veröffentlichung vom 29. Oktober |
|---|---|---|
| Gewichte | Nur API, Gewichte später versprochen | FP8 und NVFP4 auf Hugging Face, ohne Zugangsbeschränkung |
| Reasoning-Modi | high oder none |
low, medium, high (Standard high); low ersetzt none |
| Terminal-Bench 4.0 (von Mistral angegeben) | 28 % | 41 %, bei etwa 30 % weniger Ausgabe-Token |
| B3 Agent Security Angriffsresistenz (von Mistral angegeben) | 93,3 % | 97,1 % |
| API-Preis pro 1 Mio. Token | Zu einem Vorschaurabatt angezeigt | 0,70 $ Input, 0,07 $ gecachter Input, 2,10 $ Output |
Die Reasoning-Änderung bricht Code. Wenn deine Vorschau-Integration reasoning_effort: "none" sendet, stelle sie auf "low" um: Der Hugging-Face-Launch-Post merkt an, dass Transformers none als high ausführt, sodass eine veraltete Einstellung Token kostet, statt fehlzuschlagen.
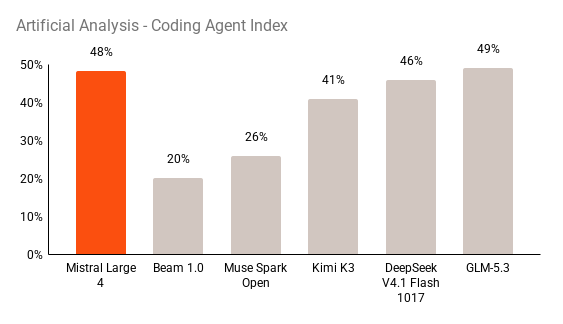
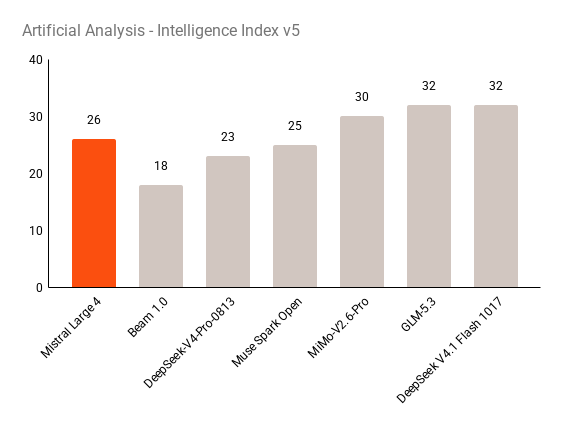
Alle Benchmark-Zahlen in diesem Beitrag stammen vom Anbieter. Mistral behauptet außerdem 19,7 % auf Cognition’s privatem FrontierCode 2.0 Benchmark, den besten Open-Weight-Wert in seinem Diagramm, und 48 % auf dem Artificial Analysis Coding Agent Index, etwa gleichauf mit GLM-5.3. Eine unabhängige Reproduktion war noch ausstehend, als wir am 2. November nachgesehen haben.
Drei Wege, Mistral Large 4 zu betreiben
Du hast drei Routen, und die richtige hängt davon ab, wie viel Hardware du kontrollierst.
- Die Mistral-API aufrufen. Modell-ID
mistral-large-4, 0,70 $ Input, 0,07 $ gecachter Input und 2,10 $ Output pro Million Token. Keine GPUs. - Einen gehosteten Anbieter nutzen. Mistral listet OpenRouter, von NVIDIA gehostete Endpunkte und einen NIM-Container sowie Microsoft Foundry, das auch private Deployments auf Azure anbietet.
- Die Gewichte selbst hosten. Von Hugging Face herunterladen und mit vLLM, SGLang, Transformers oder llama.cpp auf deinen eigenen Maschinen betreiben.
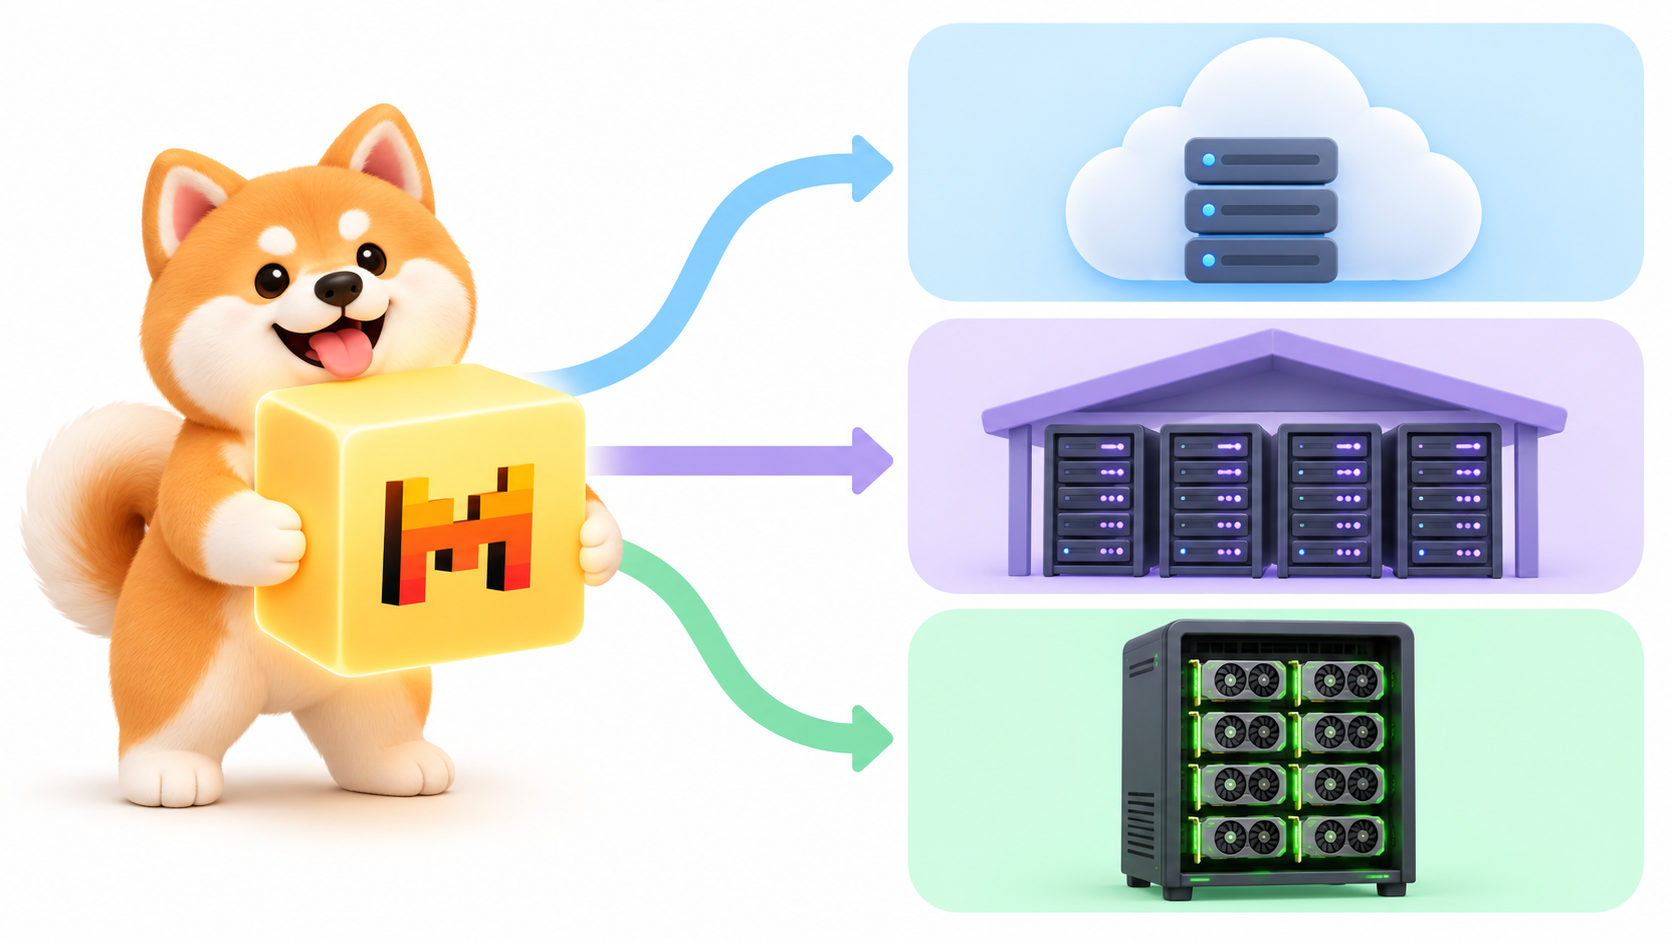
Beginne mit Route 1 oder 2. Wechsle zu Route 3 aus einem konkreten Grund: Daten, die dein Netzwerk nicht verlassen dürfen, ein Fine-Tune, das du besitzen musst, oder ein Volumen, das einen 8-GPU-Knoten dauerhaft beschäftigt.
Wie du Mistral Large 4 herunterlädst
Die offiziellen Repos sind nicht zugangsbeschränkt (die Hugging-Face-API meldet für beide gated: false), sodass jedes Konto oder anonyme Client sie abrufen kann. Die Größe ist die eigentliche Hürde.
| Repo | Format | Größe auf der Festplatte |
|---|---|---|
mistralai/Mistral-Large-4-1T-A52B |
FP8, offiziell | etwa 1.061 GB |
mistralai/Mistral-Large-4-1T-A52B-NVFP4 |
NVFP4, offiziell | etwa 610 GB |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
Q8_0 | etwa 1.115 GB |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
Q4_K_M | etwa 635 GB |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
Q2_K | etwa 381 GB |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
IQ2_XXS | etwa 298 GB |
Wir haben diese am 2. November 2026 aus den Dateilisten der jeweiligen Repos zusammengerechnet. Unsloth veröffentlicht ebenfalls GGUF-Quantisierungen unter unsloth/Mistral-Large-4-1T-A52B-GGUF.
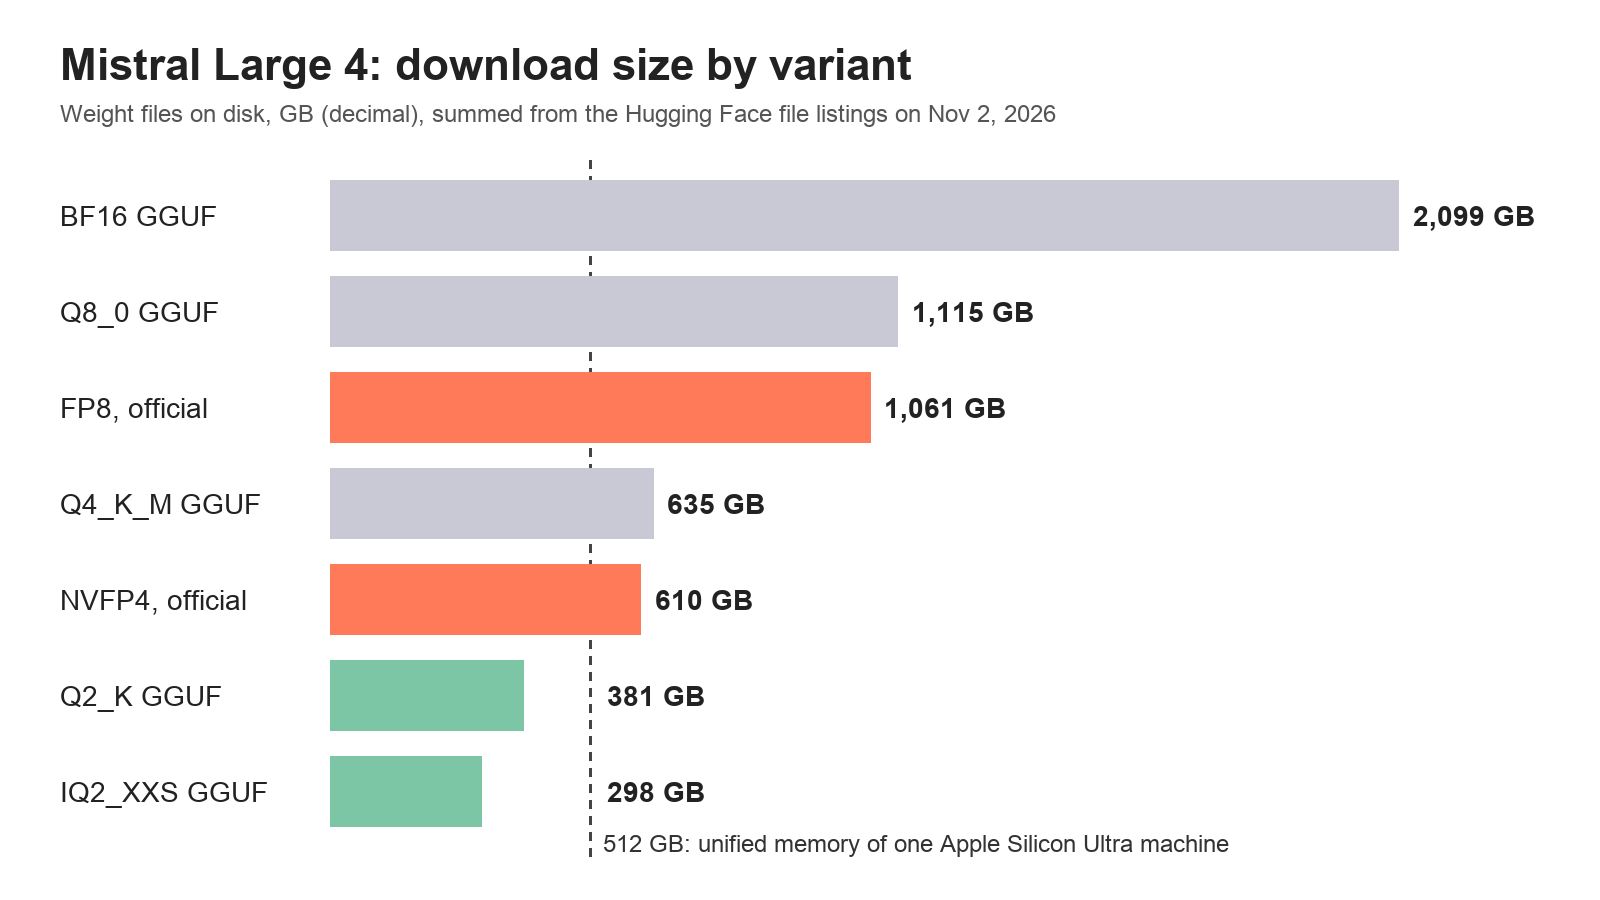
Lade nur die Dateien herunter, die du brauchst, mit der Hugging Face CLI:
pip install -U huggingface_hub
hf download mistralai/Mistral-Large-4-1T-A52B-NVFP4 \
  --local-dir ./mistral-large-4-nvfp4
Der FP8-Download dauert bei einer konstanten Rate von 1 Gbit/s etwas über zwei Stunden.
Wie du Mistral Large 4 selbst hostest
Jedes offizielle Serving-Beispiel geht von einem Knoten mit 8 GPUs und Tensor-Parallelität von 8 aus. Hier ist, was jede Engine erwartet.
| Engine | Checkpoint | Hardware in den offiziellen Beispielen |
|---|---|---|
| vLLM | FP8 | 8 GPUs, --tensor-parallel-size 8; Hugging Face Inference Endpoints verwenden 8x H200 |
| vLLM | NVFP4 | 8 NVIDIA Blackwell GPUs |
| SGLang | FP8 | 8 GPUs, --tp-size 8 |
| Transformers | FP8 | 8 GPUs über torchrun |
| llama.cpp | Q2_K GGUF | Eine Apple-Silicon-Ultra-Maschine mit 512 GB Unified Memory |
vLLM
Die Model Card empfiehlt vLLM und liefert ein dediziertes Docker-Image mit:
docker run --runtime nvidia --gpus all \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -p 8000:8000 \
  --ipc=host \
  vllm/vllm-openai:mistral-large-4 \
  --model mistralai/Mistral-Large-4-1T-A52B \
  --tensor-parallel-size 8 \
  --tool-call-parser mistral \
  --reasoning-parser mistral \
  --enable-auto-tool-choice \
  --gpu-memory-utilization 0.85
Behalte beide Parser-Flags bei, sonst landet Denk-Text in content und Tool-Aufrufe kommen als reiner Text an. Für schnelleres Dekodieren dokumentiert die Card einen optionalen DSpark-Speculative-Decoder: Füge --speculative-config '{"method": "dspark", "num_speculative_tokens": 3}' hinzu.
Auf 8x H200 mit diesem Drafter hat Hugging Face etwa 65 Token pro Sekunde für eine einzelne Anfrage und insgesamt etwa 480 Token pro Sekunde über 1.000 ShareGPT-Konversationen unter Last gemessen.
SGLang funktioniert ebenfalls: Das sglang serve-Beispiel der Model Card verwendet --tp-size 8, --speculative-algorithm DSPARK sowie auto-Reasoning- und Tool-Call-Parser.
llama.cpp auf einem Mac
Das llama.cpp-Team hat Day-0-Support geliefert. Die Q2_K-Quantisierung (381 GB) passt auf eine Apple-Silicon-Ultra-Maschine mit 512 GB Unified Memory:
curl -LsSf https://llama.app/install.sh | sh
llama serve -hf ggml-org/Mistral-Large-4-1T-A52B-GGUF:Q2_K
Hugging Face meldet etwa 90 Token pro Sekunde beim Prefill und 15 bei der Generierung auf einem M3 Ultra: gut für private Experimente, langsam für eine Agent-Loop. Eine 2-Bit-Quantisierung verliert außerdem Qualität, also teste sie zuerst mit deinen eigenen Aufgaben.
Mistrals empfohlenes Sampling ist temperature=1.0 und top_p=0.95 auf jeder Reasoning-Stufe.
Dein selbst gehostetes Modell aufrufen
vLLM und SGLang stellen beide einen OpenAI-kompatiblen Server bereit, sodass die Anfrage wie bei jeder Chat-Completion aussieht:
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mistralai/Mistral-Large-4-1T-A52B",
    "messages": [{"role": "user", "content": "Summarize RFC 9110 section 9 in 5 bullets."}],
    "reasoning_effort": "medium",
    "temperature": 1.0,
    "top_p": 0.95
  }'
Sende bei der gehosteten API denselben Body an https://api.mistral.ai/v1/chat/completions mit "model": "mistral-large-4" und einem Bearer-Key. Die Dokumentation zum OpenAI-kompatiblen Server von vLLM listet die Felder auf, die er akzeptiert.
Lass Claude Code beide Endpunkte mit Apidog CLI testen
Ein selbst gehostetes Modell schlägt leise fehl: Ein fehlendes Parser-Flag lässt Reasoning in content durchsickern, oder ein Tool-Aufruf kommt als reiner Text zurück. Lass deinen Coding-Agent beide Routen mit Apidog CLI prüfen, statt curl-Befehle von Hand einzufügen.
Richte es einmal ein:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick Claude Code when prompted
Gib Claude Code dann einen Prompt:
In Apidog project <id>, create two environments: "ml4-self-hosted" with base URL
http://localhost:8000 and "ml4-mistral-api" with base URL https://api.mistral.ai.
Add a POST /v1/chat/completions endpoint and a test case that sends a tool-calling
request with reasoning_effort "low", then asserts status 200, that choices[0].message
has a tool_calls array, and that message.content holds no thinking text.
Run it against both environments and tell me where they differ.
Der Agent liest jedes Schema, validiert seine Payload und führt den Testfall aus:
apidog environment create ml4-self-hosted --project <id> --base-url http://localhost:8000
apidog environment create ml4-mistral-api --project <id> --base-url https://api.mistral.ai
apidog cli-schema get endpoint-create
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <selfHostedEnvId> -r cli,json
apidog run --test-case <caseId> --project <id> -e <apiEnvId> -r cli,json
Füge --upload-report hinzu, um den Durchlauf in der Apidog-App anzuzeigen, oder setze dieselbe Zeile apidog run ... -r junit in CI, damit ein vLLM-Upgrade nicht mit kaputten Tool-Aufrufen ausgeliefert werden kann. Unser Leitfaden zu Apidog CLI in Claude Code behandelt das Setup ausführlicher. Der Free-Plan von Apidog deckt bis zu 4 Nutzer ab.
Die Lizenz: Was du darfst und was nicht
Die Mistral Ecosystem Open-Weight License ist MIT mit einer zusätzlichen Bedingung.
Du darfst: das Modell und seine Derivate ausführen, bereitstellen, feinabstimmen und modifizieren, für kommerzielle und nicht-kommerzielle Nutzung, solange du den Urheberrechts- und Erlaubnishinweis in Kopien beibehältst.
Du benötigst eine separate kommerzielle Lizenz von Mistral, wenn: du es als „Model as a Service“ betreibst, was die Lizenz so definiert, dass du Dritten Zugriff auf das Modell oder seine Derivate für Inferenz oder Post-Training gibst.
Diese Bedingung gilt nicht für: interne Nutzung, Endnutzerprodukte, bei denen das Modell innerhalb bestimmter Funktionen oder Harnesses sitzt, das bloße Weiterleiten von Anfragen an ein Modell, das jemand anderes hostet, und die Nutzung über Mistrals eigene Produkte.
Ein interner Coding-Assistent oder eine auf dem Modell aufbauende Produktfunktion ist in Ordnung; der Weiterverkauf roher Inferenz erfordert einen Deal. Dies ist eine Zusammenfassung, keine Rechtsberatung.
Für eine ähnliche Schritt-für-Schritt-Anleitung zu einem anderen Open-Weight-Modell siehe unseren GLM-5.3 Self-Hosting-Leitfaden.
Solltest du selbst hosten oder die API aufrufen?
Rufe die API auf, wenn dein Volumen moderat ist, du den 1-Mio.-Kontext ohne Anpassung von Server-Limits möchtest oder du ohnehin keine 8-GPU-Knoten betreibst. Bei 0,70 $ Input und 2,10 $ Output pro Million Token ergeben 100 Mio. Input-Token plus 20 Mio. Output-Token pro Monat 112 $, vor jeglichem Caching-Rabatt.
Hoste selbst, wenn deine Daten dein Netzwerk nicht verlassen dürfen, wenn du ein Fine-Tune besitzen möchtest (Hugging Face zeigt LoRA-Training mit TRL auf einem 8x-B300-Knoten) oder wenn ein stetiges Volumen einen Knoten auslastet. Mistrals Forge-Service ist die managed Option für das Tuning mit deinen eigenen Daten.
FAQ
Sind die offenen Gewichte von Mistral Large 4 kostenlos herunterladbar?
Ja. Beide offiziellen Repos auf Hugging Face sind ohne Zugangsbeschränkung, sodass du sie herunterladen kannst, ohne Zugriff anzufordern. Sie zu betreiben ist der Kostenfaktor: Der offizielle FP8-Checkpoint ist etwa 1.061 GB groß und die Serving-Beispiele verwenden 8 Data-Center-GPUs.
Kann ich Mistral Large 4 auf einer einzelnen GPU ausführen?
Kein offizielles Rezept deckt eine einzelne GPU ab. Jedes vLLM-, SGLang- und Transformers-Beispiel verwendet 8 GPUs mit Tensor-Parallelität. Das kleinste dokumentierte Setup ist llama.cpp mit der 381 GB großen Q2_K-Quantisierung auf einer Apple-Silicon-Ultra-Maschine mit 512 GB Unified Memory.
Ist Mistral Large 4 Open Source?
Es ist Open Weight, nicht Open Source im Sinne der OSI. Du bekommst die Gewichte unter einer modifizierten MIT-Lizenz, die kommerzielle Nutzung erlaubt, aber das Anbieten des Modells an Dritte als Inferenz- oder Post-Training-Service erfordert eine separate kommerzielle Lizenz von Mistral.
Ist das Open-Weight-Modell dasselbe wie das API-Modell?
Mistral sagt, dass der veröffentlichte Checkpoint nach der Vorschau vom 6. Oktober drei weitere Wochen Reinforcement Learning erhalten hat, und die API stellt das aktualisierte Modell als mistral-large-4 bereit. Auch die Reasoning-Modi haben sich geändert: Verwende low, medium oder high.
Wie viel kostet die Mistral Large 4 API?
Mistral listet 0,70 $ pro Million Input-Token, 0,07 $ pro Million gecachter Input-Token und 2,10 $ pro Million Output-Token, Stand 2. November 2026.