Bei MCP vs. CLI geht es darum, wann Ihr Agent für ein Tool bezahlt. Ein MCP-Server sendet den Namen, die Beschreibung und das JSON-Schema jedes Tools an das Modell, bevor Sie überhaupt etwas eingeben. Eine CLI kostet nichts, bis der Agent sie ausführt und ihre --help-Ausgabe oder das Ergebnis liest. In einer gemessenen Konstellation fügten vier gängige MCP-Server 11.923 Tokens an Tool-Definitionen hinzu; das Apidog-CLI-Skill kam auf 112.
Diese Lücke ist die ganze Geschichte hinter zwei Dev.to-Posts dieser Woche. Ein Entwickler tippte „Run tests“ in einen Coding-Agenten und sah 28.400 Input-Tokens bereits bei der ersten Anfrage – ohne angehängte Dateien und ohne Historie. Der Übeltäter: sieben MCP-Server. Ein anderer argumentierte, dass sich MCP kinderleicht bauen lässt, und dass die schwierigen Teile (Auth, Freigaben, doppelte Aufrufe) genau dann beginnen, wenn das Demo-Beispiel funktioniert.
Dieser Artikel konzentriert sich auf eine Frage: Was kosten Tool-Definitionen Ihren Kontextfenster, und wann ist eine CLI, die der Agent bei Bedarf aufruft, günstiger? Wenn Ihr Problem stattdessen riesige Tool-Antworten sind, lesen Sie den Begleitartikel zum Kürzen aufgeblähter API-Antworten.
Warum MCP-Server Tokens des Kontextfensters belegen
Ein MCP-Server macht seine Tools über die Methode tools/list bekannt. Laut der MCP-Tools-Spezifikation enthält jedes Tool einen name, eine description und ein inputSchema (ein JSON-Schema für seine Argumente). Damit das Modell ein Tool auswählen kann, muss der Client diese Definitionen in die Anfrage aufnehmen. In einem klassischen Setup passiert das bei jedem Zug jedes Gesprächs – ob der Agent das Tool aufruft oder nicht.
Die Kosten wachsen also mit drei Faktoren:
- Anzahl der Tools. Eine vollständige GitHub-Integration kann Dutzende Tools bereitstellen.
- Schema-Tiefe. Verschachtelte Objekte, Enums und lange Beschreibungen werden alle zu Tokens.
- Züge. Eine Agent-Schleife sendet die Definitionen bei jedem Schritt erneut.
Der necoz-Post beziffert das: Ein Stack mit 52 Tools kostete 24.600 Schema-Tokens im ersten Zug, gegenüber 640 Tokens bei einem Setup mit 4 Tools, und rund 246.000 Tokens über eine 10-stufige Schleife. Betrachten Sie das als Messung eines einzelnen Entwicklers, nicht als Benchmark. Prompt-Caching senkt die Kosten wiederholter Definitionen in Dollar, aber die Tokens belegen weiterhin das Fenster und konkurrieren mit Ihrem Code um Aufmerksamkeit.
Es gibt auch qualitative Kosten. Anthropics Tool-Search-Dokumentation stellt fest, dass ein Multi-Server-Setup mit GitHub, Slack, Sentry, Grafana und Splunk „rund 55k Tokens an Definitionen verbrauchen kann, bevor Claude überhaupt arbeitet“, und dass Claudes Genauigkeit bei der Tool-Auswahl ab etwa 30 bis 50 verfügbaren Tools abnimmt.
MCP-Tool-Definitions-Tokens: eine nachvollziehbare Messung
Am 16.11.2026 habe ich fünf MCP-Server lokal über stdio gestartet, initialize und tools/list aus einem 30-Zeilen-Node-Skript gesendet und die Tokens in name, description und inputSchema jedes Tools gezählt.
Ein Vorbehalt vorab: Gezählt habe ich mit OpenAIs tiktoken-Encoding o200k_base, weil es offline läuft. Claude, Gemini und andere Modelle verwenden eigene Tokenizer, daher werden Ihre Zählungen um einiges abweichen. Entscheidend sind hier die Verhältnisse zwischen den Setups.
| MCP-Server (Version) | Tools | Definitions-Tokens | Ø pro Tool |
|---|---|---|---|
@playwright/mcp 0.0.85 |
25 | 4.634 | 185 |
@modelcontextprotocol/server-filesystem 2.3.0 |
16 | 3.281 | 205 |
@modelcontextprotocol/server-memory 2.1.1 |
9 | 2.013 | 224 |
@modelcontextprotocol/server-everything 2.3.0 |
16 | 1.995 | 125 |
| Alle vier zusammen | 66 | 11.923 | 181 |
apidog-mcp-server 0.0.18 |
3 | 291 | 97 |
Vier gewöhnliche Server kosten rund 12.000 Tokens, bevor der Agent auch nur eine Datei liest.
Die letzte Zeile ist das nützliche Gegenbeispiel. Der Apidog-MCP-Server stellt nur drei schlanke Tools bereit (OpenAPI-Spezifikation des Projekts lesen, $ref-Dateien lesen, Spezifikation aktualisieren) und kostet daher nur 291 Tokens. Tool-Anzahl und Schema-Tiefe bestimmen die Rechnung – nicht das Protokoll.
Für die CLI-Seite habe ich gemessen, was ein Agent tatsächlich liest, wenn er Apidog CLI 2.2.12 verwendet:
| CLI-Text | Wann er in den Kontext gelangt | Tokens |
|---|---|---|
| Apidog-CLI-Skill-Beschreibung (Frontmatter) | Jede Sitzung, als Skill-Listeneintrag | 112 |
| Apidog-CLI-Skill-Textkörper | Nur wenn die Aufgabe passt | 1.189 |
apidog --help |
Nur wenn der Agent ihn ausführt | 668 |
apidog test-case --help |
Nur wenn der Agent ihn ausführt | 511 |
apidog run --help |
Nur wenn der Agent ihn ausführt | 1.036 |
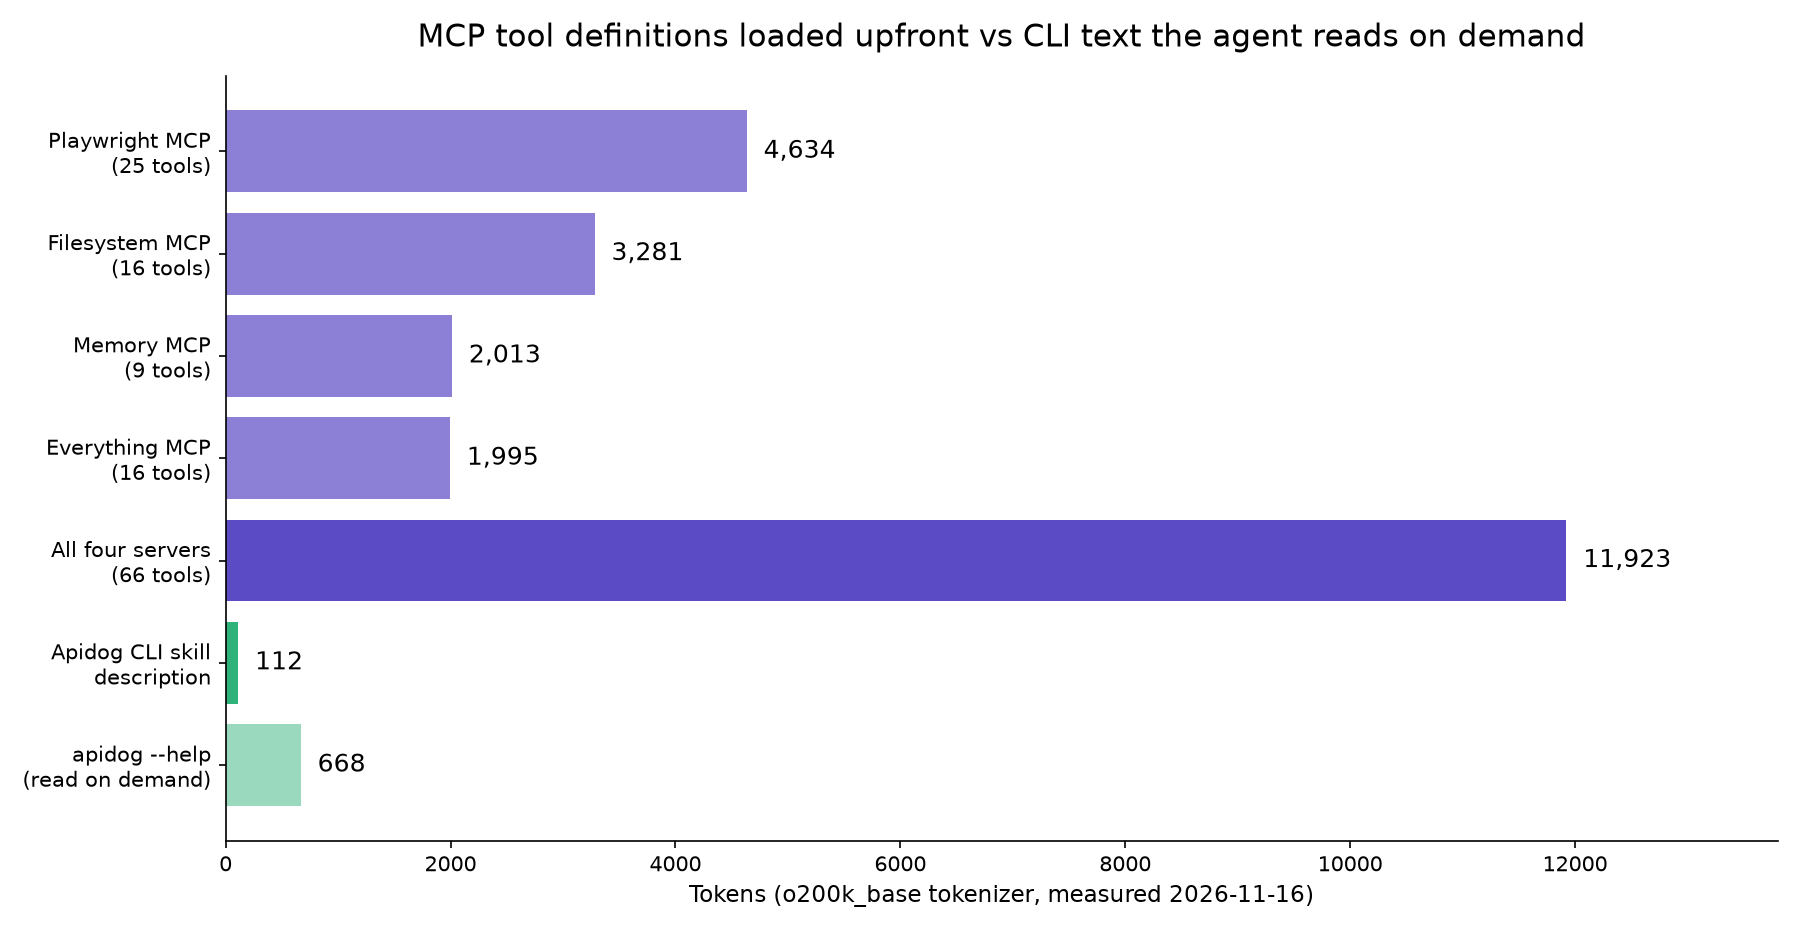
Die dauerhaft anfallenden Kosten des CLI-Wegs liegen bei 112 Tokens. Selbst wenn der Agent das vollständige Skill lädt und drei Hilfeseiten liest, landet er bei knapp 3.500 Tokens – und nur im Gespräch, das es braucht.
MCP vs. CLI: der Token-Kostenvergleich
| MCP-Server (Definitionen im Vorfeld geladen) | CLI über die Shell aufgerufen | |
|---|---|---|
| Vorlaufkosten | Das Schema jedes Tools, bei jedem Zug | Null, oder eine kurze Skill-Beschreibung |
| Entdeckung | Strukturiertes tools/list |
--help-Text, bei Bedarf gelesen |
| Ausgabe | Was das Tool zurückgibt | Was der Befehl ausgibt (lässt sich filtern) |
| Funktioniert clientübergreifend | Jeder MCP-Client, eine Konfiguration | Jeder Agent mit einem Shell-Tool |
| Typisierte Argumente | Ja, über JSON Schema | Flags; Payload-Dateien separat validiert |
| Auth und Berechtigungen | Sache des Servers (OAuth für entfernte HTTP-Server) | Ihr lokaler Login und Ihre Shell-Berechtigungen |
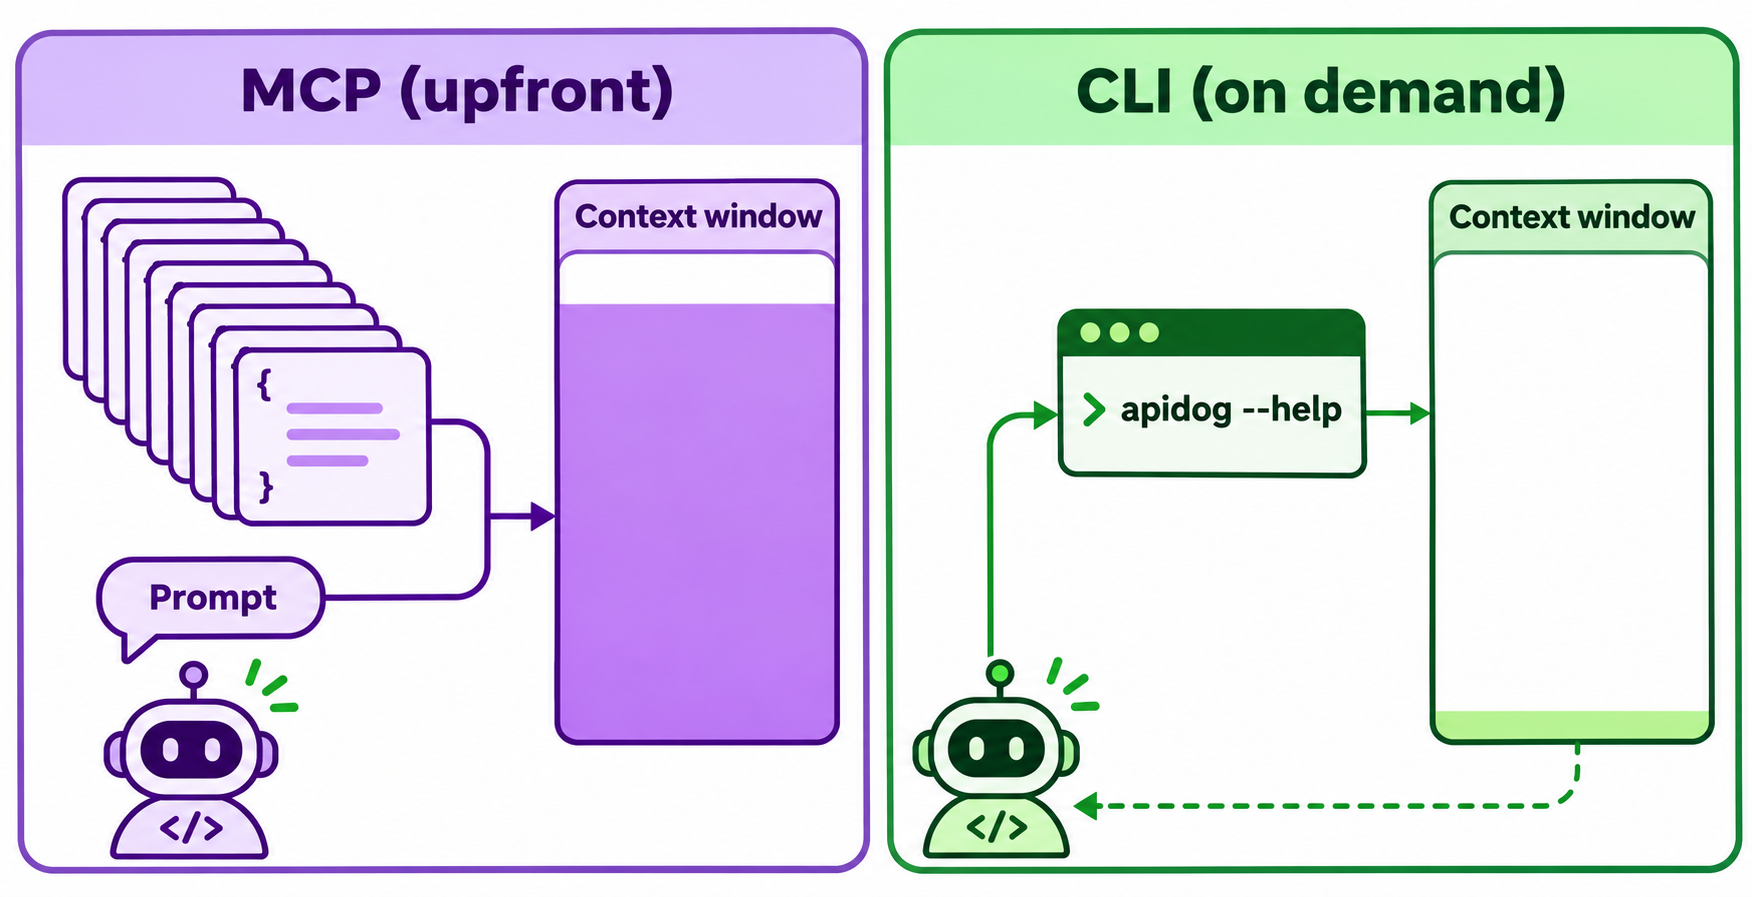
Die CLI punktet bei den Vorlaufkosten, weil der Agent ohnehin über ein Shell-Tool verfügt. Der Aufruf von apidog endpoint list --project 123 nutzt das Bash-Tool, das er sowieso laden würde. Der MCP-Weg gewinnt, wenn Sie dieselbe Fähigkeit in mehreren Clients brauchen, ohne für jeden eine Integration zu schreiben – das ist der Punkt, den Sylwia Lask macht: MCP ist kein Ersatz für REST, sondern ein Standard, mit dem AI-Clients Tools entdecken und aufrufen.
Ihr Client verschiebt MCP-Tools womöglich bereits
Bevor Sie alle Server entfernen, prüfen Sie, was Ihr Agent tut. Die oben genannten Kosten setzen voraus, dass Definitionen im Vorfeld geladen werden. Manche Clients tun das standardmäßig nicht mehr.
Die MCP-Dokumentation von Claude Code besagt, dass Tool Search standardmäßig aktiviert ist: „Nur Tool-Namen und Server-Anweisungen werden beim Sitzungsstart geladen“, und vollständige Definitionen werden geladen, wenn Claude danach sucht. Gesteuert wird das über ENABLE_TOOL_SEARCH:
- nicht gesetzt oder
true: MCP-Tools werden aufgeschoben und bei Bedarf geladen auto: Tools werden im Vorfeld geladen, solange ihre Definitionen zusammen unter 10 % des Kontextfensters liegenauto:N: dasselbe, mit Ihrem eigenen Prozentsatzfalse: jedes MCP-Tool wird im Vorfeld geladen
Zwei Ausnahmen sind relevant. Modelle älter als Opus 4 und Sonnet 4 laden MCP-Tools unabhängig davon im Vorfeld, und ein Server mit alwaysLoad: true überspringt die Aufschiebung. Führen Sie /context in Claude Code aus, um zu sehen, welche Tools als aufgeschoben markiert sind. In der Claude-API selbst heißt dieselbe Idee Tool-Search-Tool: Sie setzen defer_loading: true für Tools, die nicht im Vorfeld geladen werden sollen, und Anthropic gibt an, dass dies die Definitions-Tokens typischerweise um über 85 % senkt.
Aufschiebung löst das Problem der Definitions-, nicht der Ausgabekosten: Claude Code warnt, wenn ein MCP-Tool mehr als 10.000 Tokens zurückgibt, und begrenzt die Ausgabe standardmäßig auf 25.000 (MAX_MCP_OUTPUT_TOKENS). Neu im Protokoll? Beginnen Sie mit Was MCP ist und warum es für APIs wichtig ist.
Wann MCP vs. CLI für API-Arbeit
Für API-Design, Tests und Dokumentation nutzen Sie am besten diese Aufteilung:
- Verwenden Sie eine CLI, wenn die Aufgabe ohnehin ins Terminal gehört: Endpoints auflisten, eine OpenAPI-Datei exportieren, einen Testfall anlegen und ausführen, eine Suite in CI laufen lassen. Der Agent zahlt für Hilfetexte nur bei Bedarf, und Sie können die Ausgabe durch
jqoder--reportersleiten, um sie kurz zu halten. - Verwenden Sie einen schlanken MCP-Server, wenn der Agent in jedem Zug strukturierten Lesezugriff braucht, etwa beim Lesen Ihrer OpenAPI-Spezifikation während er Client-Code schreibt. Drei Tools für 291 Tokens sind ein fairer Preis.
- Vermeiden Sie es, fünf oder mehr Server global in jedem Projekt aktiv zu lassen. Genau dieses Setup erzeugte die 28.400-Tokens-„Run tests“-Anfrage.
Wofür Sie sich entscheiden – Sylwias Warnungen gelten weiterhin: Ein Tool, das Daten schreibt, braucht serverseitige Berechtigungsprüfungen, einen menschlichen Freigabeschritt für riskante Aktionen und Duplikaterkennung, damit ein erneuter Lauf nicht denselben Datensatz doppelt anlegt.
Lassen Sie Ihren Coding-Agenten Apidog CLI steuern
Hier ist der CLI-Weg für API-Arbeit, bei dem Ihr Coding-Agent die Eingaben macht. Installieren Sie die CLI, melden Sie sich einmal an und fügen Sie das Agent-Skill hinzu:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Sie können dem Agenten auch sagen: „Lies https://apidog.com/apidog-cli-installation-guide.md und richte Apidog CLI ein“ – dann folgt er dem agentenfreundlichen Installationsguide.
Dann geben Sie ihm einen Prompt:
In Apidog project 123, list the endpoints, export the spec as OpenAPI 3.1 to
./openapi.json, then create a test case for GET /users/{id} that asserts a 200
status and an id field, run it against environment 456 and summarize failures.
Read --help for each command before using it. Print only the lines you need.
Der Agent liest beim Vorgehen die Hilfetexte, validiert sein JSON und führt dann den Testfall aus:
apidog endpoint list --project 123 --page 1 --page-size 500
apidog export --project 123 --format openapi --oas-version 3.1 --output ./openapi.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project 123 --file case.json
apidog run --test-case <caseId> --project 123 -e 456 -r cli,json
Jeder Befehl gibt strukturiertes JSON zurück, oft mit agentHints.nextSteps, sodass der Agent weiß, was er als Nächstes ausführen muss, ohne für jede mögliche Aktion ein Schema zu laden. Dieselbe Zeile apidog run ... -r junit lässt sich in CI einsetzen, wie im Apidog-CLI-CI/CD-Pipeline-Guide gezeigt. Für einen Claude-Code-Walkthrough siehe Apidog CLI in Claude Code, und für gemessene Einsparungen bei Tool-Aufrufen: 30 % weniger Tool-Aufrufe, 25 % weniger Tokens.
Einen Überblick über alle Befehlsgruppen vor dem Start finden Sie auf der Apidog-CLI-Seite.
So senken Sie die MCP-Token-Kosten noch heute
- Führen Sie
/contextin Claude Code aus (oder das Äquivalent Ihres Clients) und notieren Sie die Summe der Tool-Definitionen. - Verschieben Sie nicht benötigte Server von der globalen in die Projekt-Konfiguration.
- Aktivieren Sie das verzögerte Laden (
ENABLE_TOOL_SEARCHin Claude Code). - Ersetzen Sie breite Server durch eine CLI plus ein kurzes Skill für Terminal-Aufgaben.
- Bauen Sie eigene Server: wenige Tools, kurze Beschreibungen.
FAQ
Verbrauchen MCP-Tools Tokens, wenn der Agent sie nie aufruft? Bei einem Client, der Definitionen im Vorfeld lädt: ja. Name, Beschreibung und Input-Schema jedes Tools landen in jeder Anfrage. Clients mit verzögertem Laden, wie Claude Code mit aktivem Tool Search, senden nur Tool-Namen, bis ein Tool benötigt wird.
Wie viele Tokens verbraucht ein MCP-Server? Das hängt von der Tool-Anzahl und der Schema-Tiefe ab. In meiner Messung verbrauchte @playwright/mcp 4.634 Tokens für 25 Tools und der Apidog-MCP-Server 291 für 3 Tools – gezählt mit dem o200k_base-Tokenizer.
Ist eine CLI für AI-Agenten immer günstiger als MCP? Bei den Vorlaufkosten fast immer, weil der Agent sein Shell-Tool wiederverwendet. Pro Aufruf kann eine CLI den Kontext trotzdem fluten, wenn der Agent eine große Payload ausgibt – filtern Sie also in jedem Fall die Ausgabe.
Löst Prompt-Caching die Kontext-Aufblähung durch MCP? Es senkt den Preis wiederholter Definitionen. Es befreit nicht das Kontextfenster, und das Modell widmet diesen Tokens weiterhin bei jedem Zug Aufmerksamkeit.
Sollte ich MCP-Server ganz aufgeben? Nein. Nutzen Sie schlanke Server für strukturierten Zugriff in jedem Zug und um eine Fähigkeit clientübergreifend zu teilen. Verlagern Sie Terminal-förmige API-Arbeit – Exporte und Testläufe – auf eine CLI.