Wenn ein Voice-Agent in echten Anrufen versagt, ist meist weder das LLM noch die Stimme die Ursache. Das Problem beginnt einen Schritt früher – beim Audio, das der Agent hört, egal ob es in Speech-to-Text (STT) oder direkt in ein Speech-to-Speech-Modell eingespeist wird. Moderne STT-Modelle kommen mit Verkehrslärm und Klimaanlagen problemlos zurecht. Was sie nicht verarbeiten können, ist eine zweite sprechende Person: ein Kollege, ein Fernseher, der Agent am Nachbarplatz im Callcenter. Das Modell hört auch diese Stimmen mit – und der Agent reagiert auf Wörter, die der Anrufer nie gesagt hat.
Krisp Voice Isolation wird vor das STT geschaltet und entfernt alle Stimmen außer der des Hauptsprechers. Für diesen Test habe ich Krisps Benchmarks und Dokumentation gelesen, mich für die Self-Serve-API registriert und acht echte Aufnahmen aus Krisps öffentlichem Datensatz damit verarbeitet. Anschließend habe ich das Audio vor und nach der Verarbeitung mit einem Open-Source-STT-Modell transkribiert, um zu sehen, was sich tatsächlich verändert.
Das kurze Fazit: Wenn Ihr Agent Anrufe aus Büros, Wohnungen, Callcentern oder anderen Umgebungen mit Hintergrundgesprächen entgegennimmt, lohnt sich die Integration von Voice Isolation in Ihre Pipeline. In meinem Test sanken Hintergrundstimmen, die zuvor 331 falsche Wörter im Transkript erzeugt hatten, auf null. Die Nachteile sind real, aber gering: leichte Qualitätsverluste bei sauberem Telefonaudio, eine API-Region, die nur in den USA verfügbar ist, und weniger Modelle in der API als im SDK.
Das Problem: Hintergrundstimmen, nicht Hintergrundgeräusche
Spracherkennungsmodelle (STT) sind darauf trainiert, Sprache zu erfassen – nicht zu entscheiden, wessen Sprache zählt. Rauschen lässt sich herausfiltern, weil es nicht wie Sprache aussieht. Eine zweite Stimme sieht genau wie Sprache aus, weil sie auch welche ist.
Krisps eigenes Beispiel ist ein gutes dafür. Ein Anrufer möchte ein Abo kündigen, während eine Kollegin in der Nähe nach dem Mittagessen fragt. Die Spracherkennung liefert einen einzigen Wortstrom zurück, ohne zu kennzeichnen, welche Worte vom Anrufer stammen – und der Agent erhält also beide Äußerungen als eine einzige Anfrage.
Das bringt einen Voice-Agenten auf dreierlei Weise durcheinander:
- Falsche Transkripte. Die Worte der Nebenperson landen im Transkript, und das LLM beantwortet Dinge, die der Anrufer nie gesagt hat.
- Falsche Unterbrechungen. Der Agent hört die Nebenperson, hält es für eine Einmischung des Anrufers und bricht mitten im Satz ab.
- Gestörtes Sprecherwechsel-Verhalten. Hintergrundsprache sieht so aus, als spräche der Anrufer noch, sodass der Agent nicht erkennt, wann der Sprecherwechsel abgeschlossen ist.
In all diesen Fällen funktioniert die Logik des Agenten wie vorgesehen. Sie reagiert nur auf eine Stimme, die sie nie hätte hören dürfen.
Die Zahlen zeigen, wie groß die Lücke ist. In Krisps Test zum Release von Voice Isolation 2.5 erreichten 10 STT-Systeme auf sauberem Audio mit nur einem Sprecher im Durchschnitt eine Wortfehlerrate (WER) von 2,10 %. Sprach eine zweite Person gleichzeitig mit dem Anrufer, lag der Durchschnitt derselben Systeme bei 35,92 %. Geräuschunterdrückung kann diese Lücke nicht schließen, denn die Störung ist eben Sprache.
Was ist Krisp Voice Isolation
Die Krisp Voice Isolation API & SDK entfernt Hintergrundstimmen und Störgeräusche aus einem Live-Audiostream und leitet nur die Hauptstimme des Sprechers weiter. Sie wurde für Voice-AI-Agents entwickelt und basiert auf derselben Kerntechnologie, die Krisp für menschliche Anrufe unter dem Namen Background Voice Cancellation (BVC) anbietet.
Sie steht am Anfang der Pipeline eines Agenten, sodass jedes nachfolgende Modell nur eine Stimme hört:
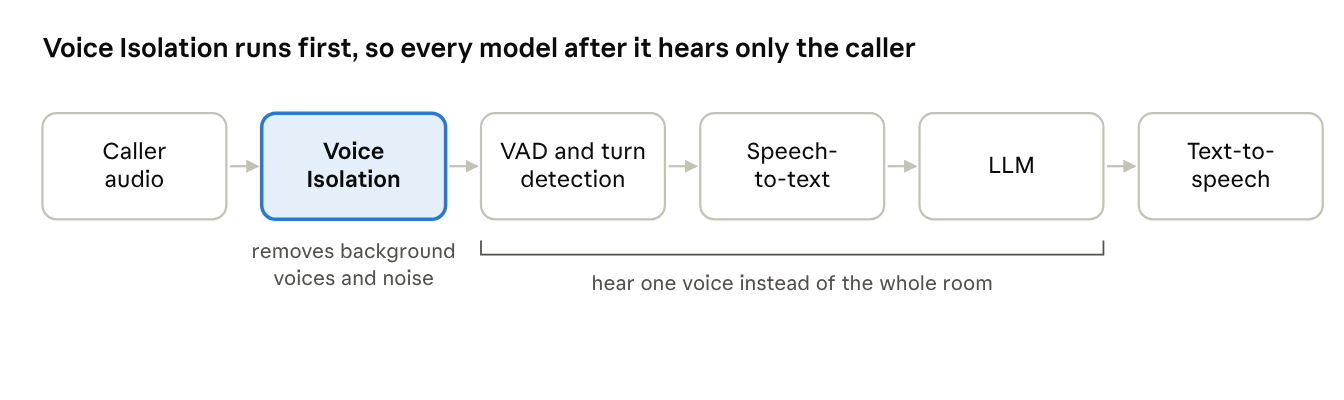
Position von Voice Isolation in der Pipeline eines Voice-Agents
Diese Positionierung ist entscheidend. Ohne Voice Isolation hören auch VAD und Turn Detection die Person im Hintergrund – genau davon stammen die falschen Unterbrechungen.
Krisp arbeitet seit rund neun Jahren an Voice AI und verarbeitet nach eigenen Angaben mehr als 1 Billion Minuten Sprache pro Jahr. Voice Isolation ist eines der Produkte im Voice-AI-API- und SDK-Angebot von Krisp. Voice Isolation ist Teil von VIVA, Krisps Suite von Echtzeitmodellen für Voice-Agents, zu der auch Turn-Taking, Interrupt Prediction und VAD gehören. Es ergänzt das Turn-Taking, ersetzt es aber nicht.
Die vier Modelle geben dir die Kontrolle darüber, wie aggressiv Hintergrundstimmen und Rauschen entfernt werden. Mit voller Aggressivität (der Standardkonfiguration) entfernt Default am meisten. Balanced verarbeitet die Hauptstimme schonender, bei gleichem Rechenaufwand. Lite benötigt etwa ein Drittel des Rechenaufwands von Default. HD ist für 32-kHz-WebRTC-Streams statt Telefonaudio vorgesehen. Die Aggressivität ist eine Laufzeiteinstellung, die du anpassen kannst, ohne den Rechenaufwand zu ändern; in der API ist das der Parameter suppression_level, mit Werten von 0 bis 100.
Eine Grenze, die man vorab kennen sollte: Die Modelle zur Stimmentfernung gehen davon aus, dass sich die sprechende Person nah am Mikrofon befindet. Als grober Richtwert: Ab etwa 30 cm Abstand kann auch die eigene Stimme der Hauptsprecherin bzw. des Hauptsprechers unterdrückt werden. Das ist keine feste Regel, sondern eine allgemeine Empfehlung – der tatsächliche Abstand hängt von den akustischen Bedingungen ab. Für Far-Field-Geräte wie Smart Speaker bietet Krisp ein separates Modell an, das ausschließlich Rauschen entfernt.
Version 2.5 erschien im August 2026, und Krisp hat im September einen offenen Benchmark und Datensatz veröffentlicht. Das Modell ist inzwischen sowohl als Self-Service-API als auch als SDK verfügbar.
Was Krisps Benchmarks zeigen
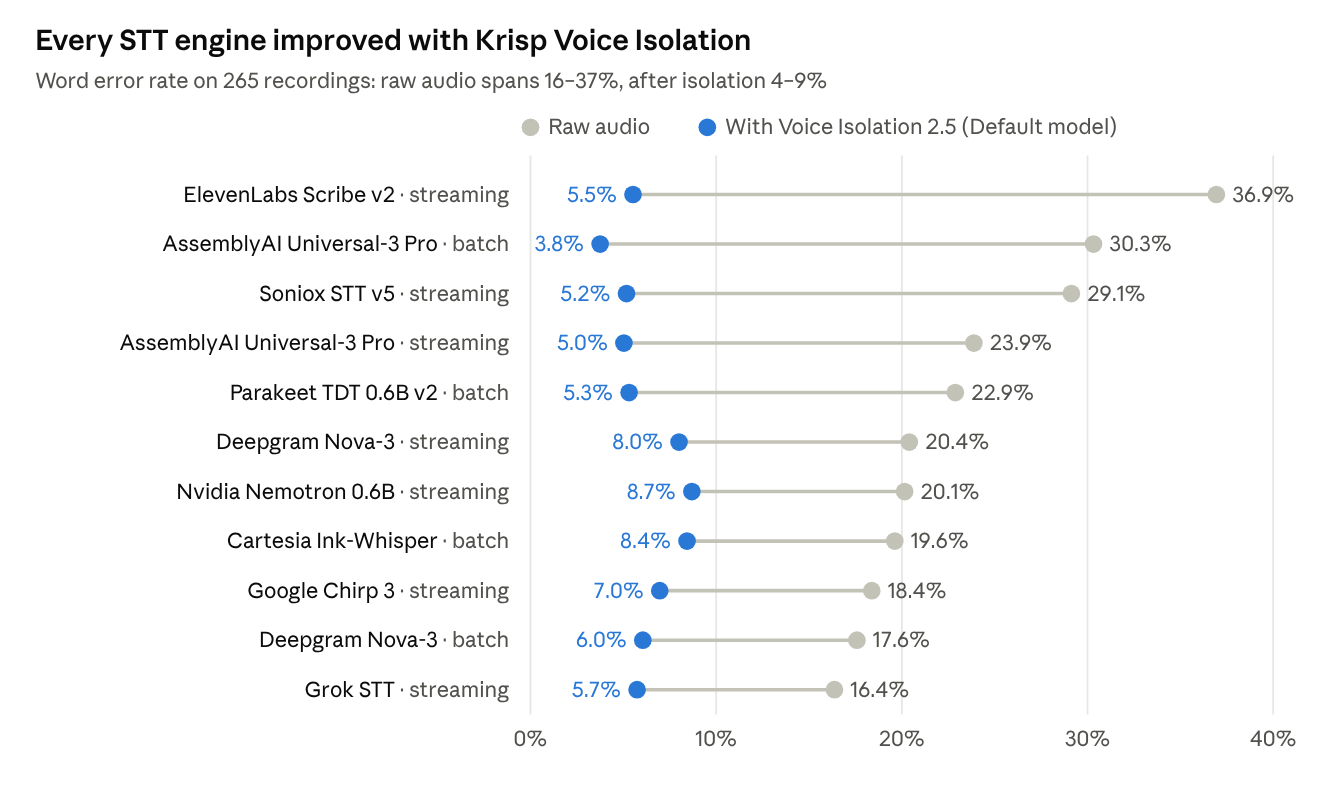
In Krisps offenem Benchmark senkte Voice Isolation die durchschnittliche Wortfehlerrate von 23,24 % auf 6,24 % – eine Verbesserung von 73 %.
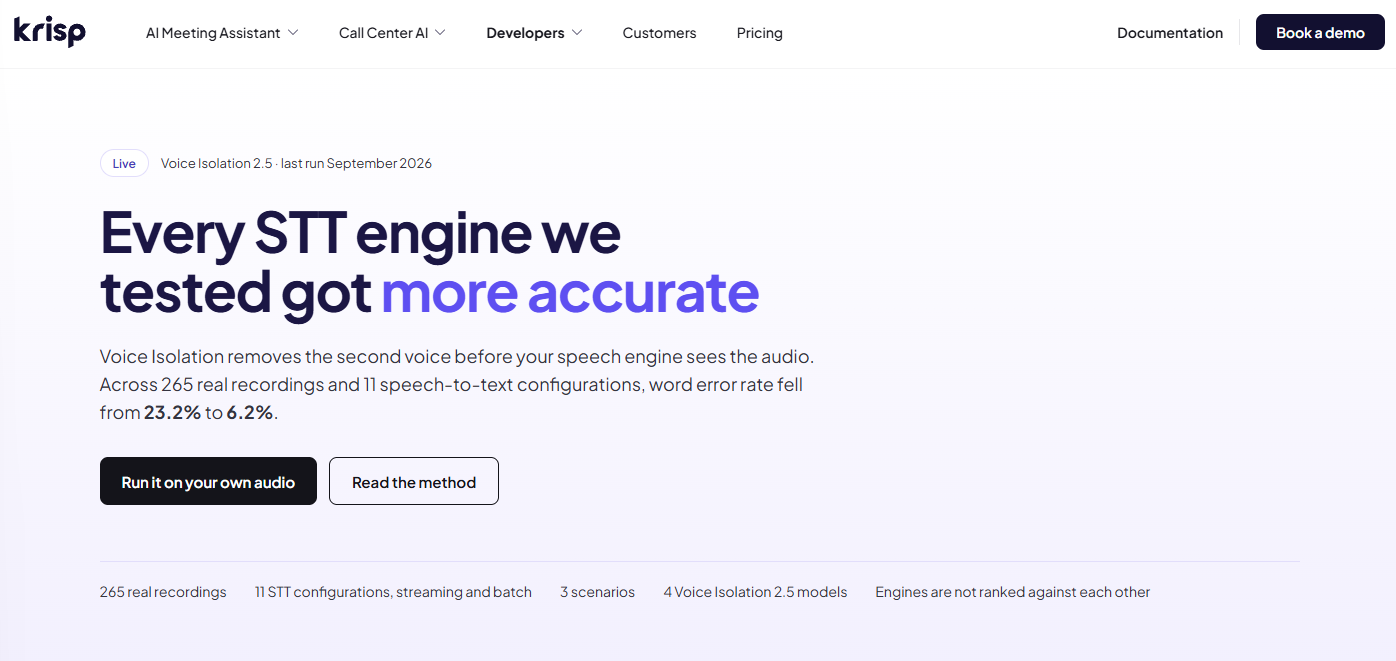
Krisps Benchmark-Seite fasst das zentrale Ergebnis zusammen.
Der Benchmark basiert auf 265 echten Aufnahmen aus Büros, Wohnungen, vier aktiven Callcenter-Etagen und Autos. Nichts wurde simuliert oder nachträglich eingemischt. Die meisten Aufnahmen folgen demselben Skript: Der Hauptprecher spricht, eine zweite Person kommt hinzu, der Hauptprecher verstummt, während die andere weiterredet, und dann kommt der Hauptprecher zurück. Dieses stille Intervall ist der eigentliche Test, denn die korrekte Transkription dafür ist leer. Jede Datei wurde durch 11 STT-Konfigurationen von neun Engines laufen gelassen – mit und ohne Isolation.
Quelle: Krisp Voice Isolation Benchmark, Okt. 2026 · 11 STT-Konfigurationen, alle Szenarien zusammengefasst
Jede Engine hat sich verbessert, keine wurde schlechter. Der aufschlussreichere Befund betrifft die Lücke zwischen den Engines: Bei rohem Audio beträgt sie rund 20 Punkte, nach der Isolation schrumpft sie auf etwa 5. Wenn Ihr Agent Stimmen im Hintergrund hört, verbessert die Bereinigung des Eingangssignals Ihre WER mehr als der Wechsel zu einem anderen STT-Anbieter.
Nach Szenario hängt der Gewinn davon ab, ob eine zweite Stimme vorhanden ist:
Wo es nicht hilft
Krisp veröffentlicht auch seine Schwachstellen, und ich finde, das ist der überzeugendste Teil des Berichts.
- Sauberes Telefon-Audio wird leicht schlechter. Wenn es keine zweite Stimme zu entfernen gibt, kann die Isolation nur die Hauptstimme beeinflussen. Die WER bei Telefonanrufen stieg von 3,48 % auf 3,91 %, und bei einer Datei stieg sie von 9,42 % auf 21,65 %. Das Balanced-Modell schneidet hier mit 3,53 % am besten ab.
- Schwerer Hall ist weiterhin ein Problem. Im separaten 2.5-Release-Test erzielten Aufnahmen mit einer einzelnen Sprecherin oder einem einzelnen Sprecher unter schwierigen akustischen Bedingungen 11,61 % mit Isolation gegenüber 8,02 % ohne. Das ist deutlich besser als Version 2.1 (15,42 %), aber immer noch schlechter, als gar nichts zu tun.
- Übermäßige Isolation verursacht stille Fehler. Krisp erklärt, dass frühere Modelle manchmal Teile der Hauptstimme entfernt haben. Ein Mensch verstand das Audio noch, aber die Spracherkennung ließ ganze Satzteile weg, und das Transkript las sich sauber – nur mit Lücken darin. Version 2.5 wurde zur Behebung dieses Problems eher für die Spracherkennung als für menschliche Ohren optimiert.
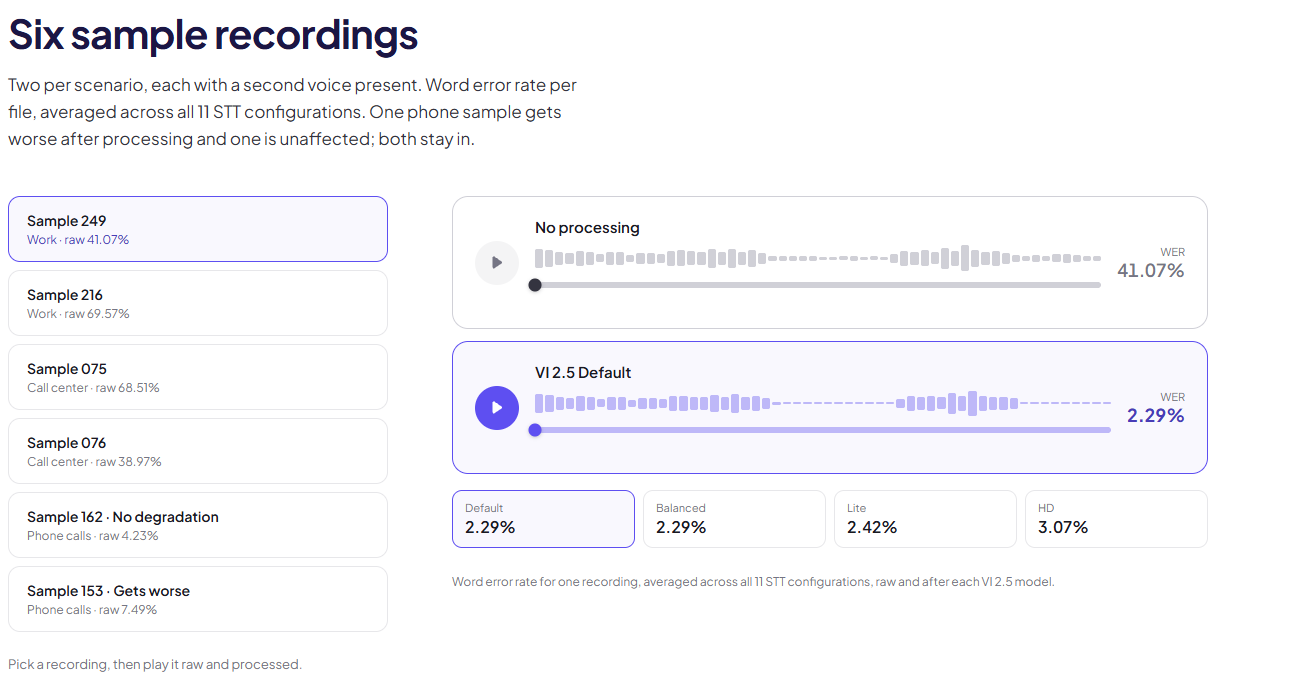
Auf der Benchmark-Seite können Sie sechs Aufnahmen im Rohzustand und verarbeitet anhören. Sample 153, ein Telefonanruf, ist mit „Gets worse" (Wird schlechter) gekennzeichnet.
Zwei weitere Dinge, die man im Hinterkopf behalten sollte: Die 73-%-Zahl und die 46,4-%-Zahl, die man auf Krisps Website sieht, stammen aus verschiedenen Tests: 265 Aufnahmen im offenen Benchmark und 1.685 Aufnahmen im 2.5-Release-Test. Und Krisps Ergebnisse vergleichen Audio mit und ohne seine eigene Isolation, nicht mit Isolationsprodukten anderer Anbieter.
Die Aufnahmen, handgeschriebenen Transkripte, Segment-Labels und die Ausgaben aller Modelle sind öffentlich auf Hugging Face verfügbar, sodass jeder den Test nachvollziehen kann. Genau das habe ich als Nächstes getan.
Praxistest: Die Voice Isolation API auf dem Prüfstand
In meinem Test hat Voice Isolation jedes Wort der Hintergrundspeeches aus den Transkripten entfernt, und die gepoolte WER sank von 40,1 % auf 10,2 %.
Einrichtung
Die Registrierung im Developers Portal geht schnell – per Google-, Microsoft- oder E-Mail-Login. Die Testversion gab mir 30 $ an Guthaben und ein Limit von zwei gleichzeitigen Sitzungen. Von dort geht es zu API Keys → Create key, und man erhält einen Schlüssel, den man nur einmal kopieren kann.
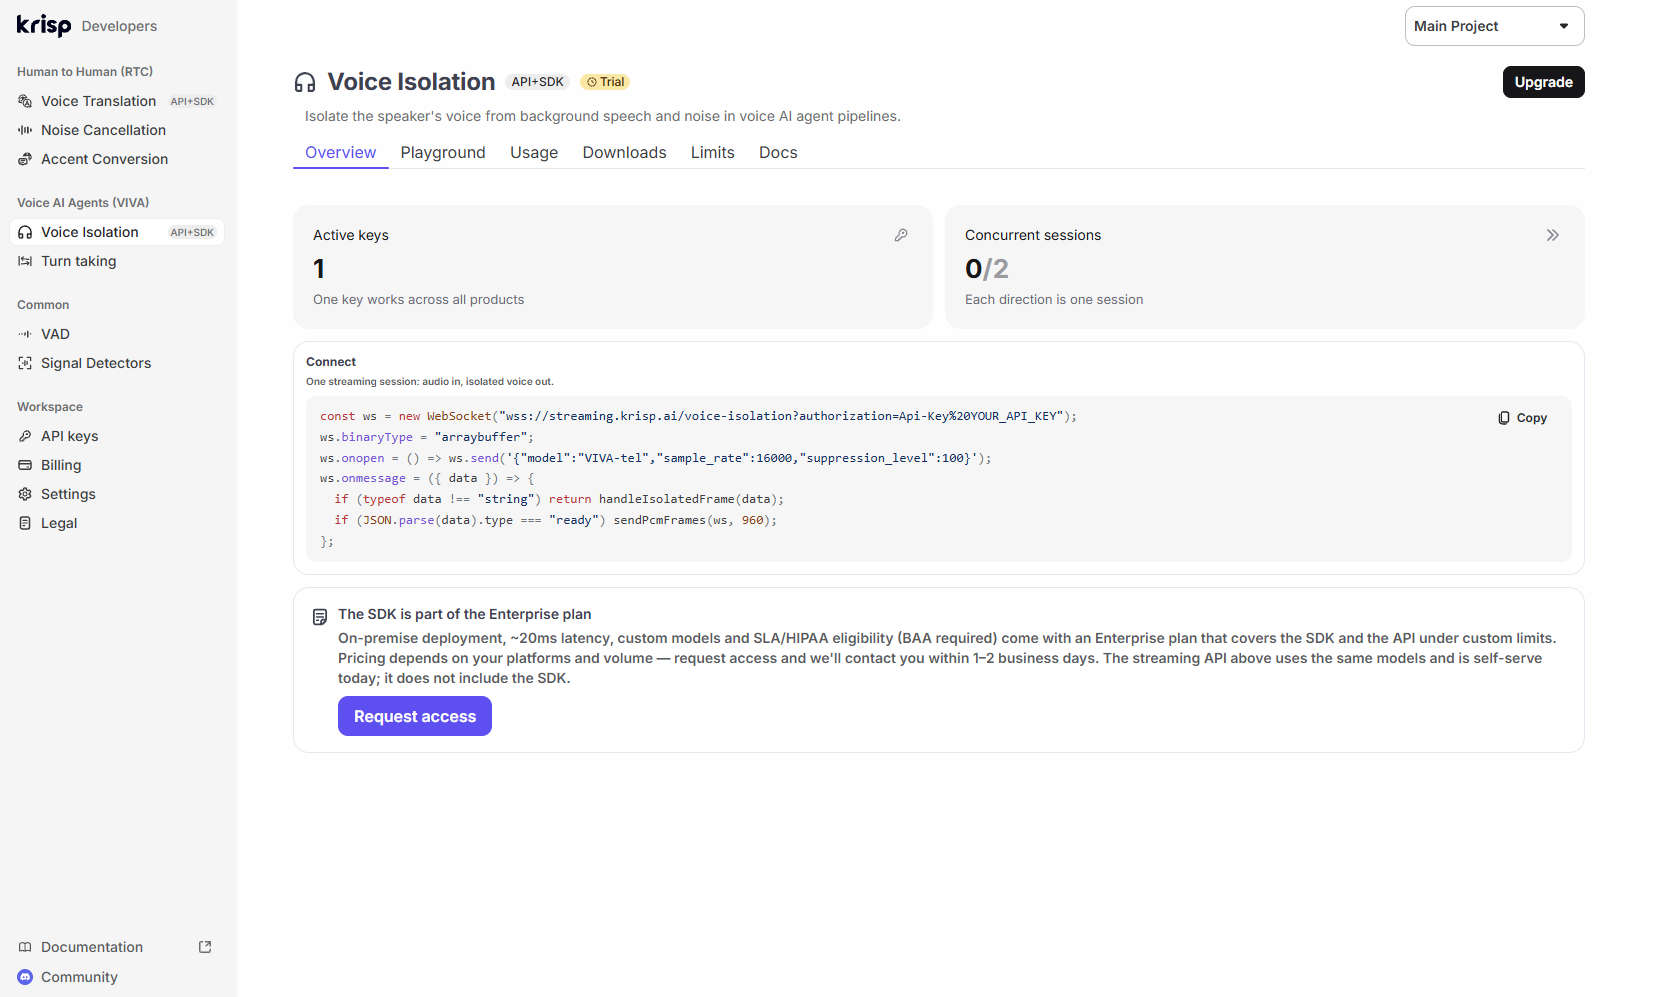
Die Voice-Isolation-Seite im Developers Portal mit dem Testtarif.
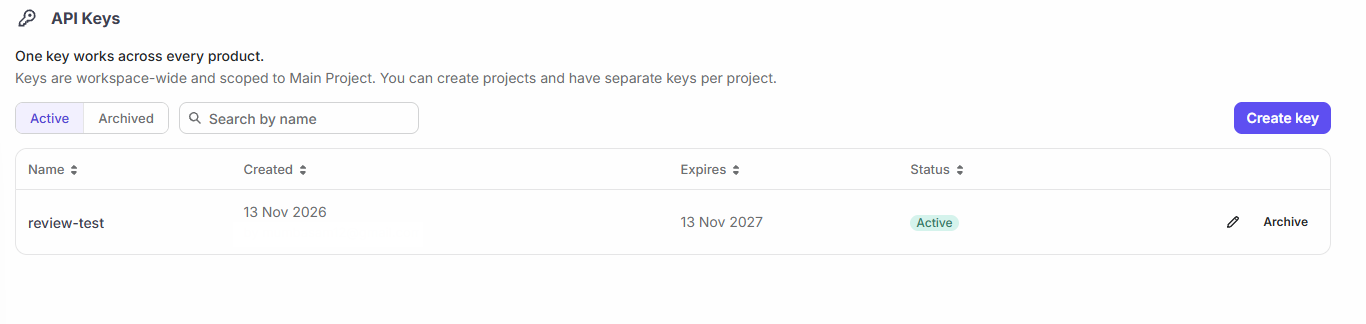
Der API-Schlüssel, den ich für diesen Test erstellt habe. Ein Schlüssel funktioniert für alle Krisp-API-Produkte, einschließlich der Voice Translation API.
Die API ist ein WebSocket. Dein Backend tauscht den API-Schlüssel gegen ein kurzlebiges Session-Token, der Client sendet ein kleines JSON-Hello, wartet auf ready und streamt dann 16-Bit-Mono-PCM, wobei er frame für frame gereinigtes Audio zurückbekommt:
URL = "wss://streaming.krisp.ai/voice-isolation"async with websockets.connect(URL, additional_headers={"Authorization": f"api-key {session_token}"}) as ws: await ws.send(json.dumps({"model": "VIVA-tel", "sample_rate": 16000, "suppression_level": 100})) hello = json.loads(await ws.recv()) # {"type": "ready", ...} # then send exactly 30 ms of audio per message (960 bytes at 16 kHz) # and write each binary message you receive to your output
Das entspricht in etwa Krisps API-Quickstart, einem kurzen Python-Skript, das eine WAV-Datei bereinigt. Eine Regel verursacht häufig Stolperfallen: Jede Audionachricht muss exakt 30 ms lang sein. Alles andere beendet die Sitzung mit einem invalid_frame_duration-Fehler, also sollte man den letzten Frame mit Stille auffüllen.
Für den Test wählte ich acht Aufnahmen aus Krisps öffentlichem Datensatz: drei Büroaufnahmen, drei vom Callcenter-Boden und zwei Telefonate aus einem Auto, insgesamt etwa 11 Minuten. Ich streamte jede davon in Echtzeit durch die API – von Asien aus. Anschließend transkribierte ich das rohe und das bereinigte Audio mit NVIDIAS Open-Source-Modell Parakeet TDT 0.6B v2, einer der Engines in Krisps Benchmark, und bewertete jedes beschriftete Segment anhand der menschlichen Transkripte.
Ergebnisse
Fast die gesamte Verbesserung kam aus einer einzigen Stelle: den Zeitfenstern, in denen der Hauptsprecher schwieg und jemand anderes weiterredete. Beim rohen Audio wandelte Parakeet diese Hintergrundsprache in 331 Wörter Transkript um. Nach der Voice Isolation entstand davon keins. Die Hintergrundstimme war in diesen Fenstern 13 bis 34 dB leiser, während sich der Pegel des Hauptsprechers kaum veränderte (innerhalb von 1 dB).
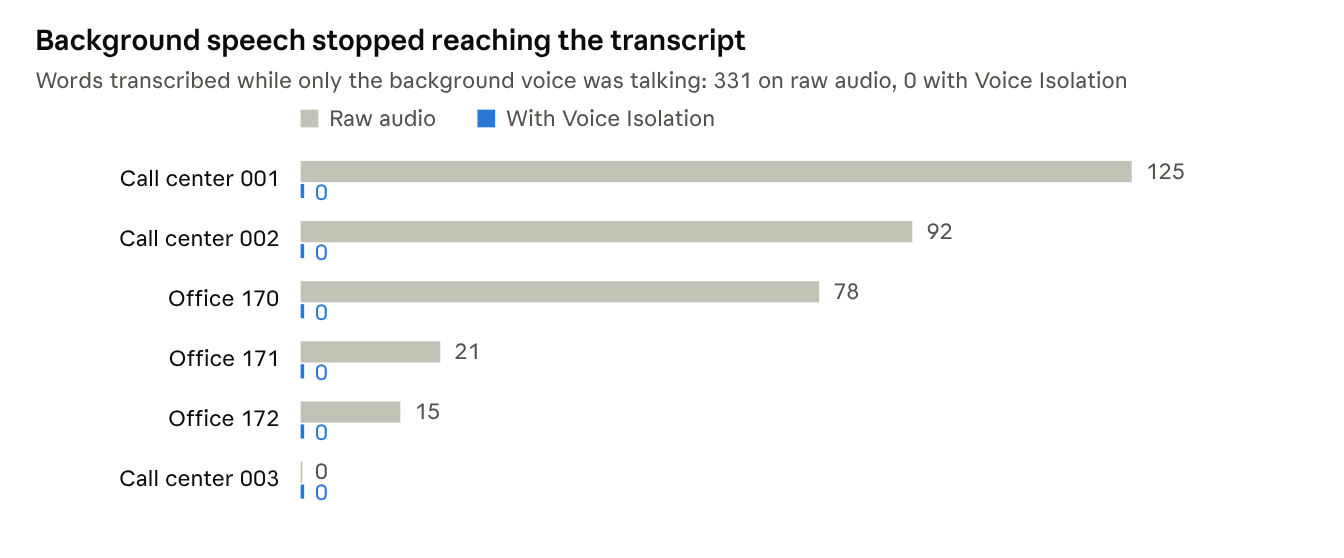
Mein Test · Krisp API (VIVA-tel), transkribiert mit Parakeet TDT 0.6B v2 · die 6 Aufnahmen mit einem reine-Hintergrund-Fenster
Das Callcenter-Beispiel zeigt, warum das wichtig ist. Während der Agent, den ich testete, pausierte, führte der Agent am Nebentisch ein anderes Gespräch. Das rohe Transkript übernahm dieses Gespräch Wort für Wort:
thank you for calling meridian bank before i begin i will need to confirm your identity for security could you give me your full name your date of birth...
Ein Voice-Agent würde das als die Rede des Anrufers interpretieren. Mit Voice Isolation blieb dasselbe Zeitfenster leer.
Wenn beide Personen gleichzeitig sprachen, war die Veränderung gering: 13,2 % roh gegenüber 12,5 % bereinigt. Parakeet bevorzugte in diesen Abschnitten bereits die lautere, näher gelegene Stimme. Die meisten verbleibenden Fehler dort sind Zahlenformatierungen in meiner Bewertung (Telefonnummern, Preise, Postleitzahlen), die beide Versionen gleichermaßen betrafen.
Bei den beiden sauberen Telefongesprächen kam in einer Datei ein Fehler dazu, in der anderen verschwanden zwei. Das deckt sich mit Krisps eigener Feststellung, dass der Aufwand bei sauberem Audio gering ist.
Latenz und Zuverlässigkeit von außerhalb der USA
Die API läuft derzeit nur in der US-Region, und Krisps Dokumentation warnt, dass Clients an anderen Standorten zusätzliche Latenz erleben werden. Aus Asien betrug die mediane Round-Trip-Zeit für einen Frame (Senden bis zur Rückkehr des bereinigten Audios) je nach Sitzung 260–520 ms, und der Aufbau einer Sitzung dauerte in der Regel 1,5–3 Sekunden. Das ist Netzwerkentfernung, nicht das Modell: Krisp nennt 15 ms algorithmische Latenz. Aber wenn Ihr Agent Nutzer weit entfernt von den USA bedient, werden Sie das spüren – und das SDK auf eigenen Servern umgeht das.
Eine meiner neun Sitzungen brach etwa 70 Sekunden nach Beginn mit einer abnormalen Trennung ab. Ein erneuter Lauf funktionierte. Ich führe das auf die lange Route von Asien aus zurück und nicht auf den Dienst, aber es ist eine Erinnerung daran, in der Produktion Reconnects zu behandeln.
Zu diesem Test: Acht Dateien sind eine kleine Stichprobe, kein Benchmark. Ich resamplete die 32-kHz-Aufnahmen für das Telephony-Modell (VIVA-tel) auf 16 kHz, verwendete eine STT-Engine und hielt die Textnormalisierung einfach, daher sind meine absoluten Zahlen nicht mit denen von Krisp vergleichbar. Was ich überprüft habe, sind Richtung und Ausmaß der Veränderung – und das stimmte mit Krisps Angaben überein.
Entwicklererfahrung: API oder SDK
Voice Isolation ist auf zwei Arten verfügbar, und welche davon Sie nutzen können, hängt von Ihrem Tarif ab.
Die API ist der einfache Einstieg: keine Modelldateien, die ausgeliefert werden müssen, und nichts, was auf Ihrer CPU laufen muss. Die Nachteile: Ihre Audiodaten landen in der Cloud von Krisp, und Sie erhalten nur zwei Modelle statt vier: VIVA-tel für Telefondaudio mit 8 oder 16 kHz und VIVA-pro für Breitbandaudio mit 32 kHz. VIVA-pro ist noch nicht in der API-Referenz aufgeführt, ist aber im Playground des Portals verfügbar, wurde in meinem Test von der API akzeptiert, und Krisp hat bestätigt, dass es verfügbar ist.
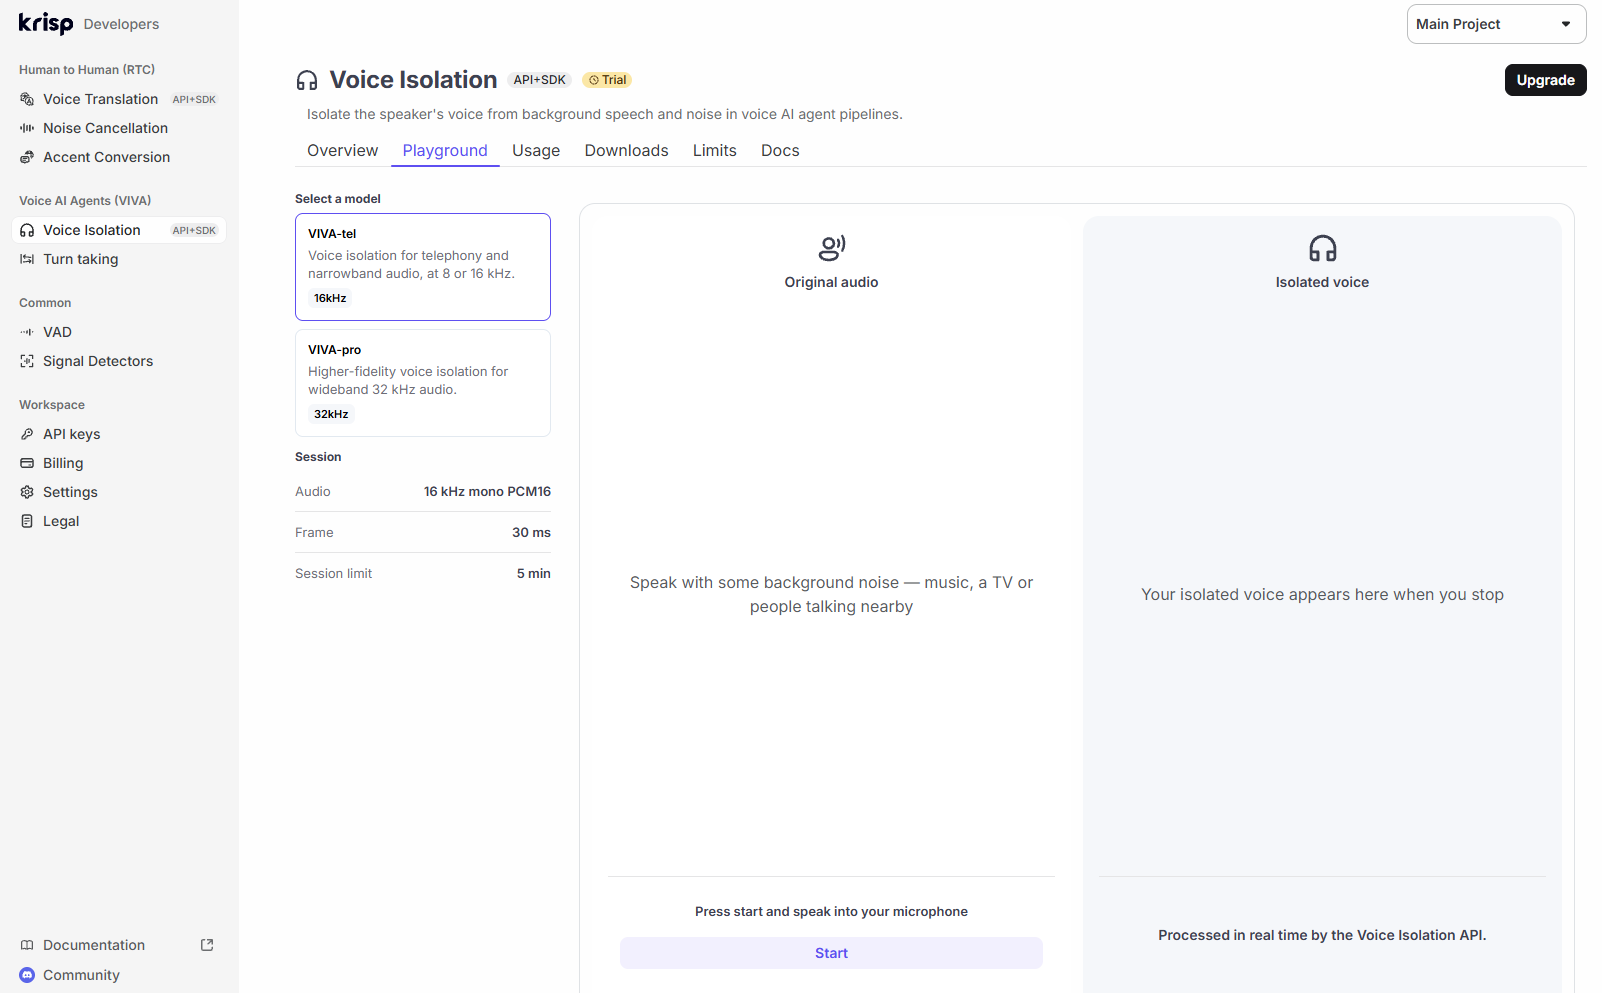
Im Playground des Portals können Sie beide API-Modelle mit Ihrem eigenen Mikrofon testen, bevor Sie Code schreiben.
Das SDK verarbeitet Audio auf Ihren eigenen Servern und geht nur online, um seine Lizenz zu prüfen. Hier wird die Kostengeschichte auch interessant. Krisps CPU-Beitrag zeigt, dass ein einzelnes SDK-Flag, enableLowPrecisionExecution, die Anzahl der Anrufe, die ein Server auf CPUs mit FP16-Unterstützung bereinigen kann, ungefähr verdoppelt. Eine AWS-Graviton3-Instanz mit 16 vCPUs kam von 76 Live-Anrufen auf 137, und das Lite-Modell bewältigt etwa dreimal so viele Streams wie die vollständigen Modelle. Auf älteren Intel-Ice-Lake-Chips hat das Flag keine Wirkung.
Integrationen
- Pipecat bietet einen fertigen Filter. Sie fügen KrispVivaFilter() als Audio-Eingabefilter Ihres Transports hinzu und können ihn mit KrispVivaTurn für die Sprecherwechsel-Erkennung kombinieren. Beachten Sie, dass dabei das SDK verwendet wird, Sie benötigen also SDK-Zugang und die Modelldateien, nicht nur einen API-Schlüssel.
- LiveKit bietet Krisp-Modelle in LiveKit Cloud an, einschließlich der Unterdrückung von Hintergrundstimmen (noise_cancellation.BVC()) für Agenten. LiveKit berechnet für seine Sprachisolationsmodelle einen Aufpreis.
- WebRTC- und Telefonie-Pipelines können das SDK direkt nutzen, und die API funktioniert mit allem, was eine WebSocket öffnen kann.
Die Dokumentation ist klar und aktuell. Der Schnellstart funktionierte beim ersten Versuch, und die Fehlermeldungen sagen Ihnen genau, was schiefgelaufen ist – bis hin zur erwarteten und empfangenen Frame-Größe. Mein einziger Kritikpunkt ist die Namensgebung: Im Blog ist von Default, Balanced, Lite und HD die Rede, die SDK-Downloads verwenden Dateinamen wie krisp-viva-vi-tel-v2.5.1, und die API nennt ihre Modelle VIVA-tel und VIVA-pro, wobei nur das erste in der API-Referenz aufgeführt ist. Eine Zuordnungstabelle in der Dokumentation wäre hilfreich.
Preise
Die API wird pro Stunde Audio abgerechnet und ist günstig genug, dass die Kosten nicht das Entscheidungskriterium für die Nutzung sein sollten.
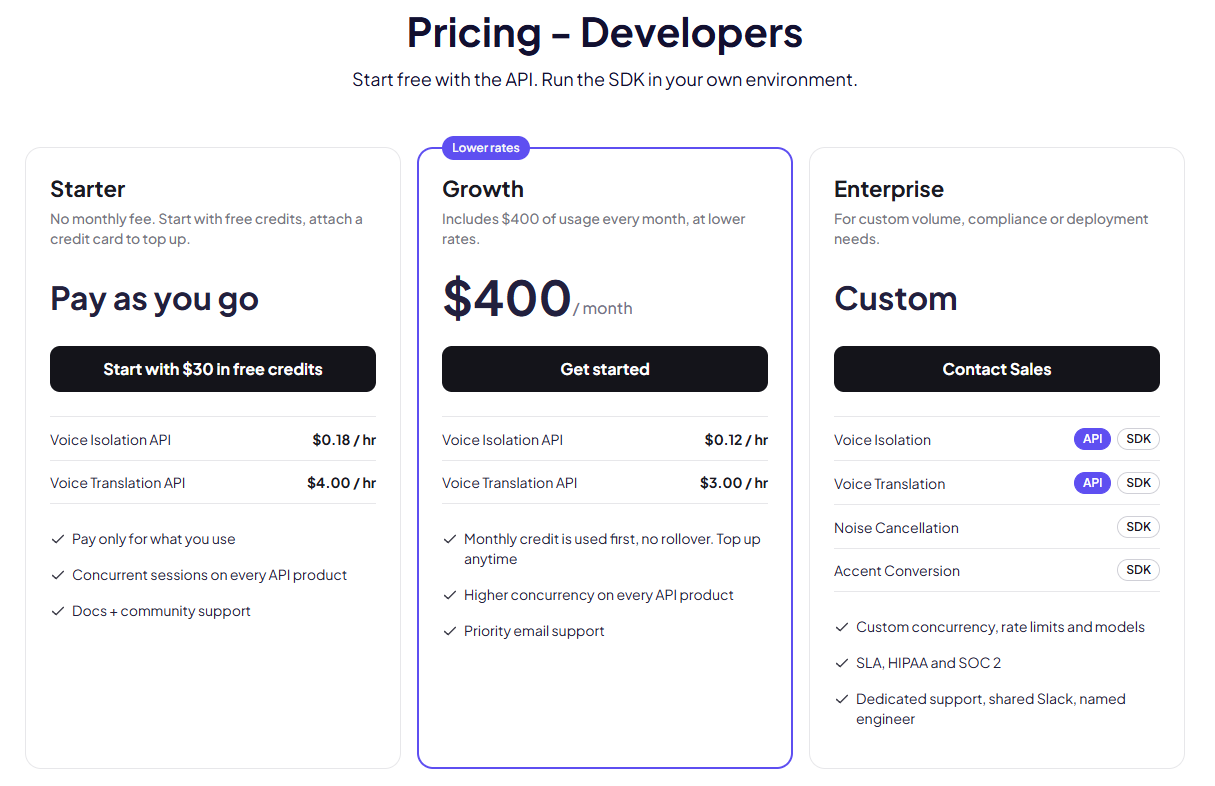
Die Entwicklerpreise von Krisp, Stand November 2026.
Im nutzungsbasierten Starter-Tarif kostet die Voice Isolation API 0,18 $ pro Stunde Audio, ohne monatliche Grundgebühr. Der Preis ist bei beiden API-Modellen, VIVA-tel und VIVA-pro, identisch. Der Growth-Tarif kostet 400 $ pro Monat, enthält 400 $ Nutzungsvolumen und senkt den Preis auf 0,12 $ pro Stunde – mit höherer Concurrency und Priority Support. Enterprise wird individuell kalkuliert und ist der einzige Tarif, der das SDK, eine SLA sowie HIPAA- und SOC-2-Konformität umfasst.
Das Startguthaben von 30 $ reicht für etwa 166 Stunden Audio zum Starter-Preis – mehr als genug zum Testen. Guthaben gilt 12 Monate, und die Abrechnung erfolgt minutengenau. Zur Orientierung: Ein 5-minütiger Anruf kostet im Starter-Tarif etwa 1,5 Cent, um ihn zu bereinigen.
Das SDK ist nur im Enterprise-Tarif zu einem vereinbarten Preis enthalten. Wenn Sie die Modelle auf Ihren eigenen Servern betreiben möchten, müssen Sie also mit dem Vertrieb sprechen. Die Preise stammen von der Preisseite von Krisp (Stand: November 2026).
Alternativen
Krisp ist nicht die einzige Option zum Entfernen von Hintergrundstimmen, aber einen unabhängigen direkten Vergleich dieser Produkte gibt es bisher nicht. Jeder Anbieter veröffentlicht seine eigenen Zahlen auf Basis seiner eigenen Daten – betrachten Sie die folgenden Angaben daher als Behauptungen.
Womit Krisp wirklich überzeugt, sind die Belege. Es ist der einzige Anbieter hier mit einem offenen, reproduzierbaren Benchmark über 11 STT-Konfigurationen hinweg – und er veröffentlicht auch die Fälle, in denen er verliert. Außerdem lässt es sich am flexibelsten einsetzen: als Cloud-API, als SDK auf eigenen Servern oder integriert in LiveKit und Pipecat.
Fazit
Krisp Voice Isolation ist die Lösung, wenn ein Voice-Agent in echten Anrufen Probleme macht und in Tests einwandfrei funktioniert. Es entfernt die Stimmen, die Ihr Agent nicht hören sollte, funktioniert mit jedem STT-System, das Sie bereits verwenden, und sowohl Krisps Benchmark als auch mein eigener Test zeigen dasselbe: Hintergrundgespräche gelangen nicht mehr ins Transkript.
Vorteile
- Entfernt Hintergrundstimmen, nicht nur Rauschen – genau das Problem, das STT allein nicht lösen kann
- Funktioniert mit jeder STT-Engine, ohne sprachspezifische Einrichtung oder Voice Enrollment
- Läuft auf der CPU mit nur 15 ms algorithmischer Latenz
- Offener, reproduzierbarer Benchmark, der auch die Fälle einschließt, in denen das Tool verliert
- Self-Service-API mit 30 $ kostenlosem Guthaben und günstig mit 0,12–0,18 $ pro Stunde
- Fertiger Pipecat-Filter und LiveKit-Unterstützung
Nachteile
- Leichte Genauigkeitseinbußen bei sauberem Telefonaudio, und weiterhin schlechter als Rohaudio in Räumen mit starkem Echo
- Die API läuft nur in der US-Region, was an anderen Standorten spürbare Latenz verursacht
- Die API bietet zwei Modelle gegenüber vier im SDK; On-Premise-Nutzung erfordert das Enterprise SDK
Für wen es geeignet ist: Teams, deren Agents Anrufe aus Callcentern, Büros, Wohnungen, Autos oder überall sonst entgegennehmen, wo in der Nähe andere Menschen sprechen. Beginnen Sie mit der API, um die Wirkung auf Ihren eigenen Aufnahmen zu messen, und wechseln Sie zum SDK, wenn Sie die anderen Modelle, geringere Latenz außerhalb der USA oder Audio, das auf Ihren Servern bleibt, benötigen.
Wer es überspringen kann: Agents, deren Anrufer fast immer allein in ruhigen Räumen sind, sowie Fernfeld-Geräte wie Smart Speaker, für die die Modelle zur Stimmentfernung nicht ausgelegt sind.
Sie können die Krisp Voice Isolation API mit den kostenlosen Guthaben testen und Ihre eigenen Aufnahmen an einem Nachmittag damit verarbeiten.
FAQ
Ist Stimmisolierung dasselbe wie Geräuschunterdrückung? Nein. Geräuschunterdrückung entfernt Sprachfremde Geräusche wie Verkehr und Tastaturgeräusche. Stimmisolierung entfernt zusätzlich die Stimmen anderer Personen, die die Geräuschunterdrückung bestehen lässt.
Funktioniert die Krisp-Stimmisolierung mit meinem STT-Anbieter? Ja. Sie verarbeitet das Audio direkt, sodass sie vor jeder STT-Engine eingesetzt werden kann. Krisp hat sie mit 11 Konfigurationen getestet, darunter Modelle von Deepgram, AssemblyAI, ElevenLabs, Soniox, Google, Cartesia und NVIDIA. Sie kann auch vor Speech-to-Speech-Modellen geschaltet werden. Krisp hat dafür noch keine Ergebnisse veröffentlicht, aber nichts hindert Sie, es auszuprobieren.
Ersetzt sie die Sprecherwechsel-Erkennung? Nein. Sie kommt vor VAD und Turn Detection und liefert ihnen saubereres Audio. Krisp bietet Turn-Taking als separates Modell im selben VIVA SDK an.
Müssen Nutzer ihre Stimme registrieren? Nein. Es ist weder eine Registrierung noch ein Training auf die Stimme des Nutzers erforderlich.
Wie viel Latenz kommt hinzu? Krisp nennt 15 ms algorithmische Latenz, und die SDK-Dokumentation beziffert die zusätzliche Latenz auf etwa 20 ms. Bei der Cloud-API kommt noch die Netzwerkzeit zur US-Region hinzu.
Funktioniert sie bei Telefonanrufen? Ja. Sie verarbeitet Schmalband-Telefonie-Audio, gängige Codecs wie G.711, G.722, G.729 und Opus sowie Bluetooth-Headsets.
Und was ist mit Gesprächen von Mensch zu Mensch? Dieselbe Technologie ist als Background Voice Cancellation (BVC) in Krisps RTC SDK enthalten, das auf dem Gerät des Nutzers in Browsern sowie Desktop- und Mobile-Apps läuft. Kontaktcenter mit menschlichen Agents erhalten sie über das Produkt Krisp’s call center AI, wo sie dafür sorgt, dass die Stimmen benachbarter Agents nicht in Kundenanrufe gelangen.