
Moonshot AI hat Kimi K3 am 16. Juli 2026 ausgeliefert, und die Berichterstattung über den Start stellte dies als direkte Herausforderung für Anthropic dar. TechCrunch berichtete, dass K3 die Lücke zu Closed-Source-Modellen schließen sollte, und zitierte Quellen, die sagten, es könne Claude Opus 4.8 erreichen oder sogar übertreffen. Dieser Beitrag vergleicht die Modelle Dimension für Dimension, wobei die überprüfbaren Zahlen und die nicht klar gekennzeichneten Zahlen deutlich gemacht werden.
Die Kurzversion: K3 gewinnt bei Preis, Kontextfenster und Offenheit; Opus 4.8 bietet die Gewissheit eines ausgereiften, verwalteten Anbieters. Da beide das OpenAI SDK-Format sprechen, können Sie dieselbe Anfrage durch jedes Modell senden und Ausgaben, Latenz und Kosten in einem Tool wie Apidog vergleichen.
TL;DR und das Urteil auf einen Blick
Kimi K3 ist ein Mixture-of-Experts-Modell mit 2,8 Billionen Parametern, einem Kontextfenster von 1 Million Tokens, günstigen Eingabepreisen und offenen Gewichten, die voraussichtlich am 27. Juli 2026 verfügbar sein werden. Claude Opus 4.8 ist ein geschlossenes proprietäres Modell aus der Opus-Reihe von Anthropic, das teurer ist und einen guten Ruf für Schlussfolgerungen und Agentenfähigkeiten genießt. Eine unabhängige Bewertung von Artificial Analysis weist K3 einen Intelligence Index von 57 zu, womit es auf Platz 4 von 189 Modellen rangiert und das beste unter den offenen Gewichten ist.
Hier ist die Kurzfassung:
- Wählen Sie Kimi K3 für ein sehr großes Kontextfenster, niedrige Kosten bei hohem Volumen oder die Möglichkeit, offene Gewichte selbst zu hosten und feinabzustimmen.
- Wählen Sie Claude Opus 4.8 für eine ausgereifte Anbieterbeziehung, verwalteten Support und SLAs sowie eine lange Produktionshistorie bei schwierigen Agentenaufgaben, wenn Sie den Aufpreis zahlen.
- Es ist knapp, nicht entschieden. Es existiert noch keine unabhängige, direkte Vergleichstabelle für K3-versus-Opus-4.8, daher sollten Sie jede Überschrift, die „der eine schlägt den anderen insgesamt“ lautet, mit Vorsicht behandeln.
Eine Anmerkung zur Einordnung. Das derzeitige Top-Modell von Anthropic, das allgemein verfügbar ist, ist Claude Fable 5; Opus 4.8 liegt deutlich unter diesem Spitzenniveau und ist nicht das Flaggschiff. Moonshots Launch-Blog sagt, K3 „hinkt immer noch den leistungsstärksten proprietären Modellen, Claude Fable 5 und GPT 5.6 Sol, hinterher“, und nennt Fable 5 und Sol, nicht Opus. Die ehrliche Geschichte ist also nicht „offenes Modell entthront Anthropic“. Es ist „offenes Modell schließt die Lücke, gewinnt bei Preis, Kontext und Offenheit und hinkt nur an der obersten Qualitätsspitze hinterher.“
Der Start und warum dieser Vergleich existiert
K3 ist Moonshots größter Schritt auf der Open-Weight-Leiter, und mit insgesamt 2,8 Billionen Parametern ist es das bisher größte Open-Weight-Modell aus China. Die Architektur basiert auf Kimi Delta Attention, Attention Residuals und einem Design, das Moonshot Stable LatentMoE nennt, das 16 von 896 Experten pro Token aktiviert. Moonshot hat die Anzahl der aktiven Parameter nicht veröffentlicht, daher werden wir sie nicht schätzen. Der Hauptartikel über was Kimi K3 ist behandelt die Architektur und den Zugang vollständig.
Der Vergleich existiert, weil Unternehmen immer wieder fragen, ob teure geschlossene Modelle es wert sind, wenn ein Open-Weight-Modell qualitativ nahe herankommt und auf der eigenen Hardware läuft. Die Einordnung wurde zu „K3 vs. Opus 4.8“ statt „K3 vs. Fable 5“, weil Opus 4.8 die Stufe ist, auf der ein offener Herausforderer eine plausible Chance hat. Der TechCrunch-Bericht liefert den Marktkontext.
Kimi K3 und Claude Opus 4.8 auf einen Blick
Hier ist der direkte Vergleich der Dimensionen, die eine Kaufentscheidung beeinflussen. Wo eine Zahl nicht öffentlich bestätigt ist, ist dies in der Zelle vermerkt.
| Dimension | Kimi K3 | Claude Opus 4.8 |
|---|---|---|
| Anbieter | Moonshot AI | Anthropic |
| Start | 16. Juli 2026 | Teil der Claude Opus 4-Reihe |
| Modelltyp | 2.8T-Parameter MoE (Stable LatentMoE, 16 von 896 Experten aktiv) | Proprietär, Architektur nicht offengelegt |
| Modell-ID / Zugang | kimi-k3, OpenAI SDK kompatibel |
Claude API (claude-opus-4-8 Familie) |
| Kontextfenster | 1.048.576 Tokens (1M) | Groß, aber unter K3s 1M Fenster |
| Eingabepreis | $0.30 / M Cache-Treffer, $3.00 / M Cache-Fehltreffer | $5.00 / M |
| Ausgabepreis | $15.00 / M | $25.00 / M |
| Ausgabegeschwindigkeit | ~62 Tokens/Sek. (Artificial Analysis) | Hier nicht zitiert; siehe Artificial Analysis |
| Unabhängiger Score | Intelligence Index 57, #4 von 189 (Artificial Analysis) | Top proprietäre Stufe (siehe Artificial Analysis) |
| Gewichte | Offene Gewichte, um den 27. Juli 2026 | Geschlossen |
| Qualitätsposition | Das Beste unter den offenen; hinkt Fable 5 und GPT 5.6 Sol hinterher (Moonshot) | Starke proprietäre Stufe unterhalb von Anthropic’s Fable 5-Grenze |
Die meisten Zellen favorisieren K3 bei Wirtschaftlichkeit und Zugang. Qualität ist die umstrittene Zeile, und wir werden sie als Nächstes genauer betrachten.
Intelligenz und Qualität: Wo die Spitzenklasse immer noch die Oberhand hat
Qualität ist die am schwierigsten zu bestimmende Dimension, da es noch keinen gemeinsamen unabhängigen Benchmark gibt, der K3 und Opus 4.8 direkt vergleicht. Das klarste unabhängige Signal kommt von Artificial Analysis, dessen Intelligence Index K3 an oder nahe der Spitze in einer Mischung aus Schlussfolgerungs-, Codierungs- und Wissensbewertungen positioniert und das führende Open-Weight-Modell in dieser Liste ist. Es wird auch vermerkt, dass K3 langsamer als der Durchschnitt läuft und wortreich ist.
Das Gegengewicht kommt von Moonshot selbst. Ihr Launch-Blog ist offen: Die Gesamtleistung von K3 „hinkt immer noch den leistungsfähigsten proprietären Modellen, Claude Fable 5 und GPT 5.6 Sol, hinterher.“ Dieser Satz nennt Fable 5 und Sol, nicht Opus 4.8. Somit platziert Moonshots eigene Aussage K3 hinter Fable 5 und Sol und sagt nichts darüber aus, dass K3 gegen Opus 4.8 verliert.
Die Benchmark-Tabelle des Anbieters bestätigt dies. Nach Moonshots Launch-Zahlen übertrifft K3 bei der maximalen Schlussfolgerungseinstellung Opus 4.8 in jedem gelisteten Benchmark:
| Benchmark | Kimi K3 | Claude Opus 4.8 |
|---|---|---|
| Terminal-Bench 2.1 | 88.3 | 84.6 |
| DeepSWE | 67.5 | 59.0 |
| BrowseComp | 91.2 | 84.3 |
| Automation Bench | 30.8 | 27.2 |
| SpreadsheetBench 2 | 34.8 | 31.6 |
Dies sind vom Anbieter durchgeführte Zahlen, kein unabhängiger Direktvergleich: Ein Labor veröffentlicht die Suiten, in denen es gut aussieht. Aber es sind Moonshots tatsächlich veröffentlichte Zahlen, und sie zeigen K3 in allen Bereichen vor Opus 4.8, einschließlich DeepSWE, der schwierigsten Metrik für agentengestütztes Coding in diesem Satz. Für eine mit Quellen versehene Ansicht siehe die Aufschlüsselung der Kimi K3 Benchmarks, und für das führende Referenzmodell, das K3 tatsächlich übertrifft, Kimi K3 vs. GPT-5.6 Sol. Das ehrliche Fazit: Nach den uns vorliegenden Zahlen ist K3 mindestens gleichauf mit Opus 4.8 und in Moonshots eigener Suite überlegen. Die wirklichen Vorteile von Opus 4.8 sind nicht Benchmark-Scores; es sind die Ausgereiftheit der Tools von Anthropic, die Zuverlässigkeitshistorie und die Sicherheiten des verwalteten Anbieters.
Preis: Die größte Kluft
Kosten sind der Punkt, an dem die beiden am weitesten auseinanderliegen, und die Zahlen sind veröffentlicht. Kimi K3 berechnet 0,30 $ pro Million Tokens für Eingaben mit Cache-Treffer, 3,00 $ für Eingaben mit Cache-Fehltreffer und 15,00 $ für Ausgaben. Claude Opus 4.8 berechnet 5,00 $ für Eingaben und 25,00 $ für Ausgaben. K3 ist also bei zwischengespeicherten Eingaben dramatisch günstiger (0,30 $ vs. 5,00 $), immer noch weniger als die Hälfte des Preises bei einem Cache-Fehltreffer (3,00 $ vs. 5,00 $) und 40 % günstiger bei Ausgaben (15,00 $ vs. 25,00 $).
Für eine Arbeitslast, die stark auf wiederholten Kontext setzt, wie ein Chatbot, der denselben System-Prompt und Dokumente erneut sendet, führt die Cache-Hit-Preisgestaltung von K3 zu großen Einsparungen, und bei der Generierung mit hohem Volumen kann allein die Ausgabedifferenz eine monatliche Rechnung erheblich beeinflussen. Um Ihren eigenen Traffic zu modellieren, führt der Kimi K3 Preisleitfaden durch die Stufen, und der Beitrag zu den Claude Opus 4.8 Preisen tut dasselbe auf Seiten von Anthropic.
Eine Vorsichtsmaßnahme: Günstiger pro Token ist nicht immer günstiger pro Aufgabe. Ein wortreiches Modell kann einen Teil seines Pro-Token-Vorteils durch die Generierung von mehr Tokens zunichtemachen, und Artificial Analysis kennzeichnet K3 als wortreich. Messen Sie daher die Gesamtkosten anhand realer Prompts, nicht der Preisliste.
Kontextfenster: Raum zum Arbeiten
Das Kontextfenster ist auf dem Papier ein klarer K3-Sieg. Kimi K3 bietet ein Fenster von 1.048.576 Tokens, genug, um sehr große Codebasen, umfangreiche Dokumentensätze oder erweiterte Multi-Turn-Historien in einer einzigen Anfrage ohne aggressives Chunks aufzunehmen. Claude Opus 4.8 bietet ebenfalls ein großes Fenster, liegt aber unter der 1M-Grenze von K3.
Wenn Ihre Arbeitslast wirklich langkontextbezogen ist (ein gesamtes Repository, ein buchgroßer Vertragssatz, ein langer Forschungsbestand in einem einzigen Prompt), bietet K3 mehr Spielraum, bevor Sie Retrieval-Mechanismen aufbauen müssen. Ein größeres Fenster ist jedoch eine Fähigkeit, keine Garantie für Qualität über die gesamte Spanne hinweg. Vergewissern Sie sich also, dass die Antworten tief in einem Millionen-Token-Prompt genau bleiben, bevor Sie sich darauf verlassen.
Offenheit: Offene Gewichte versus geschlossene
Offenheit ändert, was Sie mit dem Modell tun dürfen, und keine Menge an Preisen oder Benchmarking ersetzt dies. Die Gewichte von Kimi K3 werden voraussichtlich um den 27. Juli 2026 freigegeben und eröffnen Optionen, die ein geschlossenes Modell nicht bietet: Self-Hosting für Datenresidenz oder luftdichte Umgebungen, Feinabstimmung mit eigenen Daten und Freiheit von den Ratenbegrenzungen oder der Roadmap eines einzelnen Anbieters. Für regulierte Branchen kann „die Gewichte laufen auf unserer Hardware“ der entscheidende Faktor sein, unabhängig von Benchmark-Scores.
Claude Opus 4.8 ist geschlossen. Sie greifen über die API von Anthropic darauf zu und erhalten einen Managed Service: konsistentes Hosting, eine Support-Beziehung, veröffentlichte Richtlinien und keine Infrastruktur zum Betreiben. Die API-Dokumentation von Anthropic behandelt die Modellfamilie. K3 gibt Ihnen Kontrolle und Verantwortung; Opus gibt Ihnen Komfort und einen Anbieter, auf den Sie sich verlassen können.
Geschwindigkeit und Latenz
Geschwindigkeit ist nuancierter als eine einzelne Zahl. Artificial Analysis misst K3 mit etwa 62 Ausgabetokens pro Sekunde, was unter dem Median von ~73 für seine Preisklasse liegt, obwohl die Zeit bis zum ersten Token mit ~1,99 Sekunden schnell ist. K3 fühlt sich also am Anfang einer Antwort reaktionsschnell an, generiert den Hauptteil jedoch langsam, und eine wortreiche Ausgabe lässt lange Vervollständigungen noch langsamer erscheinen. Wir haben keine entsprechenden unabhängigen Zahlen für Opus 4.8, daher sollten Sie beide mit Ihren eigenen Prompts benchmarken, wenn der Durchsatz bei langen Ausgaben wichtig ist.
Entscheidungsmatrix nach Arbeitslast
Anstatt einen Gewinner zu küren, passen Sie das Modell an die Aufgabe an.
| Arbeitslast | Bessere Passung | Warum |
|---|---|---|
| Sehr langkontextuelle Aufgaben (ganze Repos, große Dokumentensätze) | Kimi K3 | 1M-Token-Fenster reduziert Chunking- und Retrieval-Arbeit |
| Hohes Volumen, kostensensible Generierung | Kimi K3 | Niedrigere Eingabe- und Ausgaberaten, starke Cache-Hit-Preisgestaltung |
| Self-Hosting, Datenresidenz oder Feinabstimmung | Kimi K3 | Offene Gewichte um den 27. Juli 2026 |
| Höchste Qualität bei Schlussfolgerungen und Agentenfähigkeiten | Beide testen | Umstritten: Moonshots eigene Launch-Benchmarks zeigen K3 vor Opus 4.8, aber diese sind vom Anbieter durchgeführt, und Opus hat eine längere Produktionshistorie bei komplexen Agenten |
| Missionkritische Zuverlässigkeit und Support | Claude Opus 4.8 | Verwalteter kommerzieller Dienst mit SLAs, Support und veröffentlichten Richtlinien |
| Latenzempfindliche interaktive Apps | Beide testen | K3 hat eine schnelle Time-to-First-Token, aber langsamere, wortreichere Generierung |
| Budgetbeschränkte Prototypen und Nebenprojekte | Kimi K3 | Günstigster Weg zu nahezu Spitzenqualität |
K3 beherrscht Wirtschaftlichkeit, Kontext und Kontrolle, und nach Moonshots eigenen Benchmarks übertrifft oder erreicht es Opus 4.8 auch in puncto Qualität. Was Opus 4.8 besitzt, ist der Komfort eines verwalteten Anbieters. Die meisten Teams werden feststellen, dass einige Arbeitslasten in die eine, andere in die andere Richtung tendieren, also halten Sie beide bereit, anstatt sich auf eines zu standardisieren.
Anwendungsfälle aus der Praxis
Ein Startup, das ein Dokumentenanalyseprodukt entwickelt. Lange Verträge, hohes Abfragevolumen, knappe Margen. Das 1M-Kontextfenster und die niedrigen Preise von K3 passen nahezu perfekt, und offene Gewichte bieten einen Self-Hosting-Pfad, falls Datenresidenz später zu einer Anforderung wird.
Ein Unternehmen, das mehrstufige Agenten-Workflows automatisiert. Zuverlässigkeit ist wichtig und Fehler sind teuer. Moonshots Benchmarks zeigen K3 vorne, aber Opus 4.8s längere Produktionshistorie ist das, wofür einige Teams einen Aufpreis zahlen, bis diese Zahlen reproduziert werden.
Eine regulierte Bank, die keine Daten an APIs von Drittanbietern senden kann. Die Benchmark-Debatte ist hier irrelevant: K3s offene Gewichte laufen innerhalb der eigenen Umgebung der Bank, während Opus 4.8 als geschlossener API-Dienst möglicherweise gänzlich ausgeschlossen ist.Beide mit derselben Anfrage in Apidog testen
Papiervergleiche bringen Sie nur bedingt weiter. Da Kimi K3 mit dem OpenAI SDK kompatibel ist und Claude Opus 4.8 über seine eigene API erreichbar ist, können Sie beide als Anfragen in Apidog einrichten und dieselbe Payload an jedes senden.
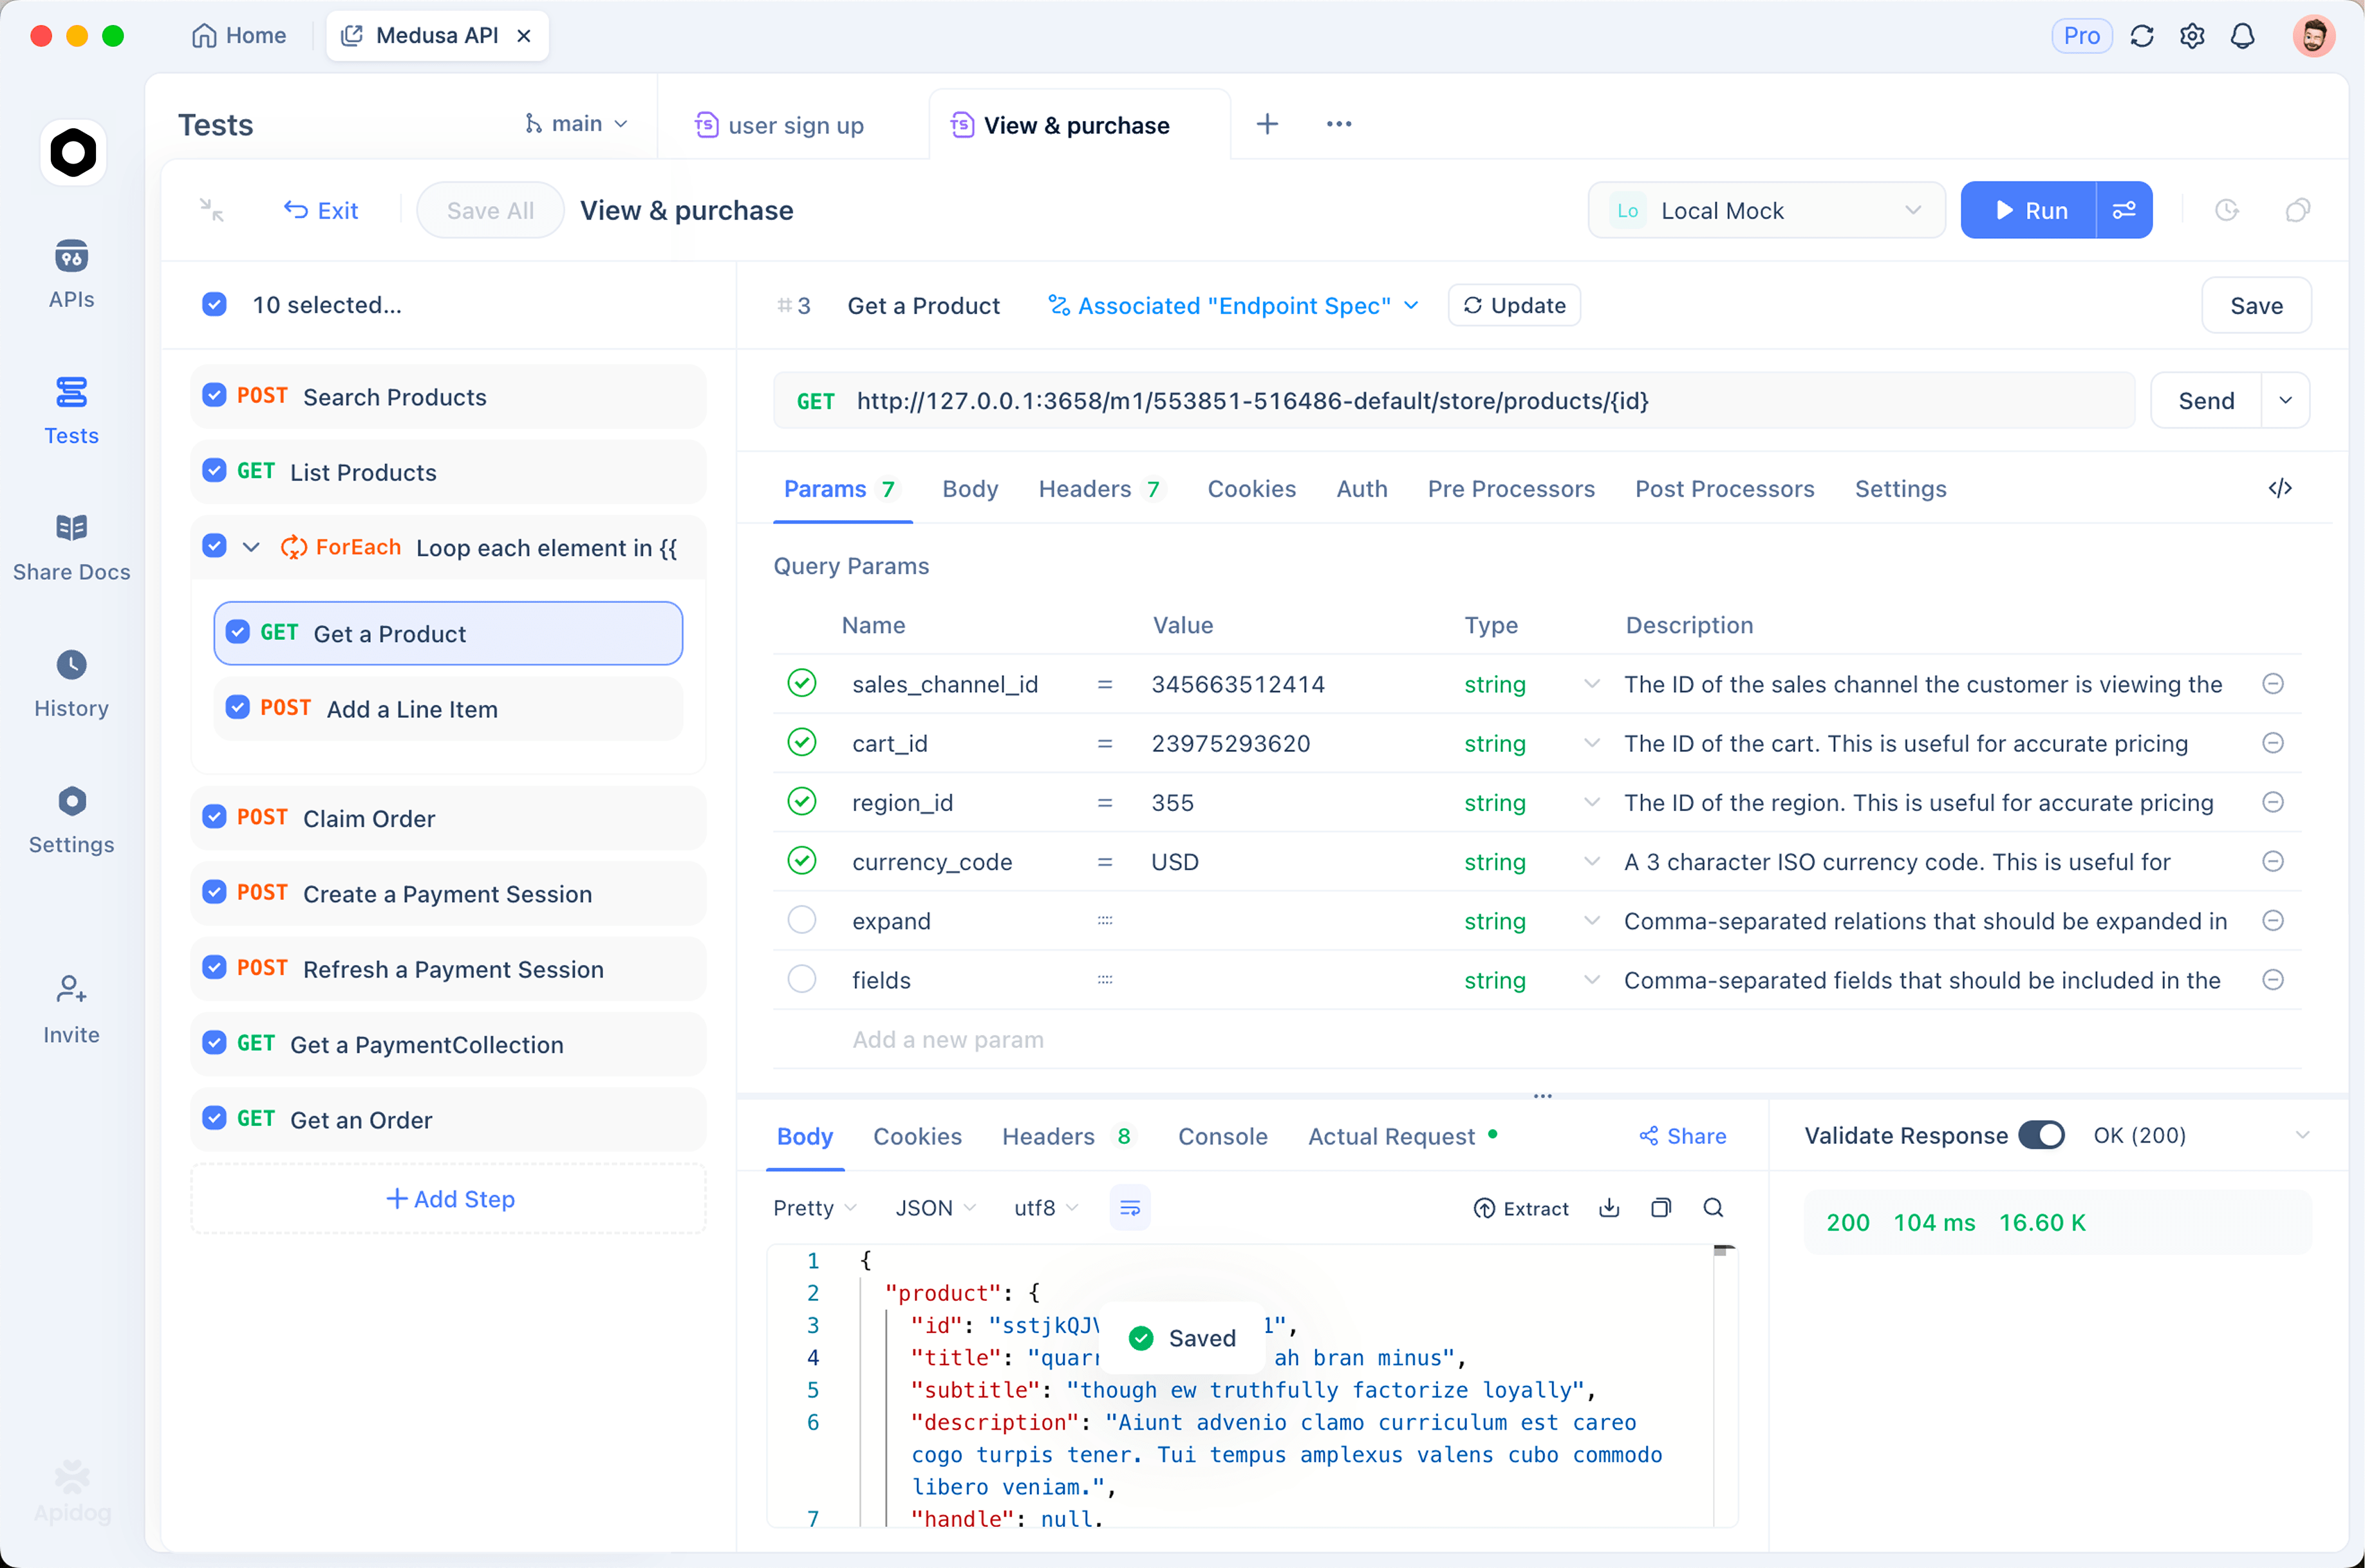
Erstellen Sie eine Anfrage für den K3-Endpunkt und eine für Opus, speichern Sie Ihre Schlüssel und Basis-URLs als Umgebungsvariablen und senden Sie dann denselben Prompt an beide. Apidog zeigt den Antwortkörper, den Status und die Zeit für jeden Aufruf an, sodass Sie die Antwortqualität, Latenz und Token-Kosten bei identischen Eingaben vergleichen können. Das Speichern als Sammlung bietet Ihnen einen wiederholbaren Testrahmen, den Sie bei jeder Modellaktualisierung erneut ausführen können. Sie können diese Überprüfungen mit Apidog in VS Code durchführen, und der Ansatz dient auch als API-Test ohne Postman. Laden Sie Apidog herunter, um es selbst einzurichten. Das Ziel: „Welches Modell ist im Allgemeinen besser?“ durch „Welches ist besser für diesen Prompt, zu diesen Kosten, bei dieser Latenz?“ ersetzen.
Das Fazit
Kimi K3 schlägt Claude Opus 4.8 bei Preis, Kontextfenster und Offenheit deutlich, und auf Moonshots eigenen Launch-Benchmarks übertrifft es Opus 4.8 auch bei der Qualität, obwohl diese Zahlen vom Anbieter stammen und noch nicht unabhängig reproduziert wurden. Was Opus 4.8 behält, ist die Sicherungsseite: ein verwalteter Anbieter, veröffentlichte Richtlinien und eine bewährte Erfolgsbilanz bei anspruchsvollen Agentenaufgaben. Wenn Ihre Arbeitslast langkontextuell, kostensensibel ist oder Self-Hosting erfordert, ist K3 die pragmatische Wahl; wenn Sie eine kommerzielle Beziehung und eine bewährte Erfolgsbilanz wünschen, verdient Opus 4.8 seinen Aufpreis. Da noch kein unabhängiger direkter Vergleich existiert, testen Sie beide mit Ihren eigenen Prompts, bevor Sie sich festlegen.
Häufig gestellte Fragen
Ist Kimi K3 besser als Claude Opus 4.8? Es ist knapp, und nach den uns vorliegenden Zahlen sieht K3 mindestens ebenbürtig aus. Es gewinnt bei Preis, Kontext und Offenheit, und auf Moonshots eigenen Launch-Benchmarks übertrifft es Opus 4.8 bei jeder aufgeführten Aufgabe, obwohl diese Zahlen vom Anbieter stammen und noch nicht unabhängig reproduziert wurden. Moonshot sagt, K3 hinke den Top-Proprietärmodellen hinterher, nennt aber Fable 5 und GPT-5.6 Sol, nicht Opus 4.8, so dass der eigentliche Vorteil von Opus 4.8 seine Erfolgsbilanz und der verwaltete Support ist, nicht ein Benchmark-Vorsprung.
Wie viel günstiger ist Kimi K3? K3 listet $0.30 pro Million Tokens für Cache-Treffer-Eingaben, $3.00 für Cache-Fehltreffer-Eingaben und $15.00 für Ausgaben. Opus 4.8 listet $5.00 für Eingaben und $25.00 für Ausgaben. K3 ist also bei zwischengespeicherten Eingaben weitaus günstiger, unter dem halben Preis bei einem Cache-Fehltreffer und etwa 40 % günstiger bei Ausgaben. Die tatsächlichen Einsparungen hängen davon ab, wie viel Ihrer Eingaben zwischenspeicherbar sind.
Gibt es einen unabhängigen Benchmark, der Kimi K3 und Opus 4.8 direkt vergleicht? Noch nicht. Artificial Analysis liefert unabhängige Intelligence Index-Scores für einzelne Modelle, und Moonshot veröffentlicht eigene Benchmark-Zahlen, aber es gibt keine gemeinsame, direkte Vergleichstabelle für K3-versus-Opus-4.8. Behandeln Sie vom Anbieter gemeldete Siege, einschließlich der Zahl „erster in vier von acht Automatisierungs-Benchmarks“, als Selbstaussage, bis sie unabhängig reproduziert wurden.
Ist Kimi K3 ein Konkurrent für Opus 4.8 oder für Claude Fable 5? K3 konkurriert auf dem gesamten Feld. Die Berichterstattung über den Start stellte es gegen Opus 4.8, da dies die Stufe ist, die ein offener Herausforderer plausibel erreichen kann. Anthropic’s aktuelle Spitze ist Claude Fable 5, wobei Moonshot einräumt, dass K3 immer noch hinterherhinkt, daher ist K3 am besten als Aufholen im proprietären Feld zu verstehen, anstatt es anzuführen.