
Die Preisgestaltung von Kimi K3.1 Pro für die API beträgt $2.00 pro 1 Mio. Eingabe-Tokens und $10.00 pro 1 Mio. Ausgabe-Tokens, wobei Cache-Treffer $0.20 pro 1 Mio. kosten. Kimi K3.1 Pro Highspeed kostet genau doppelt so viel: $4.00 für Eingabe und $20.00 für Ausgabe. Es gibt kein Abonnement und keinen Langkontext-Zuschlag über das Fenster von 1.048.576 Tokens, aber das Modell wird erst nach einer Aufladung von $1 freigeschaltet.
Im Folgenden: Cache-Berechnung, durchgerechnete Beispiele, Rate-Stufen, Verbraucherpläne und ein Listenpreisvergleich. Die Zahlen stammen von Moonshot AI: API-Preisseite, Leitfaden zum Kontext-Caching, Seite zu Rate Limits und Mitgliedschaftspreise, abgerufen am 24. Oktober 2026. Neu beim Modell? Beginnen Sie mit was Kimi K3.1 Pro ist.
Kimi K3.1 Pro API-Preistabelle
Der API-Preis von Kimi K3.1 Pro ist Pay-as-you-go, pro 1 Mio. Tokens, ohne Steuern. Jedes Modell hat fünf Tarife: Eingabe, Ausgabe, Cache-Treffer und einen Cache-Schreibtarif für jede der beiden Cache-Lebensdauern (5 Minuten und 1 Stunde).
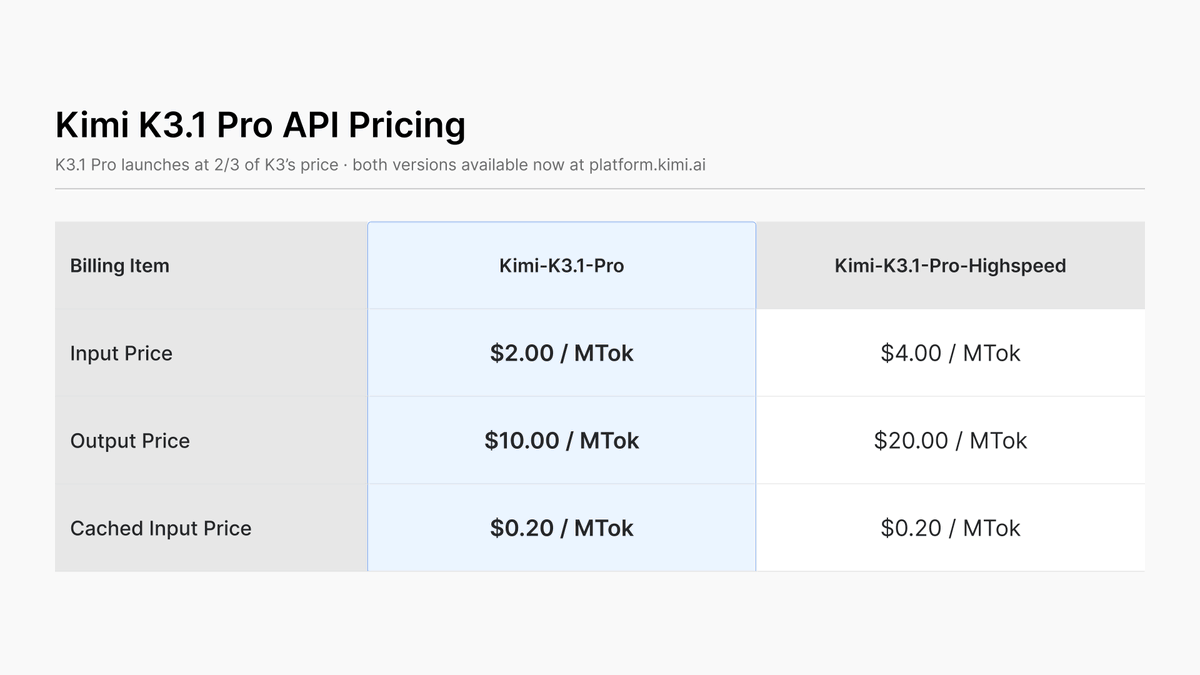
K3.1 Pro kostet ein Drittel weniger als K3 (siehe unseren Kimi K3 API-Leitfaden).
Wie die Cache-Preisgestaltung von Kimi K3.1 Pro funktioniert
Die Cache-Preisgestaltung von Kimi K3.1 Pro besteht aus zwei Teilen. Wenn ein Präfix zum ersten Mal verarbeitet wird, wird es als Cache-Schreibvorgang abgerechnet. Spätere Anfragen, die genau dasselbe Präfix innerhalb der Cache-Lebensdauer wiederverwenden, werden als Cache-Treffer mit $0.20 pro 1 Mio. abgerechnet, einem Zehntel des Eingabepreises.
Was Ihre Rechnung bestimmt:
- Caching ist automatisch, mit einer Standard-TTL von 5 Minuten.
- Ein 5-Minuten-Schreibvorgang kostet dasselbe wie Eingabe ($2.00). Moonshot sagt: „Die Schreibkosten waren bereits im Eingabepreis enthalten.“
- Ein 1-Stunden-Schreibvorgang kostet doppelt so viel: $4.00 pro 1 Mio.
- Jeder Treffer erneuert die TTL, die beim ersten Schreibvorgang festgelegt wird. Der Cache wird nur innerhalb Ihrer Organisation geteilt.
Legen Sie die 1-Stunden-TTL in Chat Completions oder der Responses API fest:
"prompt_cache_options": {"mode": "implicit", "ttl": "1h"}
Verwenden Sie in der Anthropic-kompatiblen Messages API ein "cache_control": {"type": "ephemeral", "ttl": "1h"} auf oberster Ebene.
5 Min. vs. 1 Std.: der Break-even-Punkt
Nehmen Sie ein Präfix mit 1 Mio. Tokens. Der 1-Stunden-Schreibvorgang kostet $2.00 mehr ($4.00 vs. $2.00). Jeder Treffer spart dann $1.80 gegenüber vollständiger Eingabe ($2.00 minus $0.20). Zwei Treffer sparen $3.60, was die zusätzlichen $2.00 deckt.
Die Regel: Wenn Anfragen mehr als 5 Minuten auseinanderliegen können und Sie das Präfix mindestens zweimal in der Stunde wiederverwenden, wählen Sie 1 Std. Wenn Anfragen alle paar Minuten eintreffen, erneuert sich der kostenlose 5-Minuten-Cache immer wieder selbst.
Durchgerechnete Preisbeispiele für Kimi K3.1 Pro
Beide verwenden Listenpreise; setzen Sie Ihre eigenen Token-Zahlen ein.
Beispiel 1: Ein Codebasis-Prompt mit 200K Tokens, 20-mal in einer Stunde wiederverwendet
Sie laden einen Repo-Snapshot mit 200K Tokens (0,2 Mio. Tokens) und stellen über eine Stunde verteilt 20 Fragen, einige mehr als 5 Minuten auseinander. Nur die Eingabeseite:
| Einrichtung | Berechnung | Eingabekosten |
|---|---|---|
| Keine Treffer (5-Min.-Cache läuft immer wieder ab) | 20 × 0,2 Mio. × $2.00 | $8.00 |
| 1-Std.-Cache | Schreiben 0,2 Mio. × $4.00 = $0.80, plus 19 Treffer × 0,2 Mio. × $0.20 = $0.76 | $1.56 |
| 5-Min.-Cache, alle 3 Minuten eine Frage | Schreiben 0,2 Mio. × $2.00 = $0.40, plus $0.76 | $1.16 |
Der 1-Stunden-Cache senkt die Eingabekosten von $8.00 auf $1.56 und spart $6.44 (etwa 80 %). Bei 2.000 Ausgabe-Tokens pro Antwort addieren Sie 40.000 × $10.00 pro 1 Mio. = $0.40 zu jeder Zeile.
Beispiel 2: Eine Chat-App mit 1.000 Anfragen pro Tag
Jede Anfrage sendet 2.000 Eingabe-Tokens und erhält 500 Ausgabe-Tokens, mit reasoning_effort auf "low":
- Eingabe: 1.000 × 2.000 = 2 Mio. × $2.00 = $4.00 pro Tag
- Ausgabe: 1.000 × 500 = 0,5 Mio. × $10.00 = $5.00 pro Tag
- Gesamt: $9.00 pro Tag, etwa $270 pro Monat oder $0.009 pro Anfrage
Machen Sie nun 1.500 dieser Eingabe-Tokens zu einem festen System-Prompt. Eine Anfrage alle 86 Sekunden im Durchschnitt liegt gut innerhalb der 5-Minuten-TTL, sodass fast jede Anfrage einen Treffer erzielt:
- Gecacht: 1,5 Mio. × $0.20 = $0.30; nicht gecacht: 0,5 Mio. × $2.00 = $1.00
- Neue Gesamtsumme: $1.30 + $5.00 = $6.30 pro Tag, etwa $189 pro Monat
Ein Haken: 1.000 × 2.500 = 2,5 Mio. Tokens pro Tag überschreitet die Tagesobergrenze von Tier0 von 1,5 Mio., Sie bräuchten also Tier1.
Preisgestaltung von Kimi K3.1 Pro Highspeed
Die Preisgestaltung von Kimi K3.1 Pro Highspeed ist ein pauschaler 2x-Aufschlag auf Eingabe, Ausgabe und Cache-Schreibvorgänge, für das, was Moonshot „2-3x die Geschwindigkeit von K3.1 Pro“ nennt. Cache-Treffer bleiben bei $0.20.
| Beispiel 2, ohne Cache | Eingabe | Ausgabe | Tagessumme |
|---|---|---|---|
| K3.1 Pro | 2 Mio. × $2 = $4.00 | 0,5 Mio. × $10 = $5.00 | $9.00 |
| K3.1 Pro Highspeed | 2 Mio. × $4 = $8.00 | 0,5 Mio. × $20 = $10.00 | $18.00 |
Reasoning-Aufwand, Batch- und Websuche-Kosten
Drei Details, die die Tabelle nicht zeigt:
- Reasoning-Tokens zählen zu Ihrer Nutzung. K3.1 Pro denkt immer;
reasoning_effortakzeptiert"low","high"oder"max"(Standard"max"), und eine Verringerung senkt den Token-Verbrauch. Moonshot gibt nicht wörtlich an, dass Reasoning zum Ausgabetarif abgerechnet wird [VERIFY]; wenn doch, fügen 500 zusätzliche Reasoning-Tokens pro Anfrage Beispiel 2 $5.00 pro Tag hinzu. - Kein Batch-Rabatt für K3.1 Pro. Die Batch API rechnet mit 60 % des Standardpreises ab, unterstützt aber nur
kimi-k2.7-codeundkimi-k2.6. - Websuche wird pro Aufruf abgerechnet.
/v1/tools/searchund/v1/tools/fetchkosten je $0.002,/v1/tools/search_pro$0.003, berechnet nur bei HTTP 200 mit nicht leeren Ergebnissen: $2.00 pro 1.000 einfache Suchen. Das Legacy-$web_searchkostet $0.005 plus Ergebnis-Tokens und wird derzeit nicht empfohlen (Websuche-Preise).
Anfragen, die durch einen 429 unterbrochen werden, werden nicht berechnet.
Die $1-Freischaltung und API-Rate-Stufen
K3.1 Pro „wird nach einer erfolgreichen Aufladung freigeschaltet (Minimum $1).“ Diese $1 kaufen etwa 500K Eingabe- oder 100K Ausgabe-Tokens oder etwa 111 Anfragen aus Beispiel 2 ($1 ÷ $0.009). Die kumulative Aufladung bestimmt Ihre Stufe:
| Stufe | Kumulative Aufladung | Parallelität | RPM | TPM | TPD |
|---|---|---|---|---|---|
| Tier0 | $1 | 1 | 3 | 500,000 | 1,500,000 |
| Tier1 | $10 | 15 | 100 | 2,000,000 | Unbegrenzt |
| Tier2 | $20 | 40 | 100 | 3,000,000 | Unbegrenzt |
| Tier3 | $100 | 50 | 200 | 3,000,000 | Unbegrenzt |
| Tier4 | $1,000 | 60 | 200 | 4,000,000 | Unbegrenzt |
| Tier5 | $3,000 | 100 | 300 | 5,000,000 | Unbegrenzt |
Bei $5 kumulativ erhalten Sie einen $5-Gutschein, der nicht auf Ihre Stufe angerechnet wird; ob Gutscheine für K3.1 Pro bezahlen, wird nicht angegeben [VERIFY]. Für $0-Optionen siehe wie Sie Kimi K3.1 Pro kostenlos nutzen.
Kimi-Mitgliedschaftspläne
Kimi-Mitgliedschaftspläne decken die Kimi-Apps und Kimi Code ab, nicht die API. Monatliche Preise:
| Plan | Jährliche Abrechnung | Monatliche Abrechnung | Jährliche Ersparnis | Hinweise |
|---|---|---|---|---|
| Adagio | $0 | $0 | k. A. | K3.1 Pro Chat, kein Kimi Code |
| Plus | $15 | $19 | $48 | Kimi Code mit k3.1-pro |
| Pro | $31 | $39 | $96 | Fügt Highspeed hinzu, 1M Kontext in Kimi Code |
| Max | $79 | $99 | $240 | Bis zu 1M Kontext im Chat |
| Ultra | $159 | $199 | $480 | Bis zu 1M Kontext im Chat |
Ersparnis = (monatlich minus jährlich) × 12; für Ultra: $40 × 12 = $480. API-, Kimi Code- und Mitgliedschaftsguthaben und -schlüssel sind nicht austauschbar: Eine Mitgliedschaft lässt sich nicht in API-Guthaben umwandeln, und mit API-Guthaben kann keine Mitgliedschaft gekauft werden.
Preis von Kimi K3.1 Pro vs. Claude Opus 5.5
Kimi K3.1 Pro wird bei Eingabe und Ausgabe zum halben Preis von Claude Opus 5.5 gelistet und entspricht Claude Sonnet 5.5 und GPT-6.1 Sol bis zu 272K Eingabe-Tokens. Listenpreise pro 1 Mio. Tokens, von Claude-Preise und OpenAI-Preise:
| Modell | Eingabe | Ausgabe | Cache-Lesen | Beispiel 2 pro Tag |
|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $9.00 |
| Claude Opus 5.5 | $4.00 | $20.00 | $0.20 | $18.00 |
| Claude Sonnet 5.5 | $2.00 | $10.00 | $0.10 | $9.00 |
| GPT-6.1 Sol (bis zu 272K) | $2.00 | $10.00 | $0.10 | $9.00 |
| GPT-6 Astra (bis zu 272K) | $10.00 | $50.00 | $1.00 | $45.00 |
Über 272K Eingabe-Tokens listet OpenAI GPT-6.1 Sol mit $4 / $15 und GPT-6 Astra mit $20 / $75; K3.1 Pro bleibt konstant. Für einen Prompt mit 500K Tokens und 5.000 Ausgabe-Tokens:
- K3.1 Pro: 0,5 Mio. × $2 + 0,005 Mio. × $10 = $1.00 + $0.05 = $1.05
- GPT-6.1 Sol: 0,5 Mio. × $4 + 0,005 Mio. × $15 = $2.00 + $0.075 = $2.075 (wenn die höhere Stufe die gesamte Anfrage abdeckt [VERIFY])
Der Listenpreis ist nicht gleich Kosten pro Aufgabe: Tokenizer und Reasoning-Längen unterscheiden sich. Moonshots eigene Benchmarks vergleichen K3.1 Pro mit Opus 5.5 und GPT-6 Astra. Siehe unseren Überblick zu Claude Opus 5.5.
Bestätigen, dass Caching mit Apidog CLI funktioniert
Caching spart nur Geld, wenn es Treffer gibt. Bevor Sie skalieren, lassen Sie Ihren Coding-Agenten es testen. Apidog CLI stellt Claude Code, Codex, Cursor oder OpenCode die Befehle bereit, und der kostenlose Plan von Apidog deckt bis zu 4 Benutzer ab.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
apidog skill install
Geben Sie Ihrem Agenten dann einen Prompt:
In Apidog project <projectId>, create an environment for https://api.moonshot.ai/v1.
Build a test case for POST /chat/completions with model "kimi-k3.1-pro",
reasoning_effort "low", a long fixed system prompt and a short user message.
Send MOONSHOT_API_KEY as a Bearer token. Assert status 200 and log
usage.prompt_tokens_details.cached_tokens. Validate the payload, run it
3 times and tell me whether cached_tokens rises after the first run.
Der Agent führt aus:
apidog environment create kimi-prod --project <projectId> --base-url https://api.moonshot.ai/v1
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -n 3 -r cli,json
Die erste Iteration schreibt den Cache; die nächsten beiden sollten cached_tokens über null melden. Moonshot gibt auf den von uns gelesenen Seiten keine Mindestlänge für cachefähige Präfixe an [VERIFY], halten Sie den System-Prompt also lang. Testfälle benötigen eine gültige Kategorie-ID (apidog test-case category --project <projectId> listet sie auf). Mehr dazu in der Referenz zum run-Befehl und Apidog CLI in Claude Code.
5 Kostensparregeln für Kimi K3.1 Pro
- Stellen Sie stabilen Inhalt an den Anfang: System-Prompt, Tool-Definitionen und Referenzdokumente. Keine Zeitstempel oder zufälligen IDs im Präfix.
- Wählen Sie die TTL nach der Lücke. Lücken über 5 Minuten und zwei oder mehr Wiederverwendungen pro Stunde: 1 Std. verwenden.
- Legen Sie
reasoning_effortje Aufgabe fest. Verwenden Sie"low"für einfache Aufrufe. - Verwenden Sie Highspeed nur, wo Geschwindigkeit es rechtfertigt. Es verdoppelt jeden Tarif außer Cache-Treffer.
- Protokollieren Sie die Cache-Felder:
cached_tokensundcache_write_tokens, mitstream_options.include_usage=truebeim Streaming.
Zur Einrichtung von Anfragen lesen Sie unseren Kimi K3.1 Pro API-Leitfaden und wie Sie Kimi K3.1 Pro verwenden.
Häufig gestellte Fragen
Wie viel kostet Kimi K3.1 Pro pro 1 Mio. Tokens?
$2.00 Eingabe, $10.00 Ausgabe und $0.20 für Cache-Treffer. Cache-Schreibvorgänge kosten $2.00 (5 Minuten) oder $4.00 (1 Stunde).
Erhält Kimi K3.1 Pro den Batch-API-Rabatt?
Nein. Die Batch-Preisgestaltung deckt nur kimi-k2.7-code und kimi-k2.6 ab.
Kann ich meine Kimi-Mitgliedschaft für API-Aufrufe verwenden?
Nein. Kimi API, Kimi Code und Mitgliedschaft sind separate Produkte mit separaten Guthaben und Schlüsseln.
Was ist das Minimum, um zu starten?
Eine Aufladung von $1. Sie schaltet das Modell frei und stuft Sie in Tier0 ein: 3 Anfragen pro Minute und 1,5 Mio. Tokens pro Tag.