
Moonshots Kimi K2.7 Code wurde mit Benchmarks gegen die zwei Modelle veröffentlicht, für die die meisten Entwickler tatsächlich bezahlen: Claude Opus und GPT-5.5. Kurz gesagt, die geschlossenen Spitzenmodelle erzielen bei den meisten Kodierungsaufgaben immer noch höhere Punktzahlen, aber nicht mit dem Vorsprung, den ihr Preis vermuten lässt. Kimi ist ein Open-Weight-Modell, das Sie herunterladen und selbst hosten können, und es liegt nur wenige Punkte hinter Modellen, die Sie nur mieten können.
Dieser Vergleich stellt die Zahlen nebeneinander, wägt sie gegen Kosten und Offenheit ab und sagt Ihnen, welches Modell Sie für welche Aufgabe wählen sollten.
TL;DR
- Rohe Kodierungsqualität: GPT-5.5 und Claude Opus führen bei den meisten Suiten. Kimi K2.7 Code liegt nur wenige Punkte dahinter.
- Kosten: Kimi ist wesentlich günstiger (0,95 $/4,00 $ pro Million Tokens) und kostenlos selbst zu hosten. Die geschlossenen Modelle kosten mehr und können nicht auf Ihrer eigenen Hardware gehostet werden.
- Offenheit: Kimi liefert offene Gewichte unter einer modifizierten MIT-Lizenz. Opus und GPT-5.5 sind geschlossen.
- Fazit: Wählen Sie das Spitzenmodell für die höchste Single-Shot-Qualität; wählen Sie Kimi, wenn Kosten, Volumen oder Datenkontrolle wichtiger sind als die letzten paar Punkte.
Die Kandidaten auf einen Blick
| Kimi K2.7 Code | Claude Opus | GPT-5.5 | |
|---|---|---|---|
| Typ | Offenes Gewicht (modifizierte MIT) | Geschlossen | Geschlossen |
| Architektur | MoE, 1T gesamt / 32B aktiv | Nicht offengelegt | Nicht offengelegt |
| Kontextfenster | 256K Tokens | Groß | Groß |
| Selbst-Host | Ja | Nein | Nein |
| Preisgestaltung (pro M Tokens) | 0,95 $ rein / 4,00 $ raus | Höher, nur Miete | Höher, nur Miete |
Der strukturelle Unterschied ist die Schlagzeile. Kimi sagt Ihnen genau, was es ist, und lässt Sie es selbst betreiben. Die anderen beiden sind Dienste, die Sie aufrufen.
Kodierungs-Benchmarks
Dies sind die von Moonshot gemeldeten Ergebnisse. Betrachten Sie sie als die Darstellung des Anbieters, da mehrere Suiten von Moonshot selbst stammen, aber das Muster ist konsistent und lesenswert.
| Benchmark | Kimi K2.7 Code | GPT-5.5 | Claude Opus |
|---|---|---|---|
| Kimi Code Bench v2 | 62.0 | 69.0 | 67.4 |
| Program Bench | 53.6 | 69.1 | 63.8 |
| MLS Bench Lite | 35.1 | 35.5 | 42.8 |
GPT-5.5 belegt bei den ersten beiden den Spitzenplatz; Claude Opus führt bei MLS Bench Lite und bleibt überall nah dran. Kimi liegt jeweils eine Stufe darunter. Der Unterschied ist real, aber klein bei Kimi Code Bench v2, und größer bei Program Bench. Wenn Ihre Arbeit diesem zweiten Benchmark ähnelt, zahlt sich das Spitzenmodell aus.
Agentische und Tool-Nutzungs-Benchmarks
Kodierungsagenten leben oder sterben durch Tool-Aufrufe, nicht nur durch Codegenerierung. Hier wird das Bild enger.
| Benchmark | Kimi K2.7 Code | GPT-5.5 | Claude Opus |
|---|---|---|---|
| Kimi Claw 24/7 | 46.9 | 52.8 | 50.4 |
| MCP Atlas | 76.0 | 79.4 | 81.3 |
| MCP Mark Verified | 81.1 | 92.9 | 76.4 |
Bei MCP Mark Verified übertrifft Kimi tatsächlich Claude Opus, obwohl GPT-5.5 weit vorausliegt. Bei MCP Atlas liegen alle drei innerhalb von etwa fünf Punkten. Für agentische Arbeitslasten ist Kimi näher am Feld als seine reinen Kodierungs-Scores vermuten lassen, was wichtig ist, da sich genau hier die Token-Kosten summieren.
Kosten sind Kimis Stärke
Benchmarks messen Qualität. Sie messen nicht die Rechnung. Kimi K2.7 Code kostet 0,95 $ pro Million Eingabe-Tokens und 4,00 $ pro Million Ausgabe-Tokens, mit Cache-Treffern bei 0,19 $ pro Million. Die geschlossenen Spitzenmodelle kosten pro Token deutlich mehr, und Sie können dem nicht entgehen, indem Sie sie hosten; es gibt keinen Download.
Zwei Faktoren verstärken die Einsparungen:
- Offene Gewichte bedeuten eine Null-Token-Option. Wenn Sie auf Ihrer eigenen Hardware selbst hosten, entfallen die Kosten pro Token vollständig. Sie tauschen sie gegen GPU-Zeit ein.
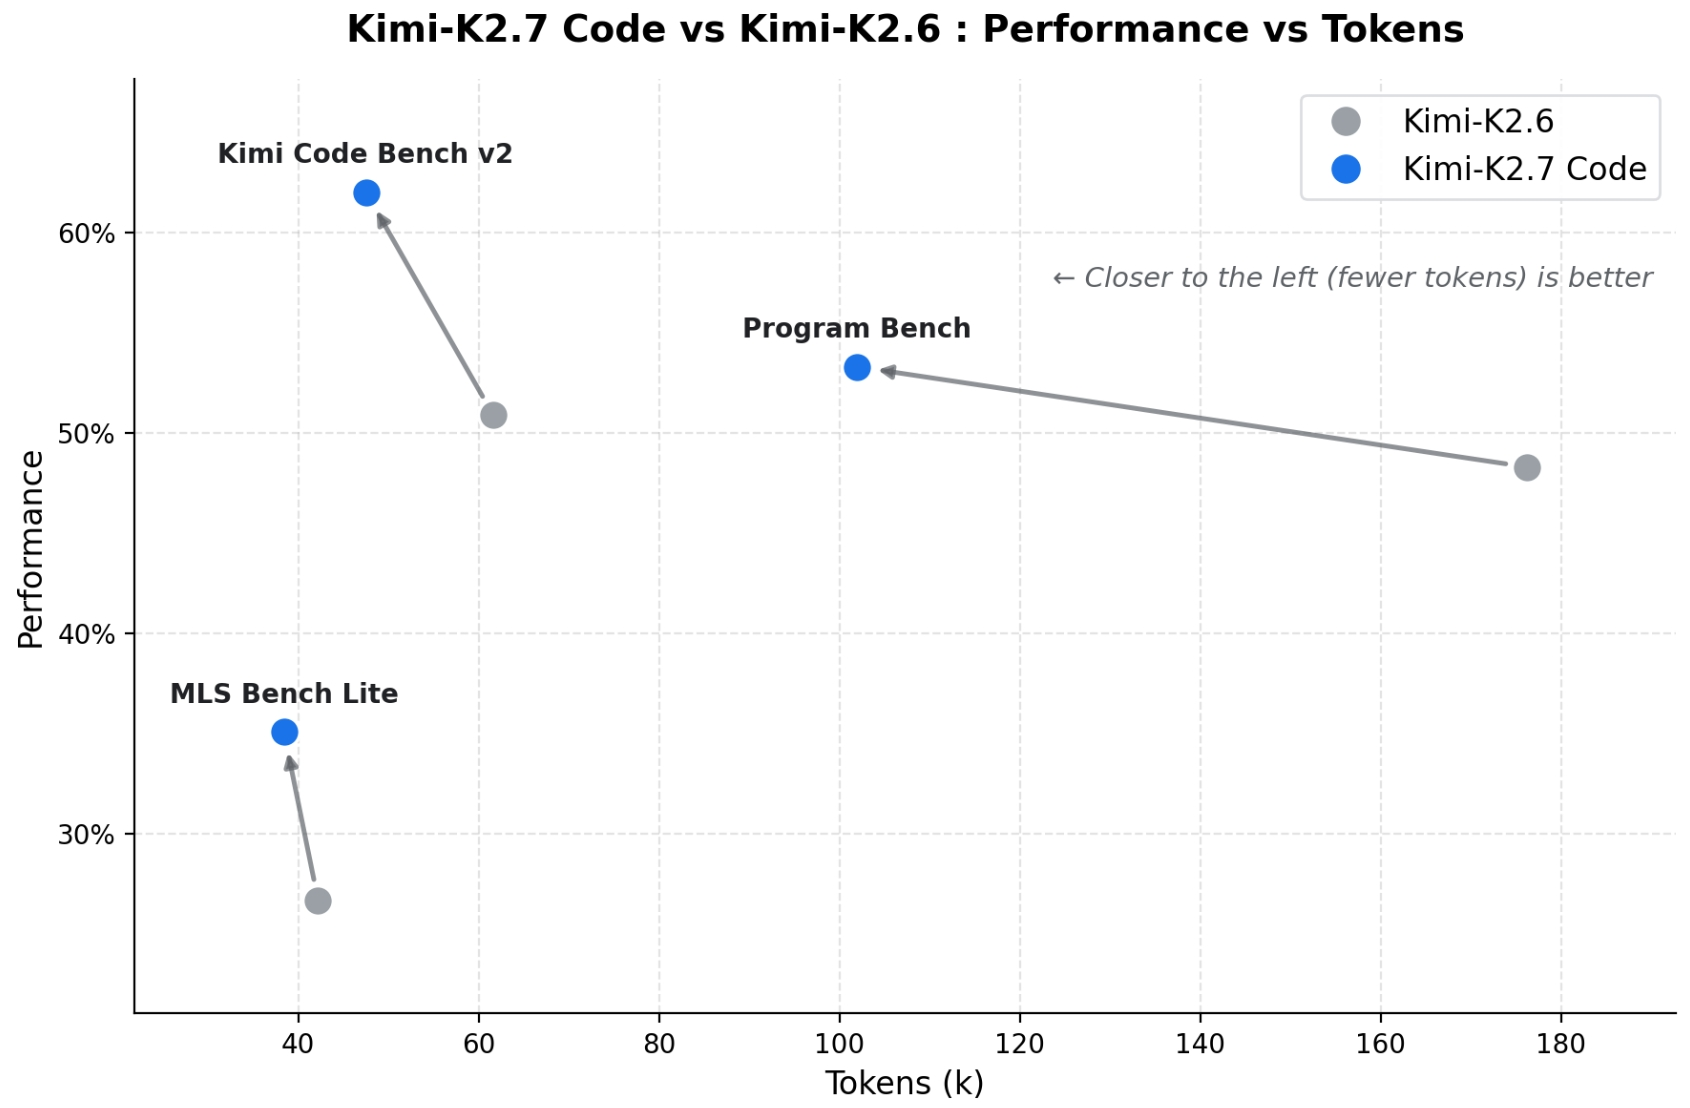
- Schlankere Argumentation. K2.7 Code verwendet etwa 30 % weniger Denk-Tokens als K2.6 für dieselbe Arbeit, sodass jeder Agentenschritt weniger kostet. Unser Leitfaden zum Reduzieren von Agenten-Token-Kosten geht näher darauf ein, warum sich das summiert.
Für einen Agenten, der Hunderte von Tool-Aufrufen pro Aufgabe durchführt, gewinnt ein Modell, das zu 90 % so gut ist wie das Spitzenmodell, aber nur einen Bruchteil des Preises kostet, oft in Bezug auf den Gesamtwert.
Kontext und Offenheit
Alle drei handhaben lange Kontexte gut; Kimis Fenster beträgt 256K Tokens, genug für einen vollständigen Dienst plus seine Tests in einer einzigen Eingabeaufforderung. Der größere Unterschied ist die Lizenz. Kimis modifizierte MIT-Gewichte ermöglichen es Ihnen, das Modell zu feinabstimmen, zu überprüfen und luftgesperrt (air-gapped) zu betreiben. Für Teams mit Compliance- oder Datenresidenzregeln ist das kein nettes Extra; es ist der entscheidende Faktor, und die geschlossenen Modelle sind einfach vom Tisch.
Wann man welches Modell wählen sollte
Wählen Sie GPT-5.5 oder Claude Opus, wenn:
- Sie die höchste Single-Shot-Kodierungsqualität benötigen und ein paar Benchmark-Punkte die Kosten rechtfertigen.
- Sie damit einverstanden sind, einen geschlossenen Dienst mit einem verwalteten SLA zu mieten.
- Ihre schwierigsten Aufgaben wie Program Bench aussehen, wo der Unterschied am größten ist.
Wählen Sie Kimi K2.7 Code, wenn:
- Sie Agenten-Arbeitslasten mit hohem Volumen ausführen, bei denen die Token-Kosten die Machbarkeit bestimmen.
- Daten auf Ihrer eigenen Infrastruktur bleiben müssen.
- Sie das Modell feinabstimmen oder überprüfen möchten.
- Sie den Gesamtwert optimieren und nicht die Spitze der Bestenliste anstreben.
Für ein breiteres Feld deckt unser Vergleich von MiniMax M3 vs DeepSeek V4 vs Qwen 3.7 die anderen Open-Weight-Herausforderer ab, und DeepSeek V4 vs Claude Opus für die Kodierung beleuchtet ein weiteres Open-vs-Closed-Duell. Wenn Sie die Agenten statt der Modelle vergleichen, siehe Claude Code vs OpenAI Codex.
Testen Sie den Vergleich selbst
Benchmarks sind ein Ausgangspunkt, kein Urteil für Ihre Codebasis. Der ehrlichste Test besteht darin, alle drei mit Ihren eigenen Aufgaben auszuführen und die Ergebnisse zu lesen. Der Kimi Code CLI bietet Ihnen den Agenten kostenlos zum Starten, und Sie können die API jedes Modells direkt aufrufen, um rohe Ausgaben zu vergleichen.
Wenn Sie dies tun, testen Sie die Endpunkte in Apidog: Senden Sie denselben Prompt an jedes Modell, speichern Sie die Aufrufe nebeneinander und vergleichen Sie die Antwortqualität, Latenz und Token-Nutzung an einem Ort. Laden Sie Apidog herunter, um den Vergleich durchzuführen.
FAQ
Ist Kimi K2.7 Code besser als Claude Opus oder GPT-5.5? Bei den von Moonshot gemeldeten Kodierungs-Benchmarks, nein; die geschlossenen Modelle erzielen bei den meisten Suiten höhere Punktzahlen. Kimis Vorteil sind offene Gewichte und wesentlich geringere Kosten, während es nur wenige Punkte dahinter liegt.
Wie viel günstiger ist Kimi? Es kostet 0,95 $ pro Million Eingabe-Tokens und 4,00 $ pro Million Ausgabe-Tokens, und ist kostenlos selbst zu hosten. Die geschlossenen Spitzenmodelle kosten pro Token mehr und können nicht selbst gehostet werden.
Kann ich Kimi K2.7 Code selbst ausführen? Ja. Die Gewichte sind unter einer modifizierten MIT-Lizenz offen; stellen Sie sie mit vLLM, SGLang oder KTransformers bereit.
Welches ist das Beste für Kodierungsagenten? Für die Rohqualität führt GPT-5.5. Für kosteneffiziente Agenten mit hohem Volumen ist Kimi der bessere Wert, und es liegt bei den agentischen Benchmarks nah dran.
Sind diese Benchmarks neutral? Mehrere Suiten stammen von Moonshot selbst, daher sollten sie als die Darstellung des Anbieters gelesen werden. Der konsistente Abstand zum Spitzenmodell ist das nützliche Signal, nicht die genauen Zahlen.
Zusammenfassung
Kimi K2.7 Code schlägt Claude Opus oder GPT-5.5 bei den meisten Kodierungs-Benchmarks nicht, und Moonshot tut auch nicht so, als ob es das täte. Es erzielt ein paar Punkte weniger, kostet aber viel weniger und liefert offene Gewichte, die Sie selbst ausführen können. Für die höchstmögliche Qualität gewinnt immer noch das geschlossene Spitzenmodell. Für Agenten mit hohem Volumen, private Bereitstellungen oder jeden, der den Gesamtwert über die Spitze der Tabelle stellt, ist Kimi die klügere Wahl. Führen Sie alle drei mit Ihrem eigenen Code aus, vergleichen Sie die Ausgaben in Apidog und lassen Sie Ihre Arbeitslast entscheiden.