Entwickler suchen ständig nach effizienten Wegen, fortschrittliche KI-Modelle in ihre Anwendungen zu integrieren, und Qwen Next erweist sich als eine überzeugende Option. Dieses Modell, Teil von Alibabas Qwen-Serie, bietet eine sparse Mixture of Experts (MoE)-Architektur, die während der Inferenz nur einen Bruchteil ihrer Parameter aktiviert. Dadurch erzielen Sie schnellere Verarbeitungszeiten und geringere Kosten, ohne die Leistung zu beeinträchtigen.
Die Kernarchitektur von Qwen Next verstehen und warum sie für API-Benutzer wichtig ist
Die Hybridarchitektur von Qwen Next kombiniert Gated-Mechanismen mit fortschrittlicher Normalisierung und optimiert sie für API-gesteuerte Aufgaben. Die MoE-Schicht leitet Eingaben an 10 von 512 spezialisierten Experten pro Token weiter, plus einen gemeinsamen Experten, wodurch nur 3 Milliarden Parameter aktiviert werden. Diese Sparsität reduziert den Ressourcenbedarf und ermöglicht eine schnellere Inferenz für Qwen API-Benutzer.
Zusätzlich verwendet das Modell eine skalierte Punktprodukt-Aufmerksamkeit mit partiellen Rotary Position Embeddings (RoPE), die den Kontext in Sequenzen von bis zu 128K Tokens bewahrt. Nullzentrierte RMSNorm-Schichten stabilisieren Gradienten und gewährleisten zuverlässige Ausgaben bei hochvolumigen API-Aufrufen. Der DeltaNet-Pfad mit einem 3-fachen Expansionsfaktor verwendet L2-Normalisierung, Faltungsschichten und SiLU-Aktivierungen, um spekulatives Decoding zu unterstützen, das mehrere Tokens gleichzeitig generiert.
Für Entwickler bedeutet dies, dass die Next Integration in Anwendungen wie Dokumentenanalyse-Tools sowohl effizient als auch skalierbar ist. Die Modularität der Architektur ermöglicht eine Feinabstimmung für Domänen wie Finanzen, wodurch sie über die Qwen API anpassbar ist. Als Nächstes wird untersucht, wie sich diese Funktionen in messbare Leistung übersetzen.
Bewertung der Leistungsbenchmarks für Qwen Next in API-gesteuerten Anwendungen
Entwickler, die Qwen Next in API-gesteuerte Workflows integrieren, bevorzugen Modelle, die hohe Leistung mit Recheneffizienz in Einklang bringen. Qwen3-Next-80B-A3B, mit seiner sparsamen Mixture of Experts (MoE)-Architektur, die während der Inferenz nur 3 Milliarden Parameter aktiviert, zeichnet sich in diesem Bereich aus. Dieser Abschnitt bewertet wichtige Benchmarks und hebt hervor, wie Qwen Next dichtere Gegenstücke wie Qwen3-32B übertrifft und gleichzeitig überlegene Inferenzgeschwindigkeiten liefert – entscheidend für Echtzeit-API-Antworten. Durch die Untersuchung von Metriken über Allgemeinwissen, Codierung, Argumentation und Aufgaben mit langem Kontext erhalten Sie Einblicke in seine Eignung für skalierbare Anwendungen.
Effizienz des Vortrainings und Leistung des Basismodells
Das Vortraining von Qwen Next zeigt eine bemerkenswerte Effizienz. Das Qwen3-Next-80B-A3B-Base-Modell, das auf einer 15 Billionen Token umfassenden Teilmenge des 36 Billionen Token umfassenden Qwen3-Korpus trainiert wurde, verbraucht weniger als 80 % der von Qwen3-30B-A3B benötigten GPU-Stunden und nur 9,3 % der Rechenkosten von Qwen3-32B. Trotzdem aktiviert es nur ein Zehntel der von Qwen3-32B-Base verwendeten Nicht-Embedding-Parameter, übertrifft es jedoch bei den meisten Standard-Benchmarks und übertrifft Qwen3-30B-A3B deutlich.
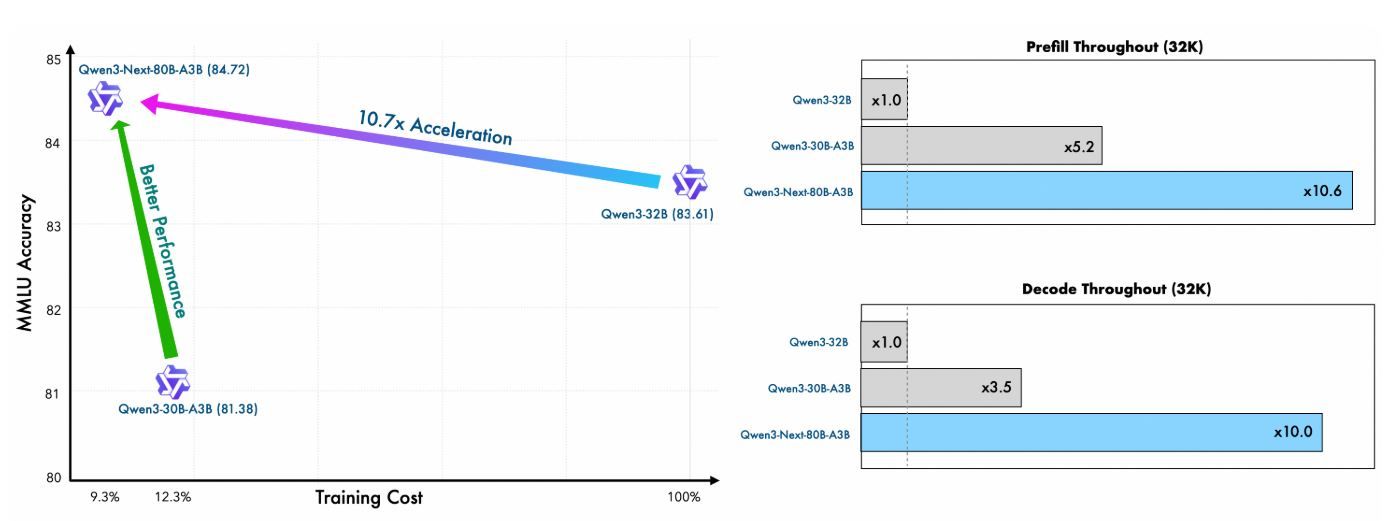
Diese Effizienz resultiert aus der Hybridarchitektur – der Kombination von Gated DeltaNet (75 % der Schichten) mit Gated Attention (25 %) – die sowohl die Trainingsstabilität als auch den Inferenzdurchsatz optimiert. Für API-Benutzer bedeutet dies geringere Bereitstellungskosten und schnelleres Prototyping, da das Modell mit weniger Ressourcen eine bessere Perplexität und Verlustreduzierung erzielt.
Metrik | Qwen3-Next-80B-A3B-Base | Qwen3-32B-Base | Qwen3-30B-A3B-Base |
|---|---|---|---|
Trainings-GPU-Stunden (% von Qwen3-32B) | 9.3% | 100% | ~125% |
Verhältnis aktiver Parameter | 10% | 100% | 10% |
Benchmark-Überlegenheit | Übertrifft die meisten | Basislinie | Deutlich besser |
Diese Zahlen unterstreichen den Wert von Qwen Next in ressourcenbeschränkten API-Umgebungen, in denen das Training benutzerdefinierter Varianten durch Feinabstimmung weiterhin machbar ist.
Inferenzgeschwindigkeit: Prefill- und Decode-Phasen für API-Latenz
Die Inferenzgeschwindigkeit wirkt sich direkt auf die API-Antwortzeiten aus, insbesondere in Szenarien mit hohem Durchsatz wie Chat-Diensten oder der Inhaltserstellung. Qwen Next glänzt hier, indem es sein ultrasparses MoE (512 Experten, Weiterleitung von 10 + 1 gemeinsam genutzten) und Multi-Token Prediction (MTP) für spekulatives Decoding nutzt.
In der Prefill-Phase (Prompt-Verarbeitung) erreicht Qwen Next bei 4K Kontextlängen einen fast 7-fach höheren Durchsatz als Qwen3-32B. Jenseits von 32K Tokens übersteigt dieser Vorteil das 10-fache, was es ideal für APIs zur Analyse langer Dokumente macht.
Für die Decode-Phase (Token-Generierung) erreicht der Durchsatz bei 4K Kontexten fast das 4-fache und bei längeren Längen über das 10-fache. Der MTP-Mechanismus, optimiert für mehrstufige Konsistenz, erhöht die Akzeptanzraten beim spekulativen Decoding und beschleunigt die Inferenz in der realen Welt weiter.
Kontextlänge | Prefill-Durchsatz (vs. Qwen3-32B) | Decode-Durchsatz (vs. Qwen3-32B) |
|---|---|---|
4K Tokens | 7x schneller | 4x schneller |
>32K Tokens | >10x schneller | >10x schneller |
API-Entwickler profitieren immens: Reduzierte Latenz ermöglicht sub-sekundäre Antworten in der Produktion, während die Energieeffizienz (durch die Aktivierung von nur 3,7 % der Parameter) die Cloud-Kosten senkt. Frameworks wie vLLM und SGLang verstärken diese Vorteile und unterstützen bis zu 256K Kontexte mit Tensor-Parallelität.
Ihren ersten API-Aufruf mit Qwen Next tätigen: Eine Schritt-für-Schritt-Implementierung
Um die Fähigkeiten von Qwen Next zu nutzen, befolgen Sie diese klaren, umsetzbaren Schritte, um Qwen API-Aufrufe über die DashScope-Plattform von Alibaba einzurichten und auszuführen. Diese Anleitung stellt sicher, dass Sie das Modell effizient integrieren können, sei es für einfache Abfragen oder komplexe Next Integration-Szenarien.
Schritt 1: Alibaba Cloud-Konto erstellen und auf Model Studio zugreifen
Beginnen Sie mit der Registrierung für ein Alibaba Cloud-Konto unter alibabacloud.com. Navigieren Sie nach der Verifizierung Ihres Kontos zur Model Studio-Konsole innerhalb der DashScope-Plattform. Wählen Sie Qwen3-Next-80B-A3B aus der Modellliste aus und wählen Sie die Basis-, Instruktions- oder Denkvariante basierend auf Ihrem Anwendungsfall – z. B. Instruktion für Konversationsaufgaben oder Denken für komplexe Argumentation.
Schritt 2: Ihren API-Schlüssel generieren und sichern
Suchen Sie im DashScope-Dashboard den Abschnitt „API Keys“ und generieren Sie einen neuen Schlüssel. Dieser Schlüssel authentifiziert Ihre Qwen API-Anfragen. Beachten Sie die Ratenbegrenzungen: Der kostenlose Tarif bietet 1 Million Tokens pro Monat, ausreichend für erste Tests. Speichern Sie den Schlüssel sicher in einer Umgebungsvariable, um eine Offenlegung zu verhindern:
bash
export DASHSCOPE_API_KEY='Ihr_Schlüssel_hier'Diese Vorgehensweise hält Ihren Code portabel und sicher.
Schritt 3: Das DashScope Python SDK installieren
Installieren Sie das DashScope SDK, um Qwen API-Interaktionen zu vereinfachen. Führen Sie den folgenden Befehl in Ihrem Terminal aus:
bash
pip install dashscopeDas SDK übernimmt die Serialisierung, Wiederholungsversuche und Fehleranalyse, wodurch Ihr Integrationsprozess optimiert wird. Alternativ können Sie HTTP-Clients wie `requests` für benutzerdefinierte Setups verwenden, aber das SDK wird aus Gründen der Einfachheit empfohlen.
Schritt 4: Den API-Endpunkt konfigurieren
Für OpenAI-kompatible Clients setzen Sie die Basis-URL auf:
text
https://dashscope.aliyuncs.com/compatible-mode/v1Für native DashScope-Aufrufe verwenden Sie:
text
https://dashscope.aliyuncs.com/api/v1/services/aigc/text-generation/generationFügen Sie Ihren API-Schlüssel im Anforderungsheader als X-DashScope-API-Key ein. Diese Konfiguration gewährleistet die korrekte Weiterleitung an Qwen Next.
Schritt 5: Ihren ersten API-Aufruf tätigen
Erstellen Sie eine grundlegende Generierungsanfrage mit der Instruktionsvariante. Unten ist ein Python-Skript, um Qwen Next abzufragen:
python
import os
from dashscope import Generation

os.environ['DASHSCOPE_API_KEY'] = 'Ihr_API_Schlüssel'

response = Generation.call(
    model='qwen3-next-80b-a3b-instruct',
    prompt='Erklären Sie die Vorteile von MoE-Architekturen in LLMs.',
    max_tokens=200,
    temperature=0.7
)

if response.status_code == 200:
    print(response.output['text'])
else:
    print(f"Fehler: {response.message}")
Dieses Skript sendet einen Prompt, begrenzt die Ausgabe auf 200 Tokens und steuert die Kreativität mit temperature=0.7. Ein Statuscode 200 zeigt den Erfolg an; andernfalls behandeln Sie Fehler wie Quotenüberschreitungen (Code 10402).
Schritt 6: Streaming für Echtzeit-Antworten implementieren
Für Anwendungen, die sofortiges Feedback erfordern, verwenden Sie Streaming:
python
from dashscope import Streaming

for response in Streaming.call(
    model='qwen3-next-80b-a3b-instruct',
    prompt='Generieren Sie eine Python-Funktion für die Sentimentanalyse.',
    max_tokens=500,
    incremental_output=True
):
    if response.status_code == 200:
        print(response.output['text_delta'], end='', flush=True)
    else:
        print(f"Fehler: {response.message}")
        break
Dies liefert eine Token-für-Token-Ausgabe, perfekt für Live-Chat-Schnittstellen in Next Integration.
Schritt 7: Funktionsaufrufe für agentenbasierte Workflows hinzufügen
Erweitern Sie die Funktionalität mit Tool-Integration. Definieren Sie ein JSON-Schema für ein Tool, wie z.B. Wetterabfrage:
python
tools = [{
    "type": "function",
    "function": {
        "name": "get_weather",
        "description": "Aktuelles Wetter abrufen",
        "parameters": {
            "type": "object",
            "properties": {"city": {"type": "string"}}
        }
    }
}]

response = Generation.call(
    model='qwen3-next-80b-a3b-instruct',
    prompt='Wie ist das Wetter in Peking?',
    tools=tools,
    tool_choice='auto'
)
Die Qwen API parst den Prompt und löst den Tool-Aufruf aus. Führen Sie die Funktion extern aus und speisen Sie die Ergebnisse zurück.
Schritt 8: Mit Apidog testen und validieren
Verwenden Sie Apidog, um Ihre API-Aufrufe zu testen. Importieren Sie das DashScope-Schema in ein neues Apidog-Projekt, fügen Sie den Endpunkt hinzu und Ihren API-Schlüssel im Header. Erstellen Sie einen JSON-Body mit Ihrem Prompt und führen Sie dann Testfälle aus, um die Antworten zu überprüfen. Apidog generiert Metriken wie Latenz und schlägt Edge-Cases vor, wodurch die Zuverlässigkeit verbessert wird.
Schritt 9: Antworten überwachen und debuggen
Überprüfen Sie die Antwortcodes auf Fehler (z. B. 429 für Ratenbegrenzungen). Protokollieren Sie anonymisierte Ausgaben für Audits. Verwenden Sie die Dashboards von Apidog, um die Token-Nutzung und Antwortzeiten zu verfolgen, um sicherzustellen, dass Ihre Qwen API-Aufrufe innerhalb der Quoten bleiben.
Diese Schritte bilden eine robuste Grundlage für die Integration von Qwen Next. Als Nächstes optimieren Sie Ihre Tests mit Apidog.
Nutzung von Funktionsaufrufen in der Qwen Next API für agentenbasierte Workflows
Funktionsaufrufe erweitern den Nutzen von Qwen Next über die Textgenerierung hinaus. Definieren Sie Tools im JSON-Schema, indem Sie Namen, Beschreibungen und Parameter festlegen. Für Wetterabfragen skizzieren Sie eine get_weather-Funktion mit einem city-Parameter.
Fügen Sie in Ihrem API-Aufruf das Tool-Array ein und setzen Sie tool_choice auf 'auto'. Das Modell analysiert den Prompt, identifiziert Absichten und gibt Tool-Aufrufe zurück. Führen Sie die Funktion extern aus und speisen Sie die Ergebnisse für die endgültigen Antworten zurück.
Dieses Muster erzeugt agentenbasierte Systeme, bei denen Qwen Next mehrere Tools orchestriert. Kombinieren Sie beispielsweise Wetterdaten mit Sentimentanalyse für personalisierte Empfehlungen. Die Qwen API übernimmt das Parsen effizient und reduziert den Bedarf an benutzerdefiniertem Code.
Optimieren Sie, indem Sie Schemata streng validieren. Stellen Sie sicher, dass die Parameter den erwarteten Typen entsprechen, um Laufzeitfehler zu vermeiden. Testen Sie diese Aufrufe bei der Integration gründlich – Tools wie Apidog erweisen sich hier als unschätzbar wertvoll, da sie Antworten ohne Live-API-Zugriffe simulieren.
Apidog für effiziente Qwen API-Tests und -Dokumentation integrieren
Dieser Leitfaden bietet einen umfassenden Workflow zur Integration von Apidog mit der Qwen API (Alibaba Cloud's Qwen Next/3.0) für effizientes Testen, Dokumentieren und API-Lebenszyklusmanagement.
Phase 1: Erste Einrichtung & Kontokonfiguration
Schritt 1: Kontoeinrichtung
1.1 Erforderliche Konten erstellen
1. Alibaba Cloud-Konto
2. Besuchen Sie: https://www.alibabacloud.com
3. Registrieren & Verifizierung abschließen
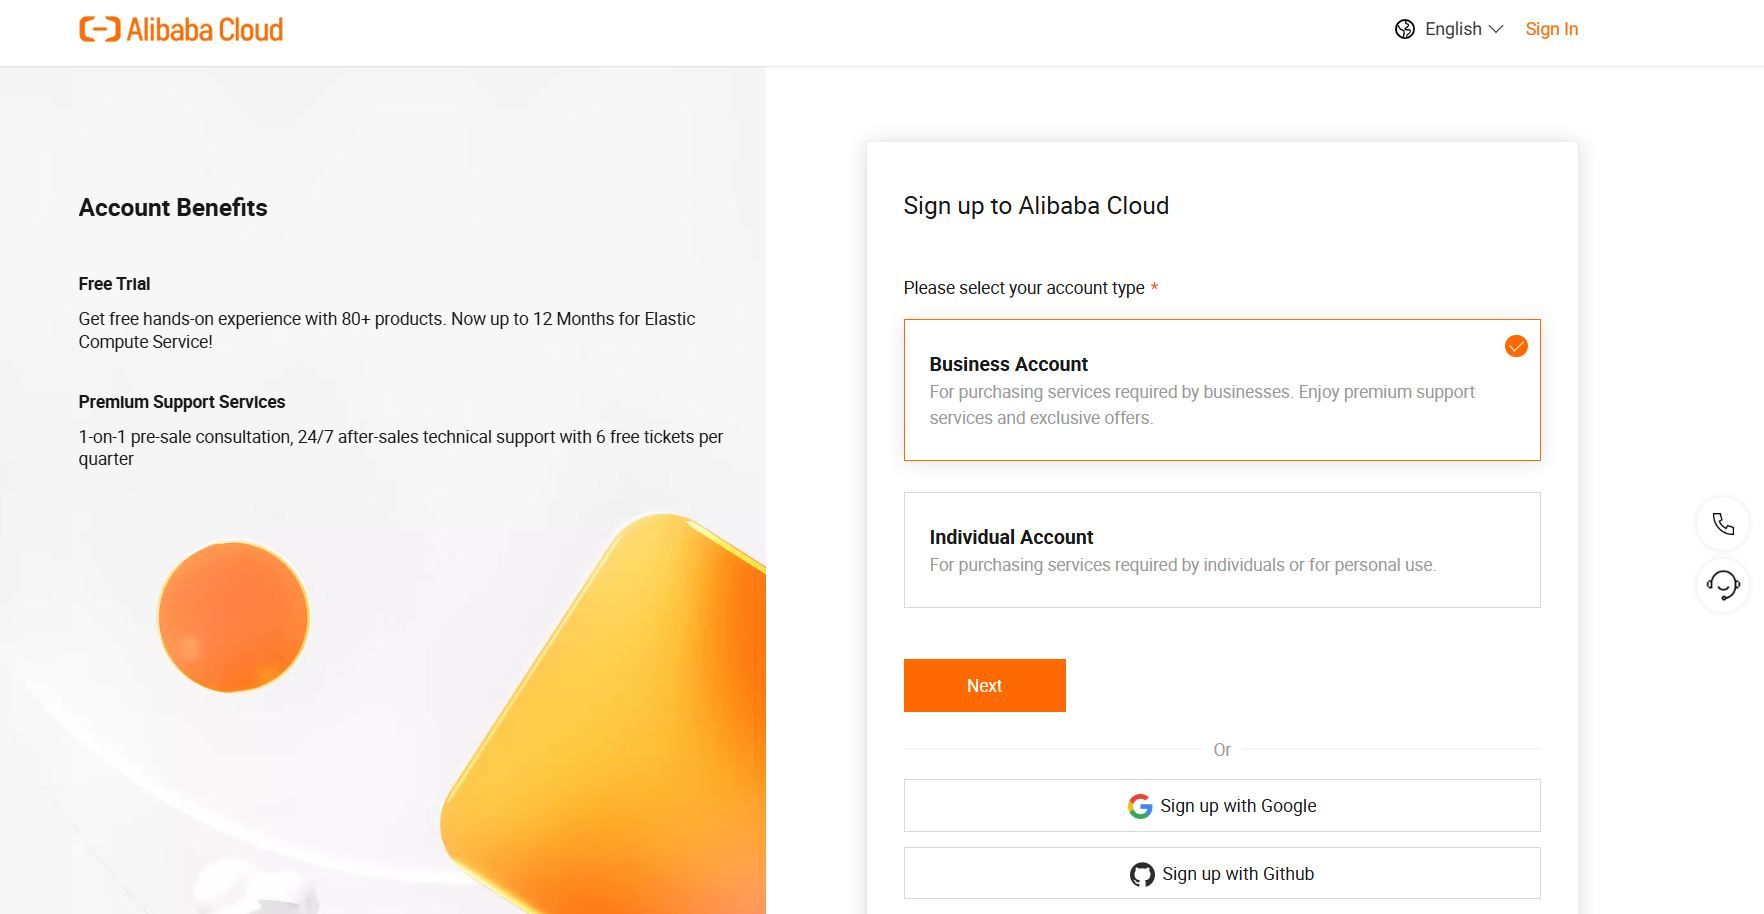
4. Dienst "Model Studio" aktivieren
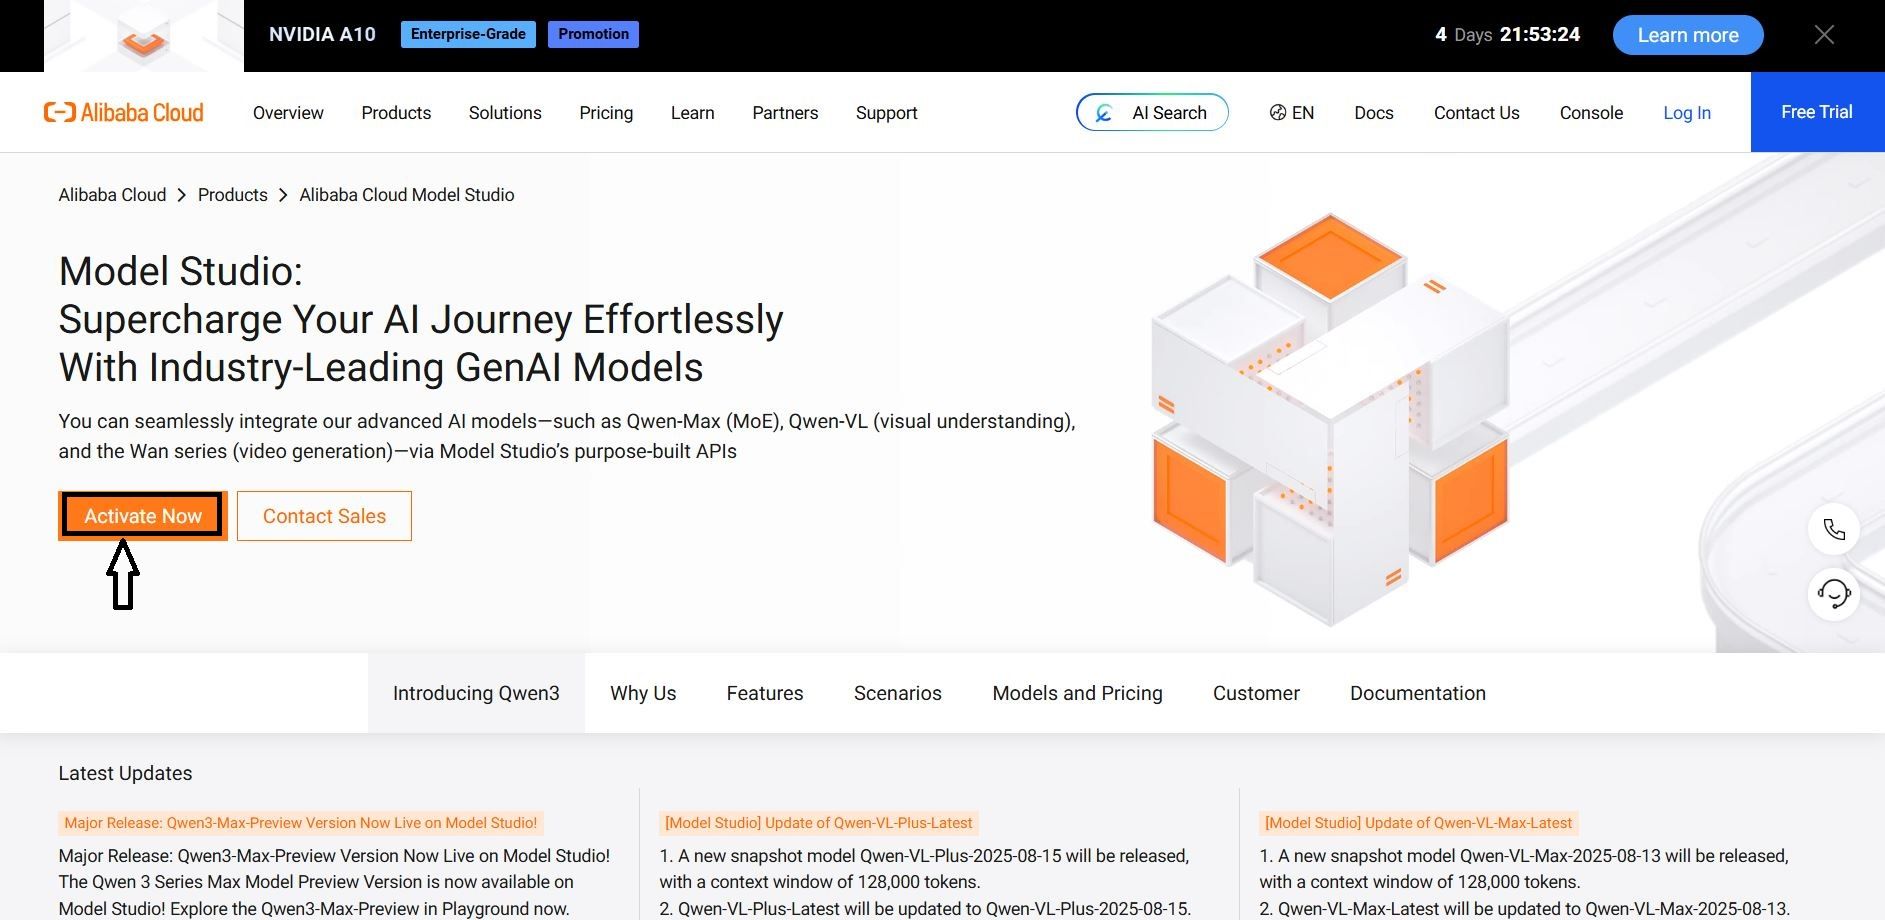
5. Apidog-Konto
6. Besuchen Sie: https://apidog.com
7. Mit E-Mail/Google/GitHub anmelden
1.2 Qwen API-Anmeldeinformationen abrufen
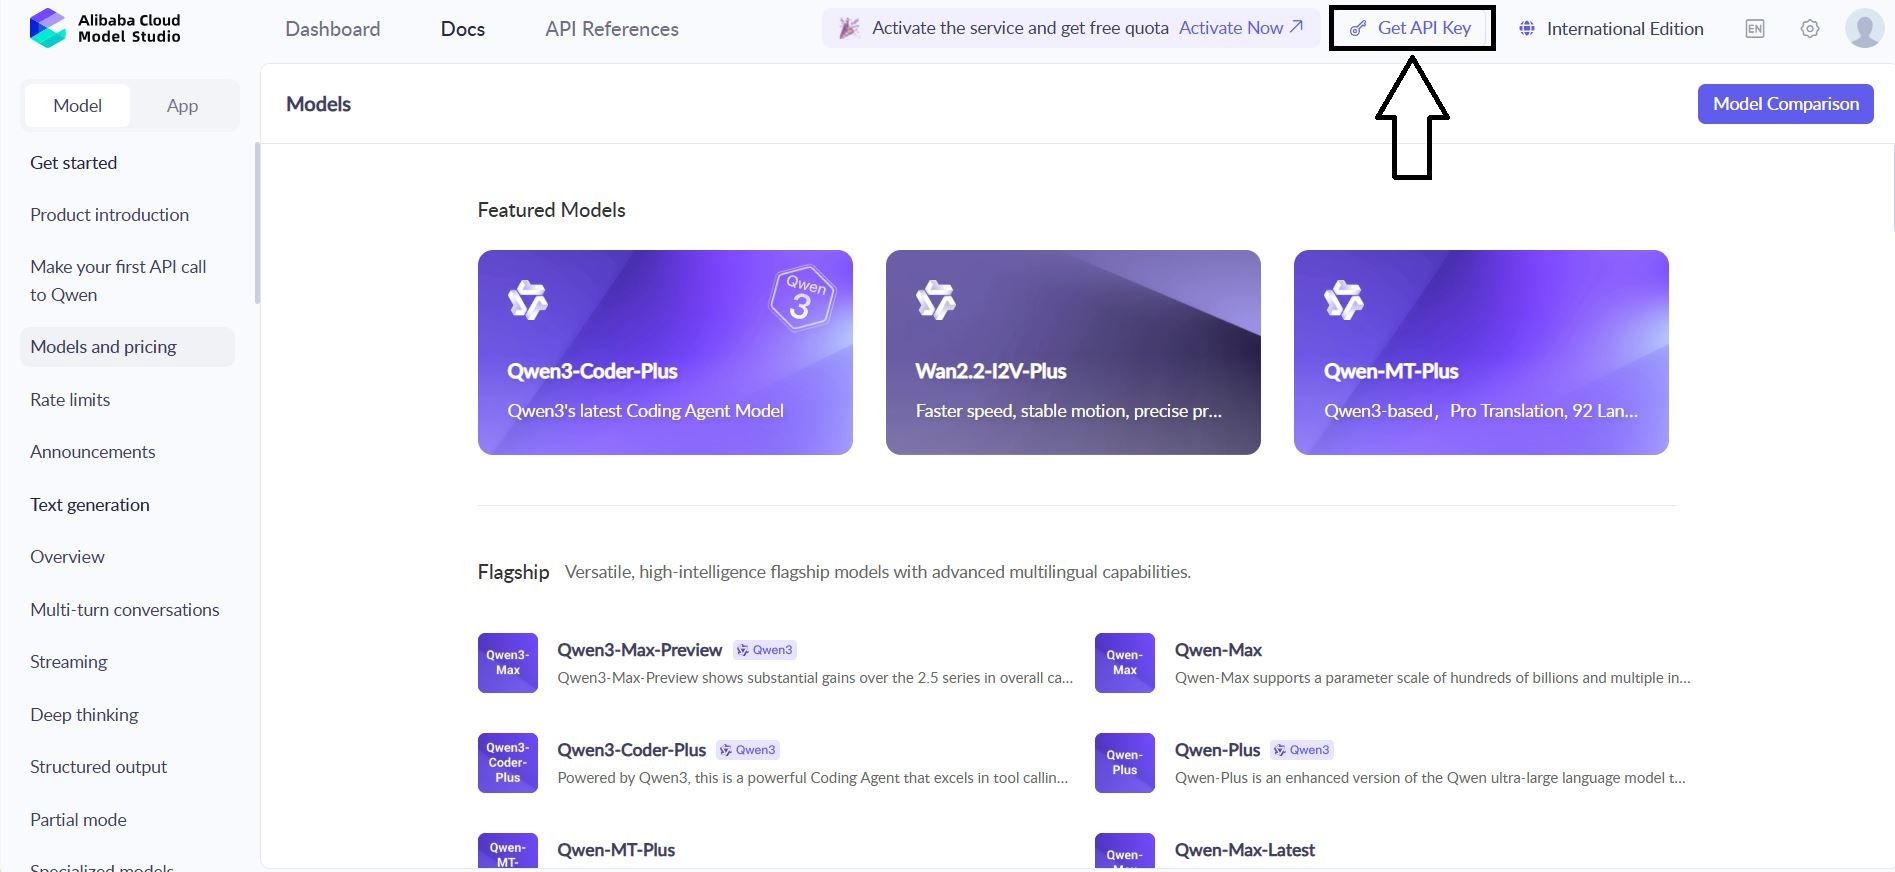
1. Navigieren Sie zu: Alibaba Cloud Konsole → Model Studio → API Keys
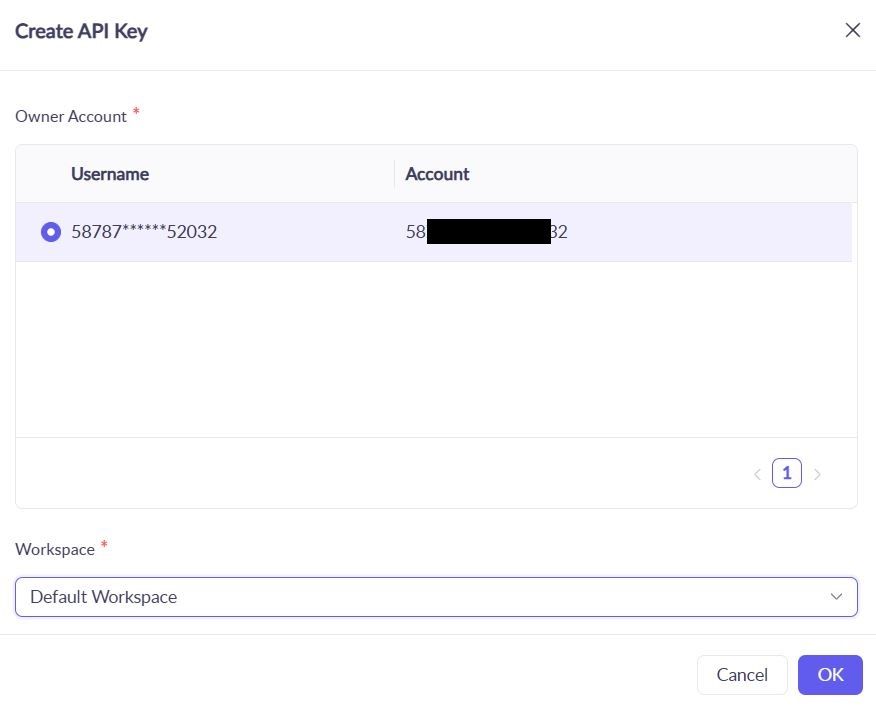
2. Neuen Schlüssel erstellen: qwen-testing-key
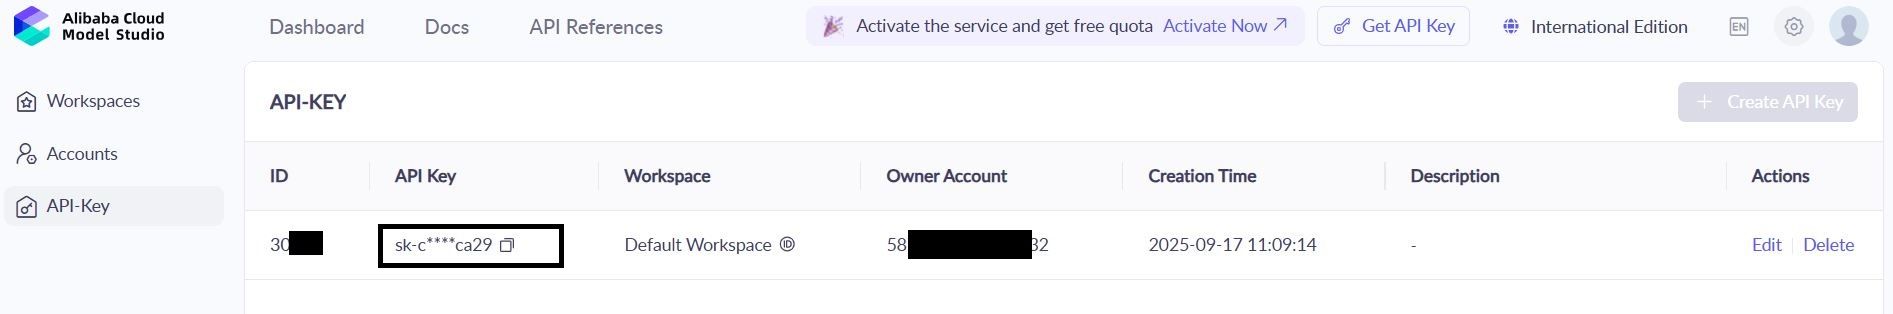
3. Speichern Sie Ihren Schlüssel: sk-[Ihr-tatsächlicher-Schlüssel-hier]
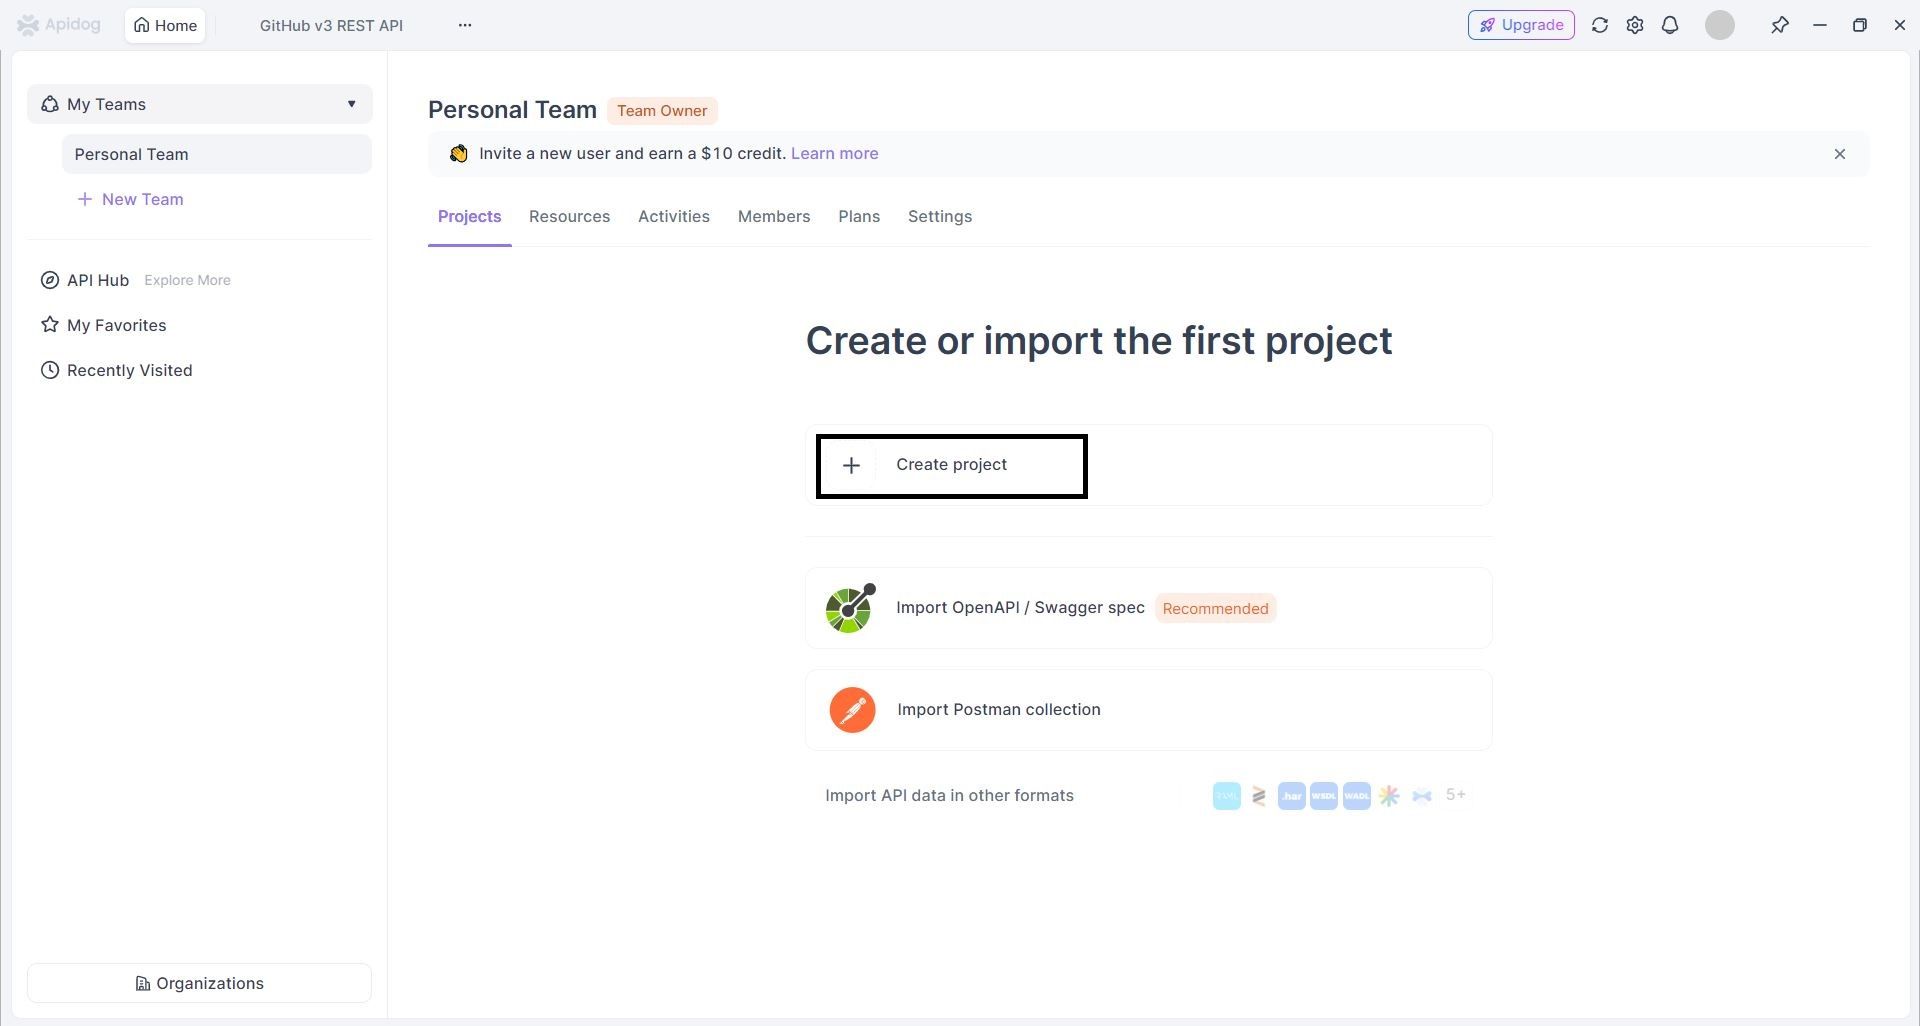
1.3 Apidog-Projekt erstellen
- Bei Apidog anmelden → Auf „Neues Projekt“ klicken
2. Projekt konfigurieren:
1. Projektname: Qwen API Integration
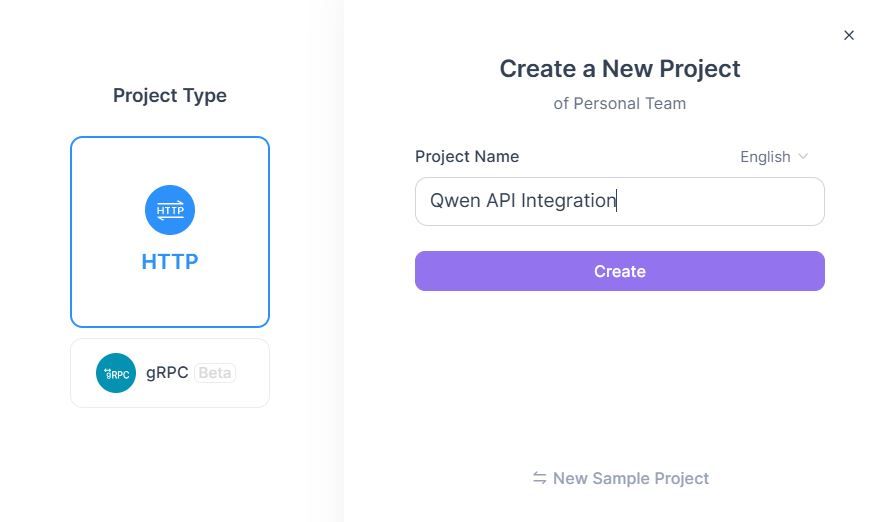
2. Beschreibung: Qwen Next API-Tests & Dokumentation
Phase 2: API-Import & Konfiguration
Schritt 2: Qwen API-Spezifikationen importieren
Methode A: Manuelle API-Erstellung
- Neue API hinzufügen → „API manuell erstellen“
- Qwen Chat Endpunkt konfigurieren:
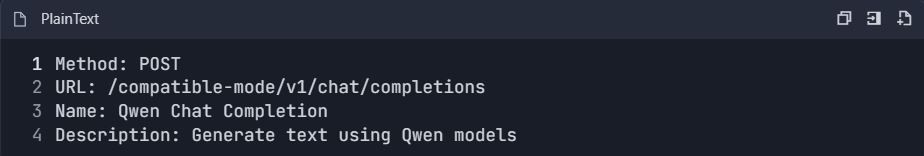
3. Anforderungskonfiguration festlegen:
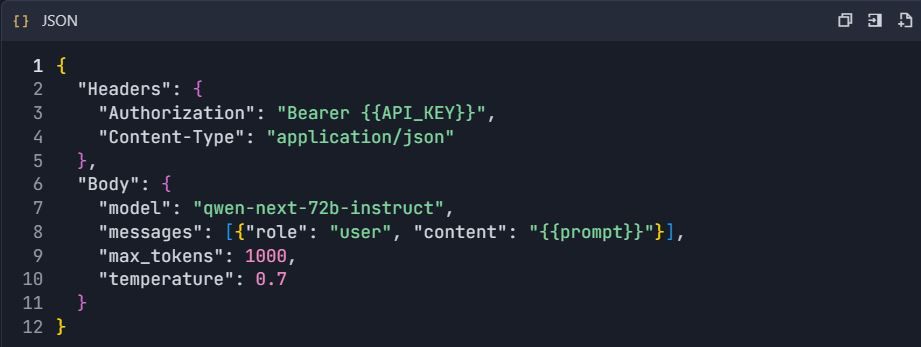
Methode B: OpenAPI-Import
- Qwen OpenAPI-Spezifikation herunterladen (falls verfügbar)
- Gehen Sie zu Projekt → „Importieren“ → „OpenAPI/Swagger“
- Spezifikationsdatei hochladen → „Importieren“
Phase 3: Umgebungs- & Authentifizierungseinrichtung
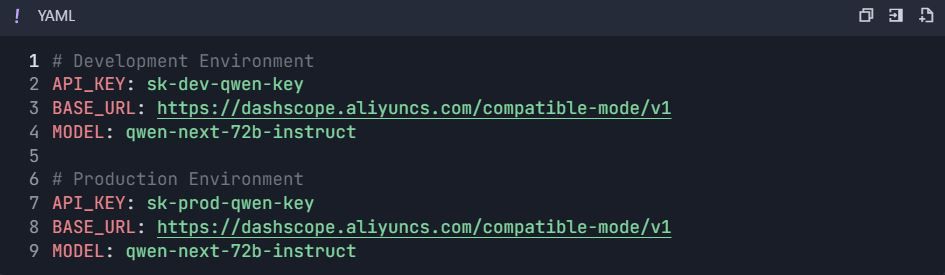
Schritt 3: Umgebungen konfigurieren
3.1 Umgebungsvariablen erstellen
- Gehen Sie zu Projekteinstellungen → „Umgebungen“
- Umgebungen erstellen:
Phase 4: Umfassende Testsuite
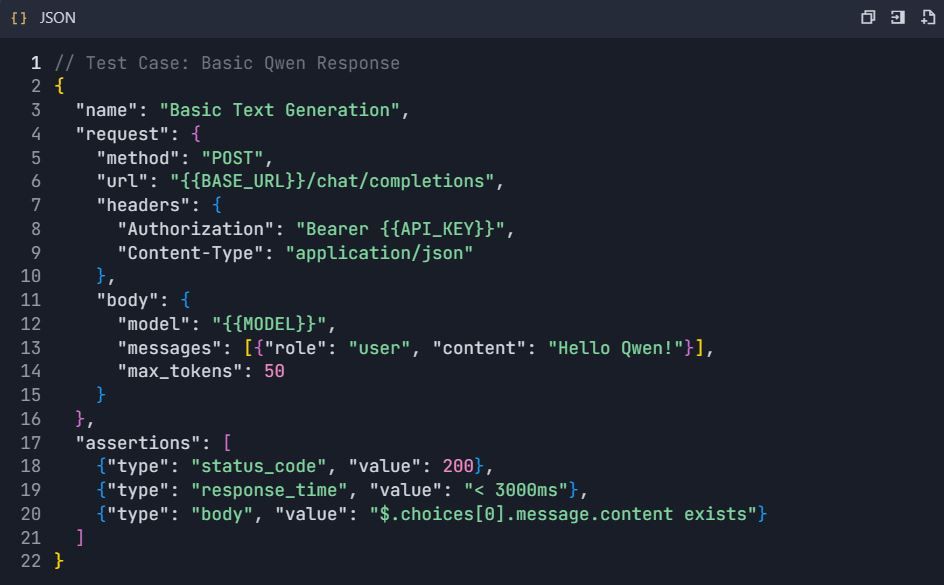
Schritt 4: Testszenarien erstellen
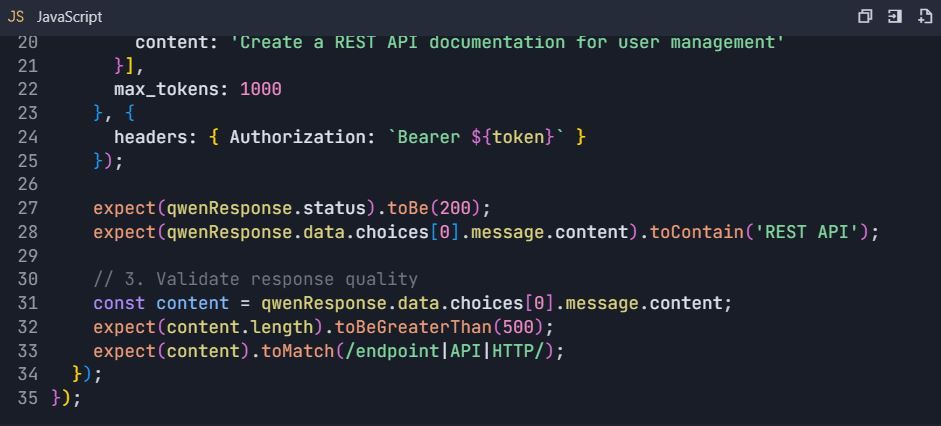
4.1 Grundlegender Textgenerierungstest
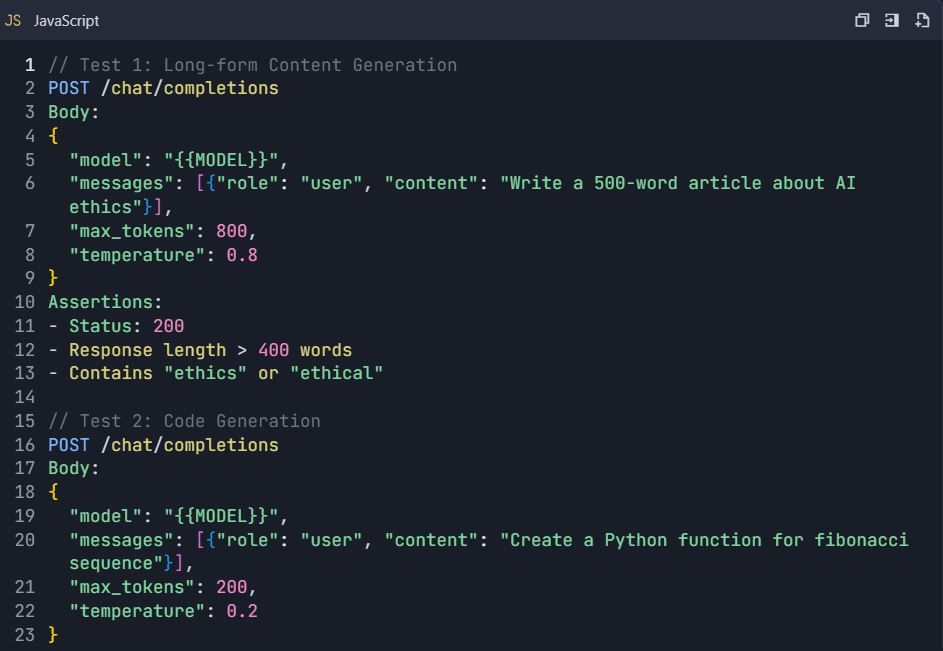
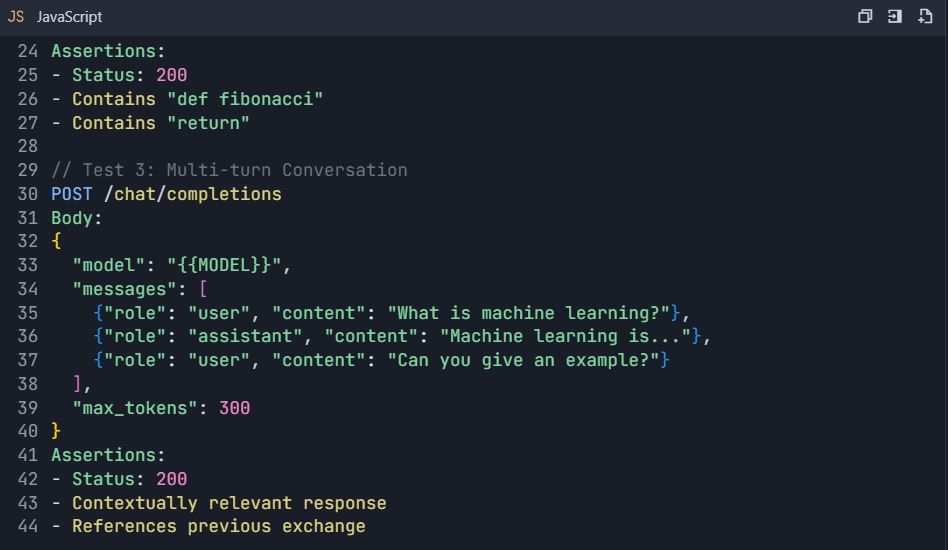
4.2 Erweiterte Testszenarien
Testsuite: Umfassende Qwen API-Tests
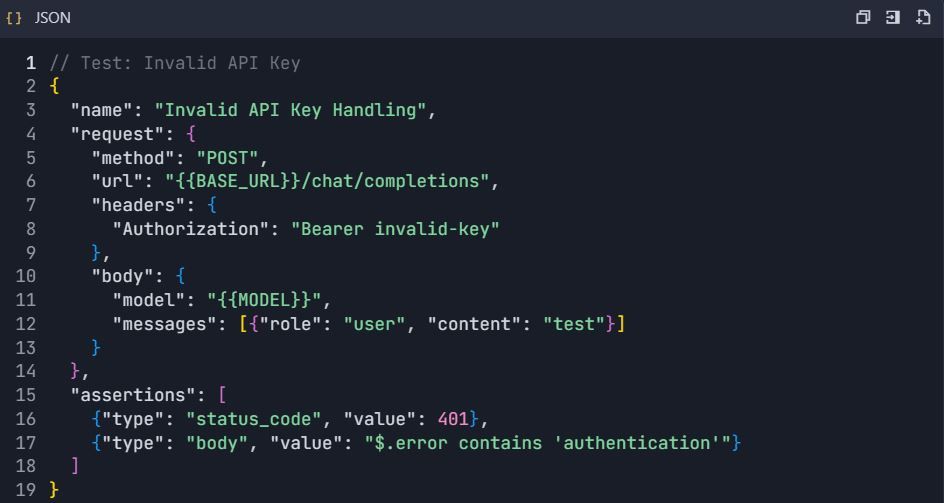
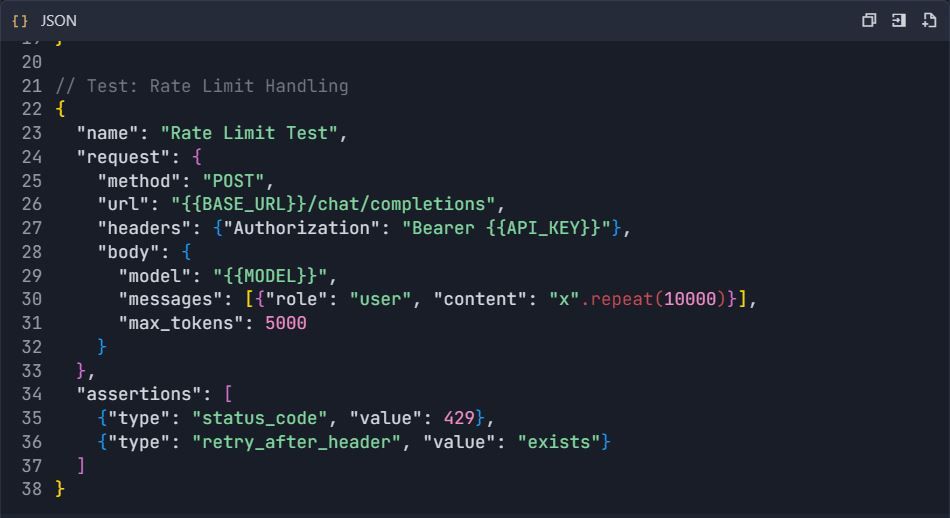
4.3 Fehlerbehandlungstests
Phase 5: Dokumentationsgenerierung
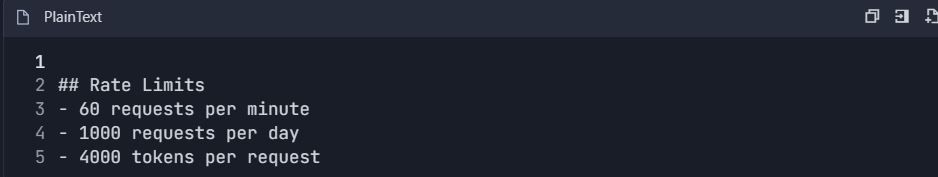
Schritt 5: API-Dokumentation automatisch generieren 5.1 Dokumentationsstruktur erstellen
- Gehen Sie zu Projekt → „Dokumentation“
- Abschnitte erstellen:
https://dashscope.aliyuncs.com/compatible-mode/v1
Autorisierung: Bearer sk-[Ihr-API-Schlüssel]
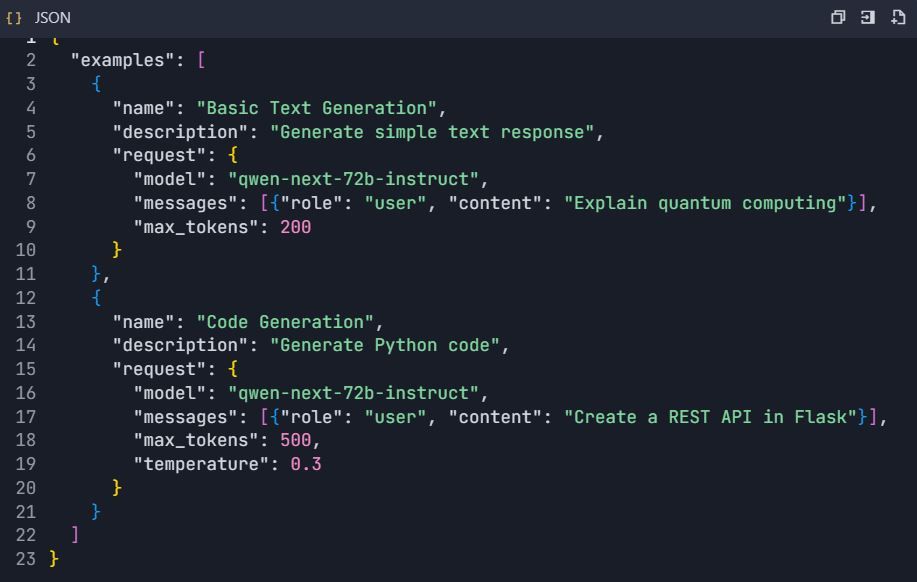
5.2 Interaktiver API Explorer
- Interaktive Beispiele konfigurieren:
Phase 6: Erweiterte Funktionen & Automatisierung
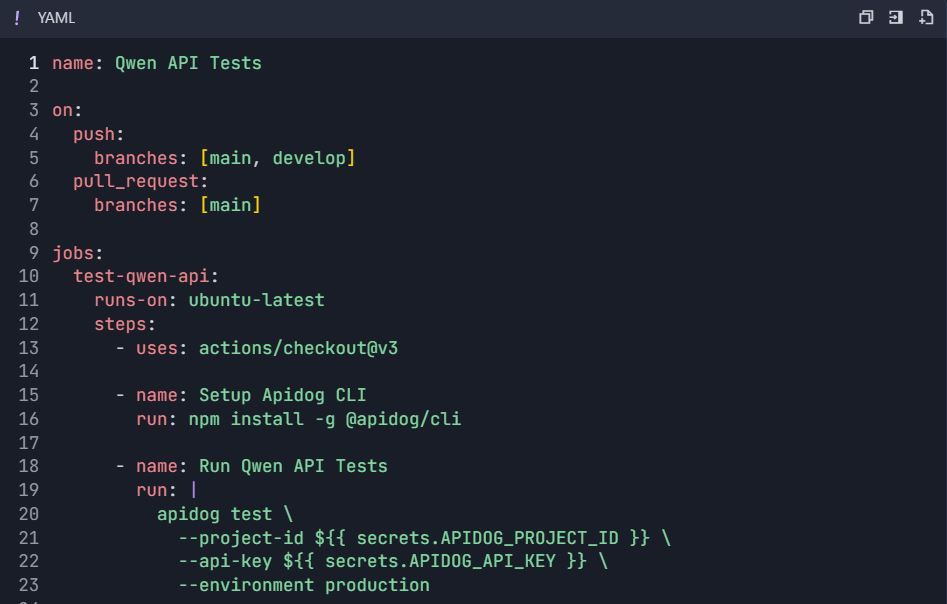
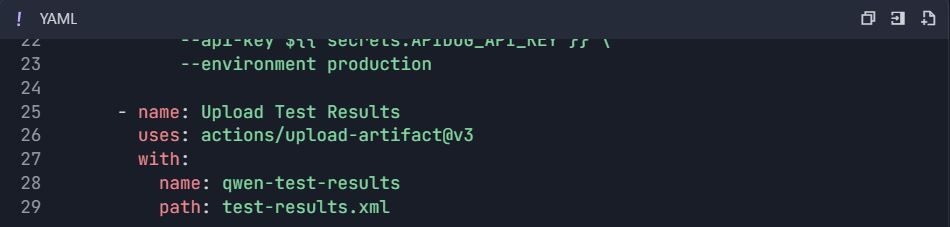
Schritt 6: Automatisierte Test-Workflows 6.1 CI/CD-Integration
GitHub Actions Workflow ( .github/workflows/qwen-tests.yml ):
6.2 Performance-Tests
- Performance-Testsuite erstellen:
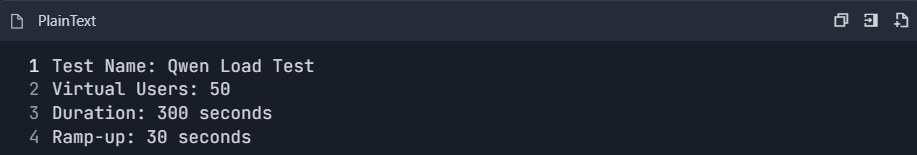
2. Metriken überwachen:
- Antwortzeit (p50, p95, p99)
- Durchsatz (Anfragen/Sekunde)
- Fehlerrate
- Effizienz der Token-Nutzung
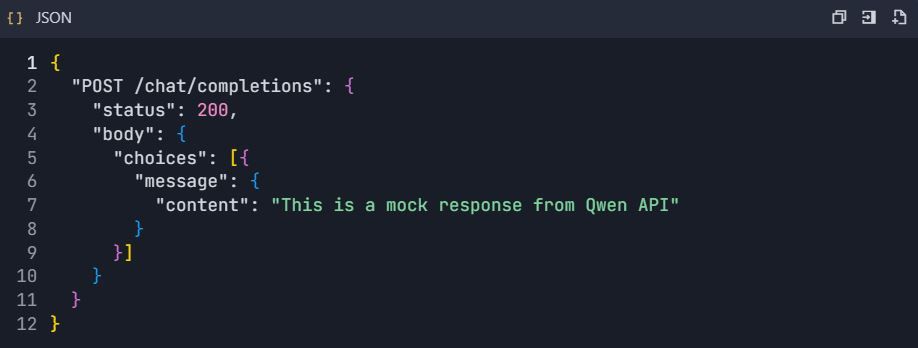
6.3 Mock-Server-Einrichtung
- Mock-Server aktivieren:
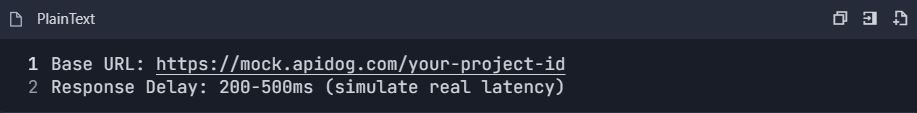
2. Mock-Antworten konfigurieren:
Phase 7: Überwachung & Analysen
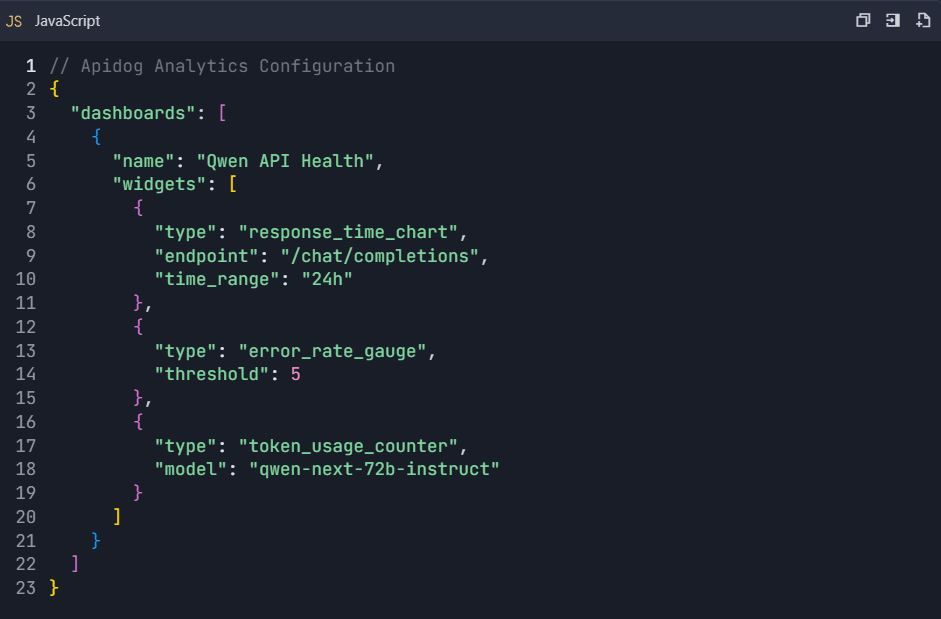
Schritt 7: Nutzungsanalyse-Dashboard
7.1 Wichtige Metriken zur Verfolgung
- API-Nutzungsstatistiken:
- Anzahl der Anfragen pro Endpunkt
- Token-Verbrauch
- Trends der Antwortzeiten
- Fehlerratenanalyse
2. Kostenüberwachung:
- Täglicher Token-Verbrauch
- Geschätzte Kosten pro Anfrage
- Budgetwarnungen
7.2 Benutzerdefinierte Dashboard-Einrichtung
Phase 8: Teamzusammenarbeit & Versionskontrolle
Schritt 8: Team-Workflow-Einrichtung
8.1 Teamrollen-Konfiguration
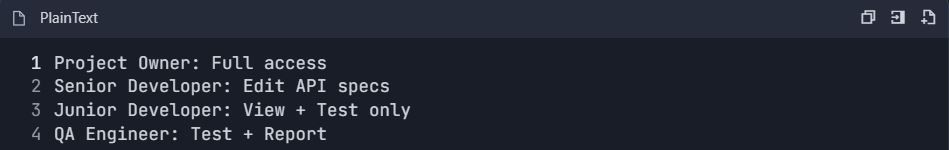
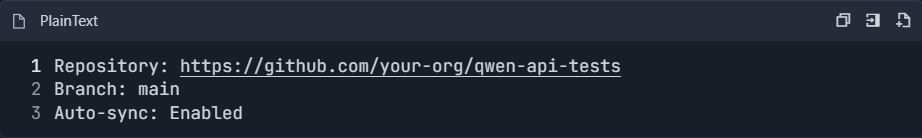
8.2 Versionskontrollintegration
- Mit Git-Repository verbinden:
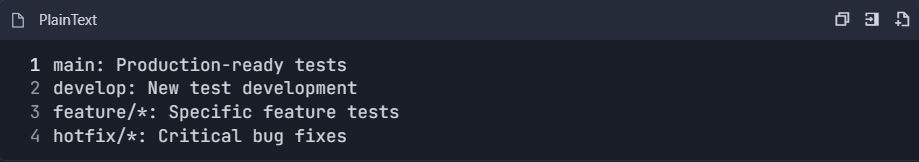
2. Branching-Strategie:
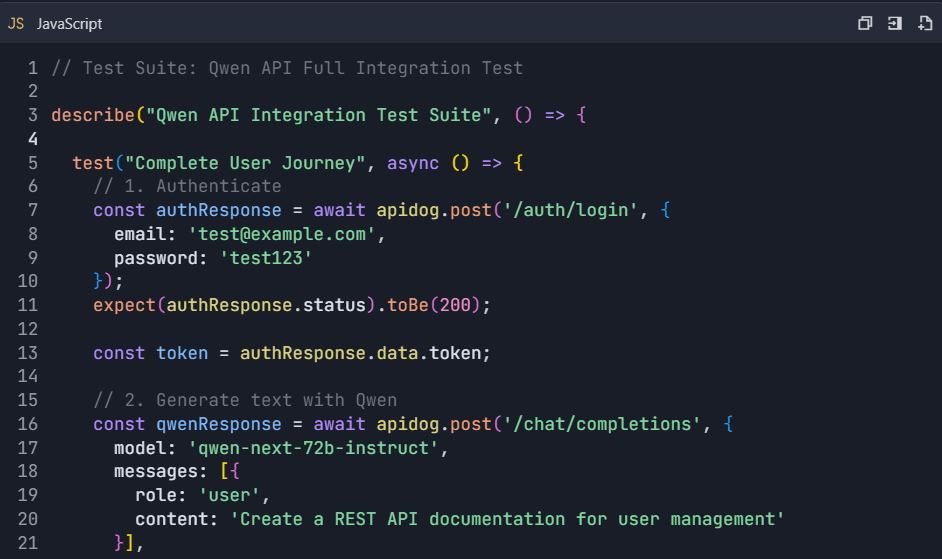
Beispiel für einen vollständigen Test-Workflow
End-to-End-Testszenario
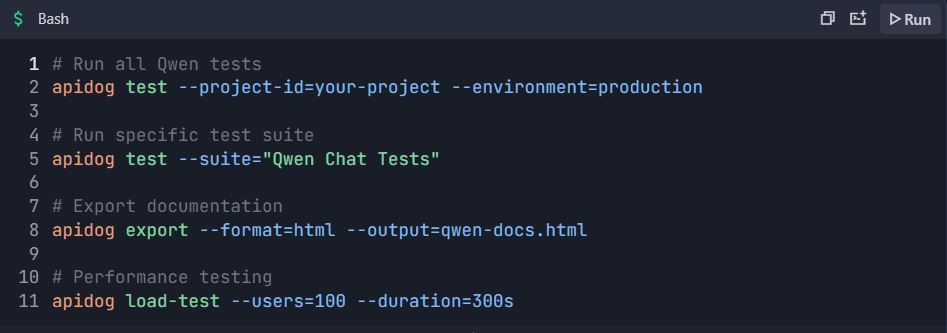
📋 Testbefehle:
Dieser umfassende Integrationsleitfaden bietet alles Notwendige, um die Qwen API mit Apidog effizient zu testen und zu dokumentieren. Die Einrichtung ermöglicht automatisierte Tests, Leistungsüberwachung, Teamzusammenarbeit und kontinuierliche Integration für eine robuste API-Entwicklung.
Fortgeschrittene Optimierungstechniken für die Qwen Next API in Produktionsumgebungen
Die Stapelverarbeitung maximiert die Effizienz in Szenarien mit hohem Volumen. DashScope erlaubt bis zu 10 Prompts pro Aufruf, wodurch Anfragen konsolidiert werden, um den Latenz-Overhead zu minimieren. Dies eignet sich für Anwendungen wie die Massenzusammenfassung.
Überwachen Sie die Token-Nutzung genau, da die Gebühren an aktive Parameter gebunden sind. Erstellen Sie prägnante Prompts, um Kosten zu sparen, und verwenden Sie result_format='message' für parsable Ausgaben, um zusätzliche Verarbeitung zu überspringen.
Implementieren Sie Wiederholungsversuche mit exponentiellem Backoff, um Transienten zu handhaben. Eine Funktion, die den Aufruf umschließt, versucht es mehrmals und pausiert dabei progressiv länger zwischen den Versuchen. Dies gewährleistet die Zuverlässigkeit unter Last.
Für Skalierbarkeit verteilen Sie über Regionen wie Singapur oder die USA. Bereinigen Sie Eingaben, um Prompt-Injektionen zu verhindern, indem Sie gegen Whitelists validieren. Protokollieren Sie anonymisierte Antworten zur Einhaltung der Vorschriften.
In Fällen mit langem Kontext zerlegen Sie Daten und verketten Aufrufe. Die Denkvariante unterstützt strukturierte Prompts für Kohärenz über erweiterte Tokens. Diese Strategien sichern robuste Bereitstellungen.
Erkundung der nächsten Integration: Qwen Next in Webanwendungen einbetten
Next Integration bezieht sich auf die Integration von Qwen Next in Next.js-Frameworks, wobei serverseitiges Rendering für KI-Funktionen genutzt wird. Richten Sie API-Routen in Next.js ein, um Qwen-Aufrufe zu proxen und Schlüssel vor Clients zu verbergen.
Verwenden Sie in Ihrem API-Handler das DashScope SDK, um Anfragen zu verarbeiten und bei Bedarf gestreamte Antworten zurückzugeben. Diese Einrichtung ermöglicht dynamische Inhalte, wie z. B. personalisierte Seiten, die spontan generiert werden.
Die Authentifizierung wird serverseitig über das Sitzungsmanagement abgewickelt. Für Echtzeit-Updates integrieren Sie WebSockets mit Streaming-Ausgaben. Testen Sie diese mit Apidog, indem Sie Client-Anfragen simulieren.
Die Leistungsoptimierung umfasst das Caching häufiger Abfragen. Verwenden Sie Redis, um Antworten zu speichern und API-Aufrufe zu reduzieren. Diese Kombination ermöglicht interaktive Anwendungen effizient.
Mehrsprachige und Langkontext-Funktionen in der Qwen Next API
Qwen Next unterstützt 119 Sprachen, wodurch es vielseitig für globale Apps einsetzbar ist. Geben Sie Sprachen in Prompts an, um genaue Übersetzungen oder Generierungen zu erhalten. Die API handhabt Wechsel nahtlos und behält den Kontext bei.
Für lange Kontexte erweitern Sie bis zu 128K Tokens, indem Sie max_context_length festlegen. Dies ist hervorragend für die Analyse großer Dokumente geeignet. Chain-of-Thought-Prompting verbessert die Argumentation über große Mengen.
Benchmarking zeigt überlegene Abrufgenauigkeit, ideal für Suchmaschinen. Integrieren Sie mit Datenbanken, um Kontexte dynamisch einzuspeisen.
Best Practices für die Sicherheit bei Qwen API-Bereitstellungen
Schützen Sie Schlüssel mit Tresoren wie AWS Secrets Manager. Überwachen Sie die Nutzung auf Anomalien und richten Sie Warnungen bei Spitzenwerten ein. Halten Sie Vorschriften ein, indem Sie Daten anonymisieren.
Ratenbegrenzung auf Client-Seite verhindert Missbrauch. Verschlüsseln Sie Übertragungen mit HTTPS.
Überwachung und Skalierung der Qwen Next API-Nutzung
DashScope-Dashboards verfolgen Metriken wie den Token-Verbrauch. Legen Sie Budgets fest, um Überschreitungen zu vermeiden. Skalieren Sie durch ein Upgrade der Tarife für höhere Limits.
Die Auto-Scaling-Infrastruktur reagiert auf Traffic. Tools wie Kubernetes verwalten Container, die Next Integration hosten.
Fallstudien: Realweltliche Anwendungen von Qwen Next über API
Im E-Commerce treibt Qwen Next Empfehlungs-Engines an, die Benutzerhistorien für Vorschläge analysieren. API-Aufrufe generieren Beschreibungen dynamisch.
Gesundheits-Apps verwenden die Denkvariante für Diagnosehilfen, die Berichte mit hoher Genauigkeit verarbeiten.
Inhaltsplattformen setzen Instruktionsmodelle für automatisiertes Schreiben ein, um die Produktion zu skalieren.
Zukunftsaussichten und Updates für Qwen Next
Alibaba entwickelt die Serie kontinuierlich weiter, mit Potenzial für mehr Experten oder feinere Weiterleitung. Bleiben Sie über offizielle Kanäle wie den QwenAI_Plus X-Account auf dem Laufenden.
API-Verbesserungen könnten eine bessere Tool-Unterstützung umfassen.
Qwen Next für innovative Lösungen nutzen
Qwen Next über API bietet unübertroffene Effizienz. Von der Einrichtung bis zu den Optimierungen verfügen Sie nun über die Tools, um effektiv zu implementieren. Experimentieren Sie mit Integrationen und nutzen Sie Apidog für reibungslose Workflows.