
Alibaba hat Qwen 3.8-Max Anfang August 2026 veröffentlicht, und die Suchergebnisse füllen sich bereits mit Behauptungen wie „für immer kostenlos nutzen“, die den tatsächlichen Bedingungen nicht standhalten. Hier ist die ehrliche Version, überprüft anhand der eigenen Seiten von Alibaba mit Stand vom 3. August 2026.
Es gibt genau vier Wege, die Ihre Zeit wert sind. Zwei funktionieren heute. Einer ist ein Versprechen mit einem Datum. Einer ist eine Ausweichlösung. Wenn Sie zuerst das vollständige Bild des Modells wünschen (2,4 Billionen Gesamtparameter, 95 Mrd. aktiv, 1 Mio. Token Kontext), beginnen Sie mit unserer Qwen 3.8 Übersicht und kommen Sie dann zurück.
Kurzübersicht vor den Details:
| Weg | Kostenlos? | Funktioniert heute? | Haken |
|---|---|---|---|
| Qwen Chat | Ja | Ja | Consumer-App, keine API |
| Model Studio API-Kontingent | 1 Mio. Token | Ja | Nur Region Singapur, 90 Tage |
| Offene Gewichte (Self-Host) | Gewichte kostenlos | Noch nicht | Versprochen „nächste Woche“, und die Hardware ist nicht kostenlos |
| Ältere Qwen-Modelle | Ja | Ja | Nicht Qwen 3.8 |
Weg 1: Qwen Chat, die Option ohne Einrichtung
Der schnellste kostenlose Weg ist der, den Alibaba für Konsumenten vorsieht: Qwen Chat. Melden Sie sich an, wählen Sie das Modell aus, und Sie sprechen mit Qwen 3.8-Max, ohne Kreditkarte und ohne Cloud-Konsole. Der offizielle Release-Post weist hierauf als Standardweg zum Ausprobieren des Modells hin.
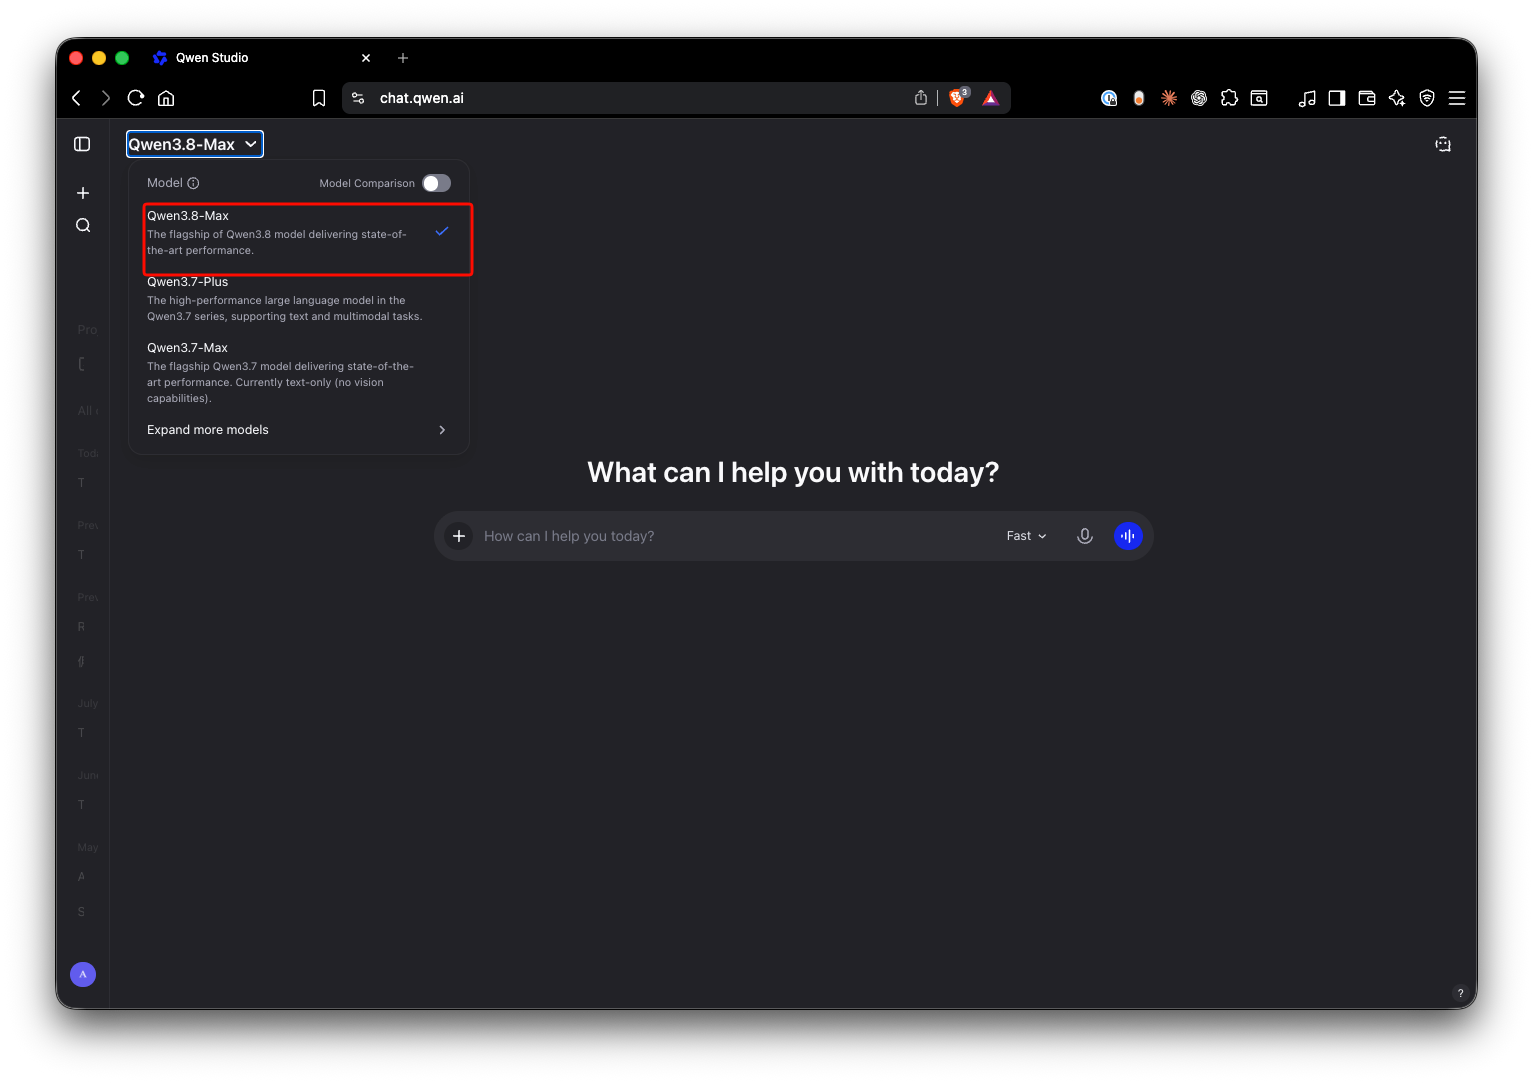
Was Sie bekommen: kostenlose Nutzung des Flaggschiffs über eine Chat-Oberfläche, einschließlich des Bild- und Dokumentenverständnisses, auf das sich die Launch-Demos stützen.
Was Sie nicht bekommen: eine API. Keine Schlüssel, keine Automatisierung, keine Möglichkeit, es in Ihre App oder Testsuite zu integrieren. Chat-Anwendungen wenden auch eigene System-Prompts und -Einstellungen an, sodass das dort angezeigte Verhalten nicht genau dem entspricht, was die rohe API zurückgibt. Wenn Sie Qwen 3.8 für ein Produkt evaluieren, behandeln Sie Qwen Chat als Demo, nicht als Benchmark.
Fazit: echt, kostenlos und gut zum Ausprobieren. Kein Weg für Entwickler.
Weg 2: das Model Studio Gratis-Kontingent (lesen Sie das Kleingedruckte)
Dies ist der Weg, der wichtig ist, wenn Sie Code schreiben. Alibaba Cloud Model Studio gibt neuen Aktivierungen ein kostenloses Kontingent für qwen3.8-max: 1 Million Token. Das ist eine wirklich nützliche Menge, und es ist auch in Kleingedrucktes verpackt, das die meisten Übersichtsbeiträge überspringen.
Hier ist, was die Preisseite tatsächlich aussagt, übersetzt in Entscheidungen:
1. Nur Region Singapur. Das kostenlose Kontingent gilt für die Region Singapur (international). Das bedeutet, Ihre Basis-URL ist:
https://dashscope-intl.aliyuncs.com/compatible-mode/v1
Zeigen Sie auf die Endpunkte Peking oder US-Virginia, und Sie zahlen ab dem ersten Token. Wenn Ihr Latenzbudget einen US-Endpunkt erfordert, hilft Ihnen das kostenlose Kontingent nicht.
2. 90 Tage, dann ist es weg. Das Kontingent ist 90 Tage ab Aktivierung gültig. Unbenutzte Token werden nicht übertragen; sie verfallen. Die Uhr läuft bereits gegen die Veröffentlichung des Modells Anfang August, also aktivieren Sie nicht jetzt und planen Sie nicht, im November zu evaluieren.
3. Nach dem Kontingent: 2 $ Eingabe / 6 $ Ausgabe pro Million Token. Das ist der Pauschalsatz über den gesamten 1M-Kontext hinweg, keine Staffelung. Es ist günstig für ein Flaggschiff, aber nicht kostenlos, und der Übergang ist automatisch, sobald Ihr Kontingent aufgebraucht oder abgelaufen ist. Richten Sie eine Abrechnungswarnung ein, bevor Sie beginnen. Wir schlüsseln die Kosten realer Workloads in unserem Qwen 3.8 Preisleitfaden auf.
Um das Kontingent in Anspruch zu nehmen: Erstellen Sie ein Konto bei Model Studio, aktivieren Sie den Dienst und generieren Sie einen API-Schlüssel (die Konvention für die Umgebungsvariable ist DASHSCOPE_API_KEY). Der Modellkatalog listet qwen3.8-max an oberster Stelle der empfohlenen Modelle auf. Der Endpunkt spricht das OpenAI-kompatible Protokoll, und es gibt auch einen Anthropic-kompatiblen Endpunkt. Unser Qwen 3.8 API-Walkthrough behandelt beide, einschließlich Streaming und Reasoning-Ausgabe.
Eine Kontingent-Falle: Reasoning ist standardmäßig aktiviert
Qwen 3.8-Max wird mit reasoning_effort auf xhigh eingestellt geliefert, und Denk-Token werden als Ausgabe abgerechnet. Ein einziger schwieriger Prompt kann unbemerkt Tausende von Reasoning-Tokens erzeugen, bevor die Antwort überhaupt beginnt. Auf einem bezahlten Konto ist das ein Kostenpunkt; bei einem kostenlosen 1M-Kontingent ist es der Unterschied zwischen zwei Wochen und zwei Tagen Testzeit. Setzen Sie reasoning_effort auf low oder medium für alles, was keine echte Reasoning-Aufgabe ist.
Die Million Token halten
Eine Million Token verschwindet schnell, wenn jede Debugging-Iteration Ihre gesamte Prompt-Kette erneut sendet. Einige Gewohnheiten strecken es:
- Die Anfrage richtig stellen, bevor Sie sie in einer Schleife ausführen. Erstellen Sie den Aufruf in Apidog, optimieren Sie Parameter und überprüfen Sie die gestreamte Antwort, einschließlich der Reasoning-Deltas, Anfrage für Anfrage. Interaktives Debugging in einem Client ist besser, als Kontingent in einer Wiederholungsschleife in Ihrem App-Code zu verbrennen.
- Mocken Sie, was Sie bereits gesehen haben. Sobald Sie die Antwortform kennen, speichern Sie ein Beispiel und lassen Sie Apidogs Mock-Server es Ihrem Frontend oder Agenten während der Entwicklung zur Verfügung stellen. Entwicklungsiterationen gegen einen Mock kosten null Token; Sie greifen nur für die endgültige Überprüfung auf den Live-Endpunkt zu.
- Beobachten Sie Ihre tatsächliche Nutzung. Die Token-Anzahlen werden in jedem Antwortkörper zurückgegeben. Behalten Sie diese pro Anfrage im Auge, und Sie kennen Ihre tatsächliche Verbrauchsrate, anstatt es erst zu erfahren, wenn das Kontingent mitten im Sprint aufgebraucht ist.
Laden Sie Apidog kostenlos herunter, wenn Sie diesem Workflow folgen möchten; es macht auch das Umschalten der Regionen schmerzfrei, da Sie die Basis-URLs für Singapur, Peking und die USA als Umgebungen speichern und zwischen ihnen wechseln können.
Fazit: echt, tatsächlich 90 Tage kostenlos und der derzeit beste Weg für Entwickler. Beachten Sie einfach die Regionssperre und das Ablaufdatum.
Weg 3: offene Gewichte, versprochen, aber noch nicht herunterladbar
Die größte Schlagzeile des Launches für die kostenlose Nutzung: Qwen 3.8-Max ist das erste Modell der Qwen-Max-Klasse mit offenen Gewichten. Alibaba sagt, die Gewichte landen „nächste Woche“ auf Hugging Face und ModelScope, was sie auf etwa den 10. August terminiert.
Mit Stand vom 3. August 2026 sind sie nicht herunterladbar. Es gibt nichts zum Herunterladen, nichts zum Quantisieren, nichts zum Ausführen. Wenn Sie ein Tutorial „Qwen 3.8 heute lokal ausführen“ sehen, das vor dem tatsächlichen Existieren der Gewichte datiert ist, schließen Sie den Tab. Zum Vergleich: Kimi K3 gab das gleiche Open-Weights-Versprechen beim Launch ab und lieferte 11 Tage später, die Zeitachse ist also plausibel. Es ist nur noch nicht passiert.
Der Self-Host-Realitätscheck
Selbst wenn die Gewichte veröffentlicht werden, benötigt „kostenlos“ einen Stern in der Größe eines Serverschranks. Qwen 3.8-Max hat insgesamt 2,4 Billionen Parameter. Der nächste Präzedenzfall ist Kimi K3: ein 2,8-Billionen-Parameter-Modell, das selbst bei aggressiver MXFP4-Quantisierung als 594 GB Gewichte ausgeliefert wurde. Wenn Sie das für Qwens 2,4 Billionen leicht herunterrechnen, sprechen wir immer noch von Hunderten von Gigabyte an Gewichten und einem Multi-GPU-, realistisch Multi-Node-Serving-Setup. Keine Consumer-GPU kann das halten. Keine einzelne Workstation kann das halten. Wir haben genau durchgesprochen, wie diese Hardwareklasse für das lokale Ausführen von Kimi K3 aussieht, und die wirtschaftlichen Aspekte gelten hier unverändert.
Was bringen Ihnen offene Gewichte also tatsächlich? Hauptsächlich dies: Sobald Gewichte öffentlich sind, können Drittanbieter das Modell hosten, und Wettbewerb drängt die gehosteten Preise tendenziell unter die Raten des Erstanbieters. Für die meisten Leser bedeutet „kostenlose offene Gewichte“ einen günstigeren API-Zugang über Hosting-Anbieter, nicht ein Modell, das auf Ihrem Laptop läuft. Das ist immer noch ein Gewinn. Es ist nur ein anderer Gewinn, als der Ausdruck vermuten lässt.
Fazit: noch nicht real. Schauen Sie Mitte August wieder vorbei und kalkulieren Sie Hosting ein, nicht Hardware.
Weg 4: die Ausweichlösung, wirklich kostenlose ältere Qwen-Modelle
Wenn Sie „ein fähiges Qwen-Modell zum Nulltarif“ benötigen, anstatt „speziell Qwen 3.8-Max“, bietet die vorherige Generation kostenlose Wege, die nicht nach 90 Tagen ablaufen. Kleinere Qwen-Modelle mit offenen Gewichten laufen bereits auf Hardware, die Leute tatsächlich besitzen, und die ältere Modellreihe hat ihre eigenen kostenlosen Zugangspfade. Wir führen einen separaten Leitfaden zum kostenlosen Verwenden von Qwen 3.7, der diese Optionen aktuell hält.
Der ehrliche Kompromiss: Sie verzichten auf die Benchmark-Gewinne, die 3.8-Max zu einer Neuigkeit machten. Für ein Nebenprojekt, einen Klassifikator oder zum Erlernen der Qwen API-Form, bevor Sie Geld ausgeben, sind die älteren Modelle oft ausreichend.
Was nicht real ist
Um Ihnen die Suche zu ersparen, hier ist, was mit Stand vom 3. August 2026 nicht existiert:
- Kein unbegrenzter kostenloser API-Tier. Das 1M-Token-Kontingent ist alles, und es läuft ab.
- Kein kostenloser Tier außerhalb Singapurs. Die Endpunkte Peking und US-Virginia berechnen ab dem ersten Token.
- Noch keine herunterladbaren Gewichte. „Nächste Woche“ ist ein Versprechen, kein Link.
- Kein offizielles kostenloses Qwen 3.8 bei Drittanbieter-Aggregatoren. Gehosteter Drittanbieterzugang wird voraussichtlich nach der Veröffentlichung der Gewichte verfügbar sein; alles davor, was behauptet, kostenloses 3.8-Max zu sein, verdient Skepsis darüber, welches Modell tatsächlich dahintersteckt.
FAQ
Ist die Qwen 3.8 API tatsächlich kostenlos?
Teilweise. Sie erhalten 1 Million kostenlose Token über Alibaba Cloud Model Studio, gültig für 90 Tage und nur in der Region Singapur. Danach beträgt der Preis 2 $ pro Million Eingabe-Token und 6 $ pro Million Ausgabe-Token, planen Sie Ihre Evaluierung also innerhalb des 90-Tage-Fensters.
Kann ich Qwen 3.8 derzeit lokal herunterladen und ausführen?
Nein. Die Gewichte sind für Hugging Face und ModelScope um den 10. August 2026 versprochen und wurden zum Zeitpunkt dieses Schreibens noch nicht ausgeliefert. Wenn sie verfügbar sind, planen Sie Hunderte von Gigabytes und Multi-GPU-Serving ein; dies ist ein Modell mit 2,4 Billionen Parametern, nichts, was ein Laptop ausführt.
Wie unterscheidet sich dies von Kimis K3 kostenlosen Optionen?
Kimi K3s Gewichte sind bereits live und herunterladbar, daher ist sein Self-Host-Weg heute real, während der von Qwen 3.8 noch aussteht. Beide sind jedoch viel zu groß für Consumer-Hardware. Unser Leitfaden zum kostenlosen Verwenden von Kimi K3 behandelt die Wege dieses Modells, wenn Sie vergleichen möchten.
Deckt das kostenlose Kontingent Denk-Token ab?
Ja, aber sie verbrauchen es. Reasoning-Ausgaben werden wie normale Ausgaben abgerechnet, und der Standardwert für reasoning_effort ist xhigh. Senken Sie ihn für Routineaufrufe, sonst verschwindet Ihr Kontingent in Chain-of-Thought, das Sie nie lesen.
Das Fazit
Der kostenlose Zugang zu Qwen 3.8 ist real, aber spezifisch: Qwen Chat für die gelegentliche Nutzung und 1 Mio. Token aus der Singapur-Region mit einer 90-Tage-Frist für Entwickler. Der Weg über offene Gewichte ist auf dem Papier nur noch Tage entfernt und wird in der Praxis hauptsächlich einen günstigeren gehosteten Zugang bedeuten. Alles darüber hinaus ist entweder ein älteres Modell oder Wunschdenken in Blogs.
Wenn Sie den API-Weg wählen, verwenden Sie Ihr Kontingent für Antworten, nicht für das Debugging. Prototypen Sie die Anfragen in Apidog, mocken Sie die Antworten während der Entwicklung und sparen Sie die Live-Token für die Evaluierungsläufe, die Ihnen tatsächlich sagen, ob Qwen 3.8-Max einen Platz in Ihrem Stack verdient.