
Die meisten Leute lernen ein neues Modell kennen, indem sie ein Chatfenster öffnen und darauf tippen. Jev bestraft diesen Reflex. Es ist TypeSafe AIs System-One-Modell, und es produziert überhaupt keine Prosa: Man übergibt ihm den Programmzustand plus eine Reihe typisierter Fragen, und es liefert Entscheidungen mit angehängten Wahrscheinlichkeiten zurück. Dieser Rollenwechsel ist die gesamte Technik. Ihr Sprachmodell schreibt weiter; Jev entscheidet, was als Nächstes passiert, und Ihr Code entscheidet, was mit der Entscheidung zu tun ist.
Dieser Leitfaden behandelt die Architektur rund um den Aufruf, nicht den Aufruf selbst. Wenn Sie zuerst die Grundlagen benötigen, beginnen Sie mit was Jev ist, und lesen Sie dann TypeSafes eigenen Einführungspost für die Unternehmensperspektive.
Worin Jev außergewöhnlich ist
Drei Primitive decken alles ab, was Jev tut. noul gibt die Wahrscheinlichkeit zurück, dass eine Aussage über den Zustand wahr ist. choice wählt eine Option aus einer Kriterienzuordnung (bis zu 255 Optionen) und gibt die Auswahl, die vollständige Wahrscheinlichkeitsverteilung und einen Konfidenzwert zurück. score platziert den Zustand auf einer geordneten Rubrik von 2 bis 10 Ebenen und gibt die Ebene, eine Legende, Wahrscheinlichkeiten und Konfidenz zurück. Der Hintergrund zum Unternehmen und zur Modellfamilie befindet sich in unserem Artikel über TypeSafe AI.
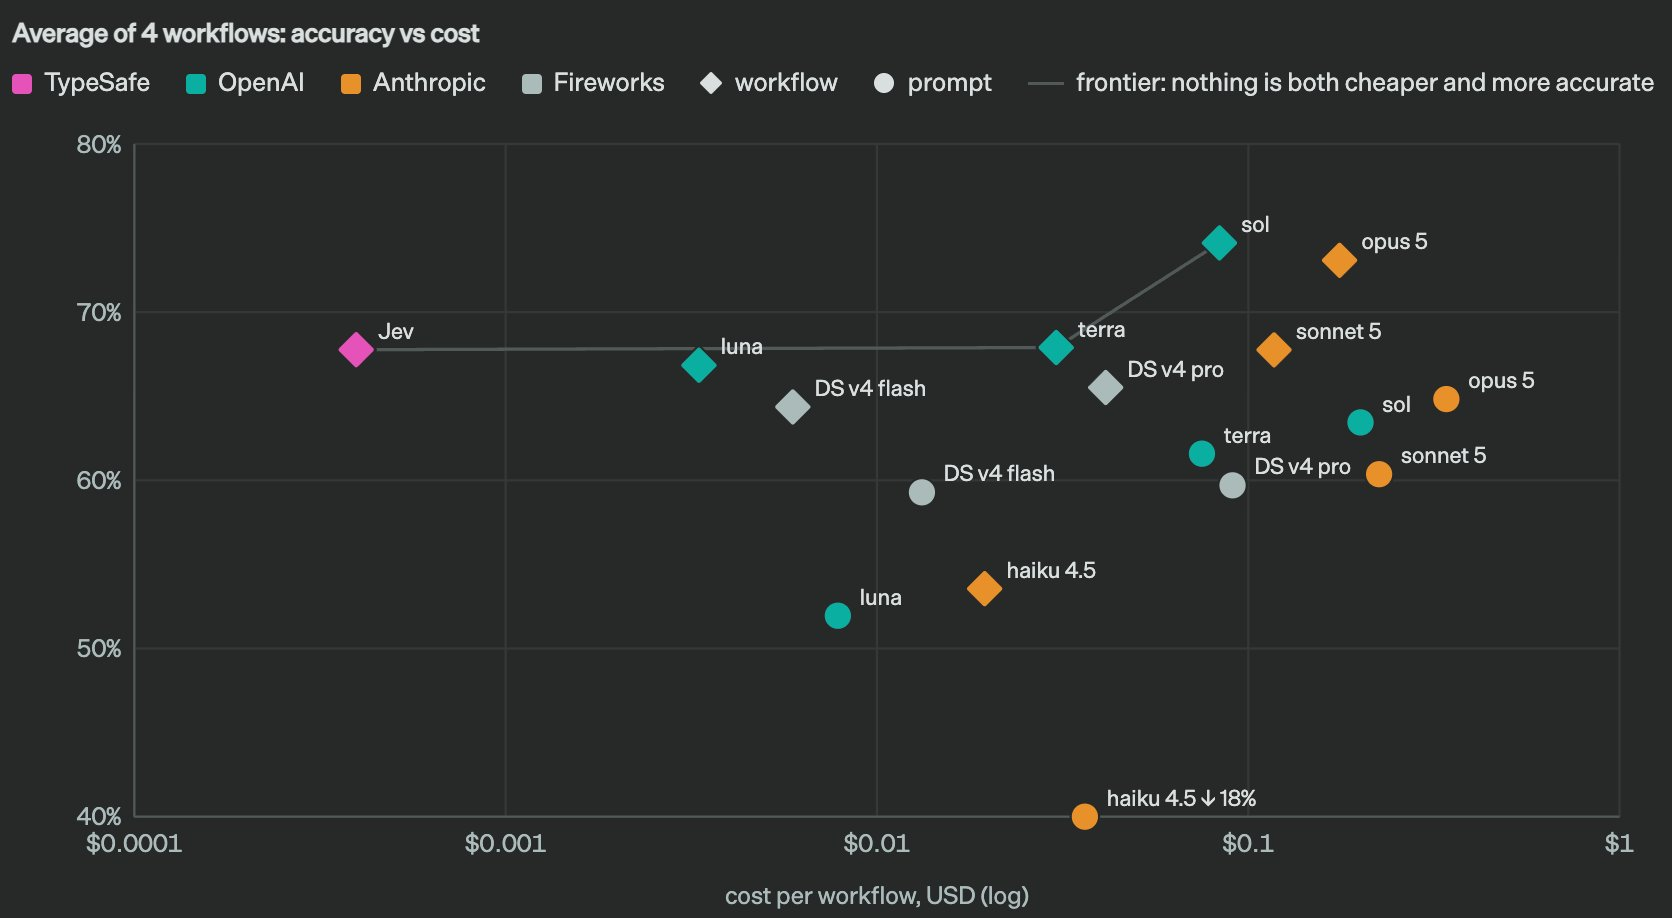
Vier Eigenschaften sind für die Architektur wichtig. Jede Antwort kommt in einem Typ an, den Ihr Programm bereits versteht. Jede Antwort birgt ihre eigene Unsicherheit, sodass „nicht sicher“ zu einer Verzweigung statt zu einer Überraschung wird. Viele Fragen zu einem Zustand werden in einem einzigen Durchlauf gelöst. Und bei 0,042 $ pro Million Input-Token, wobei Output-Token nicht berechnet werden, können Sie es sich leisten, bei jedem Ereignis zu fragen, anstatt nur bei einer Stichprobe.
Jev als Richter, nicht als Schreiber ausführen
Vier Rollen, sauber getrennt:
- Das LLM generiert. Code, einen E-Mail-Entwurf, eine Zusammenfassung, einen Plan.
- Jev entscheidet. Es klassifiziert die Anfrage, bewertet das Risiko, wählt die Route und prüft die Ausgabe anhand von Kriterien, die Sie im Voraus festgelegt haben.
- Ihr Code steuert. Schwellenwerte und Regeln entscheiden, ob gehandelt, wiederholt, eskaliert oder gestoppt werden soll.
- Ein Mensch fängt die Grenzfälle ab. Geringes Vertrauen plus hohe Einsätze gehen an eine Person.
Deshalb funktioniert die Aufteilung. Ein Sprachmodell ist flexibel, weil es alles ausgeben kann, und dieselbe Freiheit macht es unbequem, es in einen Workflow einzubetten, von dem Sie abhängen. TypeSafes Ansatz ist, dass Jev „die String-Generierung aufgibt“ und im Gegenzug einen engen Vertrag erhält: Der Satz möglicher Antworten ist festgelegt, bevor die Anfrage Ihren Server verlässt, jedes Ergebnis passt zur deklarierten Form, und Unsicherheit ist eine Zahl, die Sie mit einem Schwellenwert vergleichen können.
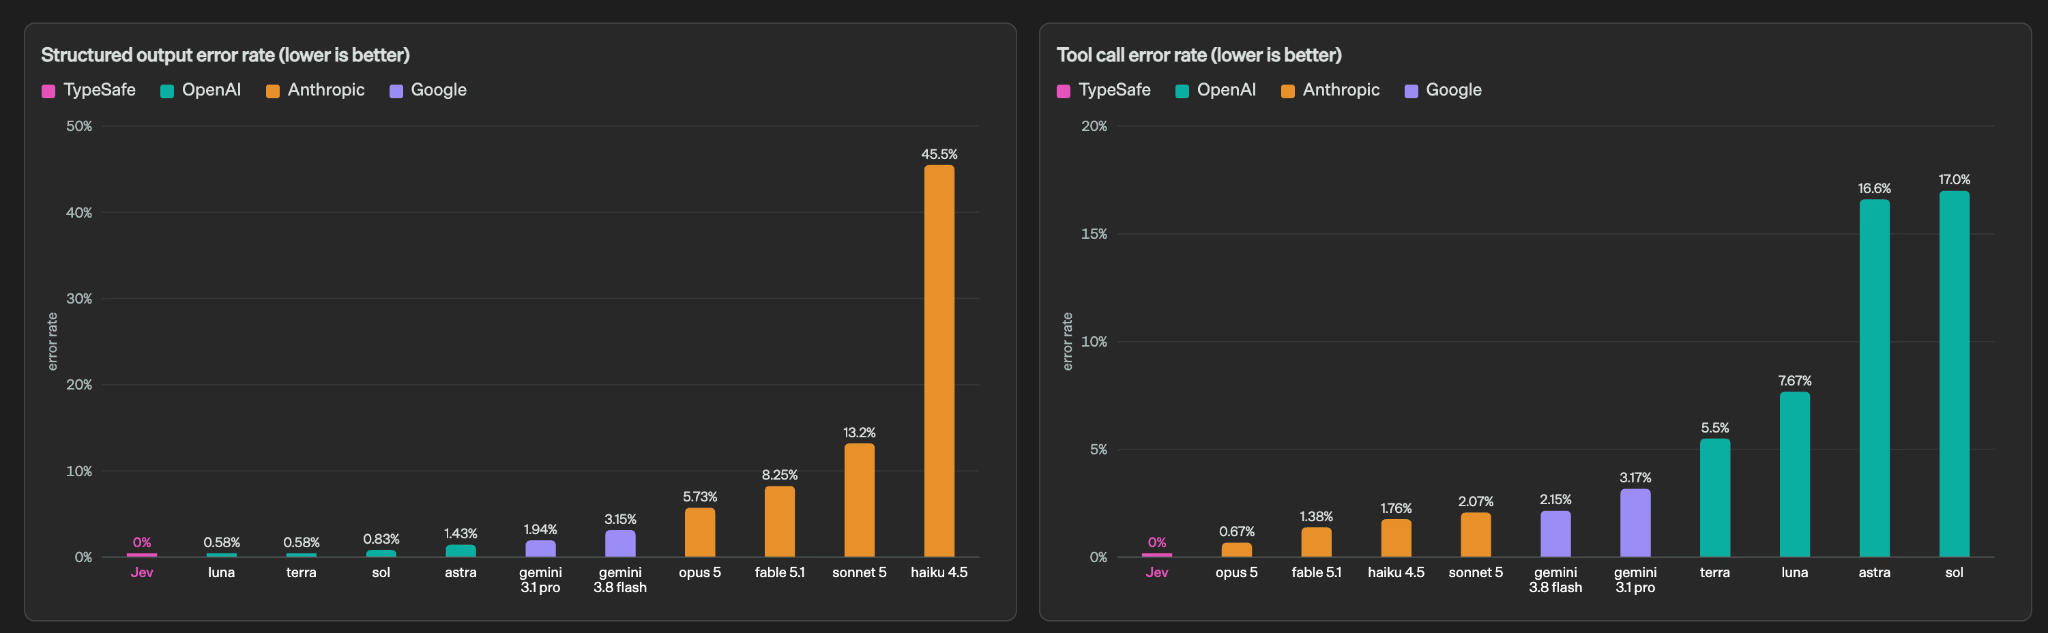
Die Kostenseite ergibt sich aus dem gleichen Kompromiss. TypeSafe berichtet von End-to-End-Antwortzeiten von 70 ms bis 500 ms und beansprucht Zahlen von 193,6x schneller und 444,6x billiger bei den getesteten Workflows. Betrachten Sie diese als Herstellerangaben, nicht als unabhängige Benchmarks. Der strukturelle Punkt bleibt so oder so bestehen: Das teure Modell läuft nur, wenn wirklich etwas geschrieben werden muss, und die wiederholten Beurteilungen darum herum laufen irgendwo günstig.
Fragen entwerfen, die Jev beantworten kann
Jede Anfrage enthält einen gemeinsamen state und eine Reihe unabhängiger Fragen. Jev liest den Zustand einmal und beantwortet alle Fragen. Ein Support-Triage-Anruf sieht so aus:
{
  "model": "jev-latest",
  "state": {
    "message": "I've been trying to connect Stripe for three days. I'm losing sales and I need this fixed today.",
    "plan": "Pro",
    "account_age_months": 14,
    "recent_technical_tickets": 3
  },
  "questions": {
    "department": {
      "type": "choice",
      "instruction": "Which team should own this ticket?",
      "criteria": {
        "billing": "Payments, charges, invoices, subscription changes",
        "technical": "Bugs, broken behavior, failing integrations",
        "sales": "Pricing, plans, questions asked before purchase"
      }
    },
    "frustration": {
      "type": "score",
      "instruction": "How frustrated is this customer?",
      "criteria": [
        "Calm and matter of fact",
        "Frustrated but civil",
        "Extremely frustrated or threatening to leave"
      ]
    },
    "urgent": {
      "type": "noul",
      "instruction": "The customer needs a resolution today."
    }
  }
}
Drei Gewohnheiten unterscheiden funktionierende Fragen von wackeligen Fragen.
Hören Sie auf, Prompts zu schreiben. Personas, ausgearbeitete Beispiele und lange Präambeln steuern einen Textgenerator. Jev generiert keinen Text. Es benötigt den Zustand, eine atomare Frage und eine genaue Beschreibung dessen, was jede Antwort bedeutet. Deskriptive Kriterien sind besser als bloße Labels: „Zahlungen, Gebühren, Rechnungen, Abonnementänderungen“ leitet besser als das Wort „Abrechnung“ allein. Bitten Sie es auch nicht, sich zu erklären, denn die Antwort enthält eine Entscheidung, Wahrscheinlichkeiten und Konfidenz, und sonst nichts.
Eine Frage, ein Urteil. „Ist dieser Lead wertvoll, dringend und wahrscheinlich kaufbereit?“ sind drei Fragen in einem Trenchcoat. Teilen Sie sie auf und kombinieren Sie die Ergebnisse im Code, wo Sie die Gewichtungen sehen und ändern können.
Halten Sie die Arithmetik aus dem Modell fern. Jev beurteilt die Bedeutung. Ihr Programm führt die Berechnungen durch, wendet die Rabattabelle an und prüft die Vertragsbedingungen. Diese Aufteilung macht das Ganze auditierbar.
TypeSafe liefert auch eine Drop-in-Fähigkeit mit, die Coding-Agenten diese Konventionen beibringt, installierbar in Claude Code mit claude plugin marketplace add typesafe-ai/skills oder anderswo mit npx skills add typesafe-ai/skills. Die Agenten-Fähigkeiten-Seite enthält die Details.
Den Zustand sauber halten
Relevanter Zustand ist besser als maximaler Zustand. Drei Abschnitte decken ihn normalerweise ab: das zu beurteilende Objekt, der Kontext, der zum Lesen dieses Objekts benötigt wird, und die Fakten, die die Entscheidung ändern würden, wenn sie sich ändern. Alles andere ist Rauschen, für dessen Versand Sie bezahlen.
Entfernen Sie duplizierte Protokollzeilen, Verläufe, die vor dem aktuellen Problem liegen, und jeden Satz, der die Schlussfolgerung angibt, die das Modell erreichen soll. Die harte Obergrenze beträgt 64k Tokens pro Anfrage, wobei 32k für den Zustand plus die längste Frage verfügbar sind, aber die Genauigkeit kann sich deutlich verschieben, bevor Sie diese Grenze erreichen. Wenn das Routing ungenau wird, ist das Verkleinern des Zustands normalerweise eine schnellere Lösung als das Umschreiben von Kriterien.
Parallele Fragen und Konfidenz-Gates
Da Jev den Zustand einmal liest, kostet die dreizehnte Frage weit weniger als ein zweiter Hin- und Rückweg. Senden Sie jede unabhängige Beurteilung, die eine Aktion ändern könnte: Absicht, Risiko, Dringlichkeit, Stimmung, Relevanz, erforderlicher nächster Schritt. Schneiden Sie dann jede Frage weg, deren Antwort niemals ändert, was Ihr Code tut. Ein ungenutztes Signal ist ein Wartungsaufwand ohne Nutzen.
Passen Sie das Primitive an die Form der Beurteilung an. Abstufungen wie Schweregrad, Qualität und Passung gehören in score, nicht in ein erzwungenes Ja/Nein. Eine einzelne Tatsachenaussage gehört in noul. Eine feste Menge an Zielen gehört in choice.
Das Gate ist der Ort, an dem die Architektur tatsächlich lebt. Eine typisierte Antwort kann immer noch eine falsche Antwort sein, daher entscheidet die Konfidenz, was als Nächstes passiert. Ein praktikables Ausgangsmuster: automatisch handeln bei Werten über 0,85, Werte von 0,55 bis 0,85 an ein stärkeres Modell oder einen zweiten Durchlauf übergeben, und alles unter 0,55 für eine Person in die Warteschlange stellen. Diese genauen Zahlen sind illustrativ. TypeSafes Konfidenz-Routing-Muster legt einen separaten Schwellenwert pro Aktion fest, basierend auf den Kosten eines Fehlers, und seine Konfidenzseite sagt Ihnen: „Testen Sie mit Ihren eigenen Daten und passen Sie an, während Sie Ergebnisse beobachten.“ Sobald Ihre Schwellenwerte abgestimmt sind, pinnen Sie das Modell fest: jev-latest folgt der neuesten stabilen Version, während jev-1.13.0 das von Ihnen gemessene Verhalten einfriert.
Die Entscheidungsebene in Apidog testen
Eine Entscheidungsebene ist nur dann vertrauenswürdig, wenn Sie ihr Verhalten nachweisen können. Das bedeutet gespeicherte Anfragen und Assertionen, nicht eine Terminalhistorie von einmaligen Curls. Apidog bietet Ihnen beides, und die Assertionen sehen anders aus als bei normalen API-Tests, da Sie Zahlen und Enum-Werte anstelle von Zeichenketten prüfen.
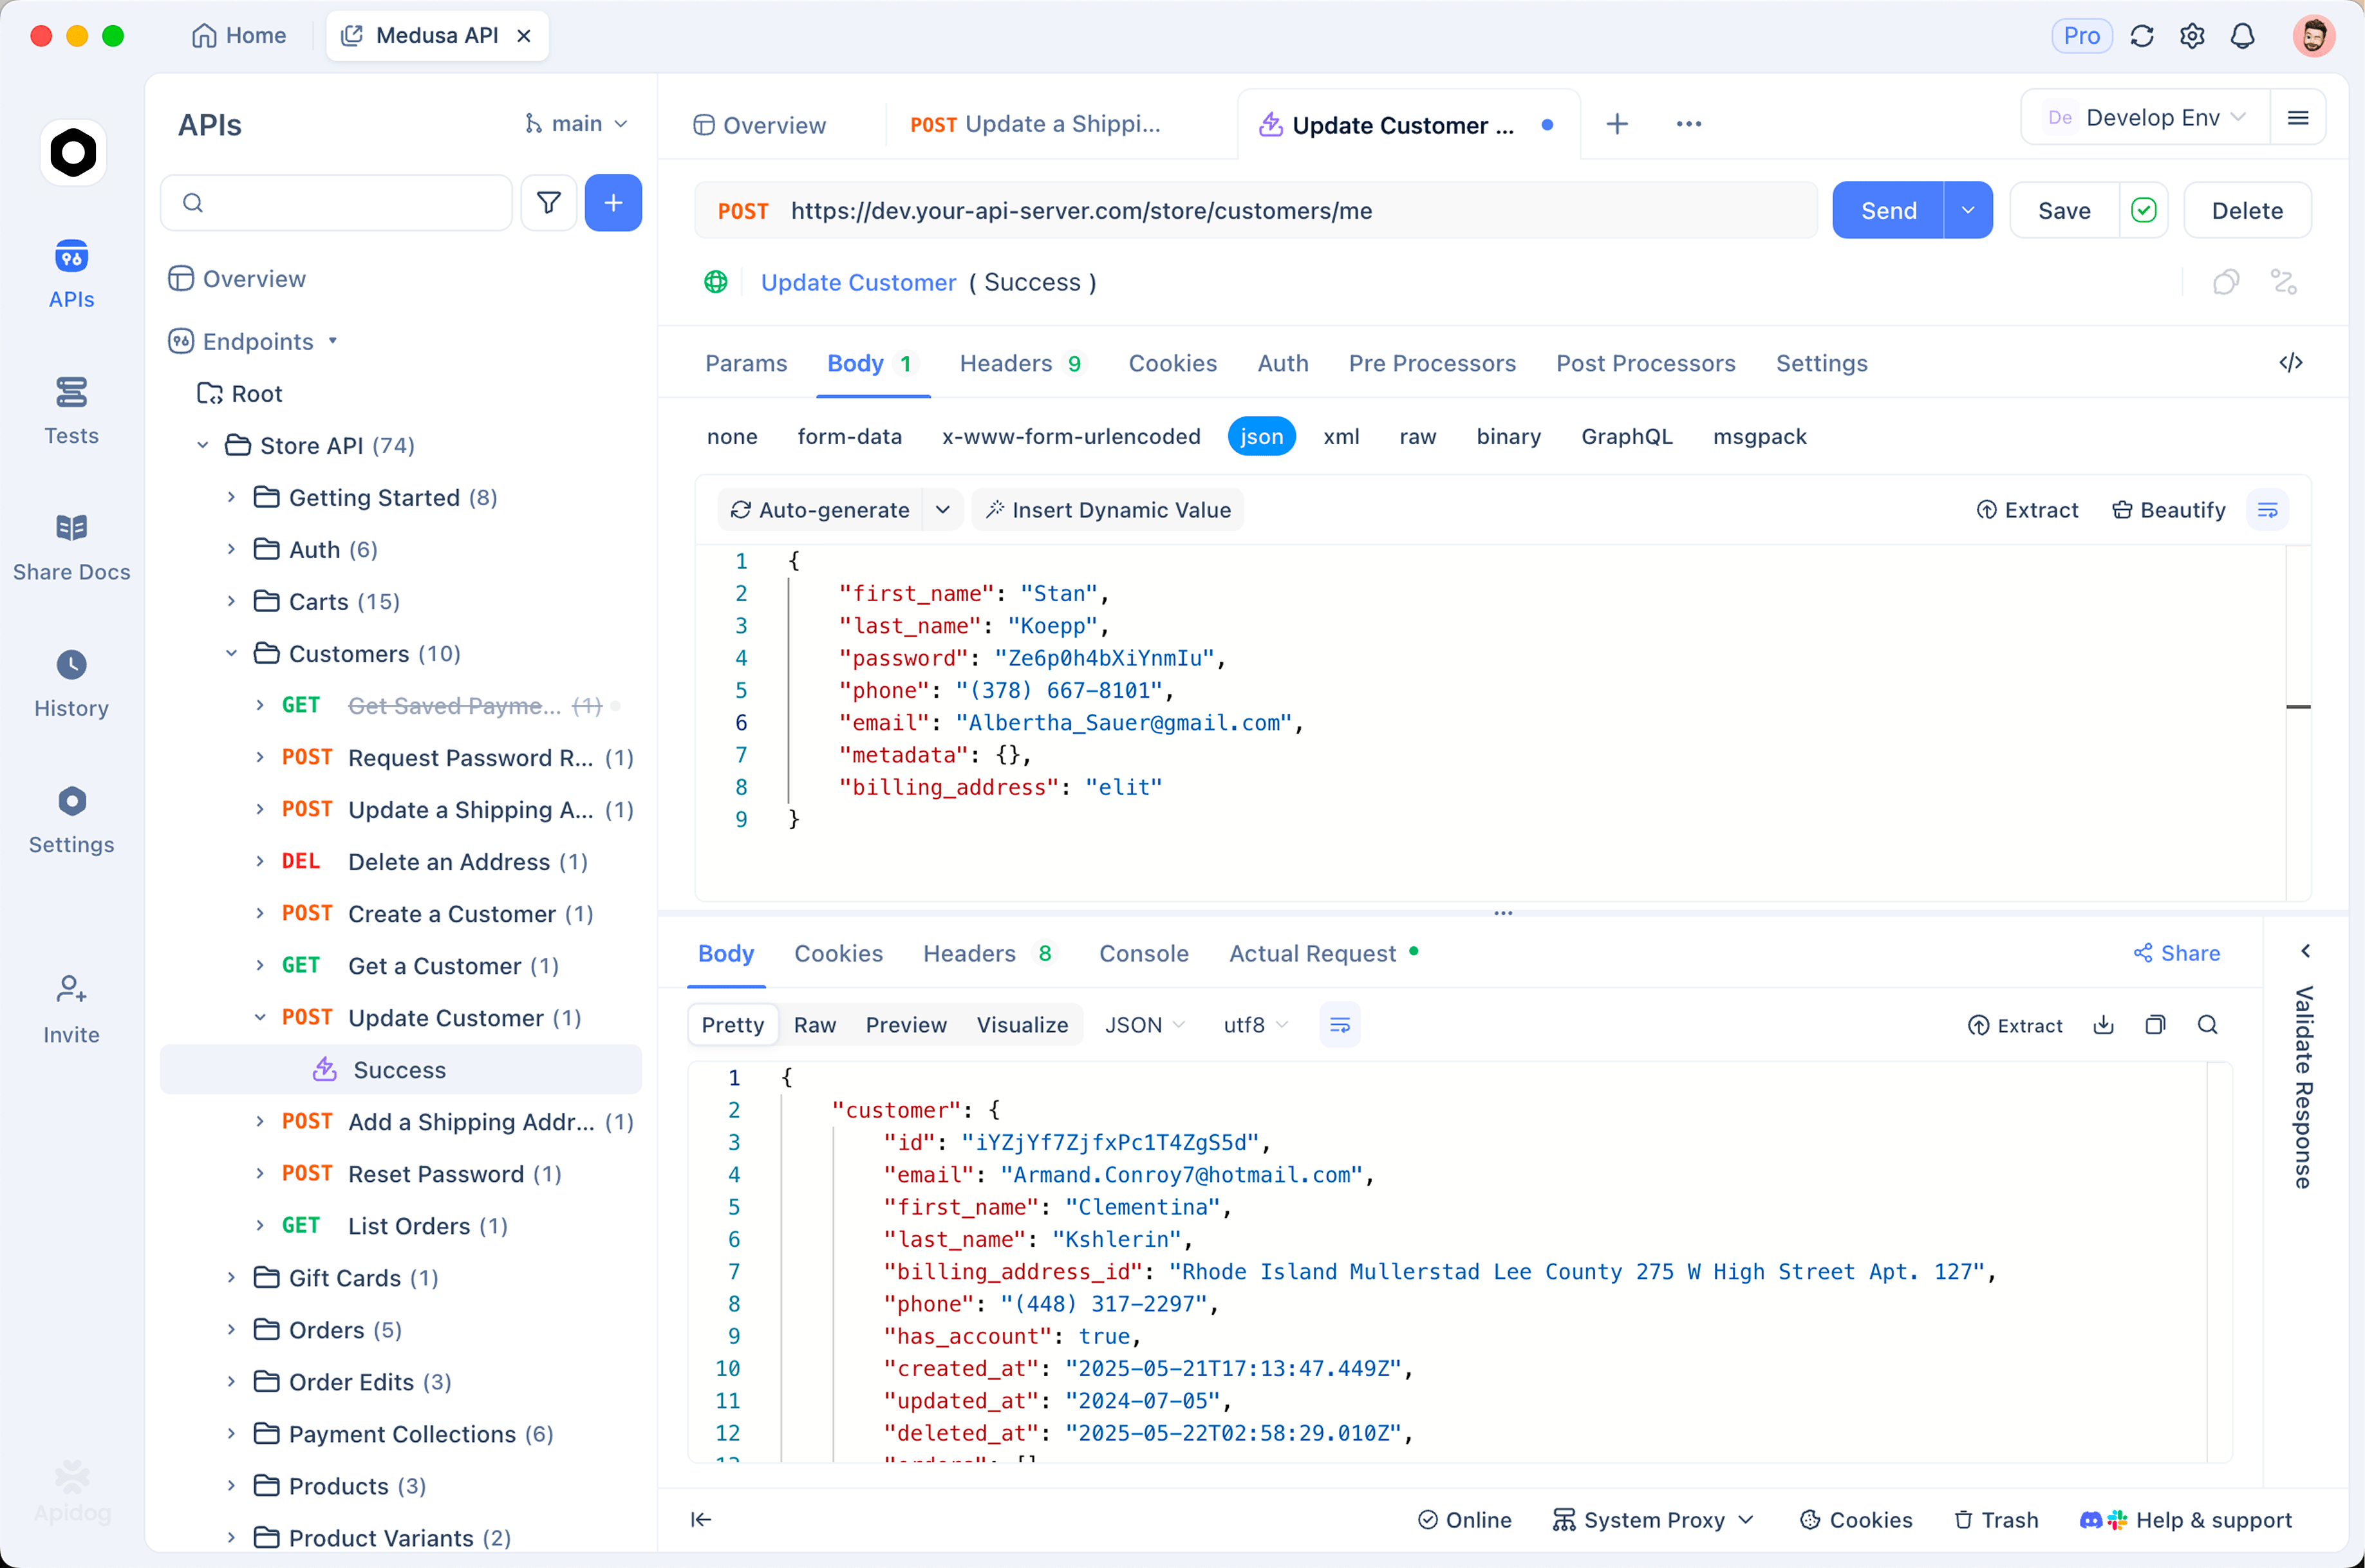
Speichern Sie den Schlüssel als Umgebungsvariable. Erstellen Sie eine Umgebung namens TypeSafe, fügen Sie TYPESAFE_API_KEY als lokalen Wert hinzu, damit er auf Ihrem Rechner bleibt, und referenzieren Sie ihn als {{TYPESAFE_API_KEY}} in einem Bearer-Token. Unser Leitfaden zu Umgebungen und geheimen Variablen behandelt die Gültigkeitsbereiche.
Senden Sie den eigentlichen Aufruf. POST https://api.typesafe.ai/v1/systemone mit dem oben genannten Body für Zustand plus Fragen.
Prüfen Sie die Entscheidung. Fügen Sie Post-Processor-Assertions hinzu, wie z.B. answers.department.choice gleich billing, answers.urgent.noul größer als 0.9 und answers.frustration.score größer als 1.5. Nun lässt eine Verhaltensänderung einen Test fehlschlagen, anstatt Tickets stillschweigend falsch weiterzuleiten.
Erstellen Sie dann das Szenario, das zählt. Speichern Sie einen kleinen Satz von beschrifteten Zuständen als Testszenario: eine ruhige Frage, eine wütende Kündigungsdrohung und eine absichtlich mehrdeutige Nachricht, bei der ein guter Router zögern sollte. Bestehen Sie auf hoher Konfidenz bei den ersten beiden und bestehen Sie darauf, dass die Konfidenz bei der dritten unter Ihr Gate fällt. Dieses einzelne Szenario macht die Schwellenwert-Anpassung zu einem Beweis statt zu einem Rätselraten, und es fängt den Fehler ab, der am schwersten von Hand zu bemerken ist: Jemand formuliert eine Kriterienbeschreibung um, jede Antwort ist immer noch gültig, und das Routing verschiebt sich stillschweigend. Führen Sie es in CI aus, und die Umformulierung lässt den Build fehlschlagen.
Mocken Sie die Antwortstruktur, damit die Frontend-Arbeit keine Tokens verbrennt. Da das answers-Objekt vor der Anfrage deklariert wird, können Mock und Live-Antwort nicht auseinanderdriften. Laden Sie Apidog herunter, um dies einzurichten; der kostenlose Plan deckt ein Team von vier Personen ab.
Fünf Workflows, bei denen sich eine Entscheidungsebene auszahlt
- Der universelle Verifizierer. Umwickeln Sie jeden teuren LLM-Aufruf. Prüfen Sie den eingehenden Prompt auf Injektion, das ausgewählte Tool auf offensichtliche Nichtübereinstimmungen, die Ausgabe auf fehlende Anforderungen und die endgültige Antwort auf Behauptungen, die das Ausgangsmaterial nicht stützen. Günstige Prüfungen um ein teures Gehirn herum.
- Der Support-Kontrollturm. Klassifizieren Sie das Ticket, erkennen Sie Dringlichkeit, Frustration, Rückerstattungsabsicht und Kündigungsrisiko in einem Anruf und leiten Sie es dann weiter. Der Vorteil sind weniger Tickets in der falschen Warteschlange und weniger wertvolle Konten, die brachliegen.
- Lead-Qualifizierung. Bewerten Sie die Unternehmenspassung, technische Reife, geäußerten Schmerz, Kaufabsicht und Dringlichkeit als separate Signale und kombinieren Sie sie dann mit Gewichtungen, die Sie besitzen und in einer Pipeline-Überprüfung verteidigen können.
- Der Modell-Router. Entscheiden Sie pro Anfrage, ob deterministischer Code, ein kleines Modell, ein Frontier-Modell oder ein Mensch die Anfrage bearbeiten soll. Hier zeigen sich die Kosteneinsparungen meistens zuerst.
- Jobs mit großen Datensätzen. Führen Sie dieselben semantischen Beurteilungen über Support-Logs, Bewertungen, Listings, Transkripte oder Agenten-Traces aus, um strukturierte Merkmale zu extrahieren und die Datensätze zu ranken, die einen menschlichen Blick wert sind. Eine Analyse, die erst dann praktisch wird, wenn jede Entscheidung schnell und nahezu kostenlos ist.
FAQ
- Brauche ich immer noch ein Sprachmodell? Ja. Jev kann die Antwort, die Zusammenfassung oder den Code nicht schreiben. Es entscheidet, welches System dies tun soll, und es kann den Entwurf danach anhand expliziter Kriterien bewerten, wie z.B. die Einhaltung von Richtlinien oder ob die Antwort ein Versprechen enthält, das Sie nicht geben.
- Worin unterscheidet sich dies vom JSON-Modus oder strukturierten Ausgaben? Strukturierte Ausgaben beschränken die Formatierung eines Textmodells; das Modell generiert immer noch Tokens und kann immer noch etwas Falsches in einer gültigen Form behaupten. Jev gibt eine Wahrscheinlichkeitsverteilung über eine Reihe von Antworten zurück, die Sie definiert haben, sodass die Unsicherheit ein erstklassiges Feld ist. Unser Erklärungsartikel zu OpenAI Structured Outputs behandelt die andere Seite dieses Vergleichs.
- Wie erhalte ich Zugang? Jev befindet sich im Early Access mit einer Warteliste, ist also noch nicht selbstbedienbar. TypeSafe nimmt Entwickler stapelweise von der Liste, und Sie melden sich unter console.typesafe.ai an, sobald Sie dabei sind. Es ist auch über Vercel AI Gateway als
typesafe-ai/jevviaexperimental_evaluateim AI SDK 7 verfügbar, welches nur SDK ist und nicht über die OpenAI-kompatiblen Endpunkte zugänglich gemacht wird. Unser Walkthrough zu dem Erhalt eines Jev API-Schlüssels enthält die Anforderungs- und SDK-Details. - Kann ich so etwas lokal ausführen? Mehrere Projekte reproduzieren Teile der Idee mit eingeschränkter Dekodierung über offene Gewichte. Wir haben sie in OpenJev und den Open-Source-Jev-Alternativen verglichen, einschließlich der Treue zur kalibrierten Konfidenz.
Wohin Sie das bringt
Jev ist nicht das Modell, das Ihre anderen Modelle ersetzt. Es ist die Schicht, die entscheidet, wann, wo und ob sie ausgeführt werden. Bauen Sie es so auf: ein sauberer Zustand, atomare Fragen mit expliziten Kriterien, parallele Auswertung und ein Konfidenz-Gate vor jeder Aktion. Dann beweisen Sie, dass das Gate funktioniert, mit einem gespeicherten Szenario in Apidog, bevor es ein einziges echtes Ticket weiterleitet.