
Um Firecrawl Local zu nutzen, installierst du es mit cargo install firecrawl-local, führst firecrawl-local init aus, um es als MCP-Server in Claude Code und Cursor zu registrieren, und startest anschließend beide Tools neu. Dein Agent kann jetzt Websites auf deinem eigenen Rechner scrapen, crawlen und kartieren. Für Code führst du firecrawl-local serve aus und richtest jedes Firecrawl-SDK auf http://localhost:3002 aus.
Diese Anleitung zeigt Schritt für Schritt, wie du Firecrawl Local verwendest – mit der echten Ausgabe unseres Testlaufs vom 19. November 2026 (Firecrawl Local 0.1.0 auf einem arm64-Mac), den Prompts für deinen Agenten und einer Möglichkeit, die lokale API vom Agenten mit der Apidog CLI testen zu lassen.
Was du vor dem Start brauchst
Firecrawl Local ist ein einzelnes Rust-Binary aus dem Firecrawl-Repository. Prüfe vor der Installation, ob du Folgendes hast:
- Rust und einen C-Compiler. Rust bekommst du von rustup.rs. Unter macOS führst du
xcode-select --installaus; unter Debian oder Ubuntu installierst dubuild-essential. - Node.js 22 oder neuer, falls du den MCP-Server nutzen möchtest. Er startet das npm-Paket
firecrawl-mcpübernpx. - Chrome oder Chromium (optional). Firecrawl Local nutzt den bereits vorhandenen Browser für Seiten, die JavaScript benötigen. Statische Seiten funktionieren auch ohne.
- Claude Code, Cursor oder einen anderen MCP-Client.
initkennt außerdem Claude Desktop, Windsurf, Gemini CLI und Codex.
Wenn du mit Firecrawl selbst noch nicht vertraut bist, beginne mit unserem Firecrawl-Web-Scraping-Leitfaden und komm dann zurück.
Schritt 1: Firecrawl Local installieren
Installiere das Crate von crates.io und prüfe die Version:
cargo install firecrawl-local
firecrawl-local --version
# firecrawl-local 0.1.0
Cargo kompiliert es aus dem Quellcode. Auf unserem Mac war der Release-Build nach 6 Minuten 54 Sekunden fertig, und das Binary landete in ~/.cargo/bin/firecrawl-local. Stelle sicher, dass dieser Ordner in deinem PATH liegt, oder merke dir den vollständigen Pfad: Du brauchst ihn für die manuelle MCP-Einrichtung.
Schritt 2: Deinen ersten Scrape im Terminal ausführen
Bevor du irgendetwas in einen Agenten einbindest, prüfe, ob das Abrufen funktioniert:
FIRECRAWL_CLOUD=off firecrawl-local scrape https://example.com --markdown
Es gab den Haupttext der Seite innerhalb von 1,2 Sekunden als Markdown aus. Lässt du --markdown weg, erhältst du das gleiche JSON, das die Firecrawl-API zurückgibt. Mit --format markdown,links wählst du Formate aus; lokal stehen markdown, html, rawHtml und links zur Verfügung.
Als Nächstes ein Crawl, der pro Seite eine Markdown-Datei schreibt:
FIRECRAWL_CLOUD=off firecrawl-local crawl https://docs.firecrawl.dev --limit 20 --out ./pages
Dieser Abruf holte 20 Seiten der Firecrawl-Dokumentation in 4,4 Sekunden und speicherte Dateien mit Namen wie 0005-docs.firecrawl.dev_advanced-scraping-guide.md. Nützliche Crawl-Flags aus firecrawl-local crawl --help:
| Flag | Funktion |
|---|---|
-l, --limit |
Maximale Seitenzahl (Standard 100) |
--max-depth |
Wie viele Linkebenen tief gefolgt wird |
--include, --exclude |
Pfad-Regex zum Behalten oder Überspringen, mehrfach angebbar |
--entire-domain |
Links außerhalb des Startpfads folgen |
-c, --concurrency |
Anzahl gleichzeitig abgerufener Seiten |
--ignore-robots |
robots.txt ignorieren (wird standardmäßig gelesen) |
firecrawl-local map https://firecrawl.dev liefert jede URL zurück, die es in den Sitemaps und auf der Startseite findet – als eine JSON-Zeile.
Schritt 3: Firecrawl Local mit init zu Claude Code und Cursor hinzufügen
init findet die KI-Tools auf deinem Rechner und fügt Firecrawl Local zu jeder MCP-Konfiguration hinzu. Zeig dir das zuerst als Vorschau an:
firecrawl-local init --dry-run
Auf unserem Mac listete es jedes Tool auf, das es anfassen würde:
Firecrawl MCP server:
  Claude Code: would be added in ~/.claude.json
  Claude desktop: would be added in ~/Library/Application Support/Claude/claude_desktop_config.json
  Cursor: would be added in ~/.cursor/mcp.json
  Gemini CLI: would be added in ~/.gemini/settings.json
  Codex: would be added in ~/.codex/config.toml
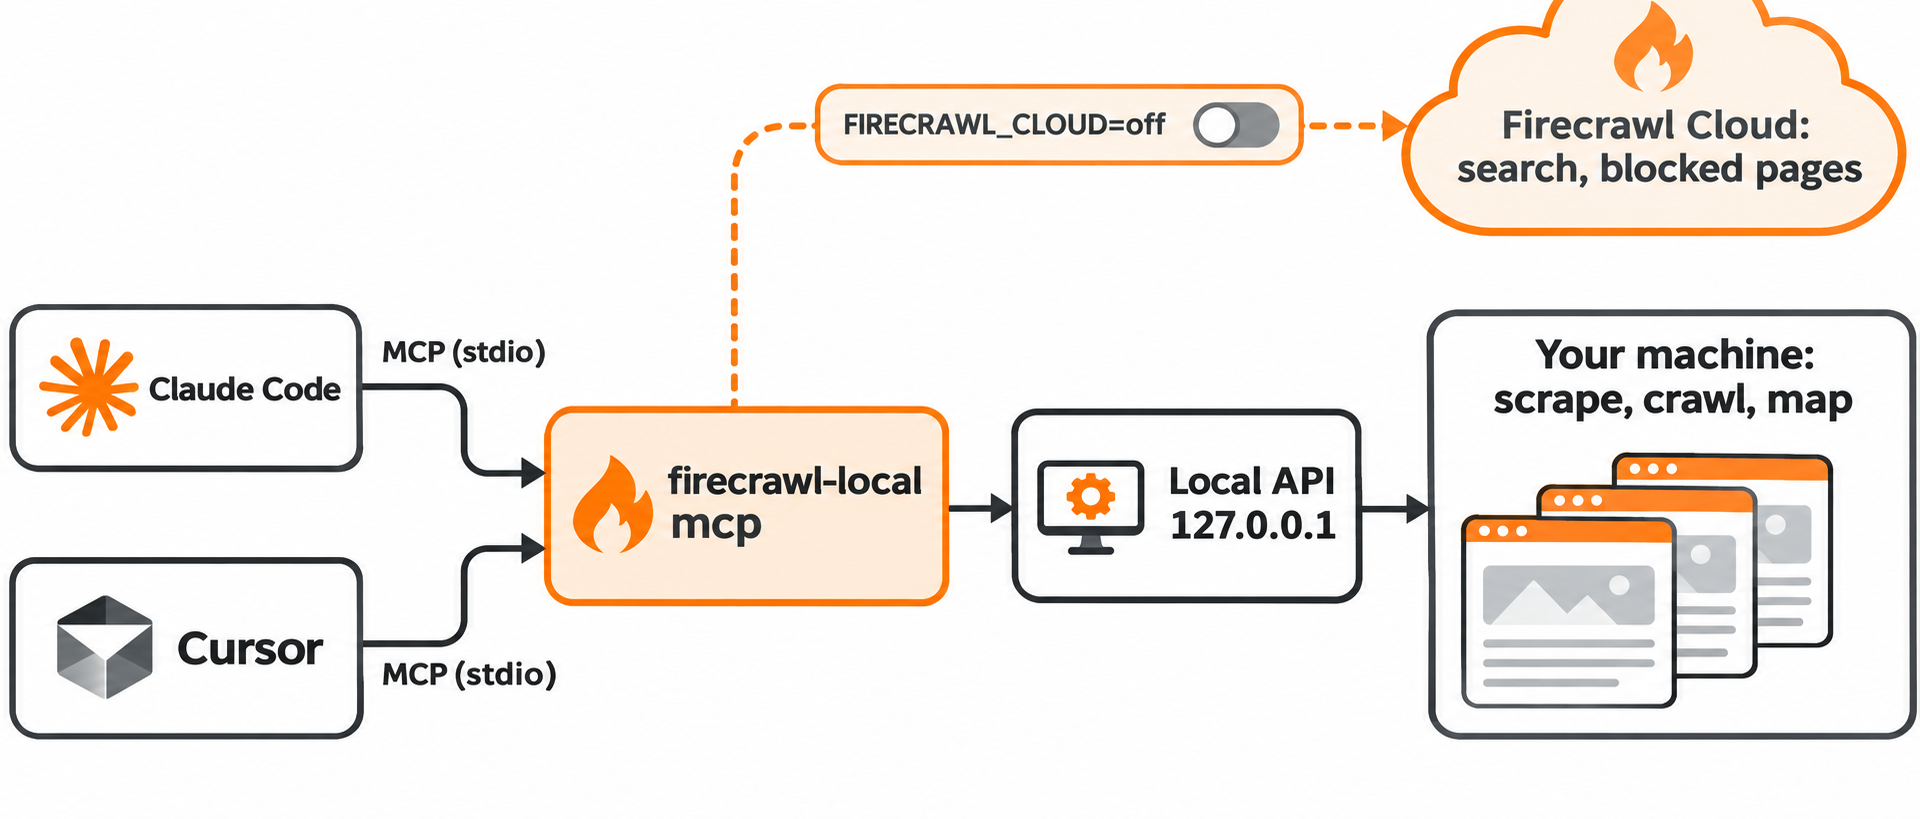
Der Dry Run zeigt außerdem, was an Firecrawl Cloud geht: Suchanfragen, die URL einer Seite, die deinen Rechner blockiert hat, Alexandria-Aufrufe nach dem Login sowie eine zufällige Installations-ID und der Name deines KI-Tools. Seiten, die lokal problemlos laden, werden nie gesendet.
Wenn du nur die beiden in dieser Anleitung behandelten Tools einrichten möchtest, wiederholst du --agent:
firecrawl-local init --agent claude-code --agent cursor
Die gültigen Bezeichnungen sind claude-code, claude-desktop, cursor, windsurf, gemini und codex. init legt vor dem Schreiben eine Sicherungskopie jeder Konfigurationsdatei an. Starte Claude Code und Cursor danach neu, damit sie den neuen Server laden.
Firecrawl Local in Claude Code manuell einrichten
Wenn du keine Konfigurationsdateien von einem Tool bearbeiten lassen möchtest, füge den stdio-Server selbst mit dem Claude-Code-MCP-Befehl hinzu:
claude mcp add firecrawl -e FIRECRAWL_CLOUD=off -- ~/.cargo/bin/firecrawl-local mcp --public-only
Führe in Claude Code /mcp aus, um zu bestätigen, dass der Server verbunden ist.
Firecrawl Local in Cursor manuell einrichten
Cursor liest MCP-Server aus ~/.cursor/mcp.json (global) oder .cursor/mcp.json (projektbezogen). Verwende den vollständigen Pfad zum Binary:
{
  "mcpServers": {
    "firecrawl": {
      "command": "/Users/you/.cargo/bin/firecrawl-local",
      "args": ["mcp", "--public-only"],
      "env": { "FIRECRAWL_CLOUD": "off" }
    }
  }
}
--public-only sorgt dafür, dass der Server localhost- und private Netzwerkadressen ablehnt. Lass es eingeschaltet, wenn dein Agent Seiten liest, denen du nicht vertraust: Versteckte Anweisungen auf einer Seite könnten den Agenten sonst in Richtung einer internen URL lenken.
Schritt 4: Prompts für deinen Agenten
firecrawl-local mcp startet die lokale API auf einem Loopback-Port und führt das Paket firecrawl-mcp dagegen aus. Dein Agent sieht die standardmäßigen Firecrawl-MCP-Tools; Scrape, Crawl, Map und Batch Scrape laufen auf deinem Rechner. Wenn du den gehosteten Firecrawl-MCP-Server verwendet hast, sind die Tool-Namen identisch.
Prompts, die gut zu den lokalen Tools passen:
Map https://docs.example.com, then crawl only the /api/ pages (limit 40)
and write a summary of every endpoint into docs/vendor-api.md.
Scrape the changelog at https://example.com/changelog as markdown and list
every breaking change from the last three releases.
Batch scrape these five pricing pages and build a comparison table of
plan names and limits. Quote only what the pages say.
Verzichte auf Prompts, die eine Suche erfordern: Mit FIRECRAWL_CLOUD=off führt dieses Tool nirgendwohin. Für ein vollständig lokales Such-Setup sieh dir unseren Leitfaden zur Open-Source-Websuche für Claude an.
Schritt 5: Die Firecrawl-Local-API starten und dein SDK darauf ausrichten
Für Skripte und Pipelines startest du den API-Server:
FIRECRAWL_CLOUD=off firecrawl-local serve
Er lauscht auf 127.0.0.1:3002. Der Health-Check antwortet sofort:
curl -s localhost:3002/health
# {"status":"ok","engine":"firecrawl-local","version":"0.1.0"}
Ein Scrape liefert die gewohnte v2-Struktur mit zwei lokalen Markern: "engine": "local-fetch" und "source": "local", sowie creditsUsed: 0.
curl -s localhost:3002/v2/scrape -H 'content-type: application/json' \
  -d '{"url":"https://example.com","formats":["markdown","links"]}'
Richte die Firecrawl-SDKs ohne API-Schlüssel darauf aus. Python:
from firecrawl import Firecrawl

app = Firecrawl(api_url="http://localhost:3002")
print(app.scrape("https://example.com").markdown)
Node:
import { Firecrawl } from "firecrawl";

const app = new Firecrawl({ apiUrl: "http://localhost:3002" });
const doc = await app.scrape("https://example.com");
console.log(doc.markdown);
init schlägt außerdem eine Abkürzung vor: Setze FIRECRAWL_API_URL=http://127.0.0.1:3002, und dein bestehender Firecrawl-Code läuft lokal. Die Firecrawl CLI teilt ihren gespeicherten Login mit Firecrawl Local, sodass das login des einen Tools für beide funktioniert.
Crawls laufen asynchron. POST /v2/crawl gab sofort eine Job-ID zurück, und GET /v2/crawl/{id} meldete wenige Sekunden später status: completed, total: 10, creditsUsed: 0 und expiresInSeconds: 3587. Jobs leben im Speicher, verfallen eine Stunde nach ihrem Start und verschwinden, wenn serve stoppt – speichere Ergebnisse also, sobald ein Crawl abgeschlossen ist.
Der Serverprozess belegte im Leerlauf etwa 10 MB residenten Speicher und direkt nach diesem Crawl über 10 Seiten 43 MB, gemessen mit ps. Firecrawls Launch-Post behauptet 37x schneller und 230x weniger Speicher als selbst gehostetes Firecrawl; die README veröffentlicht keine Methodik, behandle diese Zahlen also als Firecrawl-Angaben.
Firecrawl Local mit FIRECRAWL_CLOUD vollständig lokal halten
Standardmäßig (auto) gehen drei Dinge an Firecrawl Cloud: Suchen, Seiten, die deinen Rechner blockieren, und Alexandria-Datenanbieter (die ein kostenloses Konto über firecrawl-local login erfordern). FIRECRAWL_CLOUD steuert die Übergabe:
| Wert | Wirkung |
|---|---|
auto (Standard) |
Suche, Fallback für blockierte Seiten und Alexandria funktionieren alle |
search |
Nur Suchen geht an Firecrawl Cloud |
off |
Nichts geht an Firecrawl Cloud |
Ein nicht erkannter Wert wird als off behandelt. Bei deaktivierter Cloud antwortet POST /v2/search mit "code":"CLOUD_ONLY" und einer Meldung, die dich auffordert, FIRECRAWL_API_KEY oder FIRECRAWL_CLOUD=auto zu setzen. Eine Seite, die die Cloud für dich abgerufen hat, trägt "source": "firecrawl-cloud", sodass du immer erkennen kannst, woher ein Ergebnis stammt.
serve lehnt localhost- und private Ziele ab, es sei denn, du übergibst --allow-private, und das Binden an einen nicht-Loopback---host erfordert --token. Cloud-Metadaten und Link-Local-Adressen werden in jedem Modus blockiert.
Lass deinen Coding-Agenten die Firecrawl-Local-API mit der Apidog CLI testen
Der Crawl-Endpunkt ist am ehesten geeignet, eine Pipeline zu brechen: Er ist asynchron, der Job verfällt, und ein gestoppter Server verliert ihn. Statt manuell zu pollen, lässt du deinen Coding-Agenten einen Test mit Apidog CLI erstellen und ausführen.
Einmal einrichten:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Dann gibst du Claude Code oder Cursor einen Prompt:
firecrawl-local serve is running on http://localhost:3002. In Apidog project <id>,
import an OpenAPI file for POST /v2/scrape, POST /v2/crawl and GET /v2/crawl/{id},
create an environment for that base URL, and build a test scenario that starts a
crawl of https://docs.firecrawl.dev with limit 10, saves the returned id, polls
GET /v2/crawl/{id} until status is "completed", and asserts total equals completed
and every page has non-empty markdown. Run it and summarize any failures.
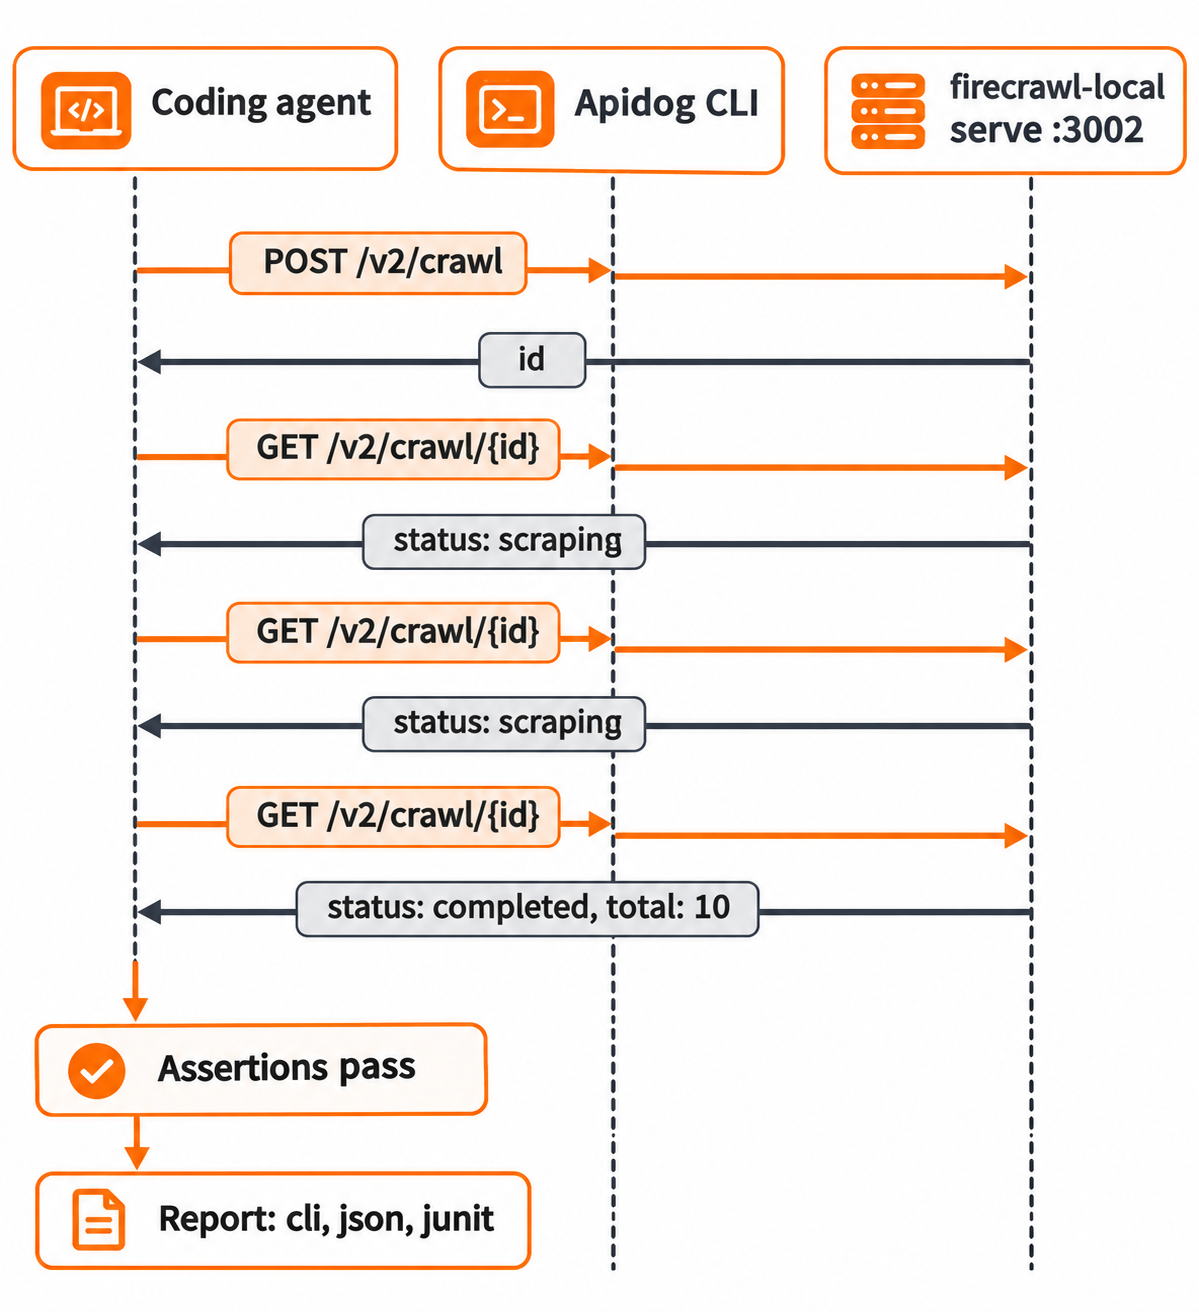
Der Agent liest jedes Payload-Schema, validiert es und führt Befehle wie diese aus, alle aus apidog <cmd> --help in CLI 2.2.12 übernommen:
apidog import --project <id> --format openapi --file ./firecrawl-local-v2.yaml
apidog environment create firecrawl-local --project <id> --base-url http://localhost:3002
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <id> --file ./scenario.json
apidog run -t <scenarioId> --project <id> -e <envId> -r cli,json
Apidog CLI sendet Anfragen von deinem Rechner, sodass localhost:3002 erreichbar ist. Wechsle zu -r junit, um denselben Lauf in deine CI einzubinden; unsere Leitfäden zu Apidog CLI in Claude Code und Apidog CLI in Cursor behandeln die Agenten-Seite. Der Free-Plan von Apidog deckt Teams mit bis zu 4 Nutzern ab.
Fehlerbehebung bei Firecrawl Local
| Symptom | Lösung |
|---|---|
404 mit NOT_FOUND auf /v1/scrape |
Es wird nur v2 bereitgestellt; stelle deinen Client auf /v2/... um |
CLOUD_ONLY auf /v2/search |
Erwartet bei FIRECRAWL_CLOUD=off; verwende auto oder search |
| Agent listet keine Firecrawl-Tools auf | Starte das Tool nach init neu; prüfe Node.js 22+ |
| JavaScript-Seite kommt spärlich zurück | Installiere Chrome oder setze --browser always |
json- oder summary-Format fehlt |
Lokal nicht unterstützt; du erhältst stattdessen eine Warnung |
| Crawl-ID nicht gefunden | Der Job ist nach einer Stunde abgelaufen oder serve wurde neu gestartet |
FAQ
Ist Firecrawl Local kostenlos? Lokales Scrapen, Crawlen und Kartieren sendet nichts an Firecrawl und verbrauchte in unseren Tests 0 Credits. Der Code steht unter AGPL-3.0, die SDKs unter MIT. Suche und Alexandria laufen über Firecrawl Cloud.
Brauche ich einen API-Schlüssel für Firecrawl Local? Nein, nicht für lokale Routen. Du benötigst einen Schlüssel – über firecrawl-local login oder FIRECRAWL_API_KEY – nur für Alexandria-Datenanbieter.
Funktioniert Firecrawl Local mit Windsurf, Codex und Gemini CLI? Ja. init kennt windsurf, codex und gemini ebenso wie Claude Code, Claude Desktop und Cursor.
Kann mein bestehender Firecrawl-Code unverändert dagegen laufen? Für v2 Scrape, Map, Crawl und Batch Scrape ja: Ändere die API-URL auf http://localhost:3002. v0- und v1-Routen werden nicht bereitgestellt, und Browser-actions werden ignoriert.
Respektiert Firecrawl Local robots.txt? Ja. Es liest beim Crawlen robots.txt und identifiziert sich im User-Agent, sodass Seiteninhaber es als FirecrawlLocal ansprechen können. --ignore-robots schaltet das ab; verwende es nur auf Websites, die dir gehören.