DeepSeek veröffentlichte die DeepSeek-V4.1-Flash-Gewichte am 10. September 2026 unter einer MIT-Lizenz auf Hugging Face, am selben Tag, an dem das Modell auf der API allgemein verfügbar wurde. Das ist ein ungewöhnlicher Zeitpunkt. Die meisten Labore veröffentlichen zuerst den gehosteten Endpunkt und erst Wochen später – wenn überhaupt – die Gewichte.
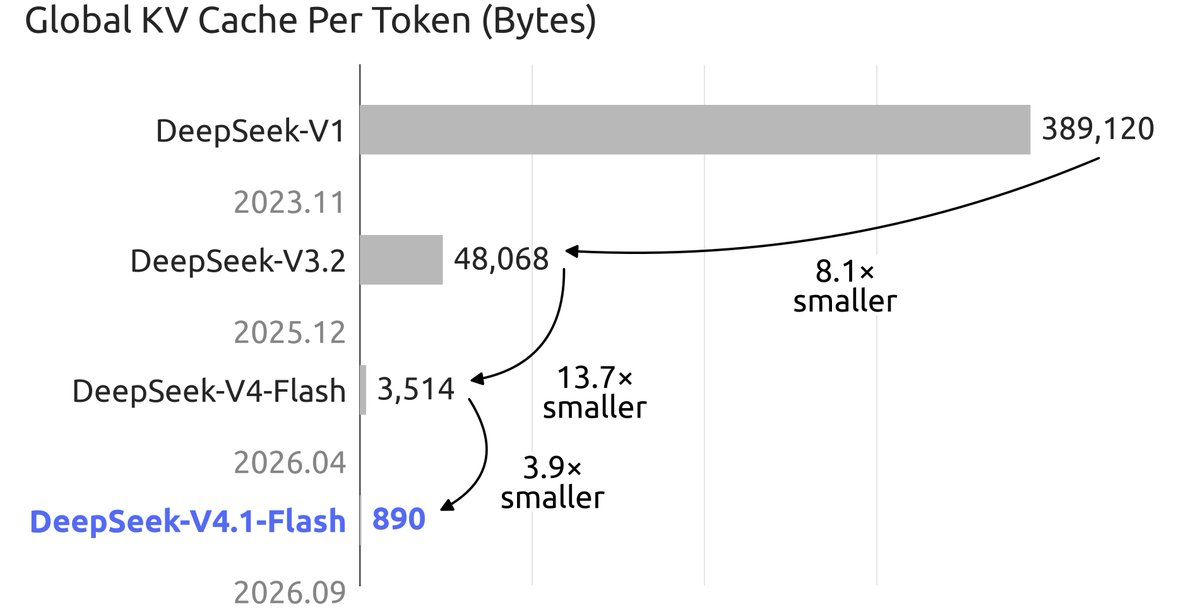
Die Schlagzeilenzahl wird die meisten Leser abschrecken: 552 Milliarden Parameter im Backbone, 763 Milliarden mit dem Vision-Encoder. Aber das darunterliegende Design ist selbst-hosting-freundlicher, als die Größe vermuten lässt. Nur 8 Milliarden Parameter sind während des Prefills aktiv und 16 Milliarden während des Decodes, und der neue FP4-KV-Cache kostet 890 Byte pro Token, ungefähr ein Viertel dessen, was V4-Flash benötigte. Rechenleistung ist günstig. Speicher ist das Hindernis.
Die Leute werden es trotzdem versuchen. Dieser Leitfaden bietet Ihnen die Speichermathe, die realistischen Pfade für jede Hardware-Stufe, die generischen Setup-Befehle und eine Möglichkeit, einen lokalen OpenAI-kompatiblen Endpunkt gegen die gehostete API in Apidog zu testen. Wenn Sie zuerst einen Modellüberblick wünschen, lesen Sie Was ist DeepSeek-V4.1-Flash? und kommen Sie dann zurück.
TL;DR
- Gewichte: 552B MoE-Backbone, MIT-Lizenz. Etwa 552 GB bei 8-Bit, etwa 280 GB bei 4-Bit, nur Backbone.
- KV-Cache: 890 Byte pro Token. Ein vollständiger 1M-Token-Kontext benötigt etwa 0,9 GB. Dieser Teil ist gelöst.
- Realistisches 4-Bit-Serving erfordert 4 bis 8 GPUs der 80-GB-Klasse. Alles darunter ist CPU- oder SSD-Offload und langsam.
- Die gehostete API berechnet $0,15 pro 1M Cache-Miss-Eingabetokens außerhalb der Spitzenzeiten. Für die meisten Teams übertrifft das allein die Stromrechnung.
Was Sie herunterladen
Die Modellkarte beschreibt einen 552B-Parameter Mixture-of-Experts-Backbone mit einem neuen kausalen Encoder-Decoder-Layout: 40 Schichten, aufgeteilt in 20 Encoder und 20 Decoder. Jede Schicht leitet über 384 Experten plus 1 gemeinsam genutzten Experten. Der DeepSeek-ViT-Vision-Encoder erhöht den vollständigen Checkpoint auf 763B Parameter, und Sie laden das Ganze herunter, selbst wenn Sie nur Text benötigen.
Drei Details sind für die lokale Inferenz wichtig:
- Aktive Parameter sind klein. 8B aktiv während des Prefills, 16B während des Decodes. Pro-Token-FLOPs sehen aus wie ein mittelgroßes dichtes Modell. Das Problem ist, dass jeder der 552B Parameter irgendwo leben muss, wo der Forward-Pass ihn erreichen kann.
- Der KV-Cache ist FP4. Die Release-Note besagt, dass der Cache 1/4 des HBM- und 1/8 des SSD-Speichers der vorherigen Generation nutzt. Bei 890 Byte pro Token ist ein langer Kontext kein Speicherproblem mehr, wie es früher der Fall war.
- Attention ist von Natur aus dünn besetzt. Compressed Sparse Attention 2 mit drei statischen Modi wurde mit 64K Kontext trainiert und spät im 45T-Token-Durchlauf auf 1M erweitert. Deshalb bleiben die KV-Zahlen bei 1M klein.
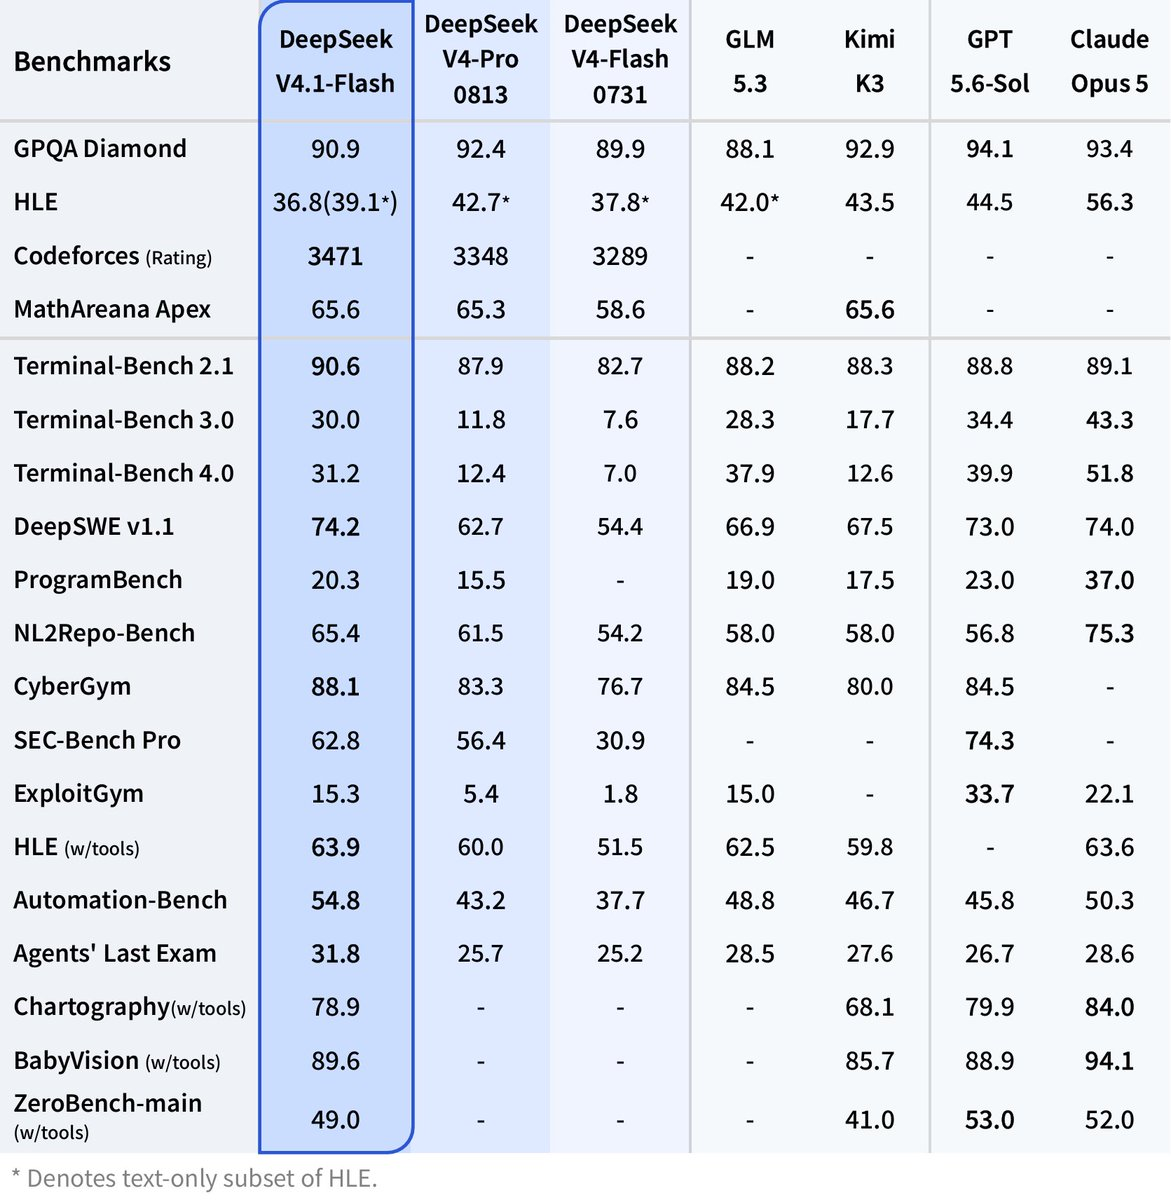
Der Tech-Report behandelt die Architektur vollständig. Jede Benchmark-Angabe auf der Karte wird von DeepSeek gemeldet; behandeln Sie sie als Behauptungen.
Die Speicherberechnung
Die folgenden Zahlen sind reine Multiplikationen, keine Messungen, und sie schließen Engine-Overhead, Aktivierungen und den Vision-Encoder aus.
| Komponente | Größe | Berechnung |
|---|---|---|
| Backbone-Gewichte, 8-Bit | ~552 GB | 552B Parameter x 1 Byte |
| Backbone-Gewichte, 4-Bit | ~280 GB | 552B Parameter x 0,5 Byte |
| KV-Cache, pro Token | 890 Byte | Von der Modellkarte |
| KV-Cache bei 128K Kontext | ~0.11 GB | 890 x 128.000 |
| KV-Cache bei 1M Kontext | ~0.89 GB | 890 x 1.000.000 |
Zwei Dinge fallen auf. Erstens ist der KV-Cache ein Rundungsfehler. Eine 1M-Token-Sitzung passt in weniger als ein Gigabyte, sodass Sie Dutzende von langen Sitzungen resident halten können, ohne das Gewichtsbudget zu beeinflussen. Zweitens sind die Gewichte das gesamte Problem. Keine Quantisierungstrickerei lässt 552B Parameter auf eine einzige Consumer-GPU passen, und das 8B-aktive Design hilft nicht, da das MoE-Routing immer noch jeden Experten geladen und adressierbar benötigt.
Das ist auch der Grund, warum offloaded Setups unausgewogen wirken. Prefill verarbeitet Batches über den gesamten Prompt und bleibt rechenleistungsgebunden. Decode paginiert 16B aktive Parameter für jedes Token aus dem RAM oder der SSD ein. Die Bandbreite, nicht die FLOPs, bestimmt Ihre Tokens pro Sekunde.
Realistische Hardware-Stufen
Hier gibt es keine Durchsatzangaben. Niemand außerhalb von DeepSeek hatte die Gewichte lange genug, um vertrauenswürdige Benchmarks zu veröffentlichen.
Stufe 1: Multi-GPU-Server, 4 bis 8 Karten der 80-GB-Klasse. Vier 80-GB-Karten ergeben 320 GB, genug für 4-Bit-Gewichte mit einem geringen Spielraum für KV-Cache und Engine-Overhead. Acht Karten ergeben 640 GB, genug für den 8-Bit-Checkpoint oder eine komfortable 4-Bit-Bereitstellung mit großen Batches. Dies ist die einzige Stufe, bei der „lokal ausführen“ produktionsreifes Serving mit Tensorparallelismus bedeutet, und es ist ein Kauf im fünf- oder sechsstelligen Bereich oder eine Cloud-Miete von mehreren Dollar pro Stunde.
Stufe 2: Einzelner Arbeitsplatzrechner mit viel Speicher und CPU-Offload. Ein Rechner mit 512 GB oder mehr System-RAM und ein oder zwei GPUs kann die 4-Bit-Gewichte im RAM halten und Experten-Schichten bei Bedarf auf die GPU streamen. Das funktioniert, ist aber langsam, weil die Decode-Bandbreite Ihr DDR5-Bus anstelle von HBM ist. Verwenden Sie es für Batch-Jobs und nächtliche Evaluierungen, nicht für interaktiven Chat.
Stufe 3: Apple Silicon mit SSD-Streaming. Der Weg für Hobbyisten. Ein 512-GB-Mac Studio hält die 4-Bit-Gewichte im Unified Memory, was eine echte Option ist, wenn Sie bereits einen besitzen. Darunter befinden Sie sich im Kimi K3 HN-Thread-Territorium: Gewichte, die über externe SSDs verteilt sind, wobei mmap die schwere Arbeit leistet, und ungefähr 1 Token pro Sekunde. Es beweist, dass das Modell läuft, aber nicht, dass es auf dieser Maschine nützlich ist. Unser Leitfaden zum lokalen Ausführen von Kimi K3 behandelt die gleichen Kompromisse bei einem größeren Modell, und wie man DeepSeek V4 lokal ausführt behandelt die vorherige Generation.
Der Einrichtungspfad
Mit der installierten Hardware ist der Ablauf: herunterladen, hinter einem OpenAI-kompatiblen Endpunkt bereitstellen, testen.
pip3 install -U "huggingface_hub[cli]"
huggingface-cli download deepseek-ai/DeepSeek-V4.1-Flash \
  --local-dir ./models/deepseek-v4.1-flash \
  --max-workers 8
Auf einer 1-Gbit/s-Leitung dauert jede 100 GB bei voller Geschwindigkeit ungefähr 15 Minuten. Planen Sie eine Stunde oder mehr ein.
Das Serving ist der Haken. Day-0-Unterstützung in vLLM, SGLang, llama.cpp und Ollama für die CED-Architektur und CSA2-Attention ist [ÜBERPRÜFEN]; ein neuer Schichttyp benötigt normalerweise einen Engine-Patch, bevor die Gewichte geladen werden, und die Release-Note nennt keine spezifischen Engines. Suchen Sie in den Changelogs jedes Projekts nach „DeepSeek-V4.1“, bevor Sie sich zum Download verpflichten. Sobald Unterstützung vorhanden ist, sieht das Serving mit vLLM über 8 GPUs so aus:
vllm serve ./models/deepseek-v4.1-flash \
  --tensor-parallel-size 8 \
  --max-model-len 131072 \
  --served-model-name deepseek-flash \
  --port 8000
Ein llama.cpp llama-server oder ein Ollama-Modell stellt denselben http://localhost:8000/v1-Endpunkt bereit, sobald eine GGUF-Konvertierung existiert, sodass jeder OpenAI SDK-Client durch Ändern einer Zeile funktioniert:
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="local")

response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "user", "content": "Summarize this incident report and list the three root causes."}],
    temperature=1.0,
    top_p=0.95,
)
print(response.choices[0].message.content)
Die Werte temperature=1.0 und top_p=0.95 entsprechen den empfohlenen Einstellungen der Modellkarte. Für Ollama behandelt unser Ollama-Leitfaden den Modelfile-Flow, und der vLLM-Leitfaden behandelt Multi-GPU-Flags ausführlich.
Die pragmatische Alternative: die gehostete API
Außerhalb der Spitzenzeiten listet die Preisseite deepseek-flash mit $0,15 pro 1M Cache-Miss-Eingabetokens, $0,003 pro 1M Cache-Hit-Eingabetokens und $0,60 pro 1M Ausgabetokens auf. Spitzenzeiten verdoppeln diese Preise. Eine Milliarde Eingabetokens plus 200 Millionen Ausgabetokens pro Monat kosten also außerhalb der Spitzenzeiten etwa $270 und in Spitzenzeiten $540, bevor Cache-Hits die Eingabeseite weiter reduzieren. Ein 8-GPU-Server der 80-GB-Klasse kostet unter Dauerlast allein mehr pro Monat an Strom und Kühlung, bevor Sie die Hardware amortisieren oder jemanden bezahlen, der sie betreut. Sofern Sie keine Datenresidenzregel oder bereits ungenutzte Hardware haben, gewinnt die API bei den Kosten. Die Umstellung ist eine einzige base_url-Änderung; unser DeepSeek-V4.1-Flash API-Leitfaden erklärt dies.
Lokal gewinnt, wenn die Einschränkung nicht Geld ist: Air-Gapped-Umgebungen, Prompt-Daten, die Sie nirgendwohin senden können, oder Forschung, die eine Modifikation der Gewichte erfordert.
Testen Sie einen lokalen Endpunkt gegen die gehostete API in Apidog
Welchen Weg Sie auch wählen, stellen Sie sicher, dass sich der lokale Server wie die Referenz verhält, bevor Sie Traffic darauf leiten. Quantisierungsdrift, eine falsche Chat-Vorlage oder ein fehlendes Stopp-Token zeigen sich alle als subtile Ausgabeunterschiede. Hier ist der Workflow in Apidog:
- Erstellen Sie zwei Umgebungen. Eine mit dem Namen
local, wobeibase_urlaufhttp://localhost:8000/v1gesetzt ist, und eine mit dem Namenhosted, wobeibase_urlaufhttps://api.deepseek.comund Ihr echter Schlüssel gesetzt ist. Jede Anfrage verwendet{{base_url}}/chat/completionsundBearer {{api_key}}. - Speichern Sie einen kleinen Prompt-Satz als Anfragen. Fünf bis zehn Prompts, die Ihre Arbeitslast repräsentieren: eine JSON-Extraktion, eine Code-Korrektur, eine Zusammenfassung mit langem Kontext. Setzen Sie
modelin allen aufdeepseek-flash; es funktioniert auf beiden Servern. - Fügen Sie Assertions hinzu. Für die JSON-Aufgabe überprüfen Sie, ob die Antwort korrekt geparst wird und ein erforderlicher Schlüssel vorhanden ist. Für jede Anfrage überprüfen Sie, ob
finish_reasongleichstopist, was eine Kürzung durch eine schlechte Kontexteinstellung abfängt. - Führen Sie den Satz für beide Umgebungen aus. Wechseln Sie im Umgebungs-Dropdown von
hostedzulocalund wiederholen Sie dasselbe Testszenario. Ein Fehler, der nur beilocalauftritt, ist Ihr Quantisierungs- oder Vorlagenproblem, das mit einem Klick isoliert wird. - Beobachten Sie das Streaming. Setzen Sie
stream: trueund verwenden Sie die SSE-Ansicht, um Ereignisse einzeln eintreffen zu sehen. Ein lokaler Server, der die gesamte Antwort puffert, bevor er sie sendet, sieht bei einem Nicht-Streaming-Aufruf in Ordnung aus, ist aber hier falsch. - In CI integrieren. Führen Sie das Szenario mit
apidog-clibei jedem Engine-Upgrade aus, sodass eine fehlerhafte Chat-Vorlage eine Pipeline zum Fehlschlag bringt, anstatt einen Benutzer.
Laden Sie Apidog herunter und der gesamte Ablauf erfolgt aus einem Projekt.
FAQ
Kann ich DeepSeek-V4.1-Flash auf einem Laptop ausführen? Nicht sinnvoll. Das 4-Bit-Backbone ist etwa 280 GB groß. Ein Laptop kann es wie das Kimi K3-Experiment von SSD streamen, mit etwa 1 Token pro Sekunde, was eine Demo, aber kein Workflow ist. Verwenden Sie die API oder eine der Optionen in wie man DeepSeek-V4.1-Flash kostenlos nutzt.
Bedeuten 8B aktive Parameter, dass ich nur 8 GB VRAM benötige? Nein. Aktive Parameter bestimmen die Rechenleistung pro Token, nicht den Speicher. Das MoE-Routing kann für jedes Token jeden der 384 Experten pro Schicht auswählen, daher müssen alle 552B Parameter geladen und erreichbar sein.
Wie viel Speicher benötigt der 1M-Kontext? Etwa 0,89 GB KV-Cache bei 890 Byte pro Token. Das ist der günstige Teil dieses Modells. Die Gewichte sind der teure Teil.
Ist die Lizenz für die kommerzielle Nutzung sicher? Ja. Die Gewichte stehen unter MIT-Lizenz, laut der Hugging Face-Modellkarte.
Was das für Sie bedeutet
DeepSeek-V4.1-Flash ist in einer rechtlich und technisch relevanten Weise offen: MIT-Gewichte, ein öffentlicher technischer Bericht und ein KV-Cache-Design, das 1M-Token-Sitzungen im Speicher nahezu kostenlos macht. Es ist nicht offen in dem Sinne, dass Sie es auf dem Rechner unter Ihrem Schreibtisch ausführen können. Für die meisten Teams ist der richtige Schritt die gehostete API zu $0,15 pro 1M Eingabetokens außerhalb der Spitzenzeiten, wobei die lokale Bereitstellung für Daten reserviert ist, die das Gebäude nicht verlassen dürfen.
So oder so, testen Sie, bevor Sie vertrauen. Richten Sie Apidog auf beide Endpunkte, führen Sie die gleichen gespeicherten Anfragen aus und lassen Sie sich von den Assertions sagen, ob Ihr lokaler Build der Referenz entspricht.