
Um mit Opus 5.5 irgendetwas zurückzuentwickeln, verbinde das Modell über REA mit einer Disassembly-Engine und arbeite dann in Phasen: das Ziel routen, es kartieren, die am häufigsten aufgerufenen Funktionen dekompilieren, Opus sie benennen und erklären lassen, eine rein verhaltensbasierte Spezifikation schreiben und aus dieser Spezifikation in einem separaten Kontext neu aufbauen. Passe den Effort-Level an jede Phase an und belege den Neuaufbau mit Paritätstests.
Das ist die Kurzfassung eines Leitfadens, der auf X viral ging. Am 12. Oktober 2026 veröffentlichte der Entwickler Movez einen 11-Schritte-Kurs zum Reverse Engineering mit Claude Opus 5.5. Er überschritt 1 Million Aufrufe und 2.800 Lesezeichen. Dieser Artikel prüft seine Behauptungen anhand der Quellen, korrigiert zwei Benchmark-Details und ergänzt den Schritt, den die meisten Leitfäden auslassen: das Testen der API, mit der ein Ziel kommuniziert.
Verwende dies nur bei Software, die dir gehört oder die du autorisiert untersuchen darfst. Die README von REA beschränkt das Tool auf „rechtmäßige Forschung, Bildung, Interoperabilität, Softwareerhaltung und Analyse von Software, die dir gehört oder die du autorisiert untersuchen darfst.“
Warum Opus 5.5 ein Tool zum Lesen einer Binärdatei braucht
Opus 5.5 liest und schreibt Text; es kann keine Mach-O- oder ELF-Datei selbst laden. REA ist ein MCP-Server, der zwischen deinem Agenten und einer Analyse-Engine (Hopper, Ghidra oder IDA für nativen Code) sitzt, die Analyse lokal ausführt und Befunde mit ihren Belegen zurückliefert: Adressen, Pseudocode, Strings und Aufrufstellen. Das Modell liest diese Befunde und stellt die nächste Frage.
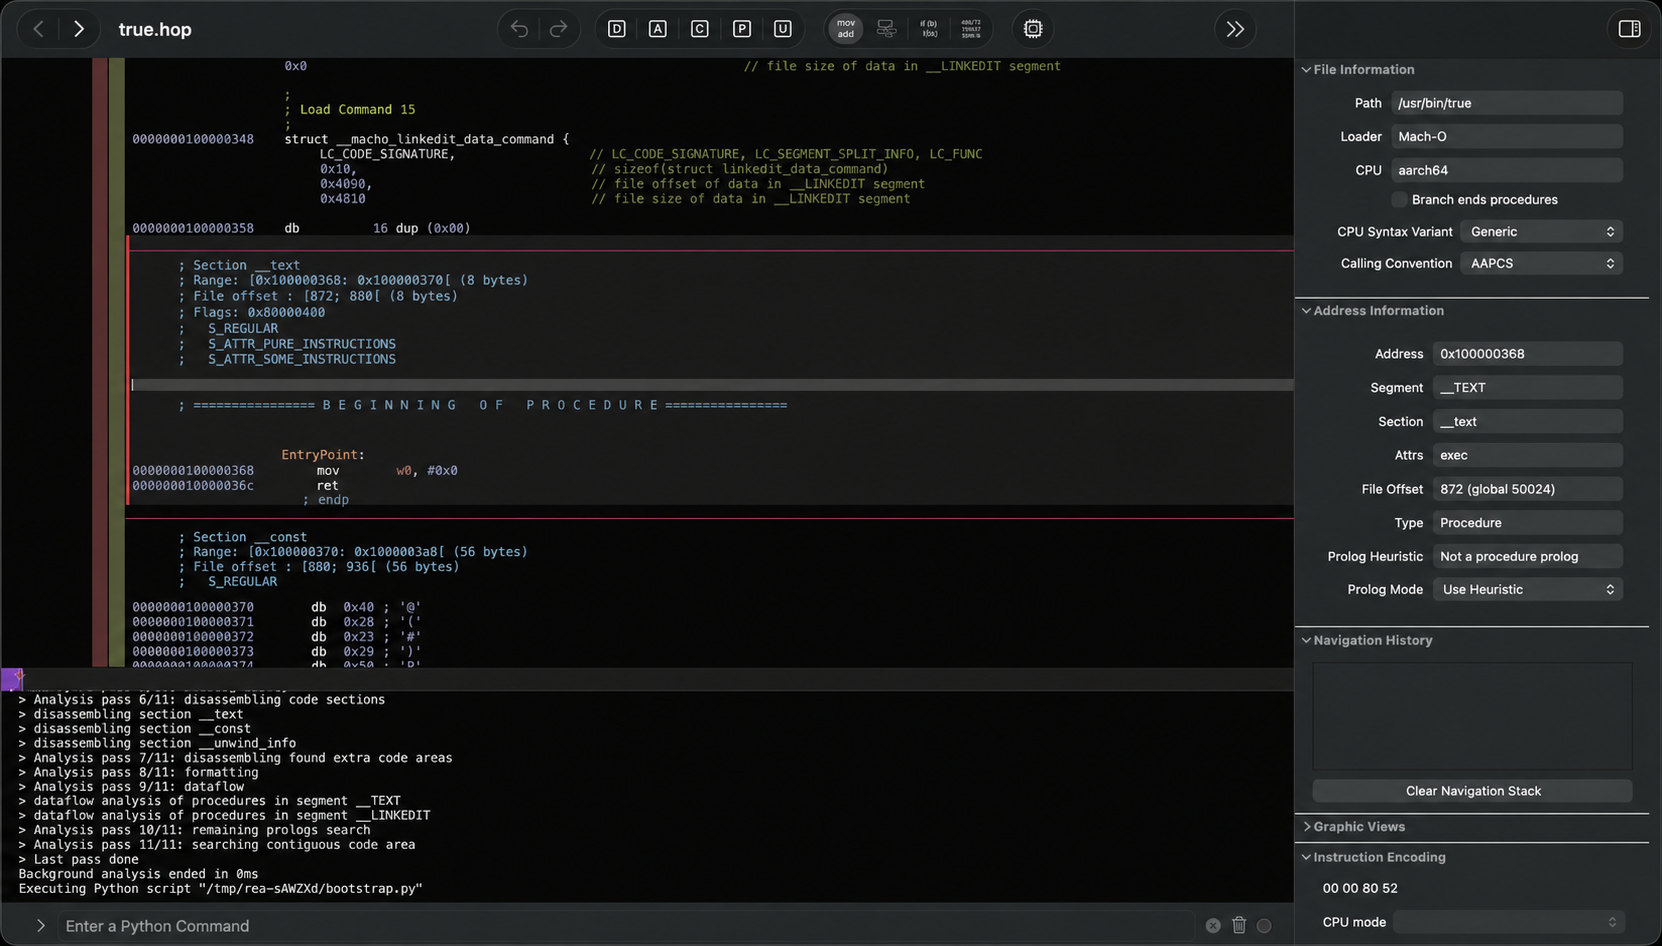
REA erreichte am 27. Oktober 2026 393.000 GitHub-Sterne, gegenüber etwa 115.000 am 12. Oktober. Wir haben was REA ist und wie es funktioniert und eine sechsschrittige Schleife zum Neuaufbau einer App-Funktion behandelt, als es erstmals trendete. Dieser Leitfaden konzentriert sich auf die Modellseite: die Prompts, die Effort-Einstellungen und die Grenzen.
Schritt 1: REA installieren und Hausregeln schreiben
REA benötigt Node.js 22.23.4 oder neuer in der 22er-Linie (24.22.1+ oder 26.12.1+ funktionieren ebenfalls) sowie npm. Die aktuelle npm-Version ist 6.8.0. Registriere es bei deinem Agenten:
npx rea-agents setup
npm install --global rea-agents
rea --help
Das Setup zeigt eine Vorschau seiner Konfigurationsänderungen an, sichert, was es anfasst, und unterstützt Claude Code, Codex, Cursor, Gemini CLI und Grok Build. Native Analyse benötigt Hopper, Ghidra oder IDA; die Inspektion von JavaScript, Electron und .NET benötigt keine Engine.
Dann gib dem Agenten Hausregeln. Der CLAUDE.md-Block des Kurses ist der beste Teil des Threads:
# Reverse-engineering house rules
- Only analyze targets I own or am authorized to examine. State the basis once.
- Tag every claim: observation, inference, or unknown.
- Cite the evidence: address, bytes, pseudocode or call site.
- Start with the smallest overview. Expand only on a concrete gap.
- Separate static facts from runtime facts.
- Build from behavior and public specs, never from copied code or assets.
- Every recovered behavior needs a passing test before "done".
Schritt 2: Wähle für jede Phase einen Effort-Level
Opus 5.5 unterstützt fünf Effort-Level: low, medium, high, xhigh und max. Laut Anthropics Dokumentation zu Effort ist der Standard bei Opus 5.5 medium, während xhigh auf lange agentische Läufe abzielt und max alle Begrenzungen des Token-Verbrauchs aufhebt. Du legst es über output_config.effort in der API oder über die Effort-Einstellung deines Agenten fest.
Die Aufteilung des Kurses ist ein sinnvoller Ausgangspunkt, keine gemessene Regel:
| Phase | Empfohlener Effort | Warum |
|---|---|---|
| Routing, Recon, Navigation | medium |
Hauptsächlich Tool-Aufrufe und Auflisten |
| Annotation gewöhnlicher Funktionen | high |
Benennung erfordert Schlussfolgerungen über den Datenfluss |
| Lange Sitzungen mit mehreren Funktionen | xhigh |
Für Läufe über 30 Minuten ausgelegt |
| Verschleierter oder pointerlastiger Code | max |
Tiefstes Reasoning, höchste Kosten |
Erhöhe den Effort pro Funktion, nicht pro Sitzung.
Schritt 3: Das Ziel routen, bevor du irgendetwas öffnest
Der häufigste Anfängerfehler ist, einen Disassembler auf einer Electron-App zu öffnen, deren JavaScript offen sichtbar ist. REA deckt Desktop-Installationen, native Binärdateien, JavaScript- und Electron-Apps, .NET-Assemblies, Android-APKs, WASM, Websites und gespeicherte Netzwerkaufzeichnungen ab, jeweils mit eigenem Einstiegstool. Dein erster Prompt sollte nur das Ziel identifizieren:
I want to understand how [FEATURE] works in [APP] at [ABSOLUTE PATH].
First tell me what kind of target this is (native, Electron/JS, .NET, APK, WASM)
and which REA tool opens it. Don't start deep analysis yet.
Then give me a one-paragraph map and where you'd look first for [FEATURE].
Keep observations, inferences and unknowns separate.
Ein Electron-Ziel geht an analyze-javascript-application (Module, Importe, IPC-Grenzen, keine Engine). Ein natives Ziel geht an open_binary.
Schritt 4: Strings kartieren und Funktionen nach Cross-Referenzen ordnen
Lies noch keinen Code. Beginne bei einem nativen Ziel mit einer Bestandsaufnahme:
rea inspect /absolute/path/to/program --provider ghidra --json
rea search /absolute/path/to/program entry --kind procedures --provider ghidra --json
Strings sind dein schnellster Hinweis: URLs, Fehlermeldungen und Funktionsnamen. Eine Basis-URL oder ein Authorization: Bearer-String verrät dir außerdem, dass die Binärdatei mit einer API spricht, was in Schritt 9 wichtig ist.
Als Nächstes ordnest du Funktionen nach Cross-Referenzen (wie viele Stellen sie aufrufen). Eine Funktion mit 147 Aufrufern ist wahrscheinlich Kerninfrastruktur, etwa ein Konfigurationslader; eine mit zwei Aufrufern kann warten. Lies von oben nach unten.
Schritt 5: Eine Funktion dekompilieren und dann Opus benennen lassen
Dekompiliere eine einzelne Hot-Funktion:
rea function /absolute/path/to/program parseConfig --provider ghidra --json
rea decompile /absolute/path/to/program --procedure=parseConfig --provider ghidra --json
Die Ausgabe ist roh (var_28, überall Casts). Übergib sie Opus 5.5 bei high-Effort mit einer festen Checkliste:
Here is decompiled pseudocode for a function with 147 cross-references.
1. Rename every variable based on how it is used.
2. State the function's purpose in one sentence.
3. List the data structures it reads and writes.
4. Name the pattern (singleton, factory, state machine, observer).
5. Flag missing error handling, validation or security checks.
Mark anything you're unsure of instead of guessing.
Decompiler machen Fehler bei Details. In REAs DX-Ball-Showcase zeigte der erste Pseudocode eine Sound-Pan-Funktion ohne Eingabe. Erst die Instruktionsansicht offenbarte den Parameter. Die finale C-Rekonstruktion besteht 3.205 originale x86-Testfälle und reproduziert alle 63 kompilierten Funktionsbytes, weil der Agent Pseudocode gegen Assembly und Aufrufer gegengeprüft hat. Frage nach rea instructions, wenn eine Signatur merkwürdig aussieht.
Schritt 6: Verschleierten Code budgetieren, nicht damit kämpfen
Hier muss der virale Kurs korrigiert werden. Er zitiert den Obfuskations-Benchmark von Elastic Security Labs als Test von „Claude Opus“. Die am 21. April 2026 veröffentlichte Studie von Elastic testete Claude Opus 4.6, nicht Opus 5.5. Die Zahlen:
| Tigress-Phase | Gelöst |
|---|---|
| Keine Transformationen | 1 von 1 |
| Einzelne Transformationen | 4 von 6 |
| Paarweise Transformationen | 3 von 6 |
| Schwer, mehrschichtig | 0 von 6 |
Insgesamt löste Opus 4.6 8 von 20 auswertbaren Zielen (40 %). Erfolge kosteten durchschnittlich 2,39 $ und Fehlschläge 4,83 $, ein Fehlschlag kostet also etwa doppelt so viel wie ein Erfolg. Behandle diese Zahlen als Untergrenze, nicht als Messung von Opus 5.5; wir haben keinen veröffentlichten vergleichbaren Wert für 5.5 gefunden.
Zweitens behauptet der Kurs, ein Tool namens Caveman „entferne etwa 75 %“ des dekompilierten Ballasts. Elastic beschreibt Caveman als Plugin, das die eigene Geschwätzigkeit des Modells um bis zu 75 % reduziert, nicht als Filter für dekompilierten Code.
Die Lehre bleibt gültig: Deckle die Ausgaben pro verschleierter Funktion, verlange einen Konfidenzwert von 1 bis 10 und stelle alles unter 6 zurück, bis seine Nachbarn geklärt sind.
Schritt 7: Große Ziele in einen Controller und Worker aufteilen
Ein Chat kann keine 500 Funktionen halten; er vergisst Namen und widerspricht sich selbst. Die Lösung des Kurses ist ein Controller, der niemals Code analysiert, und Worker, die jeweils eine Funktion übernehmen:
Controller: The function map is in functions.json (address, name, size, xrefs).
Cluster functions by call-graph proximity, order clusters by xref count,
send each cluster to a worker, inject already-resolved struct names into every
brief, and queue a second pass for any result with confidence below 6.
Report token spend after each cluster.
Jeder Worker liefert die Adresse, den Zweck, einen Konfidenzwert von 1 bis 10, die verwendeten oder gefundenen Structs sowie sauberen Quellcode zurück und verwendet dabei die Struct-Namen des Controllers wieder. Elastics Benchmark lief mit derselben Controller-Worker-Form.
Schritt 8: Eine rein verhaltensbasierte Spezifikation in einem sauberen Kontext schreiben
Ein Clean-Room-Neuaufbau kopiert, was Software tut, niemals ihren Code. Bitte Opus um eine rein verhaltensbasierte Spezifikation: öffentliche Schnittstellen, das Datenmodell, jede Funktion als testbare Anforderung, Dateiformate aus öffentlichen Standards und Fehlerbehandlung. Verbiete Adressen, dekompilierte Namen und alles Kopierte.
Dann implementiere aus dieser Spezifikation in einem anderen Kontext, der die Analyse nie sieht. Diese Trennung ist die Clean-Room-Grenze. Dies ist Engineering-Praxis, keine Rechtsberatung.
Schritt 9: Den API-Vertrag rekonstruieren und mit Apidog CLI testen
Die Strings aus Schritt 4 offenbaren oft eine Basis-URL und einen Auth-Header, also lebt ein Teil des Verhaltens hinter einer API. Dein Neuaufbau passt nur, wenn er auch diesen Vertrag einhält, und Traffic zeigt ihn schneller als Assembly.
Zeichne eine HAR auf einem Testkonto auf, das dir gehört, und lass REA sie zusammenfassen:
rea inspect-web-network-capture /absolute/session.har har --json
Dann lass deinen Agenten diese Aufzeichnung mit Apidog CLI in einen getesteten Vertrag verwandeln. Richte es einmal ein:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Gib dem Agenten einen Prompt:
Import session.har into Apidog project <id>. List the endpoints it created,
remove anything that isn't part of [FEATURE], and write one test case per
endpoint that asserts status code, required fields and response schema.
Run them against the original-service environment, then against my rebuild's
environment, and report every endpoint where the two disagree.
Der Agent führt den Import aus, prüft Payload-Formen vor dem Schreiben und führt beide Umgebungen aus:
apidog import --project <id> --format har --file ./session.har
apidog endpoint list --project <id>
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog test-case run --project <id> --endpoint <endpointId> -e <originalEnvId> -r cli,json
apidog test-case run --project <id> --endpoint <endpointId> -e <rebuildEnvId> -r cli,json
Dieselben Fälle, zwei Umgebungen, ein Diff, bei jedem Commit erneut ausführbar mit -r junit (siehe unseren Apidog CLI CI/CD-Leitfaden). Wenn du es lieber aus Claude Code steuerst, siehe Apidog CLI in Claude Code. Der kostenlose Plan von Apidog deckt bis zu 4 Benutzer ab. Für den manuellen Ansatz siehe Reverse Engineering von APIs.
Schritt 10: Parität beweisen, bevor du auslieferst
„Ich denke, es passt“ ist kein Beleg. Für lokales Verhalten bitte Opus, eine Testumgebung zu bauen, die dem Original und dem Neuaufbau dieselben Eingaben zuführt:
Generate 50 inputs: 30 normal, 10 edge (empty, max size, unicode), 10 error
(malformed, missing fields, corrupt). Run each through both programs. Compare
byte-for-byte where possible, semantically otherwise. Report the match rate and
every divergence as cosmetic, behavioral or critical.
Mit dem API-Lauf aus Schritt 9 erhältst du zwei Zahlen, die du jedem zeigen kannst: eine lokale Übereinstimmungsrate und eine API-Übereinstimmungsrate. Teste während des Builds, nicht erst am Ende.
FAQ
Ist Reverse Engineering mit Opus 5.5 legal? Es hängt von deiner Jurisdiktion, der Lizenz und deinem Zweck ab. REA unterstützt rechtmäßige Forschung, Bildung, Interoperabilität, Erhaltung und Analyse von Software, die dir gehört oder die du autorisiert untersuchen darfst. Hole Rechtsberatung ein, bevor du einen Neuaufbau kommerziell auslieferst.
Welchen Effort-Level sollte ich für Reverse Engineering verwenden? Beginne mit medium für Routing und Recon, high für die Annotation von Funktionen und reserviere max für verschleierten Code mit einem Budget pro Funktion. Opus 5.5 verwendet standardmäßig medium.
Wie gut kommt Claude mit verschleierten Binärdateien zurecht? Der einzige öffentliche Benchmark, von Elastic Security Labs, testete Opus 4.6: 40 % von 20 Tigress-Zielen gelöst und 0 % der schweren mehrschichtigen. Es wurde kein entsprechender Test von Opus 5.5 veröffentlicht.
Wie teste ich die API, die eine zurückentwickelte App verwendet? Zeichne eine HAR auf einem Testkonto auf, importiere sie mit apidog import --format har, erstelle Testfälle mit Apidog CLI und führe sie sowohl gegen den Originaldienst als auch gegen deinen Neuaufbau aus.
Lädt REA meine Binärdatei hoch? REA führt die Analyse lokal aus. Nur die Befunde, die dein Agent an das Modell übergibt (Strings, Pseudocode), erreichen deinen Modellanbieter.