
Zur Dokumentation von Kafka-APIs sollte man für jedes Topic einen Vertrag (Contract) schreiben. Darin sollte das Topic benannt werden, der Event-Key, das Payload-Schema, die Header, die Ordering- und Delivery-Garantien, die Consumer-Groups, die Aufbewahrungsfrist und der Owner. Speichern Sie diesen Vertrag neben Ihrer HTTP-API-Dokumentation, damit Producer und Consumer eine einzige verlässliche Quelle haben, statt Messages aus einem Live-Cluster zurückzuentwickeln.
Dieser Leitfaden behandelt jeden Bestandteil eines solchen Vertrags, wie man ihn in AsyncAPI schreibt, wie man Schemas sicher weiterentwickelt und wie Sie Ihren Coding-Agent die Arbeit mit dem Apidog CLI erledigen lassen.
Wenn Sie neu im Bereich ereignisgetriebener Architektur sind, starten Sie mit ereignisgetriebene APIs erstellen und dem Leitfaden zu Webhooks und ereignisgetriebener Architektur.
Was ist eine Kafka-API?
Eine Kafka-API ist die Gesamtheit der Topics, Nachrichtenformate und Zustellungsregeln, die Services nutzen, um Ereignisse über einen Apache-Kafka-Cluster auszutauschen. Anders als bei einer REST-API ruft niemand einen Endpoint auf und wartet auf eine Antwort. Producer schreiben Records in Topics, Consumer lesen sie nach ihrem eigenen Zeitplan, und der Vertrag liegt in der Struktur und Bedeutung dieser Records.
Die Kafka-Dokumentation bringt es auf den Punkt: „ein Ereignis hat einen Key, einen Value, einen Zeitstempel und optionale Metadaten-Header." Kafka selbst prüft nicht, was im Value steckt. Ein Producer kann heute JSON schreiben und morgen ein anderes JSON-Format, und der Broker akzeptiert beides. Genau deshalb brauchen Kafka-APIs geschriebene Verträge mehr als HTTP-APIs: Nichts auf Transportebene verhindert ein Breaking Change.
Dokumentierte Topics scheitern auf vorhersagbare Weise: Ein Consumer rät einen Feldtyp aus einem einzelnen Beispiel ab und stürzt bei null ab, oder ein neuer Service weiß nicht, dass er jede Message mindestens einmal erhält, und berechnet bei Retries doppelt ab.
Was man für jedes Kafka-Topic dokumentieren sollte
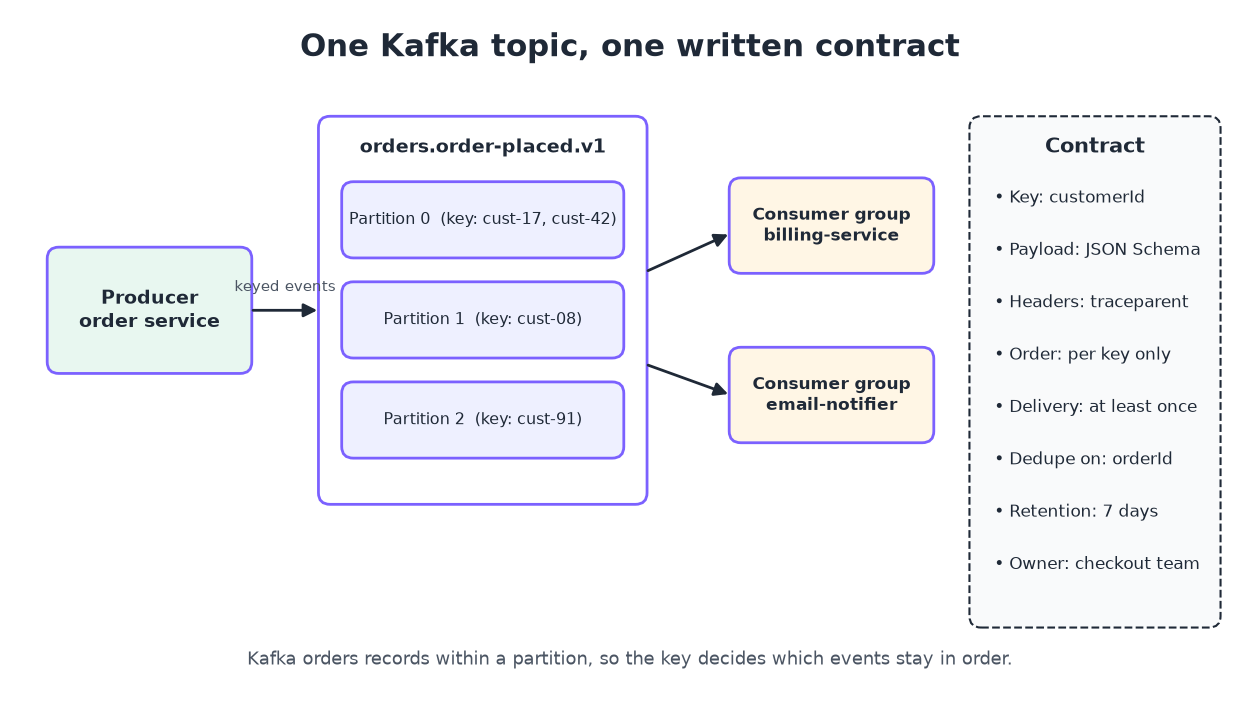
Jedes Topic braucht dieselben Kernfakten. Verwenden Sie diese Tabelle als Checkliste:
| Vertragsfeld | Was Sie festhalten sollten | Beispiel |
|---|---|---|
| Topic-Name | Vollständiger Name und Namenskonvention | orders.order-placed.v1 |
| Zweck | Ein Satz zur Bedeutung des Ereignisses | „Eine Bestellung wurde bezahlt und ist versandbereit" |
| Event-Key | Welches Feld der Key ist und warum | customerId, damit die Bestellungen eines Kunden in der richtigen Reihenfolge bleiben |
| Payload-Schema | Jedes Feld, Typ, Pflichtfeld-Markierung und Format | JSON Schema, Avro oder Protobuf |
| Header | Name, Typ und Bedeutung jedes Headers | traceparent, schema-version |
| Partitionen und Ordering | Anzahl der Partitionen und die Ordering-Zusage | 12 Partitionen, sortiert pro customerId |
| Delivery-Semantik | At least once, idempotenter Producer, Transaktionen | At least once; Consumer müssen auf orderId deduplizieren |
| Consumer-Groups | Bekannte Groups und deren Aufgabe | billing-service, email-notifier |
| Aufbewahrung | Wie lange Records lesbar bleiben | 7 Tage |
| Verantwortung | Zuständiges Team, Kontakt und Versionspolitik | Checkout-Team, #checkout-events |
Die Zeilen zu Ordering und Delivery sind am wichtigsten: Leser können sie nicht aus einer Beispiel-Message ableiten.
Kafka-APIs in 6 Schritten dokumentieren
- Alle Topics und ihre Owner auflisten. Ziehen Sie die Topic-Liste aus Ihrem Cluster und vermerken Sie, wer in jedes Topic produziert.
- Den Key definieren. Halten Sie fest, welches Feld der Key ist und was das für das Ordering bedeutet.
- Das Payload-Schema schreiben. Beschreiben Sie jedes Feld mit JSON Schema, Avro oder Protobuf.
- Header und Metadaten beschreiben. Einschließlich Tracing-, Schema-Version- und Content-Type-Headern.
- Die Garantien angeben. Dokumentieren Sie Delivery-Semantik, Ordering-Umfang, Aufbewahrung und Consumer-Groups.
- Dort veröffentlichen, wo Leute suchen. Legen Sie den Vertrag neben Ihre HTTP-API-Doku und versionieren Sie ihn wie Code.
Schritte 1 und 2: Topics und Keys
Ein Namensmuster wie <domain>.<event>.<version> verrät Lesern, wem das Topic gehört und welche Version sie lesen. Dokumentieren Sie anschließend den Key, denn er entscheidet über die Partition. In der Kafka-Dokumentation heißt es: „Ereignisse mit demselben Event-Key (z. B. eine Kunden- oder Fahrzeug-ID) werden in dieselbe Partition geschrieben", und Consumer lesen die Ereignisse einer Partition „in exakt derselben Reihenfolge, in der sie geschrieben wurden."
Ihr Vertrag sollte also sagen „sortiert pro customerId", nicht „sortiert". Kafka garantiert nur die Reihenfolge innerhalb einer Partition, niemals über ein ganzes Topic.
Schritt 3: Das Payload-Schema
Das Payload ist der Teil, gegen den Consumer programmieren, also beschreiben Sie es Feld für Feld. Hier ein JSON Schema für ein order-placed-Ereignis:
{
  "type": "object",
  "required": ["orderId", "customerId", "totalCents", "currency", "placedAt"],
  "properties": {
    "orderId": { "type": "string", "description": "Unique order ID; use it to deduplicate" },
    "customerId": { "type": "string", "description": "Also the record key" },
    "totalCents": { "type": "integer", "minimum": 0 },
    "currency": { "type": "string", "enum": ["USD", "EUR", "GBP"] },
    "placedAt": { "type": "string", "format": "date-time" },
    "couponCode": { "type": ["string", "null"] }
  }
}
Die Beschreibung „use it to deduplicate" sagt einem Consumer, was er mit dem Feld tun soll – nicht nur, welchen Typ es hat. Neu bei dem Format? Lesen Sie Was ist JSON Schema.
Schritte 4 und 5: Header und Garantien
Listen Sie jeden Header auf (Trace-Kontext, Schema-Version, Content-Type) und geben Sie an, ob sich Consumer darauf verlassen können. Halten Sie dann die Delivery-Garantie fest – in der Terminologie von Kafka selbst. In den Kafka-Design-Dokumenten heißt es, dass „Kafka standardmäßig At-Least-Once-Zustellung garantiert", was bedeutet, dass Messages „nie verloren gehen, aber möglicherweise erneut zugestellt werden." Falls Ihr Producer die idempotente Option oder Transaktionen nutzt, sagen Sie das. Falls nicht, weisen Sie Consumer an zu deduplizieren – und nennen Sie das Feld, auf das dedupliziert werden soll.
Dokumentieren Sie auch die Consumer-Groups. Innerhalb jeder abonnierenden Group wird eine Partition jeweils „von genau einem Consumer" konsumiert. Das verrät Lesern, wie weit eine Group horizontal skalieren kann: ein aktiver Consumer pro Partition.
Den Vertrag in AsyncAPI schreiben
Tools brauchen ein maschinenlesbares Format, und bei Kafka ist das üblicherweise AsyncAPI, eine Spezifikation, die „dazu dient, nachrichtengetriebene APIs in einem maschinenlesbaren Format zu beschreiben." Sie spielt für Message-basierte Systeme dieselbe Rolle wie OpenAPI für REST.
Ein AsyncAPI-3.0-Dokument enthält info, servers, channels, operations und components. Ein Channel wird über seine address auf ein Topic abgebildet, und jede Operation hat eine action mit dem Wert send oder receive:
asyncapi: 3.0.0
info:
  title: Orders events
  version: 1.0.0
channels:
  orderPlaced:
    address: orders.order-placed.v1
    messages:
      orderPlaced:
        $ref: '#/components/messages/orderPlaced'
operations:
  publishOrderPlaced:
    action: send
    channel:
      $ref: '#/channels/orderPlaced'
components:
  messages:
    orderPlaced:
      payload:
        $ref: './schemas/order-placed.json'
AsyncAPI bietet außerdem Kafka-Bindings auf Server-, Channel-, Operations- und Message-Ebene. Dort gehören die Kafka-spezifischen Details hin – diejenigen, die sich mit den generischen Feldern nicht ausdrücken lassen. Bewahren Sie die Spezifikation im Repository des Producers auf, damit der Pull Request, der ein Event ändert, auch seinen Vertrag ändert.
Schema-Evolution bei Kafka: Die Kompatibilitätsregel dokumentieren
Ihr Schema wird sich ändern. Der Vertrag sollte festlegen, welche Änderungen sicher sind. Wenn Sie eine Schema Registry verwenden, dokumentieren Sie deren Kompatibilitätsmodus. In den Schema-Evolution-Dokumenten von Confluent sind diese Modi aufgeführt, mit dem Hinweis, dass „der Standard-Kompatibilitätstyp der Confluent Schema Registry BACKWARD ist":
| Modus | Wer kann was lesen |
|---|---|
| BACKWARD | Consumer mit dem neuen Schema können Daten lesen, die mit dem vorherigen Schema geschrieben wurden |
| BACKWARD_TRANSITIVE | Consumer mit dem neuen Schema können Daten aus allen früheren Schemas lesen |
| FORWARD | Consumer mit dem vorherigen Schema können Daten lesen, die mit dem neuen Schema geschrieben wurden |
| FORWARD_TRANSITIVE | Consumer mit einem beliebigen früheren Schema können Daten lesen, die mit dem neuen Schema geschrieben wurden |
| FULL | Abwärts- und aufwärtskompatibel mit dem vorherigen Schema |
| FULL_TRANSITIVE | Abwärts- und aufwärtskompatibel mit allen früheren Schemas |
| NONE | Kompatibilitätsprüfungen sind deaktiviert |
In der Praxis dürfen Sie unter BACKWARD optionale Felder hinzufügen und Felder entfernen, die Defaults hatten. Ein Pflichtfeld umzubenennen oder seinen Typ zu ändern, bricht Consumer. Wenn Sie einen Breaking Change benötigen, veröffentlichen Sie eine neue Topic-Version (orders.order-placed.v2), dokumentieren Sie beide und legen Sie ein Abschaltdatum für die alte fest.
Ihren Coding-Agent Kafka-APIs mit dem Apidog CLI dokumentieren lassen
Handgeschriebene Verträge driften auseinander, sobald jemand einen Producer ändert. Ihr Coding-Agent kann den Producer-Code lesen, die Schemas schreiben und die Dokumentation synchron halten, während Sie das Ergebnis prüfen. Das Apidog CLI stellt Claude Code, Codex, Cursor oder jedem Terminal-Agenten die Befehle dafür in einem Apidog-Projekt bereit.
Installieren Sie die CLI, melden Sie sich an und fügen Sie die Apidog Skill hinzu, damit Ihr Agent die Befehle kennt:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Sie können das Setup auch an den Agenten delegieren: Weisen Sie ihn an, den Apidog-CLI-Installationsleitfaden zu lesen und sich selbst einzurichten.
Geben Sie Ihrem Agenten dann einen einzelnen Prompt:
Read the Kafka producers in ./services/orders. For every topic they write to,
create an Apidog data schema in project <projectId> for the message payload,
then create one Markdown doc per topic with the key, headers, ordering,
delivery guarantee, consumer groups, retention and owner. Validate every
payload before you write it.
Der Agent prüft die Payload-Struktur, validiert seine Datei und schreibt dann das Schema und die Vertragsseite:
apidog cli-schema get schema-create
apidog cli-schema validate schema-create --file order-placed.schema.json
apidog schema create --project <projectId> --file order-placed.schema.json
apidog cli-schema get doc-create
apidog doc create --project <projectId> --file order-placed.doc.json
apidog schema list --project <projectId>
apidog schema create speichert das Payload als wiederverwendbares Datenschema. Ihre HTTP-Endpoints können dasselbe Modell referenzieren, sodass ein einmal definiertes Order-Modell sowohl die REST-Antwort als auch das Kafka-Event abdeckt. apidog doc create schreibt ein Markdown-Dokument in den Projektbaum, das den Topic-Vertrag aus der Tabelle oben enthält. Wenn sich ein Producer ändert, führen Sie den Prompt erneut aus, und der Agent verwendet apidog schema update. Eine ausführlichere Anleitung zur agentengetriebenen Dokumentationsarbeit finden Sie unter APIs über die CLI dokumentieren und Apidog CLI in Claude Code.
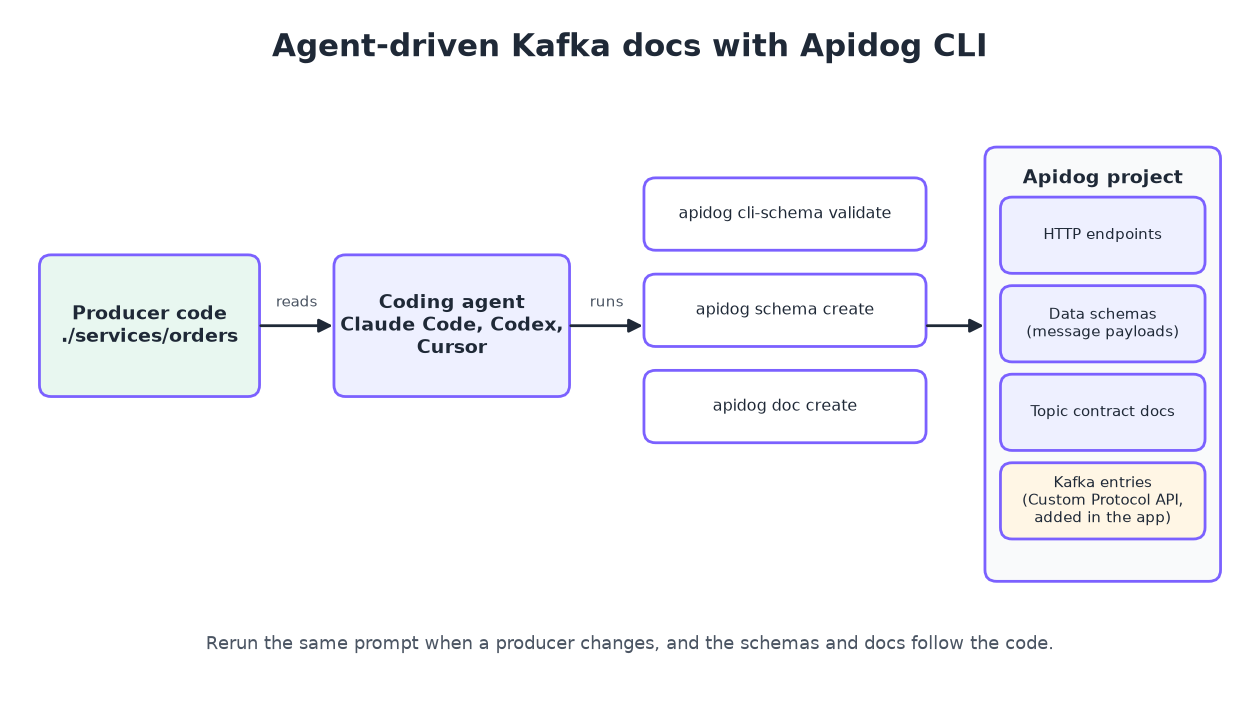
Ein Schritt bleibt in der App. Apidogs Custom Protocol API dokumentiert Kafka-Endpoints neben HTTP-Endpoints: Wählen Sie New Other Protocol APIs, dann Other Custom Protocol API, wählen Sie Kafka als Protokoll und füllen Sie URI (das Topic), Name, Status, Maintainer, Tags und Beschreibung aus. Diese Einträge teilen sich Ordnerbaum, Suche und Quick Share mit Ihrer HTTP-Dokumentation. Die CLI hat derzeit keinen Befehl für Custom-Protocol-Endpoints – dieser Teil muss also von Hand angelegt werden.
Apidog Free deckt bis zu 4 Nutzer ab, sodass ein kleines Team seine REST- und Kafka-Dokumentation kostenlos in einem Projekt verwalten kann.
FAQ
Gibt es ein OpenAPI für Kafka?
AsyncAPI übernimmt diese Rolle. Es beschreibt Server, Channels (Topics), Operationen und Message-Payloads in YAML oder JSON, mit Kafka-spezifischen Bindings.
Brauche ich eine Schema Registry, um Kafka-APIs zu dokumentieren?
Nein, aber sie hilft. Die Dokumentation legt die Regeln fest; eine Registry setzt sie zum Zeitpunkt des Schreibens durch. Wenn Sie eine betreiben, dokumentieren Sie deren Kompatibilitätsmodus.
Was ist der Unterschied zwischen der Dokumentation eines Kafka-Topics und eines REST-Endpoints?
Ein REST-Dokument beschreibt einen Request und eine Response. Ein Kafka-Dokument beschreibt eine Message, die viele Consumer später lesen – es braucht daher zusätzlich den Key, den Ordering-Umfang, die Delivery-Garantie, die Aufbewahrung und die Consumer-Groups. None davon taucht in einem typischen REST-Dokument auf.
Kann Apidog Kafka-Messages testen?
Apidog dokumentiert Kafka-Endpoints über die Custom Protocol API, sendet oder konsumiert aber keine Kafka-Messages. Nutzen Sie es, um den Vertrag und die Payload-Schemas zu verwalten, und testen Sie den Producer- und Consumer-Code mit Ihrer Kafka-Client-Bibliothek.
Wie oft sollte ich die Kafka-Dokumentation aktualisieren?
Jedes Mal, wenn ein Producer eine Message ändert. Binden Sie es an das Code Review: Der Pull Request, der das Event ändert, aktualisiert auch den Vertrag – oder Ihr Agent generiert ihn mit dem Apidog CLI neu.