
Um einen Super-Agenten nach dem Vorbild von DeepSeek Harness zu bauen, unterteilen Sie Ihren Agenten in zwei Ebenen: eine langlebige Router-Session, die mit Menschen kommuniziert und Aufgaben verteilt, sowie viele isolierte Worker-Sessions, die jeweils eine Aufgabe mit vollem Tool-Zugriff ausführen. Speisen Sie beide über Event-Trigger (Chat, GitHub, CI), leiten Sie Folgeanfragen per Thread weiter und ergänzen Sie einen separaten Watchdog, der das Gesamtsystem überwacht.
Dieser Leitfaden macht aus dem Architektur-Essay von DeepSeek Harness, „Exploring Super-agent Design“, eine praktische Bauanleitung. Ein wichtiger Hinweis vorweg: Der Essay beschreibt eine Architektur, kein fertiges Produktfeature. Teile davon stecken in einem Prototyp-Plugin namens dsh-superagent-prototype, das laut den Autoren „kein offizielles DeepSeek-Produkt“ ist. Alle folgenden Code-Skizzen dienen lediglich der Veranschaulichung und stammen nicht von DeepSeek.
Was ist ein Super-Agent?
Ein Super-Agent ist ein einzelner, dauerhaft erreichbarer KI-Teamkollege, der Ereignisse über mehrere Kanäle (Chat, Pull Requests, CI) empfängt, viele Aufgaben parallel in isolierten Sessions abarbeitet und Menschen gegenüber mit einer einheitlichen Identität auftritt.
Das Problem: Agenten-Sessions sind isoliert, und „ein Mensch kann typischerweise nur 3 bis 5 aktiven Sessions gleichzeitig folgen“. Eine einzelne Aufgabe wird durch das Modell begrenzt. Multitasking scheitert an der menschlichen Aufmerksamkeit. Genau an dieser zweiten Grenze setzt der Super-Agent an.
Er zeichnet sich durch vier Eigenschaften aus:
- Kontinuierlich: Ein einziger Agent über Chat und GitHub hinweg. Besprechen Sie Plan A im Chat und wechseln in einem PR-Kommentar zu Plan B, bleibt der Agent nahtlos im Bilde.
- Produktiv: Er führt Aufgaben parallel aus und nimmt Ihre nächste Anweisung entgegen, noch bevor die vorherige abgeschlossen ist.
- Proaktiv: Er überwacht Ereignisse und verhält sich ruhig, es sei denn, er wird tatsächlich gebraucht.
- Persistent: Er ist permanent online und stellt sich nach Fehlern selbstständig wieder her.
Wenn DeepSeek Harness für Sie neu ist, lesen Sie am besten zuerst, was DeepSeek Harness ist und wie es sich im Vergleich zu Claude Code schlägt.
Super-Agent-Architektur: Die fünf Kernmodule
Der Essay umfasst fünf Module. Hier sind sie im Überblick zusammen mit dem Schritt, in dem sie gebaut werden:
| Modul | Funktion | Bauschritt |
|---|---|---|
| Zweistufige Architektur | Router verteilt Aufgaben, Worker führen sie aus | 1 |
| Ereignisgesteuerte Trigger | Wandeln Chat-, GitHub- und CI-Events in Agenten-Input um | 2 |
| Vollduplex, Multi-Channel | Asynchrone Tools, kanalspezifische Antworten | 4 |
| Trennung von Compute, State und Umgebung | Zustandsloser Loop, State in einer Datenbank, Maschinen bleiben unverändert | 5 |
| Watchdog | Separate Session zur Überwachung von Fortschritt und Fehlern | 6 |
Schritt 1: Den Router von den Workern trennen
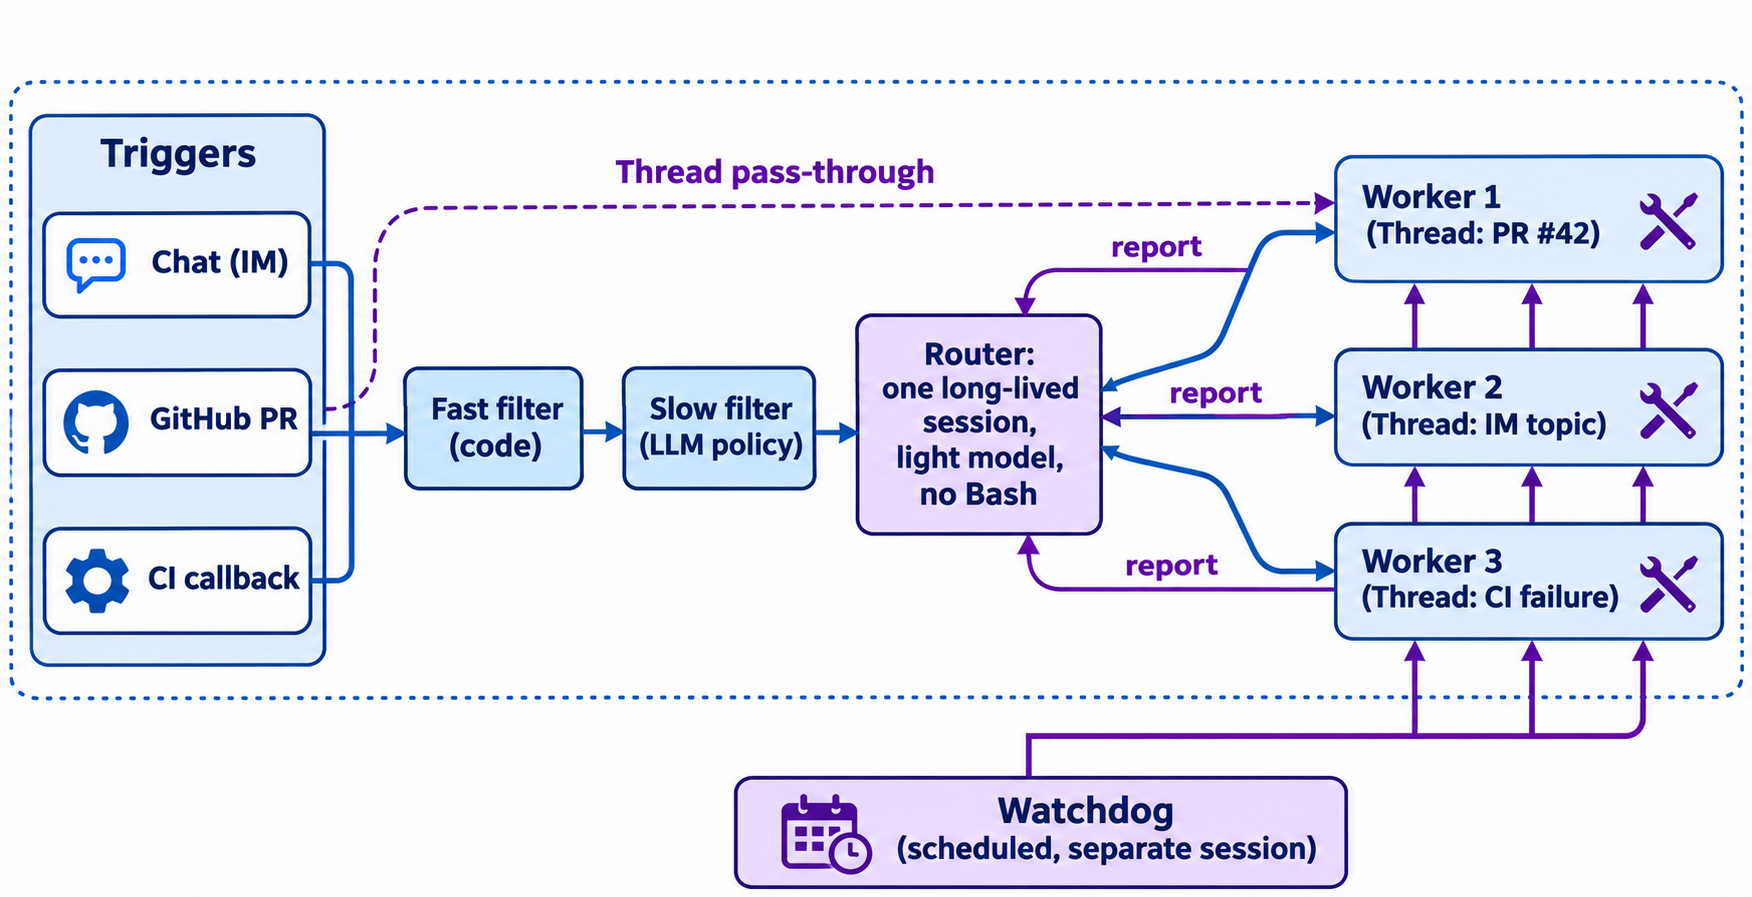
Der Router ist eine einzelne, langlebige Session. Er übernimmt die gesamte menschliche Interaktion sowie die Aufgabenverteilung und führt selbst niemals Aufgaben aus. Er kommt ohne Bash-Tool aus, sodass ein kleineres, günstigeres Modell genügt. Treffen während eines Router-Durchlaufs mehrere Trigger ein, werden sie für den nächsten Aufruf gebatcht: langer Input, kurzer Output, zusammengeführt im Prefill.
Jeder Worker ist eine isolierte Session pro Aufgabe. Er erhält vollen Tool-Zugriff und das stärkste Modell, das Sie sich leisten können. Er kommuniziert nie direkt mit Menschen, sondern berichtet an den Router zurück. Ein Worker kann selbst Subagenten nutzen oder aus einem ganzen Agenten-Team bestehen.
Verwechseln Sie dies nicht mit einem Agenten-Team: Ein Team-Lead zerlegt eine einzelne zusammenhängende Aufgabe; der Router verteilt hingegen nur unabhängige Aufgaben. Beide Ansätze lassen sich kombinieren.
# Illustrative sketch, not DeepSeek's code
class Router:
    def on_events(self, batch):              # triggers arriving mid-turn are batched
        plan = self.llm_light.decide(batch)  # dispatch, reply, or ignore
        for task in plan.new_tasks:
            Worker.spawn(task, model="strongest", tools="all", report_to=self)
        for msg in plan.replies:
            self.channels.send(msg)          # only the Router speaks to humans
Schritt 2: Events in Trigger verwandeln
Jeder Input für einen Super-Agenten ist ein Trigger: eine Chat-Nachricht, ein GitHub-Webhook-Event, ein Slack Events API-Payload oder ein CI-Callback. Die meisten davon sollten ein Modell gar nicht erst erreichen, weshalb der Essay sie in zwei Stufen filtert.
- Schnellpfad im Code: Filterung nach Quelle, Gruppe sowie Allowlisten für Benutzer oder Bots. Jede Quelle erhält einen Modus: „nur auf explizite Anfragen antworten“, „Kandidat“ oder „ignorieren“.
- Langsamere Prüfung per LLM: Kandidaten werden an ein Modell übergeben, das als Prompts formulierte Richtlinien anwendet, wie etwa „antworte, wenn jemand in diesem Kanal einen Bug meldet“.
Ihr Empfangs-Endpoint sollte Anfragen schnell bestätigen und die Arbeit nachlagern. GitHubs Best Practices für Webhooks fordern eine 2XX-Antwort innerhalb von 10 Sekunden – was ein Modellaufruf kaum garantieren kann. Geben Sie 202 Accepted zurück, reihen Sie den Trigger in eine Queue ein und lassen Sie ihn vom Router abholen. Unser Leitfaden zum Design zuverlässiger Webhooks behandelt Retries und Idempotenz für diese Ebene.
Schritt 3: Folge-Events per Thread weiterleiten
Ein Thread ist eine Abfolge zusammenhängender Ereignisse in einem PR, einem Chat-Topic oder einem E-Mail-Verlauf. Der Worker, der für das erste Event eines Threads erstellt wurde, abonniert diesen. Nachfolgende Ereignisse gehen dann direkt an diesen Worker – ganz ohne Router-Aufruf.
Die Zuordnung ist n-zu-m: Berühren zwei Worker denselben PR, empfangen beide dessen Events und können Konflikte direkt über den PR lösen, ohne direkt miteinander kommunizieren zu müssen.
Diesen Schritt zu überspringen hat seinen Preis: Im Experiment des Essays musste der Router ohne Pass-Through etwa 30 % mehr Entscheidungen treffen, und der Token-Verbrauch stieg um rund 37 %.
Schritt 4: Kontext als Cache behandeln und Tools asynchron machen
Der Router kann nicht alles behalten, daher behandelt der Essay den Kontext wie einen Cache:
- Inline speichern, was wahrscheinlich gebraucht wird: IDs, kurze Zusammenfassungen, benachbarte Nachrichten.
- Auslagern (Spill) des Rests: Inhalte kürzen und einen Verweis (Pointer) hinterlassen, dem der Agent folgen kann.
Stabile IDs für Trigger, Threads und Worker bilden einen Referenzgraphen, den die Autoren als „Chain of Recall“ bezeichnen. Der Agent springt von einem Trigger zu dessen Thread und weiter zum zuständigen Worker, was ihm Multi-Hop-Abfragen ermöglicht, ohne dass ein riesiger Prompt erforderlich ist.
Setzen Sie anschließend auf Vollduplex: Ersetzen Sie ein blockierendes run()-Tool durch asynchrone start()- und stop()-Tools. start() gibt sofort „Started“ zurück, und das Ergebnis trifft später als neues Event ein. Genau dadurch kann der Agent Ihre nächste Anweisung annehmen, während die vorherige noch läuft. Laut dem Essay ist dies in DeepSeek Harness zwar implementiert, aber standardmäßig deaktiviert.
Machen Sie Antworten schließlich kanalspezifisch: Die getestete Regel begrenzt Chat-Antworten auf 100 Wörter, während für GitHub, E-Mails und Dokumentationen strukturierte, dichte Berichte erstellt werden.
Dies ermöglicht auch eine spekulative Ausführung: In der Testgruppe liefert eine Policy nach dem Motto „im Hintergrund reproduzieren und beheben“ nur einen bestätigten einfachen Fix aus und verhält sich ansonsten ruhig.
Schritt 5: Compute, State und Umgebungen trennen
Führen Sie den Agenten-Loop in zustandslosen Cloud-Containern aus und speichern Sie den Session-State in einer Datenbank. Die Umgebungen bleiben, wo sie sind: Auf jeder Maschine läuft ein schlanker Daemon – im Essay als BYOM (Bring Your Own Machine) bezeichnet. Ein abgestürzter Loop startet an beliebiger Stelle neu und lädt seinen State wieder ein, während Repos auf ihren Maschinen verbleiben.
Der Essay verweist auf Anthropics Artikel „Scaling Managed Agents: Decoupling the brain from the hands“, der dieselbe Idee beschreibt, jedoch auf gemanagte Sandboxen statt auf eigene Maschinen abzielt.
Schritt 6: Einen Watchdog hinzufügen
Der Watchdog ist eine separate, zeitgesteuerte Session außerhalb des Hauptsystems. Er kümmert sich um API-Fehler und fragt ein Modell, ob die einzelnen Worker Fortschritte machen oder abdriften. Maintainer können ihn auch direkt fragen, warum etwas fehlgeschlagen ist. Betreiben Sie ihn außerhalb des Router-Prozesses, damit ein hängender Router nicht auch seinen Monitor mit in den Abgrund reißt.
Was die Experimente zeigten
Die Autoren ließen rund 300 Chat- und CI-Nachrichten mit etwa 20 Arbeitsaufträgen durchlaufen, simulierten das Coding per Timer und führten jedes Setup fünfmal aus. Die Ergebnisse bezeichnen sie als „rein indikativ“.
| Setup | p50 (Min.) | p95 (Min.) | Cache-Read-Tokens pro Durchlauf |
|---|---|---|---|
| Super-Agent | 12.4 | 15.7 | 23.2M |
| Ohne Thread-Pass-Through | 12.6 | 15.5 | 31.8M |
| Einzelsession + Subagent-Tool, neutraler Prompt | 20.4 | 29.5 | 6.1M |
| Einzelsession, Delegation-First-Prompt | 13.8 | 29.0 | 10.8M |
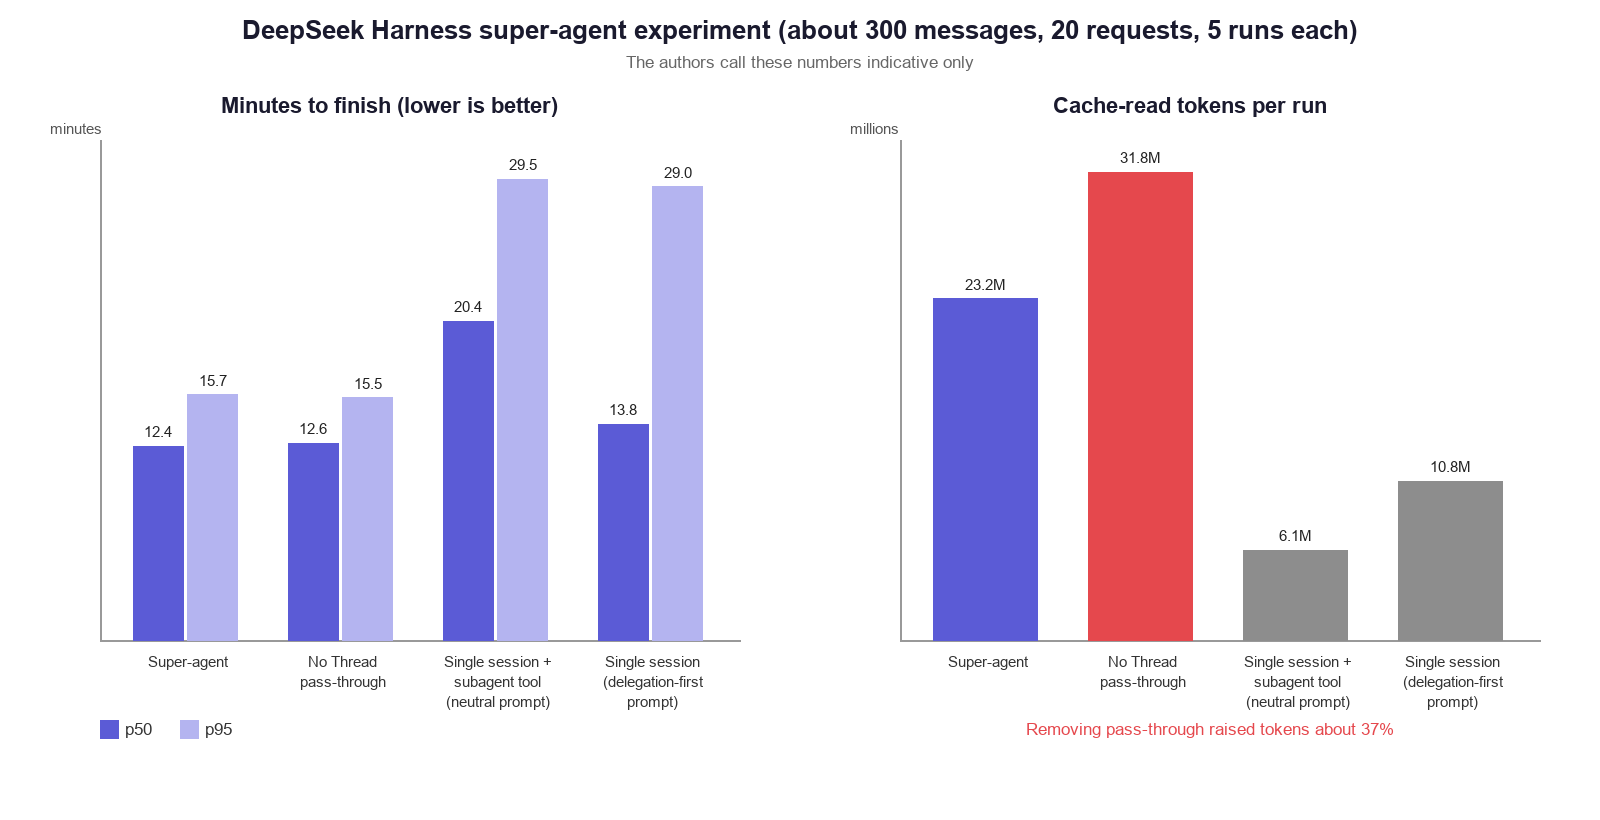
Zwei Ergebnisse stechen hervor: Mit einem neutralen Prompt delegierte die Einzelsession in fünf Durchläufen kein einziges Mal, sodass ihr p95-Wert fast doppelt so hoch war wie der des Super-Agenten. Ein Prompt mit Delegationsfokus verbesserte den Median, nicht aber die Ausreißer nach oben. Der Super-Agent verbraucht mehr Tokens als eine Einzelsession – man tauscht also Tokens gegen Latenz und Aufmerksamkeit ein.
Ein zweiter Test untersuchte den Router unter isolierter Last: Als die Trigger von 1 auf 40 pro Minute anstiegen, wuchs die Batch-Größe von 1,0 auf 2,8 und die Zeit pro Anfrage stieg von 2,5 s auf 3,9 s, während die Zeit pro Entscheidung von 6,4 s auf 1,6 s sank. Batching verhindert somit, dass ein einzelner Router frühzeitig zum Flaschenhals wird.
Trigger-Empfang mit der Apidog CLI testen
Jeder Trigger beginnt als HTTP-Request, der an Ihrem Empfangs-Endpoint eingeht. Daher sollte dieser Endpoint als Erstes getestet werden. Geht ein PR-Kommentar verloren oder wird jedem Event eine neue thread_id zugewiesen, bricht das Thread-Routing zusammen und jede Folgeanfrage läuft wieder über den Router. Lassen Sie Ihren Coding-Agenten diesen Test mit der Apidog CLI schreiben und ausführen.
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Geben Sie Ihrem Agenten anschließend folgenden Prompt:
In Apidog project <id>, create POST /triggers/github for a GitHub
pull_request_review_comment webhook. Add a test case that sends two
comments on the same PR and asserts: status 202, a trigger_id in the
body, and the same thread_id both times. Run it against staging and
summarize any failures.
Der Agent liest jedes Payload-Schema, validiert dessen JSON, erstellt den Endpoint sowie den Testfall und führt ihn aus:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <id> --file endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <stagingEnvId> -r cli,json
Derselbe Aufruf von apidog run mit -r junit lässt sich direkt in Ihre Pipeline integrieren; siehe Apidog CLI in CI/CD. Wenn Ihr Agent DeepSeek Harness selbst ist, folgen Sie dieser Setup-Anleitung; für Claude Code nutzen Sie diese hier. Der kostenlose Free-Plan von Apidog umfasst bis zu 4 Benutzer.
Offene Fragen
Der Essay listet auf, was bislang ungelöst ist:
- Skalierung des Routers und die Wahl einer Worker-Topologie bei wachsender Last.
- Langzeitgedächtnis über die Chain of Recall hinaus.
- UX ohne Sessions: Die Steuerung eines Agenten ohne zentrales Chat-Fenster.
- Kontextgrenzen und Agent-to-Agent-Protokolle, bei denen A2A ein Kandidat ist.
- Sicherheit: Eine Prompt Injection, die den Cloud-Loop erreicht, könnte jede verbundene Maschine erreichen, und Zugangsdaten im Kontext können nach außen dringen. Die Autoren wünschen sich, dass Agenten Anmeldedaten nutzen können, ohne sie jemals selbst zu sehen.
FAQ
Ist der Super-Agent ein Feature von DeepSeek Harness, das ich einfach einschalten kann? Nein. Der Essay beschreibt eine Architektur. Teile davon existieren im Plugin dsh-superagent-prototype, das laut den Autoren kein offizielles Produkt von DeepSeek ist. Vollduplex-Tools sind implementiert, aber standardmäßig deaktiviert.
Warum verwendet der Router ein leichteres Modell? Er verteilt lediglich Aufgaben und spricht mit Menschen; er führt niemals selbst Aufgaben aus und benötigt kein Bash-Tool. Das anspruchsvolle Reasoning übernehmen die Worker mit dem stärksten Modell.
Worin unterscheidet sich ein Super-Agent von einem Agenten-Team? Ein Team-Lead teilt eine einzelne, gekoppelte Aufgabe auf. Der Router verteilt unabhängige Aufgaben. Ein Worker kann innerhalb des Super-Agenten ein eigenes Agenten-Team betreiben.
Was ist Thread-Pass-Through? Folge-Events zu einem PR, einem Chat-Topic oder einem E-Mail-Thread gehen direkt an den Worker, der diesen Thread besitzt, und überspringen... [truncated 795 chars]