
Grok 4.6 wurde am 12. August veröffentlicht und bringt eine Behauptung mit sich, die die Entscheidung für Frontier-Modelle neu gestaltet: eine Intelligenz, die GPT-5.6 Sol im Artificial Analysis Index einholt, und das für 6 $ pro Million Ausgabe-Tokens anstatt 30 $. Die meisten Vergleichsartikel, die Sie finden, benchmarken immer noch Grok 4.5, das dem Frontier-Bereich so weit hinterherhinkte, dass der Preis keine Rolle spielte. Das ist nicht mehr der Fall, daher beginnt dieser Vergleich frisch mit den 4.6-Zahlen.
Die kurze Antwort: GPT-5.6 Sol bleibt die beste Wahl für Repository-Skala-Code-Agenten, Claude Fable 5 führt bei langfristiger autonomer Arbeit knapp, und Grok 4.6 ist jetzt die preiswerte Option, die in puncto Fähigkeiten nah genug dran ist, um die anderen beiden ihren Preis rechtfertigen zu lassen. Die richtige Wahl hängt von Ihrer Arbeitslast ab, daher finden Sie unten die Zahlen, die API-Überlegungen und eine reproduzierbare Methode, um alle drei auf Ihrem eigenen Stack zu testen. Wenn Sie diesen Test heute durchführen möchten, können Sie mit Apidog alle drei APIs kostenlos Seite an Seite von einem einzigen Arbeitsbereich aus nutzen.
Button
TL;DR
- Intelligenz-Index: Claude Fable 5 führt mit 62; Grok 4.6 und GPT-5.6 Sol liegen gleichauf bei 61.
- Preise (Ausgabe, pro 1 Mio. Tokens): Grok 4.6 für 6 $, Claude Opus 4.8 für 25 $, GPT-5.6 Sol für 30 $, eine 5-fache Spanne.
- Kontext: GPT-5.6 Sol 1.05 Mio. Tokens, Claude Fable 5 1 Mio., Grok 4.6 500K.
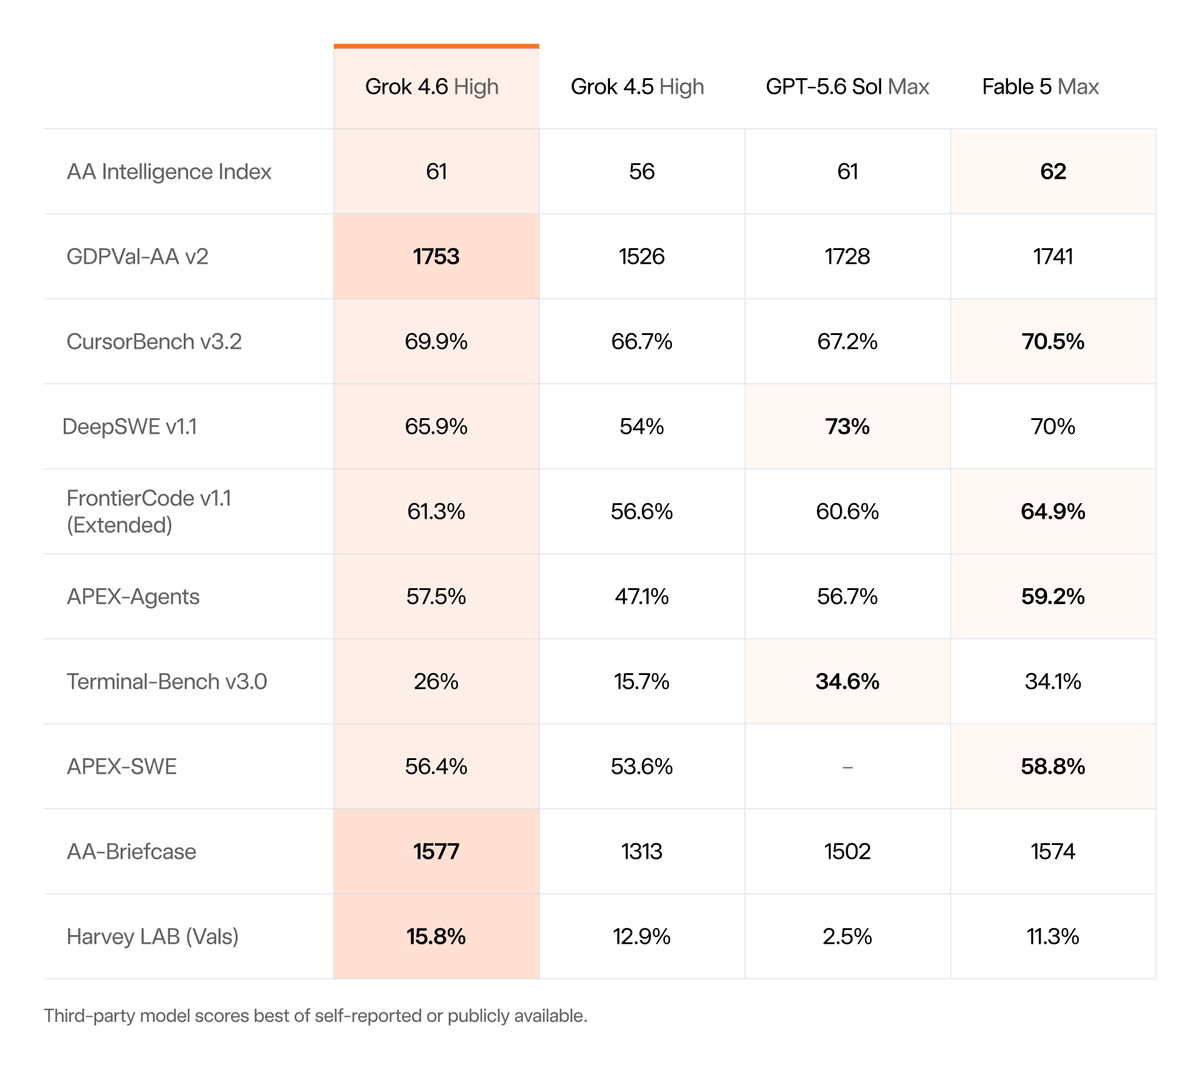
- Codierung: Sol Max führt bei DeepSWE (73,0 % vs. Groks 65,9 %); Fable 5 Max führt bei FrontierCode (63,6 % vs. 61,3 %).
- Agenten: Fable 5 Max führt bei APEX-Agents mit 59,2 %; Grok 4.6 (57,5 %) liegt knapp vor Sol Max (56,7 %).
- Kosten pro abgeschlossener Aufgabe: Grok 4.6 wurde von Artificial Analysis mit 0,84 $ gemessen, der niedrigste Wert im Frontier-Bereich.
- Entscheiden Sie nicht allein aufgrund von Benchmarks: Führen Sie einen 20-Prompt-Vergleich für Ihre eigene Arbeitslast durch (Methode unten).
Spezifikationen und Preise im Vergleich
| Grok 4.6 | GPT-5.6 Sol | Claude Fable 5 | |
|---|---|---|---|
| Entwickler | xAI | OpenAI | Anthropic |
| Intelligenz-Index | 61 | 61 | 62 |
| Kontextfenster | 500K | 1.05M | 1M |
| Eingabepreis / 1M | $2 | $12 | $10 |
| Ausgabepreis / 1M | $6 | $30 | $25* |
| Schnelle/Premium-Variante | 2-facher Preis | Sol Max Stufe | Fable 5 Max Stufe |
| API-Stil | OpenAI-kompatibel | OpenAI nativ | Anthropic Messages |
| Wissensstand | Feb 2026 |
*Claude-Preise für Opus 4.8; Fable 5 Stufenpreise variieren je nach Aufwandseinstellung. Die vollständigen Matrizen finden Sie in unserem GPT-5.6 Preisleitfaden und der Claude Kostenreduzierungsaufschlüsselung.
Die Preis-Asymmetrie ist die eigentliche Geschichte. Bei der Eingabe berechnet Grok ein Sechstel dessen, was OpenAI verlangt; bei der Ausgabe ein Fünftel. Für Chat-Arbeitslasten ist das angenehm; bei Agenten-Arbeitslasten, wo eine einzelne Aufgabe Dutzende von Modellaufrufen und lange Transkripte der Werkzeugnutzung generieren kann, summiert sich dies zum Unterschied zwischen einem 50 $/Tag und einem 250 $/Tag Agenten.
Coding-Benchmarks: Sol für Tiefe, Grok für Wert
Basierend auf den Startzahlen beansprucht jedes Modell seinen Bereich:
| Benchmark | Grok 4.6 | GPT-5.6 Sol Max | Claude Fable 5 Max |
|---|---|---|---|
| DeepSWE v1.1 (Fehlerbehebungen im Repository-Maßstab) | 65.9% | 73.0% | |
| FrontierCode v1.1 Extended | 61.3% | 60.6% | 63.6% |
| CursorBench v3.2 | 69.9% | ||
| APEX-Agents | 57.5% | 56.7% | 59.2% |
| Terminal-Bench v2.1 | 88.4% |
Lesen Sie es so:
- Der 7-Punkte-Vorsprung von GPT-5.6 Sol Max bei DeepSWE ist real und bedeutsam. Fehlerbehebungen im Repository-Maßstab sind der schwierigste und wirtschaftlich wertvollste Coding-Benchmark. Wenn Ihr Agent mit großen bestehenden Codebasen bei minimaler Überwachung arbeitet, ist Sol immer noch die sicherste Wahl. Unser Vergleich zwischen GPT-5.6 Sol und Claude Fable 5 behandelt dieses Matchup ausführlich.
- Claude Fable 5 gewinnt bei der Konsistenz. Es führt den Gesamtindex, FrontierCode und APEX-Agents an. Nichts Spitzenmäßiges, es ist einfach selten schlechter als Zweiter. Dieses Profil eignet sich für langfristige autonome Arbeiten, bei denen ein falscher Schritt eine Stunde Fortschritt zunichte macht.
- Grok 4.6 ist nie weit zurück und manchmal sogar vorne. CursorBench und Terminal-Bench anzuführen und gleichzeitig an anderer Stelle in Schlagdistanz zu bleiben, und das zu einem Bruchteil der Kosten, ist genau das Profil eines Modells, an das Sie den Großteil Ihres Traffics leiten und nur die schwierigen Fälle eskalieren.
Ein Hinweis zur Ehrlichkeit: Dies sind Zahlen aus der Startwoche, die größtenteils vom Anbieter gemeldet wurden. Die Start-Benchmarks von Grok 4.5 erforderten sorgfältiges Lesen, und die gleiche Vorsicht gilt hier für jeden Anbieter.
Kosten pro Aufgabe, nicht Kosten pro Token
Token-Preise sind irreführend, wenn sich Modelle in Ausführlichkeit und Wiederholungsraten unterscheiden. Ein günstiges Modell, das bei einem Terminal-Durchlauf fehlschlägt, erzeugt Überprüfungs- und Reparaturarbeiten, die mehr kosten als die eingesparten Tokens. Die bessere Metrik sind die Kosten pro abgeschlossener Aufgabe, und hier ist die unabhängige Messung von Artificial Analysis frappierend: Grok 4.6 lag im Durchschnitt bei 0,84 $ pro Aufgabe in seinen Agenten-Bewertungen, der niedrigste Wert unter den Frontier-Modellen, was eher durch einen relativ disziplinierten Token-Einsatz als nur durch niedrige Preise ermöglicht wurde.
Ein Rechenbeispiel. Angenommen, Ihr Code-Agent verbraucht durchschnittlich 500.000 Eingabe- und 100.000 Ausgabe-Tokens pro abgeschlossener Aufgabe:
| Modell | Eingabekosten | Ausgabekosten | Pro Aufgabe |
|---|---|---|---|
| Grok 4.6 | $1.00 | $0.60 | $1.60 |
| Claude Opus 4.8 | $5.00 | $2.50 | $7.50 |
| GPT-5.6 Sol | $6.00 | $3.00 | $9.00 |
Bei 1.000 Aufgaben pro Monat spart Grok im Vergleich zu den Alternativen etwa 6.000–7.400 $, wenn seine Erfolgsquote bei Ihrer Arbeitslast stabil bleibt. Diese Bedingung ist entscheidend, deshalb sollten Sie testen, bevor Sie sich festlegen.
API-Ergonomie: Was die Integration Sie wirklich kostet
- Grok 4.6 ist OpenAI-kompatibel. Wenn Sie einen OpenAI-artigen Client haben, richten Sie die
base_urlaufhttps://api.x.ai/v1und schon läuft es. Es ist auch auf OpenRouter, Vercel und Cloudflare für Gateway-Benutzer verfügbar. - GPT-5.6 Sol hat das umfangreichste Ökosystem: die Responses API, programmatische Werkzeugaufrufe und hauseigene SDKs überall. Die Tier-Struktur finden Sie unter So nutzen Sie die GPT-5.6 API.
- Claude Fable 5 verwendet die Messages API von Anthropic, eine andere Anfragenstruktur, ausgezeichnete Zuverlässigkeit bei der Werkzeugnutzung und einen Aufwandsparameter, der Kosten gegen Leistungsfähigkeit innerhalb eines Modells tauscht.
Die Migrationsreibung ist zwischen Grok und OpenAI am geringsten (gemeinsames Format), am höchsten beim Wechsel zu oder von Anthropic. Wenn Sie einen Wechsel oder das Routing zwischen Modellen in Betracht ziehen, sollte diese Asymmetrie in Ihre Architektur-Entscheidung einfließen.
Kontextfenster: Wenn 500K ausreichen
Auf dem Papier verdoppelt das 1,05 Millionen Token-Fenster von GPT-5.6 Sol das 500K-Fenster von Grok 4.6, wobei Claude Fable 5 mit 1 Million dicht folgt. In der Praxis stellt sich die Frage, was Ihre Arbeitslast tatsächlich im Kontext enthält.
Ein 500K-Fenster fasst ungefähr 350.000 Wörter: die gesamte Codebasis eines mittelgroßen Dienstes, ein Jahr voller Support-Transkripte oder mehrere hundert Seiten juristischer Dokumente. Die meisten Agenten-Aufgaben erreichen diese Größe nie. Die Arbeitslasten, die wirklich die Millionen-Token-Stufe benötigen, sind eng gefasst: die Analyse ganzer Monorepos, sehr lange Agenten-Transkripte mit mehreren Sitzungen, die Sie nicht zusammenfassen möchten, und die einmalige Verarbeitung riesiger Dokumentensätze.
Zwei praktische Anmerkungen sprechen dagegen, sich allein auf die Fenstergröße zu konzentrieren. Erstens verschlechtert sich jedes Modell, wenn der Kontext gefüllt wird; die Abrufqualität bei 80 % Kapazität ist bei allen dreien schlechter als bei 20 %, sodass Architekturen, die das Fenster vollstopfen, selten Architekturen schlagen, die selektiv abrufen. Zweitens sind Eingabe-Tokens der Punkt, an dem Budgets sterben: Das Füllen von Sols vollem Fenster kostet etwa 12,60 $ pro Anfrage zum Listenpreis, während das Füllen von Groks Fenster 1 $ kostet. Wenn Ihre Prompts routinemäßig 400K Tokens überschreiten, benötigen Sie nicht nur ein größeres Fenster, sondern auch eine Caching- und Abrufstrategie, egal welchen Anbieter Sie wählen.
Wissensstand und Ökosystem-Reife
Grok 4.6 wird mit einem Wissensstand vom 1. Februar 2026 ausgeliefert, dem aktuellsten der drei, was für Code-Agenten, die sich auf schnelllebige Frameworks beziehen, von Bedeutung ist. Es ist ein echter, aber kleiner Vorteil: Jeder ernsthafte Agenten-Stack stützt sich auf Abruf- und Dokumentationstools, anstatt parametrisches Wissen zu vertrauen.
Das Ökosystem ist die umgekehrte Geschichte. OpenAI hat die tiefste Oberfläche für Integrationen von Drittanbietern, Anthropic hat die stärkste Bekanntheit im Bereich Agenten-Frameworks, und xAI ist der Neuling, der sich auf die OpenAI-Kompatibilität stützt, um beides zu nutzen. Diese Wette geht größtenteils auf: Alles, was das Chat-Completions-Format spricht, läuft heute mit Grok, und die Gateway-Verfügbarkeit über OpenRouter, Vercel und Cloudflare bedeutet, dass Sie es ohne Änderungen an Ihrer Infrastruktur einführen können. Was Sie aufgeben, ist der erstklassige Feinschliff, Batch-APIs, Caching-Ebenen und detaillierte Nutzungssteuerungen sind weniger ausgereift als die der etablierten Anbieter.
Welches Modell für welche Aufgabe
- Autonomer Code-Agent im Repository-Maßstab, Qualität zuerst: GPT-5.6 Sol. Der DeepSWE-Vorsprung führt zu weniger Fehlern bei großen Codebasen.
- Langfristige Wissensarbeit und mehrstündige Agenten-Sitzungen: Claude Fable 5. Bester Gesamtscore, bester Agenten-Benchmark, stärkste Erfolgsbilanz bei der Einhaltung des Kurses.
- Hohes Agenten-Traffic-Aufkommen, kostensensible Produkte oder das Standardmodell eines Routers: Grok 4.6. Frontier-Output zu Commodity-Preisen; die schwierigsten 10 % der Aufgaben an Sol oder Fable eskalieren.
- Interaktives Codieren in einer IDE: Grok 4.6s CursorBench-Führung plus seine 2x schnelle Variante machen es zu einem ernsthaften Anwärter; es wurde effektiv dafür entwickelt, nachdem es an echten Cursor-Sitzungen trainiert wurde.
Testen Sie alle drei an einem Nachmittag auf Ihrem Stack
Benchmarks prognostizieren Durchschnitte, nicht Ihre Arbeitslast. Hier ist ein reproduzierbarer Vergleichstest mit Apidog:
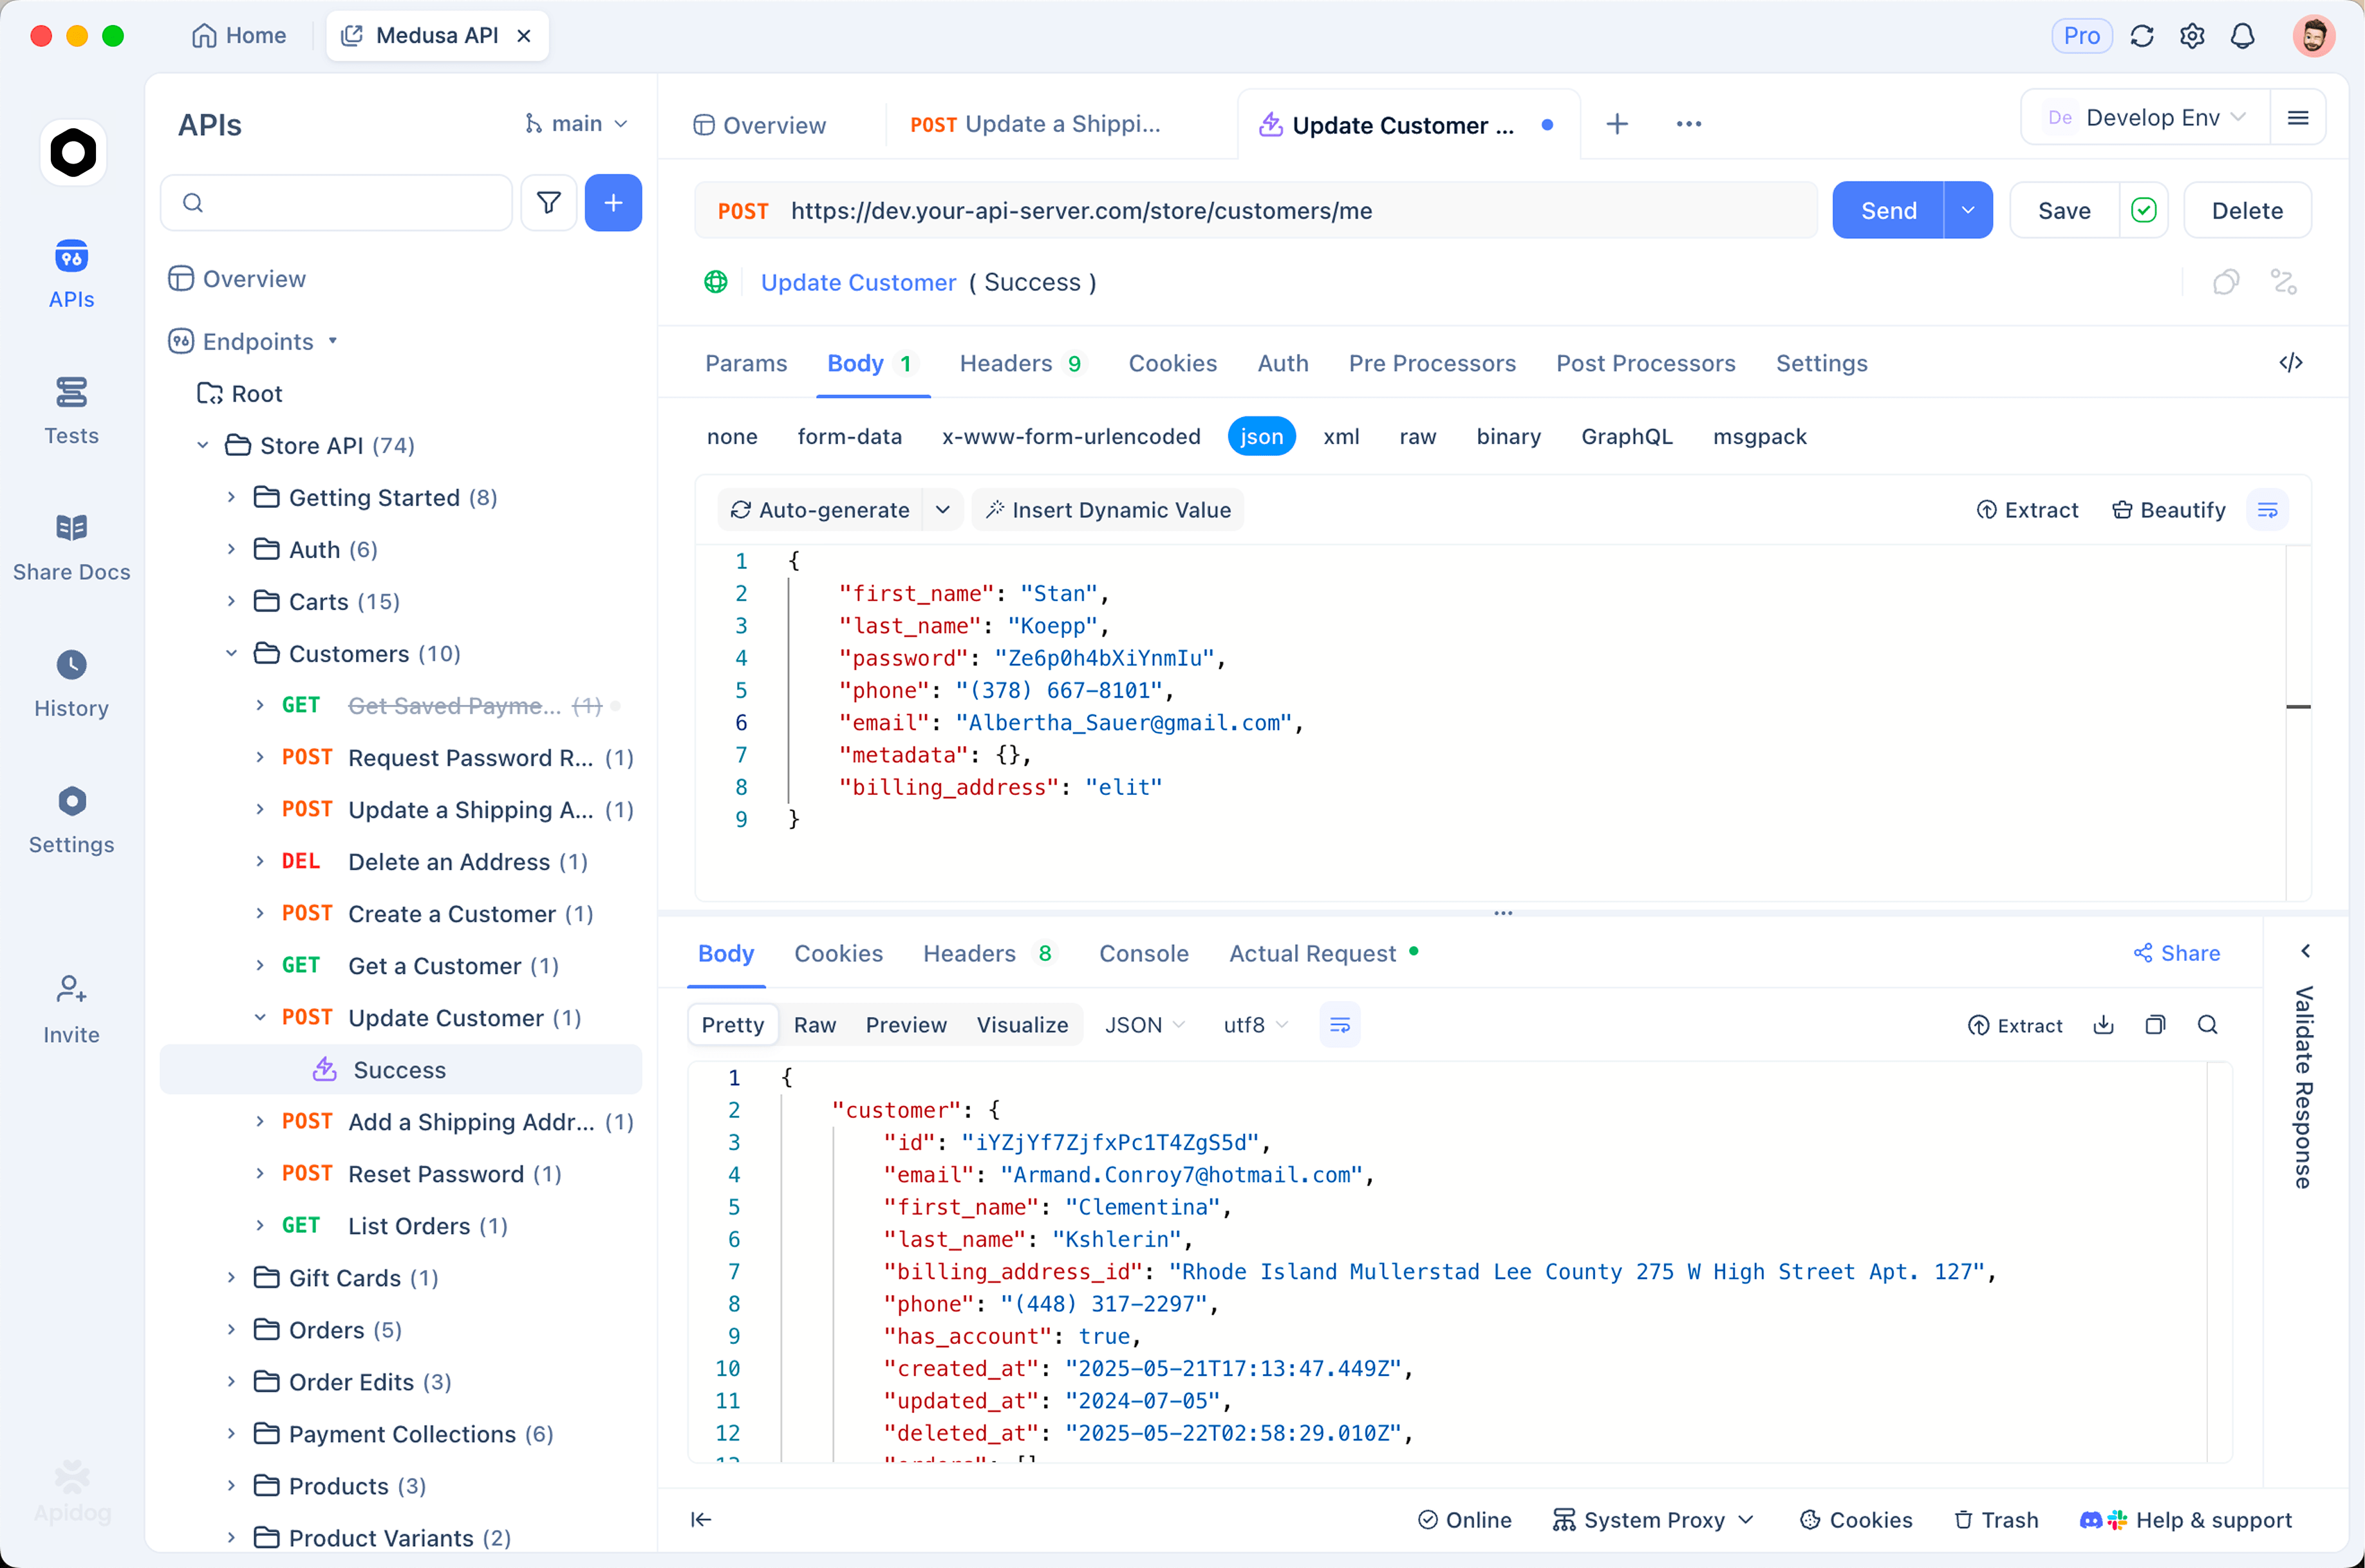
- Ein Projekt, drei Umgebungen. Erstellen Sie Umgebungen für xAI (
api.x.ai/v1), OpenAI und Anthropic, jede mit eigener Authentifizierung. Dieselbe Anfrage wechselt den Anbieter mit einem Dropdown. - Sammeln Sie 20 echte Prompts. Verwenden Sie tatsächliche Aufgaben aus Ihrem Produkt, keine Spielzeugfragen. Fügen Sie Ihren System-Prompt, Ihre Tool-Definitionen (falls Sie Funktionsaufrufe verwenden) und mindestens fünf bekanntermaßen schwierige Fälle hinzu.
- Definieren Sie, was Ihnen wichtig ist. Fügen Sie Apidog-Assertions für die Gültigkeit der Antwort, die Token-Nutzung aus dem
usage-Objekt und Latenzschwellen hinzu. Bei Tool-Calling-Workloads stellen Sie sicher, dass das Tool-Call-JSON geparst wird und Ihrem Schema entspricht; Modelle scheitern hier weitaus häufiger als in Prosa. - Führen Sie es als Testszenario durch, dreimal pro Modell. LLM-Outputs variieren; drei Durchläufe zeigen die Varianz, die eine einzelne Demo verbirgt. Exportieren Sie die Ergebnisse und vergleichen Sie die Erfolgsrate und die Kosten pro Erfolg, nicht die Kosten pro Token.
- Behalten Sie die Suite bei. Wenn die nächste Modellversion veröffentlicht wird (im aktuellen Rhythmus innerhalb weniger Monate), führen Sie sie erneut aus. Die Modellwahl ist jetzt eine vierteljährliche Entscheidung, und Teams mit einem etablierten Evaluierungs-Harness wechseln Wochen schneller als Teams, die sich durch Anekdoten neu entscheiden.
FAQ
- Ist Grok 4.6 besser als GPT-5.6 Sol? Sie liegen im Gesamtindex mit 61 gleichauf. Sol führt klar bei der Codierung im Repository-Maßstab (DeepSWE 73,0 % vs. 65,9 %); Grok führt bei CursorBench und Terminal-Bench und kostet am Ausgabeende 5x weniger. „Besser“ hängt davon ab, ob Ihre Arbeitslast eher DeepSWE oder eher einer IDE-Sitzung ähnelt.
- Ist Grok 4.6 besser als Claude Fable 5? Fable 5 führt beim Index (62 vs. 61), FrontierCode und APEX-Agents, allesamt knapp. Groks Vorteil ist der Preis. Für genauigkeitskritische autonome Arbeit, Fable 5; für kostensensibles Volumen, Grok.
- Welches KI-Modell ist 2026 das günstigste im Frontier-Bereich? Grok 4.6, mit 2 $/6 $ pro Million Tokens und einem unabhängig gemessenen Wert von 0,84 $ pro Agenten-Aufgabe. Die Ausgabe-Tokens des nächstgelegenen Frontier-Konkurrenten kosten etwa 4x mehr.
- Sollte ich meinen Produktions-Agenten auf Grok 4.6 umstellen? Nicht allein aufgrund von Benchmarks. Führen Sie zuerst den oben beschriebenen Vergleichstest mit Ihrer realen Arbeitslast durch; der 5-fache Preisunterschied zahlt sich nur aus, wenn die Erfolgsrate bei Ihren Aufgaben Bestand hat.
- Kann ich alle drei Modelle hinter einem API-Format verwenden? Größtenteils. Grok 4.6 spricht nativ das OpenAI Chat Completions Format, teilt sich also den Client-Code mit GPT-5.6. Claude benötigt die Messages API von Anthropic oder ein Gateway wie OpenRouter, das alle drei hinter einer Schnittstelle mit geringem Aufschlag normalisiert.
- Spielt Grok 4.6s kleineres Kontextfenster eine Rolle? Für die meisten Agenten- und Chat-Workloads nein; 500K Tokens liegen weit über dem typischen Gebrauch, und alle drei Modelle verschlechtern sich ohnehin nahe ihren Grenzen. Es spielt eine Rolle, wenn Sie routinemäßig ganze Monorepos oder riesige Dokumentensätze in einem einzigen Aufruf verarbeiten, wo Sols 1,05M Fenster echten Spielraum bietet.
Button