
Die Preisgestaltung von GPT-Live-1.1 ist zeitbasiert, nicht tokenbasiert. OpenAI rechnet die Sprachsession mit $0,05 pro aktiver Minute und $0,02 pro Standby-Minute ab, sekundengenau und ohne Aufrundung auf die nächste Minute. Backend-Modell- und Tool-Aufrufe werden separat zu den üblichen Preisen abgerechnet. Eine Stunde durchgehendes Gespräch kostet $3,00 an Sprachgebühren; eine Stunde im Standby-Modus kostet $1,20.
Die Preisliste ist kurz. Entscheidend ist, wie sie sich in einer echten App verhält – dort, wo Anrufer pausieren, Backends rechnen und Sessions zu lange offen bleiben. Im Folgenden finden Sie drei durchgerechnete Beispiele sowie die Einstellungen, die Ihre Rechnung planbar halten.
Die Preise von GPT-Live-1.1 im Überblick
GPT-Live-1.1 hat zwei Sprachtarife und eine separate Rechnung für das Backend. Dies listet die GPT-Live-1.1-Modellseite zusammen mit der OpenAI-Preisseite zum Stand vom 20. November 2026 auf:
| Gebühr | Tarif | Pro Stunde | Hinweise |
|---|---|---|---|
| Aktive Sessionzeit | $0,05 pro Minute | $3,00 | Sprache, Stille vor dem Idle-Timeout, Warten auf Backend-Arbeit |
| Standby-Sessionzeit | $0,02 pro Minute | $1,20 | Nur WebRTC, während die Inferenz pausiert |
| Backend-Responses-Modell | Übliche Tokenpreise | Variiert | Je nachdem, welches Modell Sie für die Delegierung wählen |
| Gehostete Tools | Übliche Tool-Preise | Variiert | Websuche, Dateisuche, Code Interpreter und andere |
Drei Details sind wichtiger als die offiziellen Tarife:
- Sekundengenaue Abrechnung. Ein 90-sekündiger Anruf kostet $0,075, nicht $0,10; die Dauer wird nicht auf eine ganze Minute aufgerundet.
- Gleicher Preis wie GPT-Live-1. Beide Modelle haben identische Tarife, ein Upgrade ändert also nichts an der Sprachrechnung.
- Eine Startgebühr von 15 Sekunden. Beim Anlegen einer WebRTC-Session werden 15 Sekunden abgerechnet, während sie initialisiert wird; gutgeschrieben wird, sobald die Session läuft. Zusatzkosten entstehen nur bei Sessions, die Sie anlegen und dann verwerfen.
Hintergrundinformationen zu den Voice-Stacks finden Sie in GPT-Live vs. GPT-Realtime.
Was zählt als aktive und was als Standby-Minute?
Aktive Minuten sind jede Zeit, in der Inferenz läuft. Standby-Minuten sind die Zeit, in der eine WebRTC-Session verbunden bleibt, während die Inferenz pausiert und auf Sprache wartet. Die Differenz von $0,03 pro Minute entscheidet über den Großteil Ihrer Sprachrechnung.
OpenAIs Kostenleitfaden führt auf, was in den aktiven Topf fällt:
- Zeit, in der der Nutzer oder das Modell spricht.
- Stille, bevor Ihr Idle-Timeout abläuft.
- Wartezeit auf Backend-Arbeit, während die Inferenz läuft.
Das Stummschalten des Mikrofons löst keinen Standby aus; die Session rechnet weiter mit $0,05 pro Minute ab.
Für den Standby-Modus sind bei der Session-Erstellung zwei Einstellungen nötig, dokumentiert im Leitfaden zu Live-Konversationen:
{
  "session": {
    "model": "gpt-live-1.1",
    "wake_policy": { "type": "speech", "vad_threshold": 0.5 },
    "idle_timeout_s": 15
  }
}
wake_policy.type: "speech" weist die Session an, vor dem Start der Inferenz auf Sprache zu warten. idle_timeout_s nimmt eine ganze Zahl zwischen 5 und 60 an und schickt die Session nach so vielen Sekunden ohne Input- oder Output-Transkript zurück in den Standby. Lassen Sie das Timeout weg, bleibt die Inferenz aktiv, bis die Session endet – Sie erhalten dann nie den Standby-Tarif.
Zwei Einschränkungen: Standby funktioniert nur mit WebRTC, d. h. WebSocket- und SIP-Sessions rechnen jede verbundene Sekunde zum aktiven Tarif ab, und die erste Antwort nach dem Standby kann länger dauern.
Durchgerechnete Kostenbeispiele
Die Sprachtarife sind die veröffentlichten; die Backend-Tokenmengen sind illustrative Annahmen. Die Backend-Preise stammen von der OpenAI-Preisseite: gpt-6-luna mit $0,10 Input und $0,50 Output pro 1M Token, gpt-6-sol mit $2,00 Input und $10,00 Output pro 1M Token (Standard-Tier, kurzer Kontext). OpenAIs Delegierungsleitfaden empfiehlt, mit gpt-6-luna zu starten und gpt-6-sol für anspruchsvollere Backend-Aufgaben auszuprobieren.
Beispiel 1: Eine Kunden-Support-Hotline
Ein Telefon- oder WebSocket-Supportanruf dauert 6 Minuten. Standby greift nicht, also werden alle 6 Minuten als aktiv abgerechnet. GPT-Live delegiert 4 Nachschlageaktionen an gpt-6-luna, jeweils mit rund 6.000 Input- und 400 Output-Token.
| Position | Rechnung | Kosten |
|---|---|---|
| Sprache | 6 Min. x $0,05 | $0,30 |
| Backend-Input | 24.000 Token x $0,10 / 1M | $0,0024 |
| Backend-Output | 1.600 Token x $0,50 / 1M | $0,0008 |
| Pro Anruf | $0,3032 |
Bei 10.000 Anrufen im Monat sind das rund $3.032, wovon $3.000 auf Sprachzeit entfallen. 30 Sekunden von jedem Anruf abzuschneiden spart mehr ein, als das gesamte Backend kostet.
Beispiel 2: Ein Sprachtutor im Browser
Eine 30-minütige WebRTC-Tutorsession mit idle_timeout_s auf 15 gesetzt. Die Studentin verbringt lange Phasen mit Lesen und Nachdenken, daher läuft die Session 18 Minuten aktiv und 12 Minuten im Standby. Der Tutor delegiert 10 Erklärungen an gpt-6-sol, jeweils mit etwa 8.000 Input- und 600 Output-Token.
| Position | Rechnung | Kosten |
|---|---|---|
| Aktive Sprachzeit | 18 Min. x $0,05 | $0,90 |
| Standby-Sprachzeit | 12 Min. x $0,02 | $0,24 |
| Backend-Input | 80.000 Token x $2,00 / 1M | $0,16 |
| Backend-Output | 6.000 Token x $10,00 / 1M | $0,06 |
| Pro Session | $1,36 |
Ohne Standby würden dieselben 30 Minuten Sprachzeit $1,50 statt $1,14 kosten – der Standby-Modus senkt die Sprachrechnung also um 24 %.
Beispiel 3: Ein immer laufender Desktop-Assistent
Ein Assistent bleibt über den 8-Stunden-Arbeitstag geöffnet, aber der Nutzer spricht nur 40 Minuten in kurzen Stößen mit ihm. Hier verändert die gewählte Strategie die Rechnung um mehr als den Faktor 10:
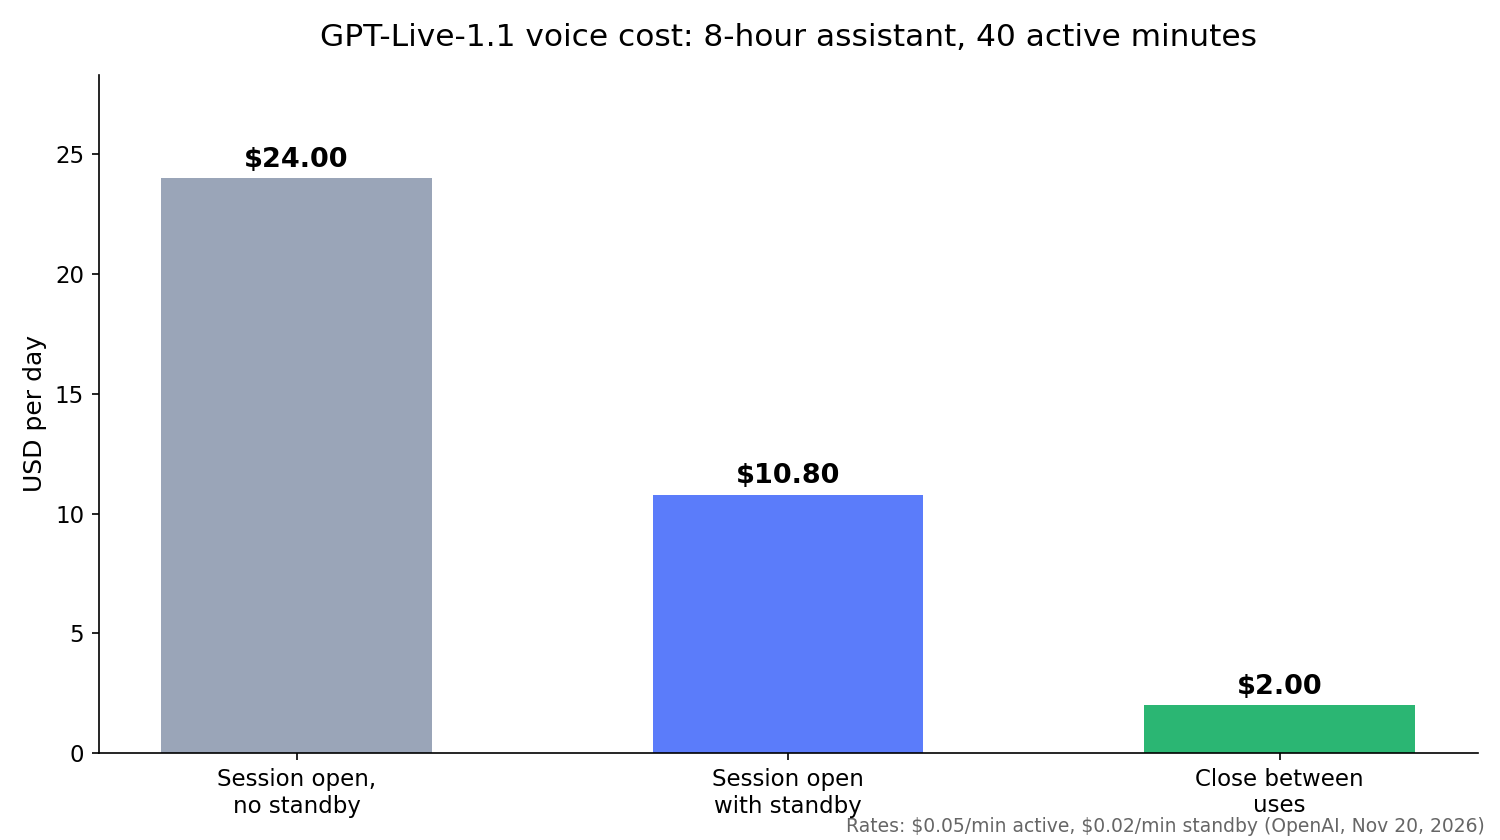
| Strategie | Rechnung | Pro Tag | Pro 22-Tage-Monat |
|---|---|---|---|
| Session offen, kein Standby | 480 Min. x $0,05 | $24,00 | $528,00 |
| Session offen mit Standby | 40 x $0,05 + 440 x $0,02 | $10,80 | $237,60 |
| Schließen zwischen den Nutzungen | 40 Min. x $0,05 | $2,00 | $44,00 |
Standby kostet trotzdem $1,20 pro Leerlaufstunde. OpenAIs Leitfaden empfiehlt, die Session bei langen Pausen zu schließen und beim Rückkehr des Nutzers eine neue zu starten, die mit gespeichertem Verlauf versehen wird. Die 15-Sekunden-Startgebühr wird gutgeschrieben, sobald die neue Session läuft – allein bei den Sprachgebühren gewinnt also das Schließen. Dafür verzichten Sie auf das sofortige Aufwecken: Eine geschlossene Session kann den Nutzer nicht hören, Sie brauchen also Push-to-Talk oder einen eigenen Wake-Trigger.
Wie das Idle-Timeout Ihre Rechnung verändert
Jede Pause kostet aktive Zeit, bis das Idle-Timeout greift. Ein kürzeres Timeout erreicht den günstigeren Standby-Tarif schneller, allerdings um den Preis von mehr Pausier- und Fortsetzungszyklen und einer langsameren ersten Antwort nach jedem Zyklus.
Der Aufpreis pro Pause entspricht der Timeout-Dauer, abgerechnet mit der Differenz von $0,03 zwischen den beiden Tarifen. Bei 100 Pausen in einer Session oder einem Tag:
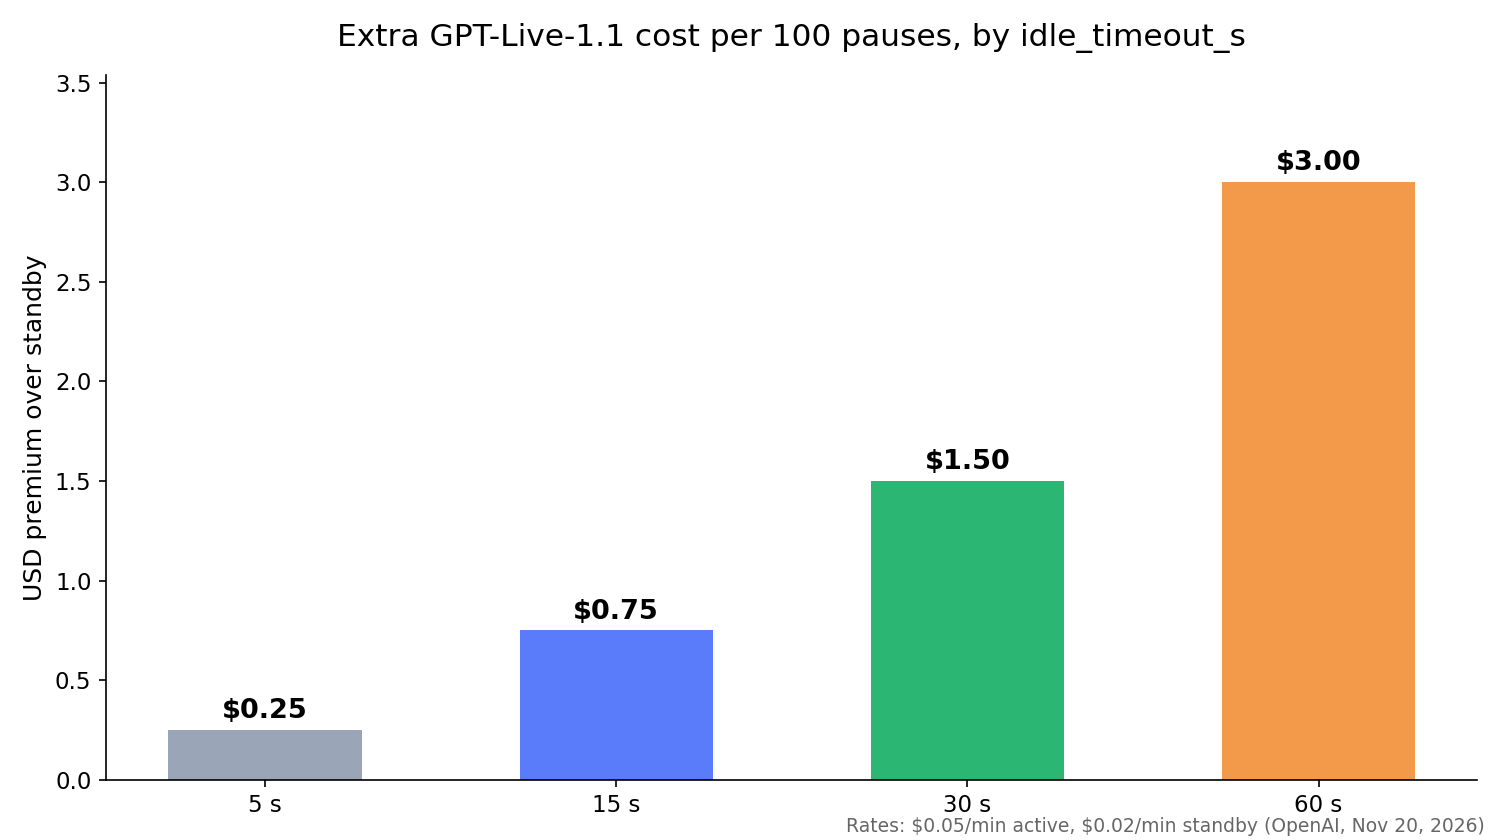
idle_timeout_s |
Aktive Sekunden pro Pause | Aufpreis gegenüber Standby, pro 100 Pausen |
|---|---|---|
| 5 | 5 | $0,25 |
| 15 | 15 | $0,75 |
| 30 | 30 | $1,50 |
| 60 | 60 | $3,00 |
Kleine Beträge – und das ist der Punkt: Das Timeout ist vor allem eine Einstellung für die Nutzererfahrung. Wählen Sie einen Wert, der Nutzer nicht mitten im Gedanken abschneidet, lassen Sie den Standby lange Pausen abdecken und das Schließen der Session sehr lange Pausen.
Wie sich die Preisgestaltung von GPT-Live-1.1 zu GPT-Realtime verhält
GPT-Live-1.1 rechnet pro Minute ab; die GPT-Realtime-Modelle rechnen pro Token ab. Die OpenAI-Preisseite listet gpt-realtime-2.1-Audio mit $32,00 pro 1M Input-Token und $64,00 pro 1M Output-Token sowie gpt-realtime-2.1-mini-Audio mit $10,00 und $20,00.
| GPT-Live-1.1 | GPT-Realtime-2.1 | |
|---|---|---|
| Abrechnungseinheit | Session-Sekunden | Input- und Output-Token |
| Sprachtarif | $0,05/Min. aktiv, $0,02/Min. Standby | $32 / $64 pro 1M Audio-Token |
| Reasoning und Tools | Separates Backend-Modell | Im selben Modell enthalten |
| Kostenverlauf | Flach pro Minute | Steigt pro Zug, je größer der Kontext wird |
OpenAIs Kostenleitfaden weist darauf hin, dass eine Realtime-Session bei jeder Antwort den gesamten Gesprächsverlauf an das Modell sendet – spätere Züge kosten also mehr. Eine GPT-Live-Minute kostet in Minute 2 dasselbe wie in Minute 40, was die Kostenvorhersage einfach macht. Unser GPT-Realtime-2-API-Leitfaden behandelt das tokenbasierte Setup.
Nutzung nachverfolgen und überraschende Rechnungen vermeiden
GPT-Live meldet die kumulierte Sprachnutzung in Sekunden über session.usage.updated-Ereignisse:
{
  "type": "session.usage.updated",
  "usage": { "seconds": 12 },
  "context_window": { "usage_ratio": 0.42 }
}
Jede Aktualisierung ersetzt den bisherigen Gesamtwert – summieren Sie sie also niemals. Senden Sie session.close, warten Sie auf session.closed und erfassen Sie den finalen usage.seconds-Wert. Um aktive von Standby-Zeit zu trennen, messen Sie die Abstände zwischen den session.paused- und session.resumed-Ereignissen.
Gewohnheiten, die die Kosten flach halten:
- Beendete Sessions schließen. Eine verwaiste offene Session rechnet weiter ab.
- Backend beschleunigen. Warten auf eine delegierte Aufgabe ist aktive Zeit; eine Minute früher fertig spart $0,05.
- Schließen bei langen Aufgaben. Schließen Sie die Sprachverbindung, solange das Backend arbeitet, und öffnen Sie sie wieder, wenn das Ergebnis bereit ist.
- Parallelität einplanen. Limits beziehen sich auf gleichzeitige Sessions, und GPT-Live-1.1 hat ein eigenes Limit, getrennt von GPT-Live-1, dessen veröffentlichte Limits bei 50 (Build), 300 (Launch) und 500 (Grow) liegen. Der Free-Tier wird nicht unterstützt.
Codex Ihre Kostenbilanz mit Apidog CLI testen lassen
Ihre Nutzungsabrechnung ist Code, der Ihnen gehört – und ein Fehler dort verprellt jeden Anruf. Testen Sie sie bei jedem Commit, ganz ohne Sprachsession und zu $0 an Sprachzeit, und lassen Sie Ihren Coding-Agenten die Tests mit Apidog CLI ausführen.
Installieren Sie die CLI, melden Sie sich an und fügen Sie die Apidog-Skill zu Ihrem Agenten hinzu:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Dann geben Sie Codex einen einzigen Prompt:
In Apidog project <projectId>, create a test case for POST /api/voice-usage.
Send {"session_id":"test-1","active_seconds":90,"standby_seconds":30} and assert
the response cost is 0.085 (90 s at $0.05/min plus 30 s at $0.02/min).
Add a second case with standby_seconds 0 that expects 0.075. Run both against
the local environment and summarize any failures.
Der Agent liest das Schema, validiert seine Payload, erstellt die Testfälle und führt sie aus:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case.json
apidog test-case create --project <projectId> --file ./case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
Ersetzen Sie -r cli,json durch -r junit, und derselbe Lauf lässt sich in CI einbinden; siehe Apidog CLI in einer CI/CD-Pipeline ausführen. Der Leitfaden Apidog CLI in Codex behandelt das Agent-Setup. Apidogs Free-Plan deckt Teams von bis zu 4 Nutzern ab.
FAQ
Wie viel kostet GPT-Live-1.1 pro Minute? $0,05 pro aktiver Minute und $0,02 pro Standby-Minute, sekundengenau abgerechnet. Backend-Nutzung kommt zusätzlich hinzu.
Ist GPT-Live-1.1 teurer als GPT-Live-1? Nein. OpenAI listet beide mit denselben aktiven und Standby-Tarifen.
Funktioniert Standby bei Telefonanrufen? Nein. Der günstigere Standby-Tarif gilt nur für WebRTC-Sessions, während die Inferenz pausiert. WebSocket- und SIP-Sessions rechnen die verbundene Zeit zum aktiven Tarif ab.
Sind Backend-Modellaufrufe im Minutenpreis enthalten? Nein. Delegierte Responses-Aufrufe werden zu den Tokenpreisen des gewählten Modells abgerechnet, zuzüglich Tool-Gebühren.
Was ist aus der GPT-Live-API-Frage vom Juli geworden? Damals war GPT-Live eine ChatGPT-Sprachfunktion ohne API, wie unser GPT-Live-API-Explainer seinerzeit anmerkte. GPT-Live-1.1 ist das API-Modell, bereitgestellt unter v1/live/sessions.